
投机解码端到端解析:EAGLE、接受判定与调优
投机解码(Speculative Decoding)端到端深挖
本文会图文并茂讲解 sglang 投机解码。
1. 心智模型与加速直觉
普通 AR:每 1 token = 1 次 target forward。投机解码:
- Draft(便宜)猜候选
- Verify(一次)target 验整块
- Accept 前缀 + bonus_token
- Draft Extend 写回 draft 状态
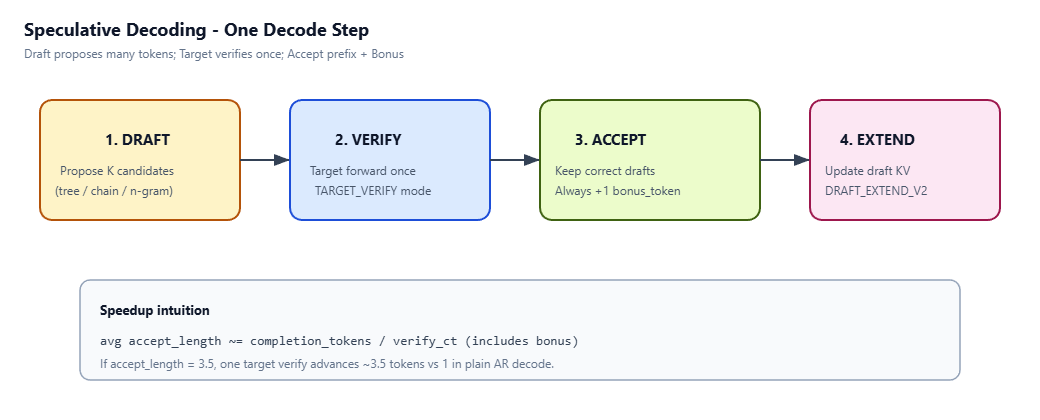
Draft → Target VERIFY → Accept + Bonus → Draft extend
1.1 加速公式(为什么不是「τ 倍」那么简单)
很多人第一直觉:每步平均接受 τ 个 token,就该有 τ 倍 吞吐。这只在「draft 完全免费」时成立。真实一步 decode 时间大致是:
T_spec ≈ C_draft + C_verify + C_extend
T_AR   ≈ C_verify_1token    # 普通 AR:一次 target decode forward
一步产出约 τ 个 token,故:
实际加速 ≈ (τ / T_spec) / (1 / T_AR) ≈ τ · T_AR / T_spec
把一次 target verify 记为 C_verify(常近似 T_AR ≈ C_verify),draft 相对耗时比记为 r = C_draft / C_verify,并暂时忽略 C_extend,得到:
实际加速 ≈ τ / (1 + r) = τ / (1 + C_draft / C_verify)
| 符号 | 含义 | 在 SGLang 里怎么理解 |
|---|---|---|
| τ | 每次 verify 平均产出 token 数(含 bonus) | spec_accept_length ≈ completion_tokens / spec_verify_ct |
| C_verify | target 一次 TARGET_VERIFY 耗时 | 贵;大模型一次 forward |
| C_draft | draft 提候选(多步采样 + 建树)耗时 | 应尽量小 |
| r | C_draft / C_verify | draft 相对有多贵;越小越好 |
| C_extend | DRAFT_EXTEND_V2 写回 draft KV | 公式常省略;慢时也会吃加速 |
1.2 公式在说什么(三句话)
- 分子 τ:一步「赚」了多少 token——猜得越准,τ 越大。
- 分母 (1 + r):比「只跑一次 target」多付了多少——draft 越贵,分母越大。
- 加速 < τ 是常态:只要
C_draft > 0,就拿不满 τ 倍。
1.3 数值例子
设 C_verify = 1(单位时间),r = C_draft / C_verify:
| τ | r | 近似加速 τ/(1+r) | 直觉 |
|---|---|---|---|
| 3.5 | 0(draft 免费) | 3.5× | 上界,实际达不到 |
| 3.5 | 0.2(draft 很快) | ≈ 2.9× | 较理想 |
| 3.5 | 1.0(draft ≈ verify) | ≈ 1.75× | 仍可能赚 |
| 3.5 | 3.0(draft 很重) | ≈ 0.9× | 比普通 AR 还慢 |
| 1.2 | 0.2 | ≈ 1.0× | 几乎没猜中,白付 draft |
| 1.0 | 任意 r>0 | < 1× | 只靠 1 个 bonus,必亏 |
调参既要抬 τ,又要控 r(别把 num_steps/topk 开到 draft 比 target 还慢)。 |
1.4 τ 和 accept_rate 别混
τ = accept_length  # 每步写入 token 数(含 1 bonus)
α = accept_rate    # 接受的 draft / 提出的 draft(不含 bonus)
链上每步提 K 个 draft 时,粗关系:τ ≈ α · K + 1(+1 即 bonus)。
故 accept_rate=0 时 τ 仍可≈1,加速变为 ≤ 1/(1+r) < 1——「猜全错仍比 AR 慢」。
2. 算法全家福与选型
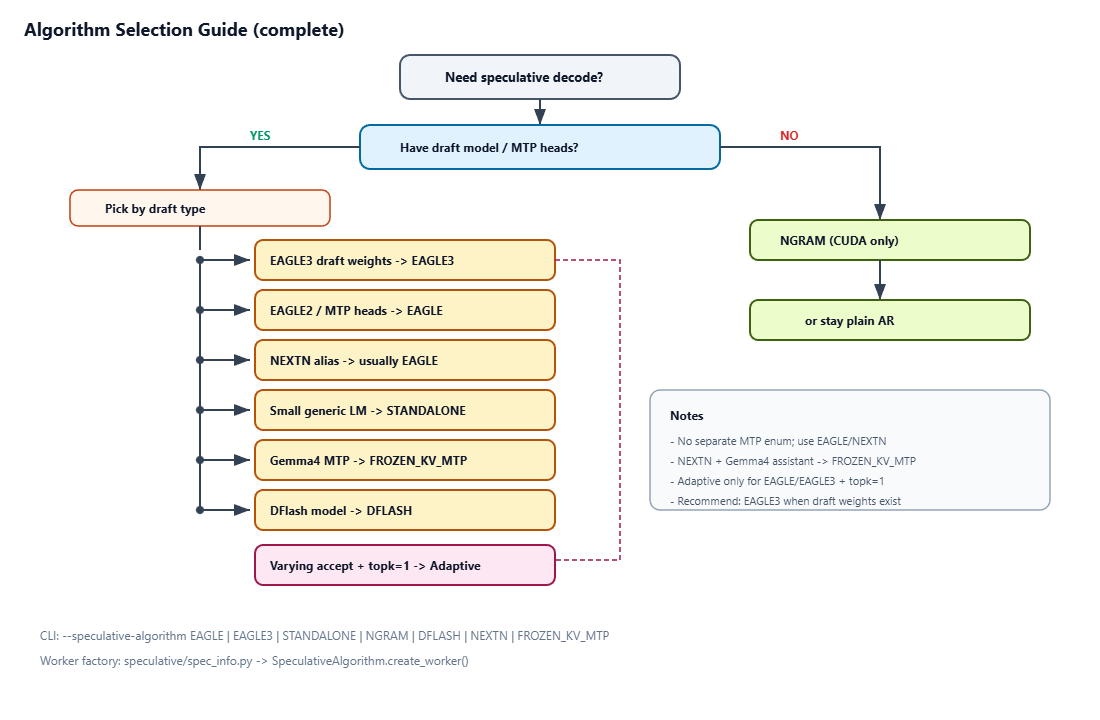
| 算法 | Draft 来源 | 独立权重? | Worker | 场景 |
|---|---|---|---|---|
| EAGLE / EAGLE3 | EAGLE draft(可树) | 通常要 | eagle_worker_v2.py | EAGLE3 推荐;EAGLE 强默认 |
| NEXTN | 别名→多为 EAGLE;Gemma4→FROZEN_KV_MTP | 视模型 | 同上 | DeepSeek/Qwen MTP |
| FROZEN_KV_MTP | Gemma4 MTP | 常无独立 KV | frozen_kv_mtp_worker_v2.py | 只读 target KV |
| STANDALONE | 任意小 LM | 要(不共享 embed) | standalone_worker_v2.py | 有现成小模型 |
| NGRAM | 历史 n-gram | 否 | ngram_worker.py | 无 draft 模型(CUDA) |
| DFLASH | block 候选 | 要 | dflash_worker_v2.py | Block 式 |
无独立
MTPenum:MTP 走EAGLE/NEXTN+ 内置 MTP 头。
枚举:srt/speculative/spec_info.py → SpeculativeAlgorithm。
3. CLI / 启动钩子
| 参数 | 含义 | 默认直觉 |
|---|---|---|
--speculative-draft-model-path | draft 权重 | EAGLE/STANDALONE 通常必需 |
--speculative-num-steps | draft 展开深度 | Llama 常 5;许多 MTP 为 3 |
--speculative-eagle-topk | 树分支宽度 | Llama 常 4;链=1 |
--speculative-num-draft-tokens | verify 窗口 | Llama 常 8;topk=1 强制 steps+1 |
--speculative-accept-threshold-single / _acc | 随机接受阈值 | 默认 1.0 |
--speculative-use-rejection-sampling | coin*q < p | False(需 topk=1) |
--speculative-adaptive | 自适应 steps | False |
--speculative-token-map | FR-Spec 小词表 | 仅 EAGLE-2 |
硬约束:topk==1 → num_draft_tokens = num_steps+1。
3.1 为何开 spec 时 max_running_requests 默认降到 48?
实现位置:arg_groups/speculative_hook.py(EAGLE / STANDALONE / NGRAM / DFLASH / FROZEN_KV_MTP 等路径均有)。
逻辑:仅当用户未显式设置 --max-running-requests(值为 None)时,才重置为 48,并打 warning 提示可覆盖。
这是保守默认值,不是算法硬约束。原因是开 spec 后每个 running request 比普通 AR 更贵:
- KV 更胖
每个请求要为 draft 树/链预留最多约speculative_num_draft_tokens的候选槽;verify 验整棵树而非 1 token。KV / 上下文预留会按 draft token 数放大(见model_runner_kv_cache_mixin)。 - 往往双份模型相关状态
EAGLE 等还有 draft 权重 + draft KV,显存明显高于纯 target。 - CUDA Graph / batch 形状
draft、verify、extend 多套 graph;max_running_requests越大,可捕获档位与峰值显存越高,OOM 风险越大。 - 经验默认
代码里没有「必须是 48」的公式;与 DeepSeek MTP 文档一致:默认 48 是为了先稳启动,大 batch 应自行调大。
| 情况 | 做法 |
|-|-|
| 显存够、要更高并发 | 显式--max-running-requests <更大值>|
| 启动 OOM / 开 spec 后不稳 | 保持 48 或再降,并配合--mem-fraction-static|
| 已手动设置该参数 | 不会被改成 48 |
python3 -m sglang.launch_server \
  --model-path meta-llama/Llama-2-7b-chat-hf \
  --speculative-algorithm EAGLE \
  --speculative-draft-model-path lmsys/sglang-EAGLE-llama2-chat-7B \
  --speculative-num-steps 3 --speculative-eagle-topk 4 \
  --speculative-num-draft-tokens 16 --mem-fraction-static 0.7
4. 进程与 Worker 架构
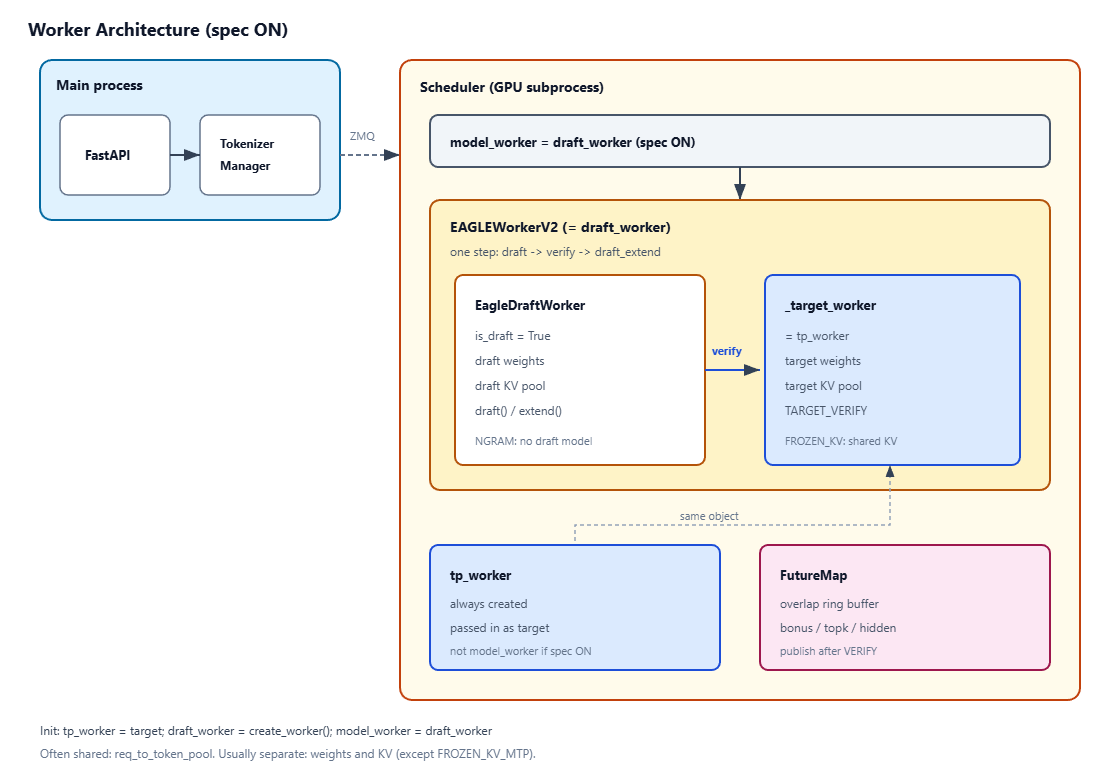
| 资源 | Target (tp_worker) | Draft (draft_worker) |
|---|---|---|
| 权重 | --model-path | --speculative-draft-model-path(NGRAM 无) |
| KV pool | 主 req_to_token / token_to_kv | 独立 draft KV;EAGLE 可共享 req pool |
| Forward | TARGET_VERIFY / prefill | DECODE draft + DRAFT_EXTEND_V2 |
| CUDA Graph | decode + verify graph | draft + draft_extend graph |
| 调度入口 | 被 draft 内部调用 | model_worker(spec 开启时) |
# scheduler.py — init_model_worker()
self.tp_worker = TpModelWorker(...)          # target 权重 + KV
self.maybe_init_draft_worker()               # 按算法创建 draft_worker
if spec off:  self.model_worker = self.tp_worker
else:         self.model_worker = self.draft_worker  # decode 走 draft 门面
# eagle_worker_v2.py — EAGLEWorkerV2
self.target_worker = target_worker           # 即 tp_worker
self._draft_worker = EagleDraftWorker(...)   # 小模型 + draft KV
# forward_batch_generation: draft → verify(target) → draft_extend
EAGLE 门面把 draft / verify / extend 串成一步;Scheduler 只调 draft_worker.forward_batch_generation。
5. 生命周期 Prefill → Decode
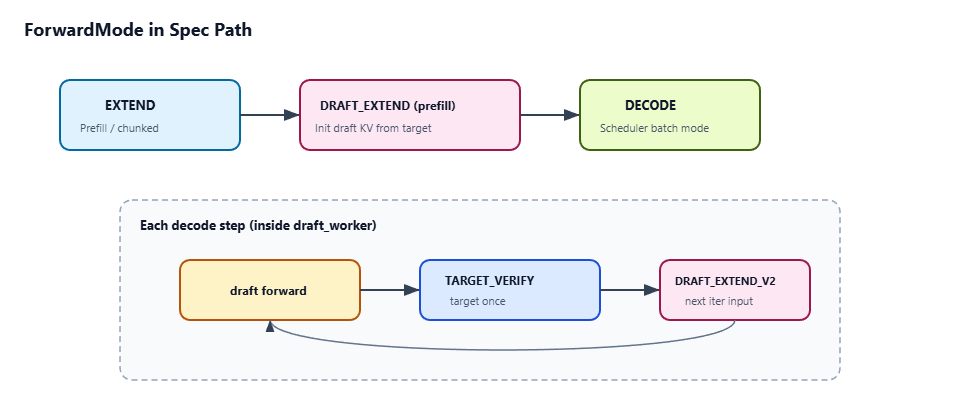
ForwardMode | 谁跑 | 典型场景 |
|---|---|---|
EXTEND / DECODE | target | prefill、无 spec 单 token |
TARGET_VERIFY | target | 一次验整棵 draft 树/链 |
DRAFT_EXTEND_V2 | draft | 接受后写回 draft KV |
DECODE(draft runner) | draft | 多步 draft 自回归 |
| Prefill 后 target hidden 喂给 draft,使 draft KV 与已提交 prefix 对齐;decode 循环只在 verify 成功后 extend。 |
5.1 一次 chat/completions ≠ 投机一次
投机挂在每个 decode 步上,不是整次 API 只跑一轮 draft→verify。
POST /v1/chat/completions          ← 一次请求 / 整段生成
  └─ Prefill(prompt)
  │     target EXTEND → draft_extend_for_prefill(对齐 draft KV)
  │     ※ 这里不做「猜下一串」那种 decode 投机
  └─ Decode 循环(直到 EOS / max_tokens / stop)
        第 1 步: draft → verify → accept N+bonus → draft_extend
        第 2 步: 再 draft → verify → ...
        第 k 步: 同样,每步都争取多收下几个 token
| 粒度 | 含义 |
|---|---|
| 一次 API / 一个请求 | 整段生成(许多 decode 步) |
| 一次投机(一步) | 一轮 draft → verify → extend,本步尽量多产出 |
spec_verify_ct | 该请求里 verify 次数 ≈ decode 步数 |
spec_accept_length | 平均每步产出多少 token(含 bonus) |
| 所以:调用一次接口会经历 很多轮 投机;每一轮都在「这次 target verify 里多收下几个 token」。 |
6. EAGLE 一步拆解
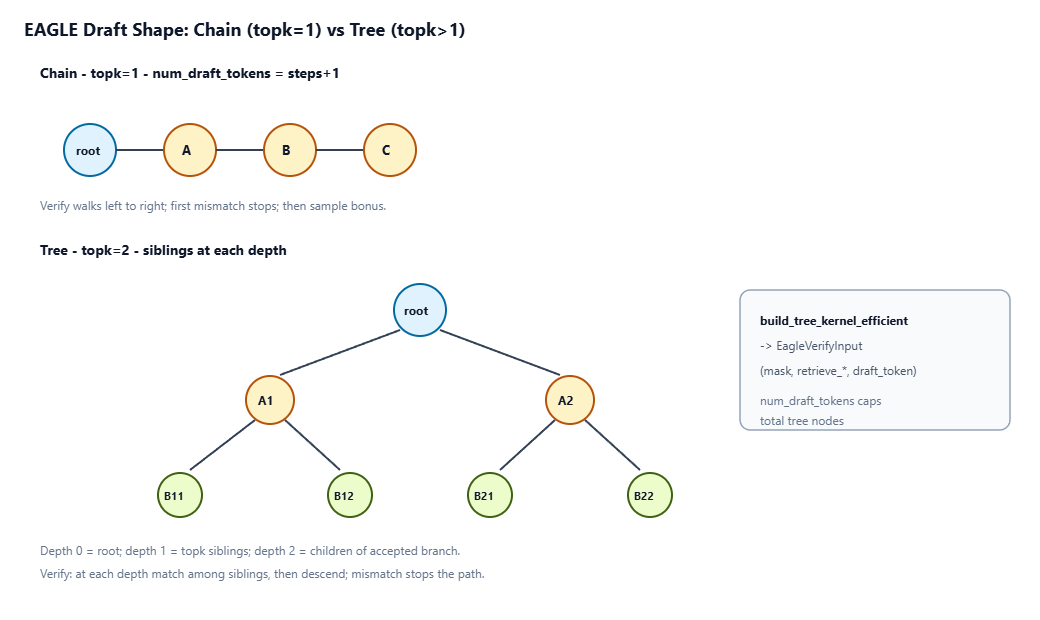
Draft — EagleDraftWorker.draft():分配 draft slot,循环 speculative_num_steps 次 top-k 采样,构建树 mask 与 draft_token_ids。
Verify — EAGLEWorkerV2.verify():把树展平成 verify batch,target 一次 forward 得各位置 logits,再进 eagle_sample()。
Extend — _draft_extend_for_decode():用已接受 token + bonus 更新 draft KV,为下一步 draft 对齐状态。
| 参数 | 几何含义 | 典型 Llama |
|---|---|---|
num_steps | draft 自回归深度(层数) | 5 |
eagle_topk | 每层分支数(1=链,>1=树) | 4 |
num_draft_tokens | verify 窗口 / 树节点上限 | 8 |
| 约束 | topk=1 → 强制 num_draft_tokens = num_steps+1 | 链式 |
6.1 Chain(eagle_topk = 1)— 单路径投机
Chain 是没有分叉的草稿序列:每一步 draft 只保留 1 个 下一 token,形成一条链。
root → A → B → C → … (长度受 num_steps 限制)
| 概念 | Chain 下的含义 |
|---|---|
num_steps | 链上最多猜几步(不含 root / 与 bonus 的记账方式见下) |
eagle_topk | 固定为 1(无 sibling) |
num_draft_tokens | 强制 = num_steps + 1(hook 自动改) |
| draft 行为 | 每步 argmax/采样 1 个 token,接到上一 token 后面 |
| verify 行为 | 从左到右检查;第一个不匹配就停,后面全丢 |
| 接受后 | 再采 1 个 bonus(保证至少前进 1) |
例子(num_steps=3,故 num_draft_tokens=4): |
Draft 提出:     A → B → C
Target greedy:  A → B → X

→ 接受 A、B;在 B 后停止;bonus ≈ X
→ 本步输出: A, B, bonus    (correct_drafts=2,accept_lens=3)
若第一层就不匹配:correct=0,只输出 1 个 bonus → 退化为普通 AR(还多付了 draft 成本)。
Chain 适合:
- 要开 rejection sampling / Adaptive(二者都要求
topk=1) - attention backend 限制(如部分
trtllm_mha仅 topk=1) - 想要实现简单、调试 greedy「相等就接受」
Chain 代价: 没有备用分支;一步猜错,整条后缀作废,平均 τ 可能低于宽树。
6.2 Tree(eagle_topk > 1)— 分层兄弟候选
Tree 在每一层保留 topk 个 sibling:draft 不是赌一条路,而是长出一棵候选树,再在 verify 时按层挑选。
              root
           /        \
         A1          A2          ← depth 1,topk=2 个 sibling
       /    \      /    \
     B11   B12   B21   B22     ← depth 2
| 概念 | Tree 下的含义 |
|---|---|
num_steps | 树的最大深度(展开几轮) |
eagle_topk | 每层保留几个候选(分支因子) |
num_draft_tokens | 一次 verify 能装下的节点总数上限(含结构节点) |
| draft 行为 | 每步对当前层节点做 top-k,再 build_tree_kernel_efficient 建 mask / retrieve 索引 |
| verify 行为 | 按深度:在当前层 sibling 里找匹配 → 下钻到其子树;本层全失败则 STOP |
| 接受后 | 同样追加 1 个 bonus |
| Verify 怎么走树(greedy 直觉): |
depth=1: 在 {A1, A2} 里找是否有 token == target_argmax
         命中 A1 → 进入 A1 的孩子
depth=2: 在 {B11, B12} 里继续匹配
         未命中 → 停止,后面节点全部拒绝
最后: 在最后接受位置采 bonus
因此:树宽(topk)提高的是「每层猜错一条仍有兄弟可试」的容错;树深(steps)提高的是「猜对时能连吃多远」。二者都受 num_draft_tokens 预算卡住——节点太多 verify batch / 显存会爆。
Tree 适合:
- EAGLE-2 默认宽树(如 Llama
topk=4)冲更高 accept_rate / τ - 负载上 draft 常「差一点猜对」、需要 sibling 兜底
Tree 代价 / 约束: - verify 算力与 attention mask 更复杂(custom tree mask)
topk>1+page_size>1仅部分 backend(flashinfer / fa3 / triton)- 不能开 rejection sampling、不能开 Adaptive(需 topk=1)
- draft 与 graph 显存通常高于链
6.3 Chain vs Tree 对照
Chain (topk=1) | Tree (topk>1) | |
|---|---|---|
| 形状 | 单路径 | 每层多个 sibling |
num_draft_tokens | 强制 steps+1 | 独立设定(节点预算) |
| 猜错时 | 整条后缀作废 | 同层还可试兄弟 |
| Adaptive / rejection | ✅ | ❌ |
| 典型用途 | MTP 链、调试、自适应 steps | EAGLE-2 冲吞吐 |
| 参数直觉 | 主要调 num_steps | 联调 steps × topk × draft_tokens |
粗上界(节点数,未剪枝时):树节点量级随 topk^steps 膨胀,故必须用 num_draft_tokens 截断;build_tree_kernel_efficient 负责在预算内选出实际送去 verify 的节点与 mask。 |
7. 接受判定三条路径
判定入口唯一:eagle_utils.eagle_sample()。Target 已对整棵 draft 树做完一次 forward,得到各位置 logits。
共同规则:
- 从左到右(树则按层)检查 draft token。
- 某层拒绝 → 该层之后全部丢弃(不回头试更深层)。
- 无论接受几个 draft,最后一定再采 1 个 bonus(保证至少前进 1;分布贴近 target)。
因此accept_lens = num_correct_drafts + 1;accept_lens - 1= 本步猜对的 draft 数。
| 路径 | 条件 | 接受判定 | 需要 draft 概率 q? |
|-|-|-|-|
| A Greedy | temp≈0 / greedy |draft == target argmax| 否 |
| B Target-only | 默认随机 |coin ≤ 累计p/θ_acc或p ≥ θ_single| 基本不用 |
| C Rejection |--speculative-use-rejection-sampling|coin * q < p| 是 |
7.1 路径 A:Greedy
条件:is_all_greedy,或 NPU/HIP/XPU 等走 greedy 实现。
for depth in 1 .. max_depth:
    target = argmax(target_logits at current node)
    if some sibling draft_token == target:
        ACCEPT; go to its children
    else:
        STOP   # 本层及之后全部拒绝
# 再从「最后接受位置」采 / 写 bonus
例子(链,topk=1):
Draft:          A → B → C
Target argmax:  A → B → X
→ 接受 A、B;在 C 处停;bonus 从 B 后采(常为 X)
→ correct_drafts=2, accept_lens=3
第一层就不匹配 → correct=0,只输出 1 个 bonus(退化为普通 AR,仍付 draft 成本)。
代码:verify_tree_greedy_func → kernel(sibling 上 draft_token == target_token)。
7.2 路径 B:默认随机(target-only)
条件:非 greedy,且未开 rejection sampling → tree_speculative_sampling_target_only。
对每个候选:p = target_probs[draft_token];层内对 sibling 累加 prob_acc,用 coin ~ U(0,1):
if coin <= prob_acc / threshold_acc  OR  p >= threshold_single:
    ACCEPT
else:
    试下一 sibling;本层全失败则 STOP
| CLI | 默认 | 管什么 |
|---|---|---|
--speculative-accept-threshold-single | 1.0 | 单 token 快通:p ≥ θ_single 直接接受。默认 1.0 → 几乎只有 p≈1 才靠这条 |
--speculative-accept-threshold-acc | 1.0 | 累积 roulette:接受概率从 p 抬到 min(1, p/θ_acc)。默认 1.0 → 按 target 概率在 sibling 上抽 |
默认双阈值=1.0:本层按 target 概率做累积抽样;抽中某个 draft sibling 就下钻,一个都抽不中就停。draft_probs 常被置零占位——主要看 target 概率,不是完整 draft-vs-target 比值。 |
拒绝后 bonus:从 relu(target_probs - draft_probs) 残差采。
7.3 路径 C:Rejection sampling
条件:--speculative-use-rejection-sampling,且通常 topk=1(链)。
p = TargetProbs[draft_token]   # target 给该 token 的概率
q = DraftProbs[draft_token]    # draft 提出该 token 时的概率
coin ~ Uniform(0,1)            # 代码里的 coin / u
accept if  coin * q < p        # 即 u < p/q(q>0)
| 符号 | 含义 |
|---|---|
| p | target 在该位置对 draft token 的概率 |
| q | draft 模型对该 token 的概率 |
| coin | U(0,1) 随机数 |
直觉:接受概率 = min(1, p/q)。q ≤ p 时几乎必接受;draft 过高估则以 p/q 概率收下。拒绝后从 relu(p-q) 归一化采 bonus(理论无偏)。 |
代码:reject_sampling.py(coin * q < p)。
7.4 对照与 bonus
| Greedy | Target-only(默认) | Rejection | |
|---|---|---|---|
| 接受条件 | draft == argmax | coin≤累计p/θ_acc 或 p≥θ_single | coin * q < p |
| 需 q? | 否 | 基本不用 | 是 |
| 无偏复现 target? | greedy 本身 | 近似 / 依赖阈值 | ✅ |
✏️
为何总有 bonus: target 在「最后接受前缀」之后再采 1 个,保证每步至少前进 1,且输出分布贴近 target。accept_lens - 1 = num_correct_drafts(不含 bonus 的 draft 数)。
7.5 Bonus 会不会多出「不想要的」token / 更容易幻觉?
不会。 常见误解是:已经接受了 N 个 draft,再强制 +1 就是多塞了一个不该有的字。
正确对照普通 AR:
普通 AR 每步:     从 target 采 1 个 token
投机 一步:        收下 N 个 target 同意的 draft 前缀
                  + 再像 AR 一样从 target 采 1 个  ← 这就是 bonus
本步产出:         N 个 correct + 1 个 bonus
| 部分 | 实质 |
|---|---|
| N 个 correct | target 也会写出的前缀(greedy=argmax;rejection=按概率无偏收下) |
| +1 bonus | 没有投机时下一步也会从 target 采到的那个(rejection 用残差分布保无偏) |
| 因此: |
- Bonus 不是 draft 乱编,而是 target 自己采的下一个。
- 幻觉能力上界仍是 target 模型本身;投机只改速度,不单独开一条「更容易胡说」的通道。
- 若觉得 bonus「不是想要的」,关掉投机、只跑 AR,同分布下下一步同样会采到类似内容。
- 唯一可能轻微偏分布的是默认 threshold 近似路径,不是「多了一个 bonus」本身。
8. 命名:accept / correct / bonus
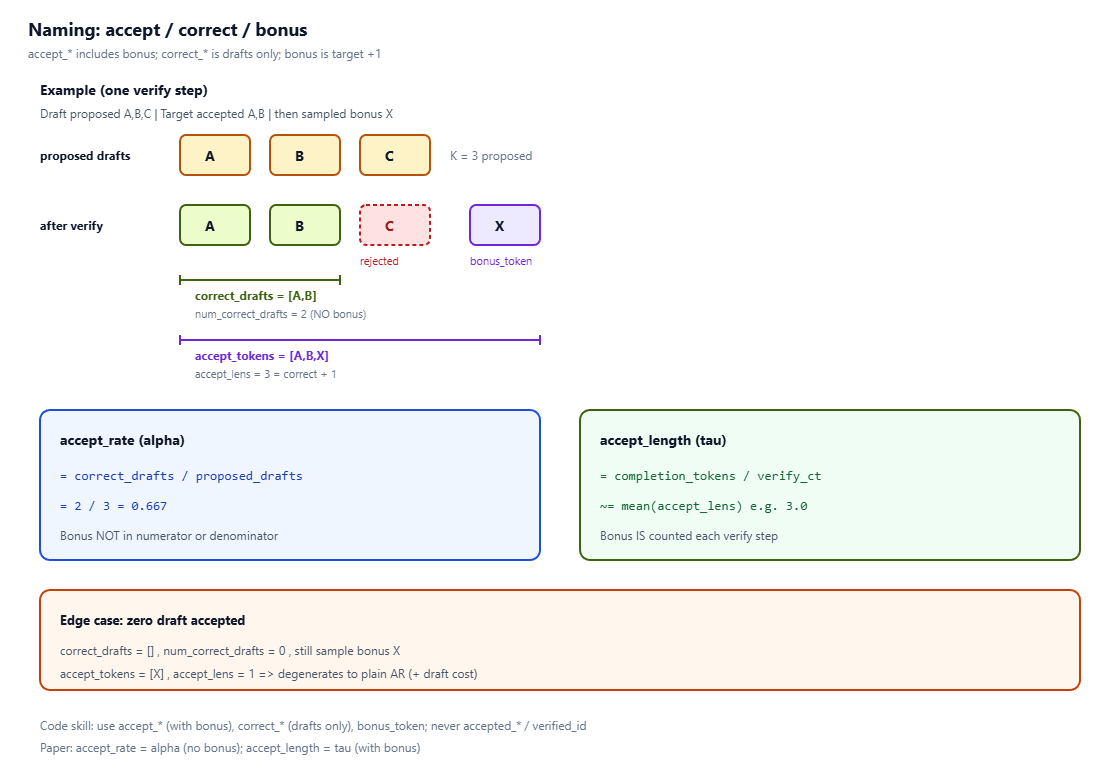
SGLang 投机路径里,动词决定是否含 bonus:
| 动词 / 名 | 含 bonus? | 含义 |
|---|---|---|
correct_* | 否 | 猜对的 draft(被 verify 接受的候选) |
accept_* | 是 | 本步真正写入序列的 token(correct + bonus) |
bonus_token(s) | 自身 | target 在接受前缀之后采的 +1(= 普通 AR 的「下一个」) |
accept_rate(指标 α) | 否 | 论文约定:只看 draft 准不准 |
accept_length(指标 τ) | 是 | 论文约定:每步推进多少 token |
不要用 accepted_*、verified_id 等旧说法指 bonus。 |
投机路径:指开启投机解码后的那套代码/字段(speculative/、spec 计数、meta_info 等),相对普通 AR。不是说 greedy / rejection 某一条 accept 算法。
动词:指标识符名字里的前缀词。
8.1 一步里发生了什么
proposed drafts:   A   B   C          # draft 提出,K=3
verify 结果:       A   B   ✗C         # A,B 对;C 拒绝 → 后面全丢
再采 bonus:                    X      # 无论 correct 几个,一定有
写入序列:          A   B   X
| 字段 | 本例取值 |
|---|---|
correct_drafts / num_correct_drafts | [A,B] / 2 |
bonus_token | X |
accept_tokens | [A,B,X] |
accept_lens | 3 = 2 + 1 |
| 恒等式(每步、每个 req): |
accept_lens = num_correct_drafts + 1
num_correct_drafts = accept_lens - 1
8.2 两个指标别混
| 指标 | 公式(本例) | Bonus |
|---|---|---|
accept_rate α | correct / proposed = 2/3 ≈ 0.667 | 不进分子分母 |
accept_length τ | 多步平均 accept_lens;或 completion_tokens / verify_ct | 计入 |
粗关系(链、每步提 K 个 draft):τ ≈ α·K + 1。 |
8.3 边界:0 个 draft 仍有 1 个 bonus
correct_drafts = [] , num_correct_drafts = 0
accept_tokens  = [X] , accept_lens = 1
语义上仍前进 1 token(分布跟 target 一致),但多付了 draft 成本 → 加速公式里 τ≈1 且 r>0 时 比普通 AR 慢。这不是「完全失败无输出」,而是「投机没赚到」。
8.4 代码落点
| 名称 | 含义 | 计入 τ? | 计入 α? |
|---|---|---|---|
num_correct_drafts | 本步接受的 draft 数 | 是(τ 的主体) | 是(分子) |
bonus_token | 拒绝点后 target +1 | 是(+1) | 否 |
accept_lens | 本步写入总长 | 是 | — |
spec_verify_ct | verify 次数 | τ 的分母 | — |
num_proposed_drafts | 累计提出的 draft | — | α 的分母 |
batch_result_processor._resolve_spec_v2_tokens 按 accept_lens 展开 token,更新上述计数与 KV。 |
9. 关键数据结构
classDiagram
    class SpecInput {
        +spec_info fields
    }
    class EagleVerifyInput {
        +draft_token_ids
        +custom_mask
        +positions
    }
    class EagleDraftOutput {
        +topk_p / topk_index
    }
    SpecInput <|-- EagleVerifyInput
    EagleDraftOutput --> EagleVerifyInput : build tree
| 结构 / 类型 | 文件 | 作用 |
|---|---|---|
SpeculativeAlgorithm | speculative/spec_info.py | 算法枚举 + worker 工厂 |
EagleVerifyInput | speculative/eagle_info.py | verify batch 树形输入 |
ForwardMode | model_executor/forward_batch_info.py | TARGET_VERIFY 等 |
FutureMap | managers/overlap_utils.py | overlap 时 stash 上步 token |
SpecRuntimeState | speculative/eagle_worker_v2.py | adaptive tier 状态 bundle |
10. Scheduler / Overlap / CUDA Graph
Scheduler 在 spec 开启时仍只调一次 model_worker.forward_batch_generation;差别是 worker 指向 draft_worker,内部串 draft → verify → draft_extend。Overlap 与 CUDA Graph 正交:前者叠 CPU schedule vs GPU extend,后者叠 kernel launch 开销。
10.1 Scheduler 入口
| 点 | 行为 |
|---|---|
enable_overlap | not disable_overlap_schedule(且非 MLX 特例) |
| resolve | 每步开始 resolve_forward_inputs / resolve_seq_lens_cpu |
| publish(spec) | verify 之后、extend 之前 调 FutureMap.publish |
| publish(非 spec) | worker 返回后由 Scheduler 发布 seq_lens+1 |
10.2 Overlap:为什么 mid-step publish
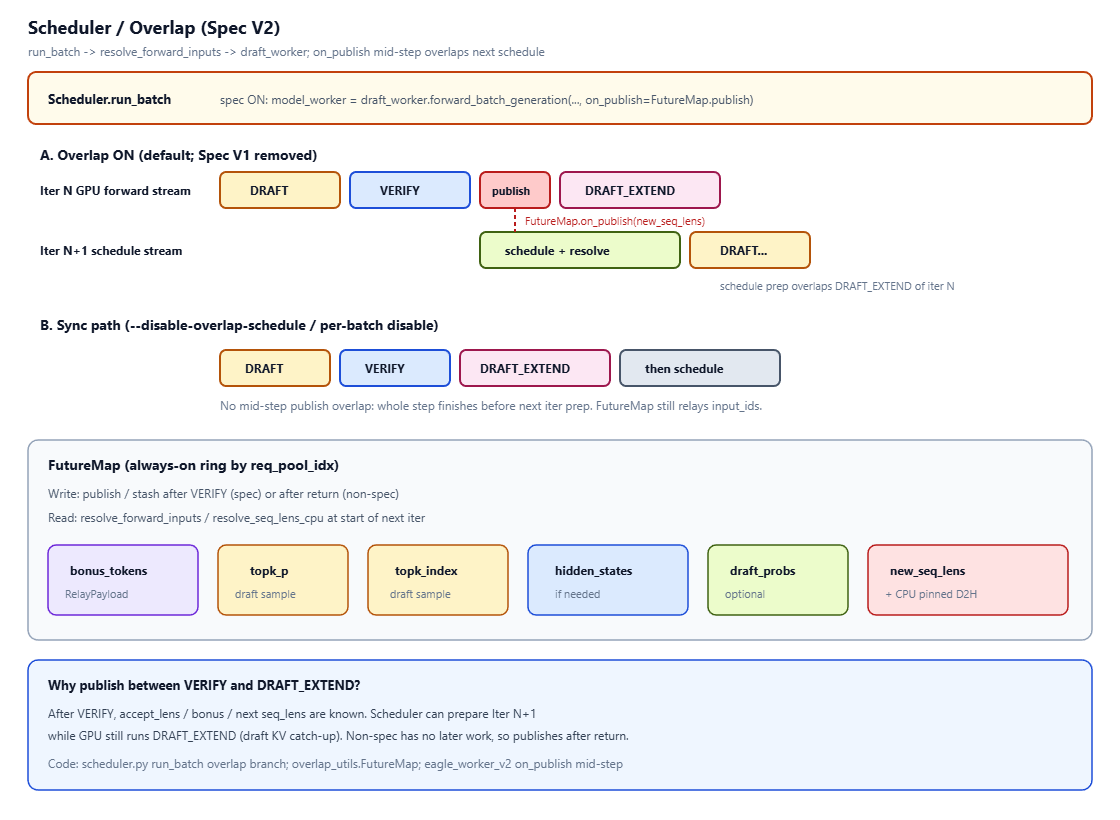
VERIFY 结束时已知道 accept_lens / bonus_tokens / new_seq_lens,可以立刻 stash,让 Iter N+1 的 schedule + resolve 与 Iter N 的 DRAFT_EXTEND 并行。
| 模式 | 时间线 | 触发 |
|---|---|---|
| Overlap ON(默认) | DRAFT → VERIFY → publish → DRAFT_EXTEND;下一 iter 的 schedule 从 publish 起叠 | Spec V2 |
| Sync | DRAFT → VERIFY → DRAFT_EXTEND → 再 schedule | --disable-overlap-schedule 或 is_disable_overlap_for_batch |
FutureMap(overlap_utils.py)按 req_pool_idx 做 ring;写用 publish/stash,读用 resolve_forward_inputs / resolve_seq_lens_cpu。 | ||
| 字段 | 用途 | |
| - | - | |
bonus_tokens | 上步 bonus → 本步 draft/verify 根 | |
topk_p / topk_index | draft 采样接力 | |
hidden_states | EAGLE 需要时 | |
draft_probs | 可选 | |
new_seq_lens(+ CPU pinned D2H) | 下一 iter 长度 / 分配 |
10.3 CUDA Graph:三套 runner
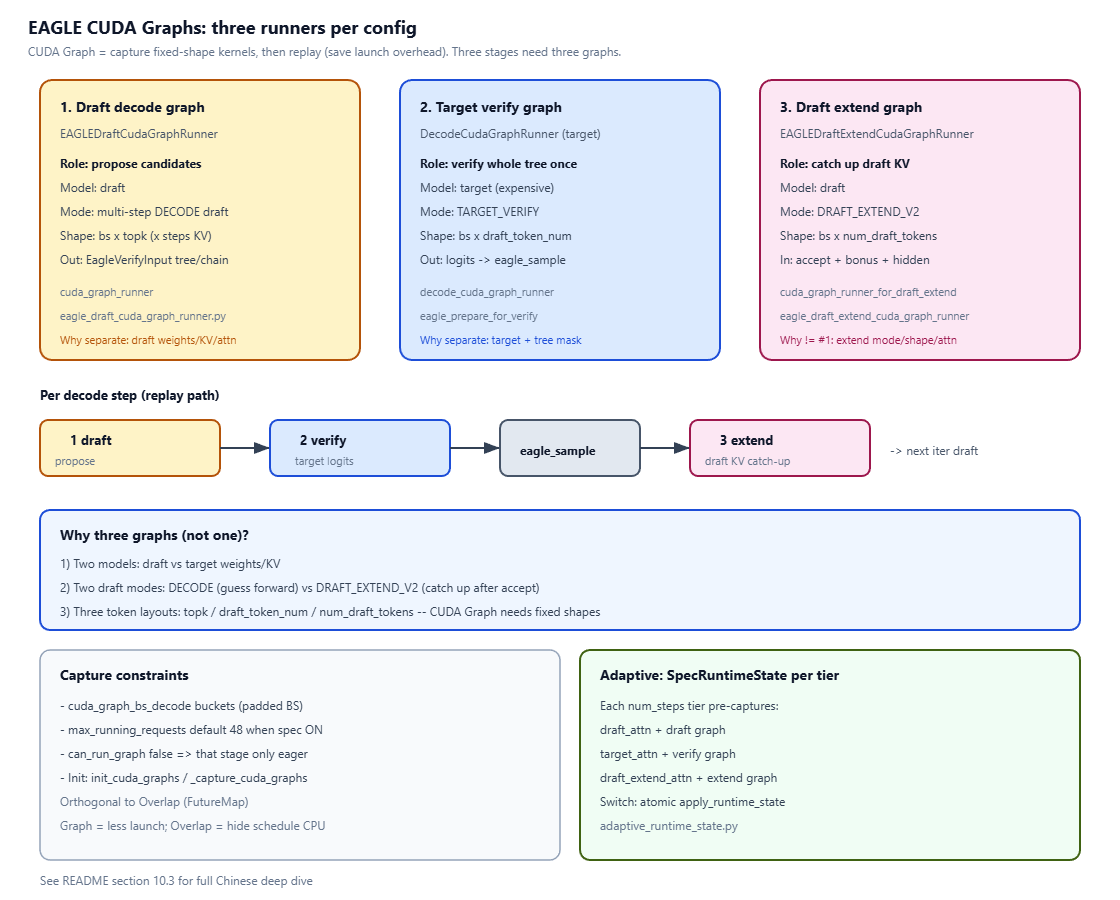
先记住:CUDA Graph 在干什么
CUDA Graph 把「一组固定形状的 GPU kernel」录成可 replay 的图,省掉每步 CPU 侧的 launch / 调度开销。
投机一步有 三个 GPU 阶段、两套模型、三种 token 布局,所以不能共用一张 graph——每阶段各自 capture 一套 runner。
decode 一步:
  [1 draft graph]  draft 模型多步猜候选
       ↓
  [2 verify graph] target 模型一次验整棵树/链
       ↓
  [3 extend graph] draft 模型按接受结果补 KV
       ↓
  下一 decode 步再从 [1] 开始
| Runner | 类 | 模型 | ForwardMode | 形状轴(capture 时钉死) |
|---|---|---|---|---|
| Draft decode | EAGLEDraftCudaGraphRunner | draft | draft 的 DECODE 多步 | bs × topk(再 × num_steps 写 KV) |
| Target verify | target DecodeCudaGraphRunner | target | TARGET_VERIFY | bs × draft_token_num |
| Draft extend | EAGLEDraftExtendCudaGraphRunner | draft | DRAFT_EXTEND_V2 | bs × speculative_num_draft_tokens |
Init:EAGLEWorkerV2.init_cuda_graphs → draft 侧 _capture_cuda_graphs;target 侧用 model_runner.decode_cuda_graph_runner(verify 时 eagle_prepare_for_verify 里 can_run_graph / load_batch)。 |
Runner 1:Draft decode —「便宜地多猜几步」
- 文件 / 字段:
eagle_draft_cuda_graph_runner.py;挂在EagleDraftWorker.cuda_graph_runner。 - 做什么: 把 draft 模型的 多步自回归 draft(
draft_forward×speculative_num_steps)录进 graph。每步对当前节点做 top-k,长出链或树,最后产出EagleVerifyInput。 - 为何单独一套: 跑的是 draft 权重 + draft KV + draft attn;每 req token 数 ≈
topk(num_tokens_per_bs = topk);缓冲含topk_p/topk_index/hidden_states(EagleDraftInputBuffers)。 - 作用一句话: 加速「提出候选」——否则每步 draft 的 launch 会吃掉投机省下的时间。
Runner 2:Target verify —「一次 forward 验整块」
- 文件 / 字段: target 的
DecodeCudaGraphRunner(model_runner.decode_cuda_graph_runner);eagle_prepare_for_verify里can_run_graph/load_batch。 - 做什么: target 对整棵 draft 树/链做 一次
TARGET_VERIFY,得到各位置 logits,再交给eagle_sample做 accept/reject + bonus。 - 为何单独一套: 跑的是 target 大模型 + 主 KV;每 req token 数 =
draft_token_num(树节点总数),注意力是 tree mask,不是普通单 token decode。 - 作用一句话: 加速「验候选」——投机里最贵的 GPU 段;graph 压大模型 verify 的 launch 开销。
Runner 3:Draft extend —「接受后把 draft KV 追上」
- 文件 / 字段:
eagle_draft_extend_cuda_graph_runner.py;cuda_graph_runner_for_draft_extend。 - 做什么: verify 后用 已接受 token + bonus(及 target hidden)做
DRAFT_EXTEND_V2,把 draft KV / 隐状态对齐到已提交前缀,供 下一步 draft 接着猜。 - 为何不能复用 Runner 1: 同是 draft 模型,但模式不同(向前猜 vs 按 accept 补历史);宽度按
speculative_num_draft_tokens;用draft_extend_attn_backend;缓冲含num_correct_drafts/num_accept_tokens。 - 作用一句话: 加速「状态对齐」——没有这一步下一步 draft 会站错前缀;有 graph 则 catch-up 不拖慢整步。
三者如何串起来
| 问题 | 答案 |
|---|---|
| 为什么三套不是一套? | 两模型 × 两 draft 模式(猜 / 补 KV)× 三种 token 布局 |
can_run_graph 失败? | 仅该 stage eager,其它仍可走 graph |
| Adaptive 更费显存? | 每个 num_steps tier 一份 SpecRuntimeState(三套 attn + 三套 graph) |
| 与 Overlap? | 正交:Graph 省 launch;Overlap 叠 schedule CPU 与 extend GPU |
| 与 max_running_requests=48? | 限制 graph 最大 BS / 预分配(§3.1) |
Capture 分桶:cuda_graph_bs_decode。NPU/XPU 等有同三阶段划分的 device runner 子类。 |
11. 其它算法
| 算法 | Draft 机制 | Verify | 特殊点 |
|---|---|---|---|
| STANDALONE | 独立小 LM | 同 EAGLE 树/链 | 不共享 embed |
| NGRAM | 历史 n-gram 查表 | eagle_sample | 无 draft 模型 KV |
| DFLASH | block 候选 | dflash_utils | num_steps=1 |
| FROZEN_KV_MTP | 读 target KV | MTP 头 | Gemma4 类 |
MTP 无独立 enum:DeepSeek/Qwen 走 EAGLE/NEXTN + 内置 MTP 头。 |
12. Adaptive
运行时按 EMA 接受长度切换 num_steps tier
开启:--speculative-adaptive。硬要求:
- 仅
EAGLE算法 - 仅
--speculative-eagle-topk 1(链式,便于 tier 间 graph 复用) - 默认候选 tier:
[1, 3, 7],每 tier 预构建 draft/verify/extend graph
13. 指标与读数
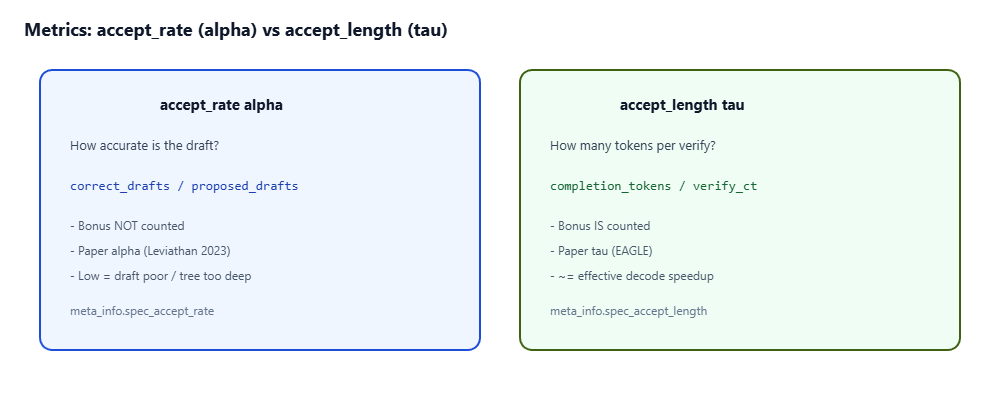
| 指标 | 公式直觉 | 含 bonus? | 回答什么问题 |
|---|---|---|---|
spec_accept_rate (α) | num_correct_drafts / num_proposed_drafts | 否 | draft 猜得准不准 |
spec_accept_length (τ) | completion_tokens / spec_verify_ct | 是 | 每步实际推进多少 |
spec_verify_ct | verify 次数 | — | 跑了多少次 verify |
num_proposed_drafts | verify_ct × (num_draft_tokens-1) | — | 累计提出多少 draft |
别混: rate = 命中率,length = 步长;链上粗关系 τ ≈ α·K + 1。 |
例子: num_draft_tokens=5(K=4 draft/步),10 次 verify,接受 25 draft,completion=35:
spec_accept_rate = 25 / (10×4) = 0.625spec_accept_length = 35 / 10 = 3.5(25 draft + 10 bonus)
pie title 单步 token 构成 (accept_length=3.5)
    "correct drafts" : 2.5
    "bonus" : 1
| 你想看的问题 | 读哪个 |
|---|---|
| draft 猜得准不准 | spec_accept_rate |
| 每步实际推进多少 token | spec_accept_length |
| 投机是否几乎无效 | verify_ct 高 + accept_rate 低 |
| 客户端单请求 | meta_info.spec_* 字段 |
| 集群负载 | /v1/loads → SpeculativeMetrics |
14. 调参与坑
OOM 提示:
- 开 spec 后
max_running_requests默认降至 48(原因见 [§3.1](#31-为何开-spec-时-max_running_requests-默认降到-48))。 num_draft_tokens越大 verify batch 越大,显存涨。- adaptive 会为每个 tier 各 capture graph,显存 × tier 数。
- 先降
mem-fraction-static或num_draft_tokens,再减并发。
15. 源码阅读路线
| 顺序 | 文件 | 链接 |
|---|---|---|
| 1 | speculative/spec_info.py | GitHub |
| 2 | arg_groups/speculative_hook.py | GitHub |
| 3 | managers/scheduler.py | GitHub |
| 4 | speculative/eagle_worker_v2.py | GitHub |
| 5 | speculative/eagle_utils.py | GitHub |
| 6 | speculative/reject_sampling.py | GitHub |
| 7 | managers/scheduler_components/batch_result_processor.py | GitHub |
| 8 | managers/tokenizer_manager.py | GitHub |
16. FAQ 速答
1. Greedy 下「接受」条件?一层拒绝后后面怎么办?
draft_token == argmax(target_logits)(当前层 sibling 里找相等)。某层找不到 → 立刻 STOP,该层及之后全部丢掉;再从最后接受位置采 1 个 bonus。
2. 默认随机路径里 threshold_single / threshold_acc 各管什么?
threshold_single(默认 1.0):单 token 快通,p ≥ θ直接接受。threshold_acc(默认 1.0):累积 roulette,coin ≤ 累计p/θ;默认等价按 target 概率在 sibling 上抽。
3. Rejection sampling 的coin * q < p里 p、q、coin 是什么?
p = target 概率,q = draft 概率,coin ~ U(0,1)。接受概率 = min(1, p/q)。
4. 为什么无论接受几个 draft 都会多一个 bonus?accept_lens - 1 是什么?
bonus = 在接受前缀上做一次普通 target 采样(不是多余乱编)。accept_lens = num_correct_drafts + 1,故 accept_lens - 1 = 本步接受的 draft 数。
5. model_worker 在 spec 开启时指向谁?verify 谁跑?
model_worker = draft_worker(如 EAGLEWorkerV2)。Scheduler 只调它的 forward_batch_generation;内部 verify 由 target(tp_worker)跑 TARGET_VERIFY,draft 只跑 draft / draft_extend。
6. spec_accept_rate 与 spec_accept_length 差在哪?
| 指标 | 公式直觉 | Bonus |
|---|---|---|
spec_accept_rate (α) | 接受 draft / 提出 draft | 不含 |
spec_accept_length (τ) | 每步写入 token 均值 / completion / verify_ct | 含 |
粗关系(链):τ ≈ α·K + 1。 |
7. 有了 bonus(N+1),会不会更容易幻觉?
不会。N 个 correct 是 target 同意的前缀;+1 bonus 是 没有投机时下一步也会从 target 采到的那个。幻觉上界仍是 target 本身。
8. 一次 chat/completions 是投机一次,还是每轮 decode 都投机?
每个 decode 步都投机。一次 API = Prefill(对齐 draft)+ 许多轮 draft→verify→extend,每轮争取多产出几个 token;spec_verify_ct ≈ 步数。
阅读导航



