
FlashAttention V1 到 V4:分块、在线 Softmax 与演进
FlashAttention 从 0 到 1:从 V1 到 V4 的完整进化史
面向读者:第一次认真学 FlashAttention,但希望读完后能解释清楚“为什么快”、知道“每一版改了什么”、并能在工程里正确用起来的同学。
覆盖范围:FlashAttention(v1, 2022)→ FlashAttention‑2(2023/2024)→ FlashAttention‑3(2024,Hopper/H100)→ FlashAttention‑4(2026,Blackwell/B200)。
关键词:IO‑aware、HBM vs SRAM、tiling、online softmax、数值稳定、并行/分工、异步流水、warp specialization、FP8、2‑CTA MMA、pipeline co‑design。
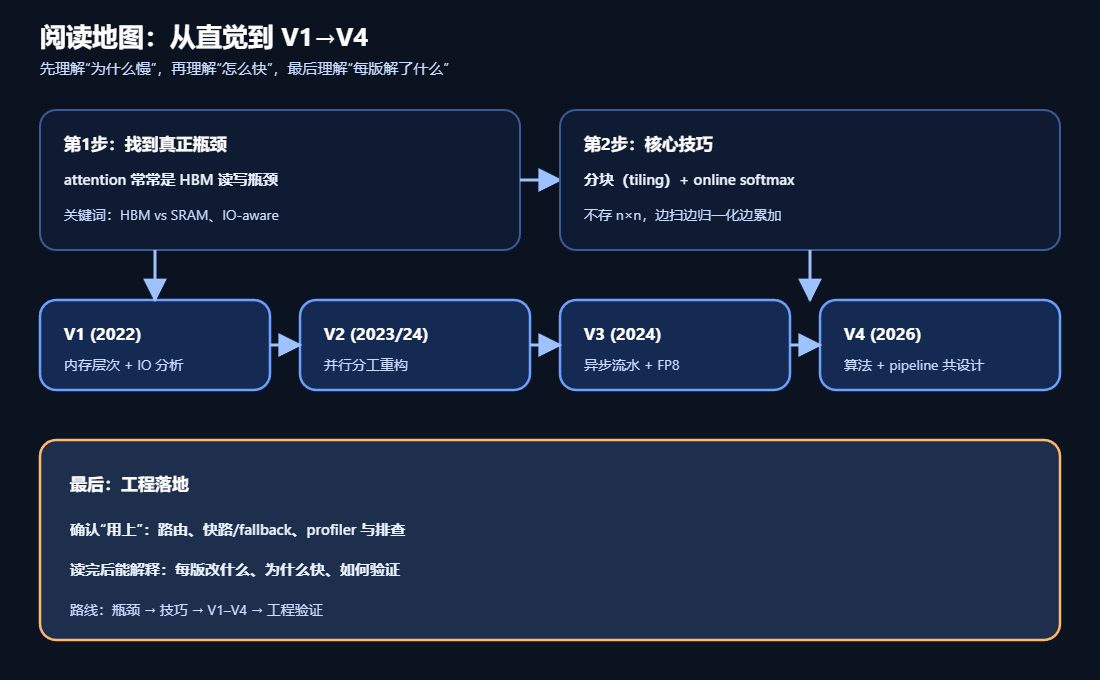
阅读地图(建议先看这张图)
0. 预备知识:要读懂 FlashAttention,你只需要补齐这 3 件事
FlashAttention 的论文和实现都偏“硬件味”,但对新手来说,真正需要的前置并不多,主要是:
- (A) Attention 的数学结构:你要清楚 的形状、两次 GEMM 在算什么、softmax 在哪一维做归一化。
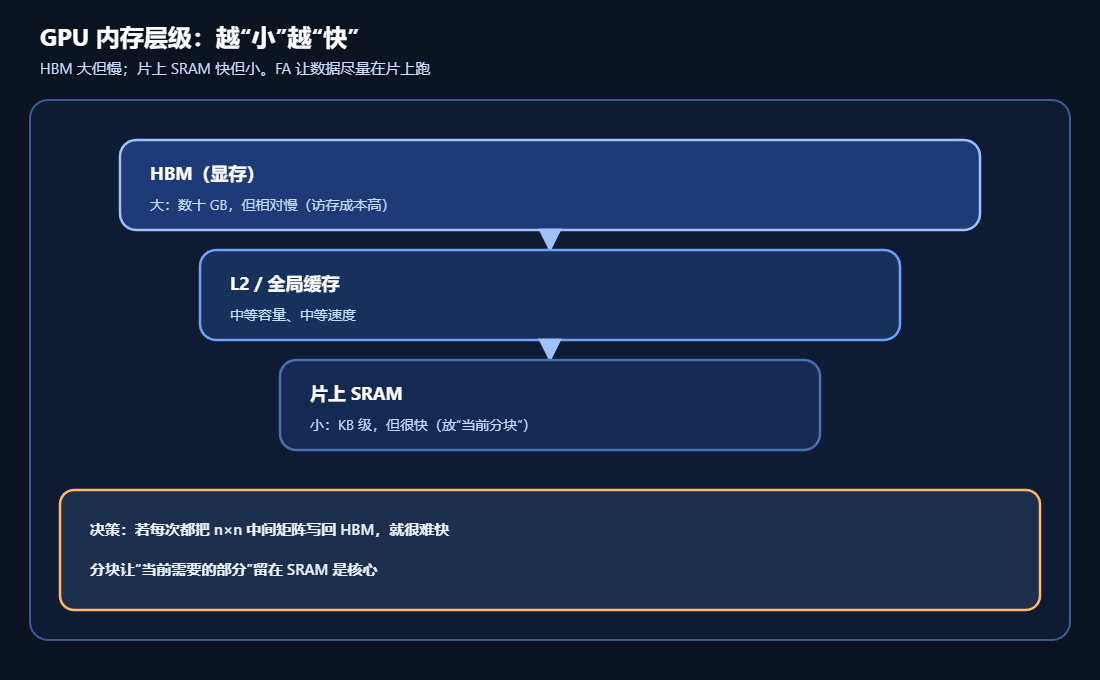
- (B) GPU 的内存层级:HBM(显存)很大但慢,SRAM(寄存器/共享内存/L1 等片上存储)很小但快。
- (C) 一个直觉:注意力经常是 memory-bound:瓶颈不是 FLOPs,而是“把数据搬来搬去”的带宽与中间结果写回。
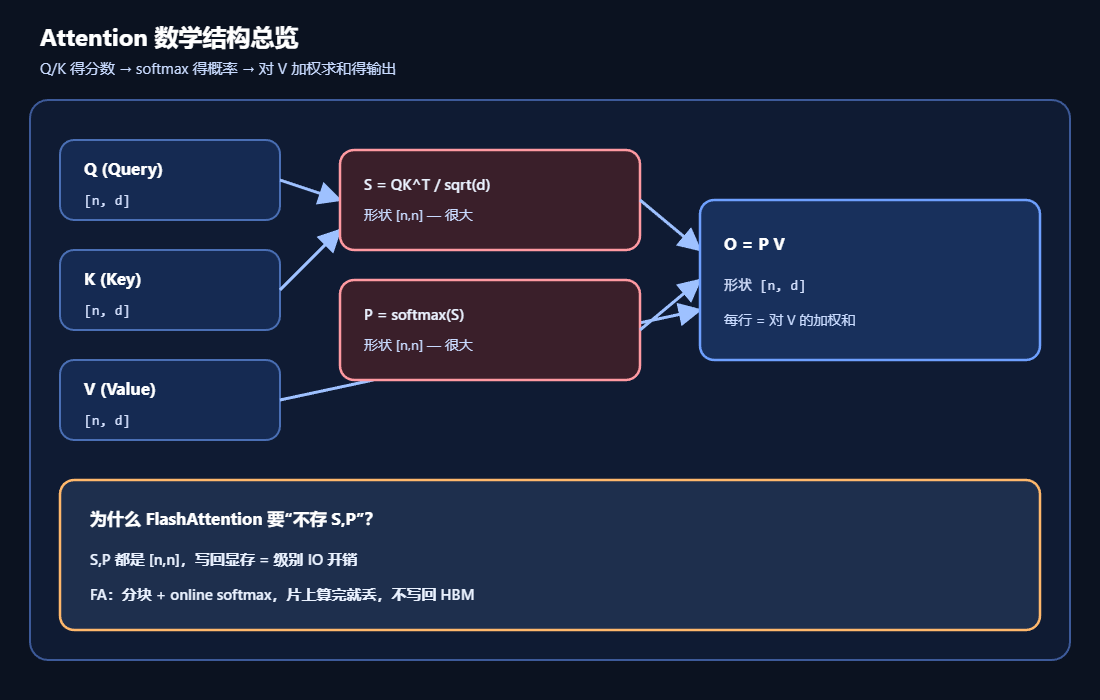
0.1 标准 attention 为什么慢:不是你不会写 GEMM,而是你在写一个巨大的
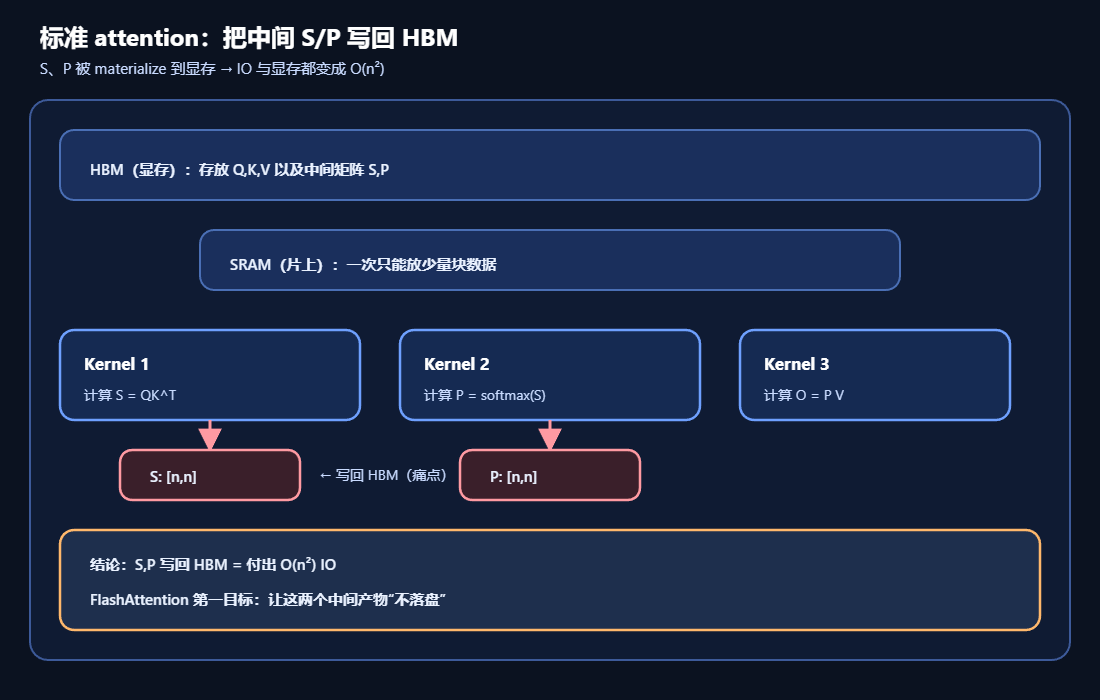
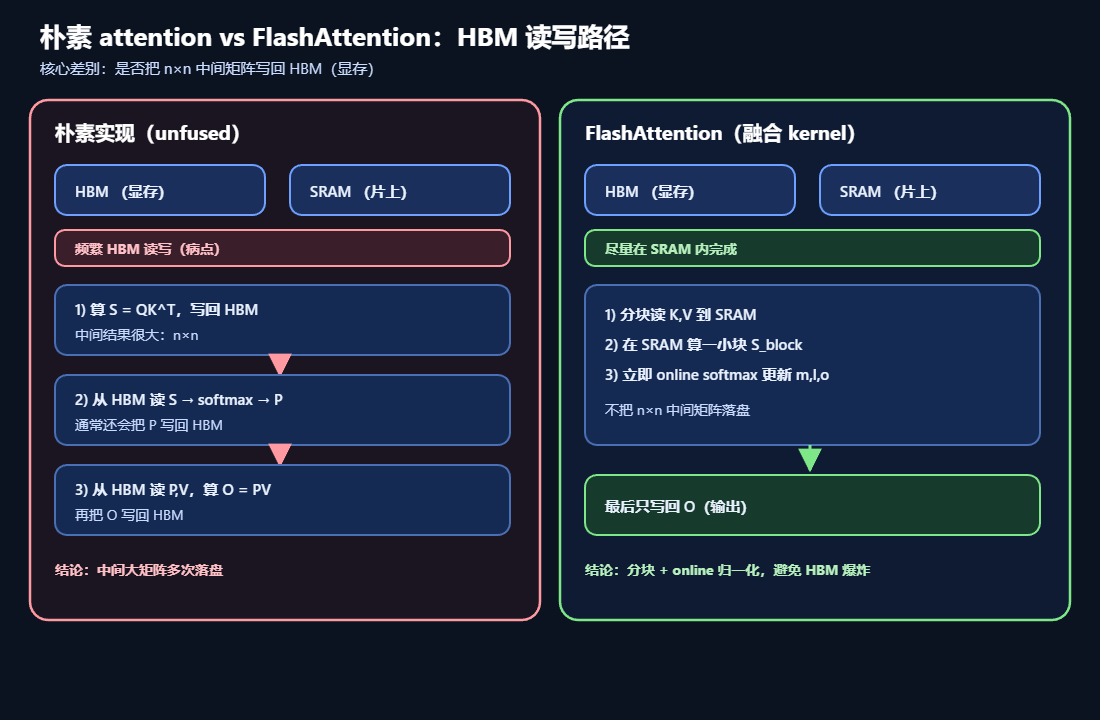
标准 attention(尤其是 unfused 版本)有一个“致命中间产物”:
- ,形状
- ,形状
它们都很大,通常会被 materialize(写回 HBM),导致: - 显存峰值高(长序列炸得更早)
- HBM 读写巨大(带宽先爆)
- kernel 被拆碎(launch/sync 额外开销)
1. 你到底在优化什么:Attention 的“算力瓶颈”常常是假的,真正瓶颈是“搬运”
很多新手对 Attention 的第一印象是:
- 计算量: 和 两个大矩阵乘法,看起来很“吃算力”
- 复杂度:,序列一长就爆
但在 GPU 上,标准 attention(naive / unfused)经常不是算不过,而是“搬不过”: - 你会把巨大的 (尺寸 )写回 HBM(显存)
- 然后再从 HBM 读回来做 softmax
- 再写回,再读回来去乘
这会导致: - HBM 读写量是 (甚至比算力更先爆)
- kernel 被拆成很多段,launch 开销/同步开销变大
- 由于中间矩阵太大,很多实现无法在长序列上训练/推理
FlashAttention 的核心主张就是:
把 attention 当成一个 IO 问题来优化,让数据尽量在片上 SRAM(shared memory / registers)里流动,不要反复落到 HBM。
2. 从 0 到 1:FlashAttention 的“一个关键技巧”——tile + online softmax(不存 )
FlashAttention 不是近似注意力,它计算的是精确 softmax attention:
它做的事情非常朴素,但组合起来威力巨大:
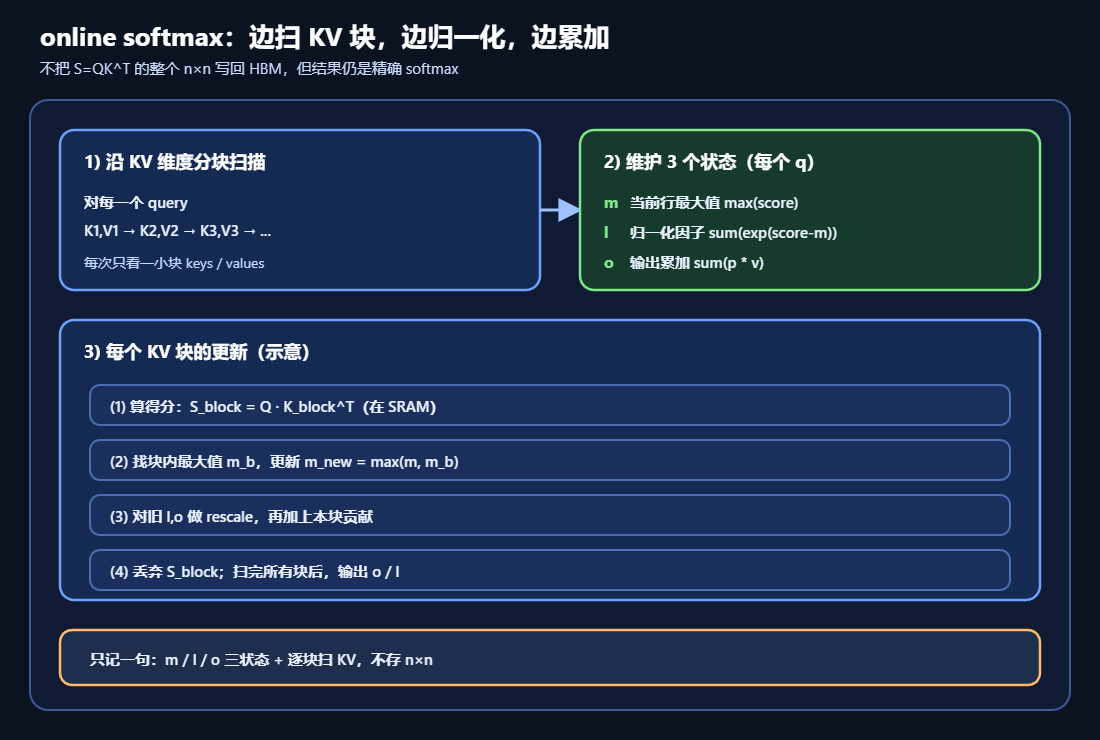
- 把 按序列维分块(tile):一次只处理一小块 keys/values
- 对 softmax 用 online 方式累计:一边扫块、一边维护每一行(每个 query)的
- 当前最大值 (用于 log‑sum‑exp 的稳定)
- 当前归一化因子 (类似分母)
- 当前输出累加
这样你就不用把整个 写回显存了:
- 每次在 SRAM 中算一块
- 立刻更新
- 丢弃这块
如果你想把“V1 的算法”在脑子里跑一遍,下面这张流程图基本就够了(注意:核心是 KV 内层循环 与 m/l/o 三状态):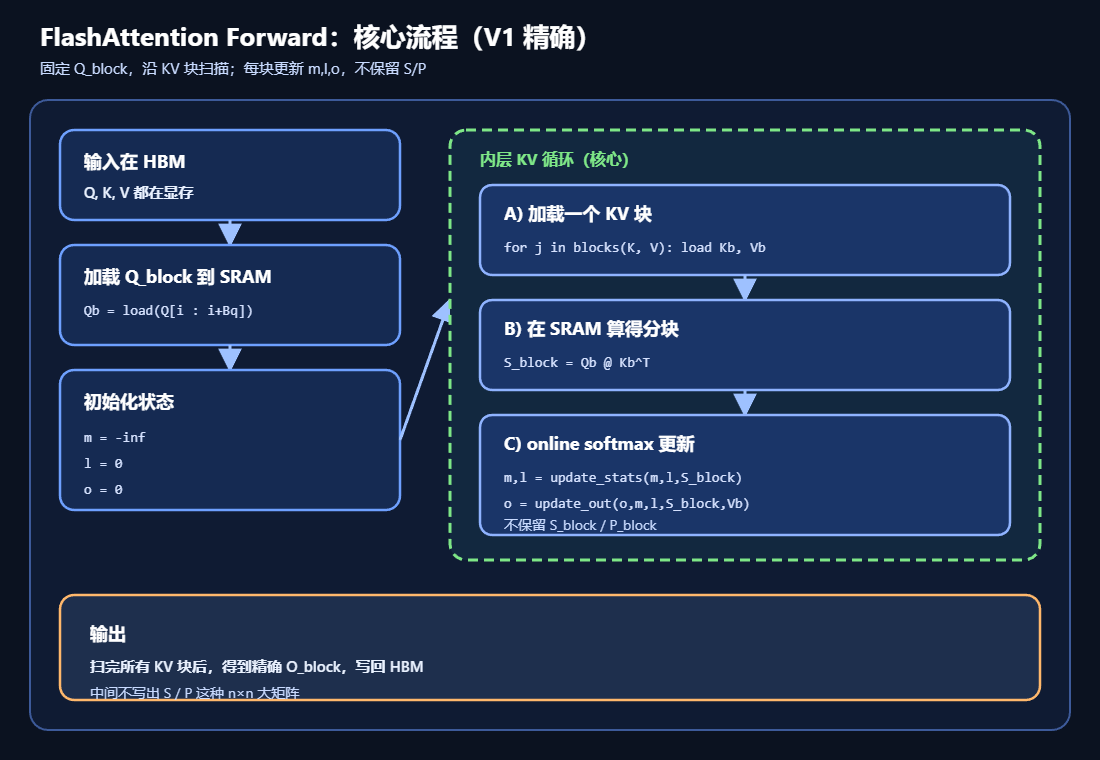
同时你也可以用一张“IO 直觉图”来记住它为什么快(标准 attention 的大头在写 S/P,FlashAttention 则把这一步尽量消掉):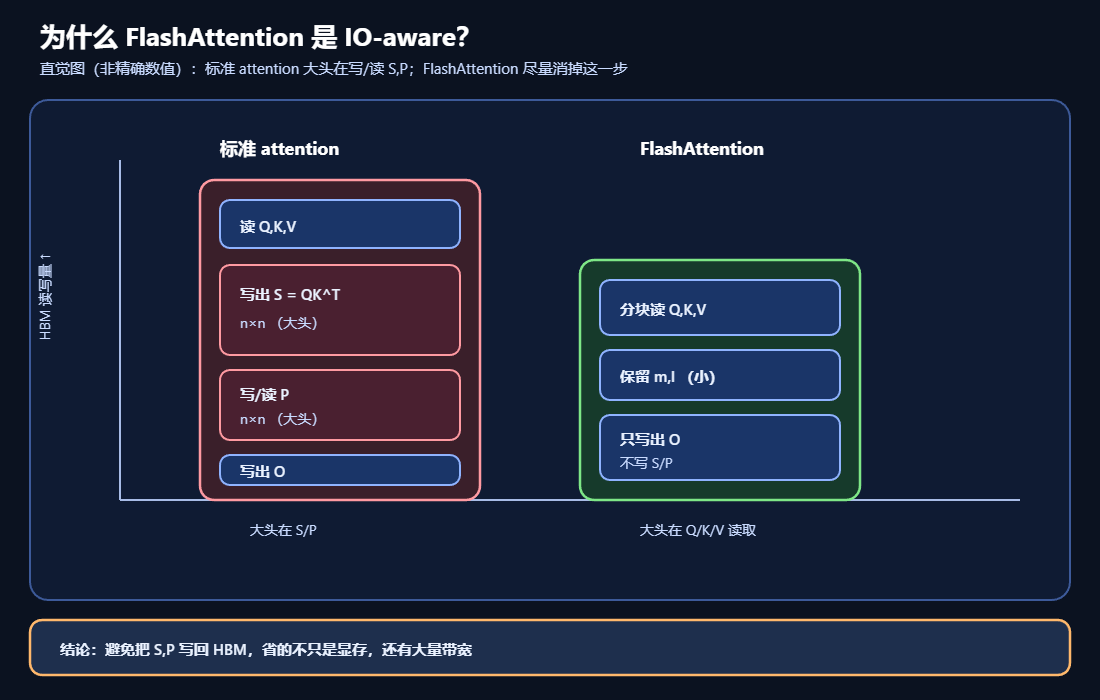
3. FlashAttention V1(2022):IO‑aware 的“方法论”与基础算法
3.1 论文与实现
- 论文(V1):FlashAttention: Fast and Memory‑Efficient Exact Attention with IO‑Awareness(NeurIPS 2022)
- arXiv:
https://arxiv.org/abs/2205.14135
- arXiv:
- 代码:Dao‑AILab/flash‑attention
https://github.com/Dao-AILab/flash-attention
下面这张来自官方仓库的图很适合当“第一眼直觉”(为什么要 tiling、为什么要在 SRAM 算完就丢):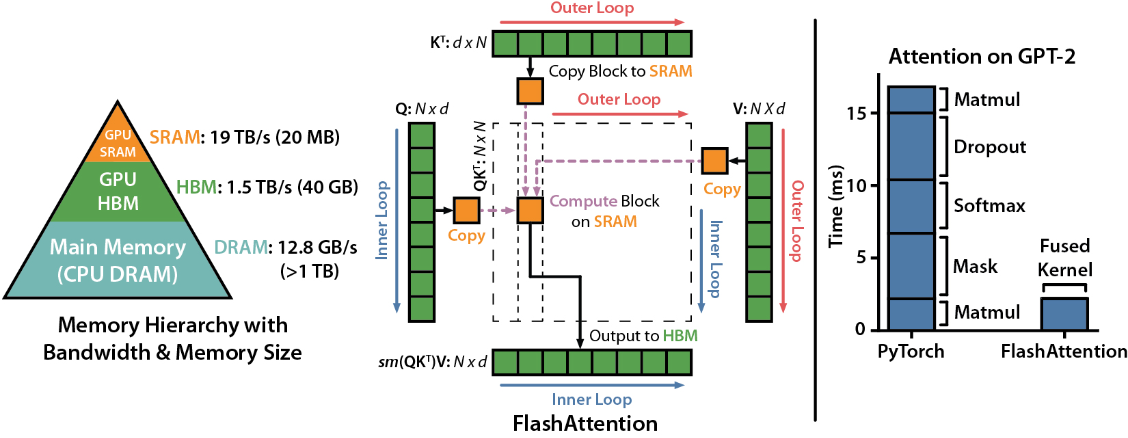
3.2 V1 解决了什么
用一句话总结 V1:
把 attention 的中间矩阵“留在片上算完就扔”,把 HBM 读写从 降到接近 。
从工程体验上看,V1 带来两种“能感知到”的变化:
- 显存峰值下降:长序列训练/推理更容易跑起来
- 吞吐提升:尤其在长序列、较大 batch/heads 时更明显
这张官方图展示了“显存随序列长度”的变化趋势(最关键的一点:FlashAttention 近似线性,而标准 attention 近似二次):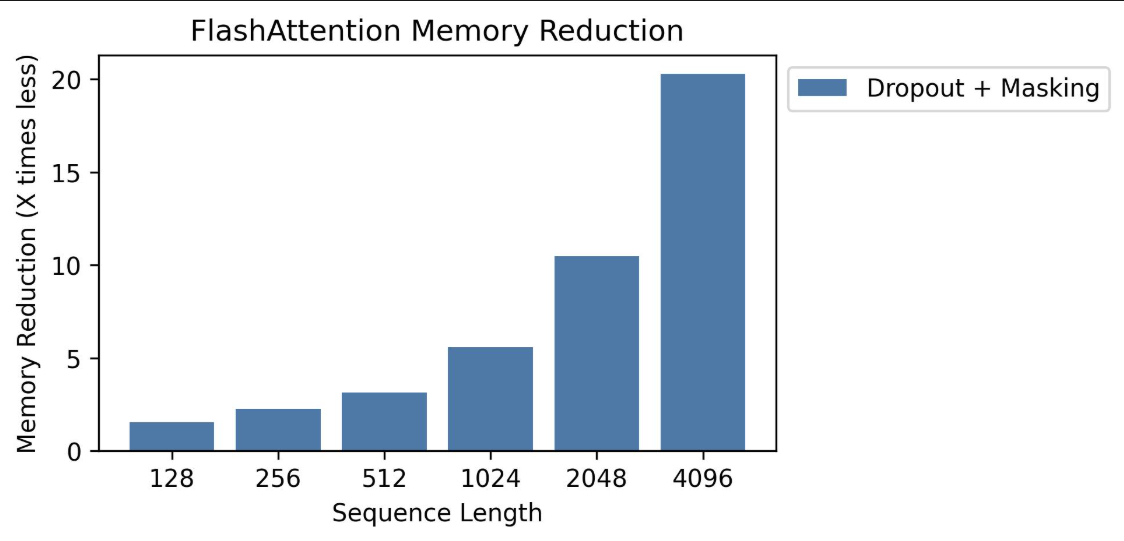
3.3 V1 的核心结构:两层 tiling(Q 维度 + KV 维度)
V1 在 kernel 里通常会同时分:
- Query block: 的一段行(多个 query token)
- KV block: 的一段列(多个 key/value token)
你可以把它想成一个“二维扫块”: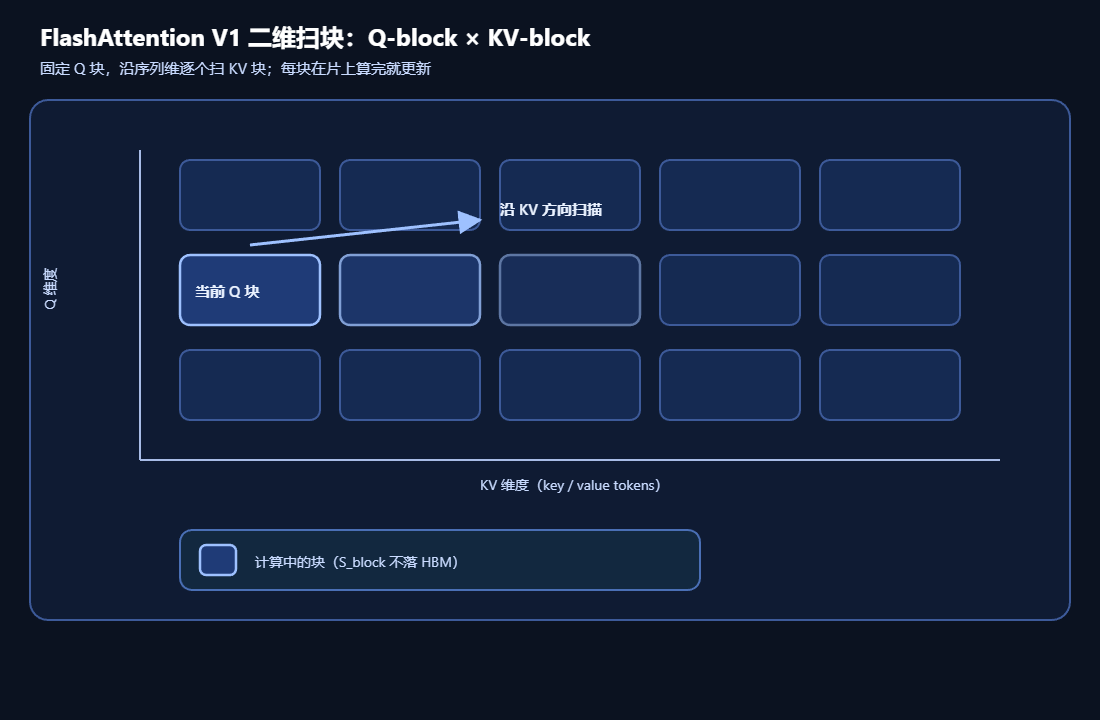
3.4 V1 的数值稳定:为什么 online softmax 仍然精确?
核心是 log‑sum‑exp 的等价变形:
对一行分数 ,softmax 分母是 。
当你分块处理时,每块都可以更新全局的 max 与 sum:
- 维护全局最大值
- 维护归一化因子
每处理一个新块,就用新块的最大值更新 ,并对旧的 做 rescale,再加上新块贡献。
这保证了与一次性 softmax 完全一致(只要浮点误差可控)。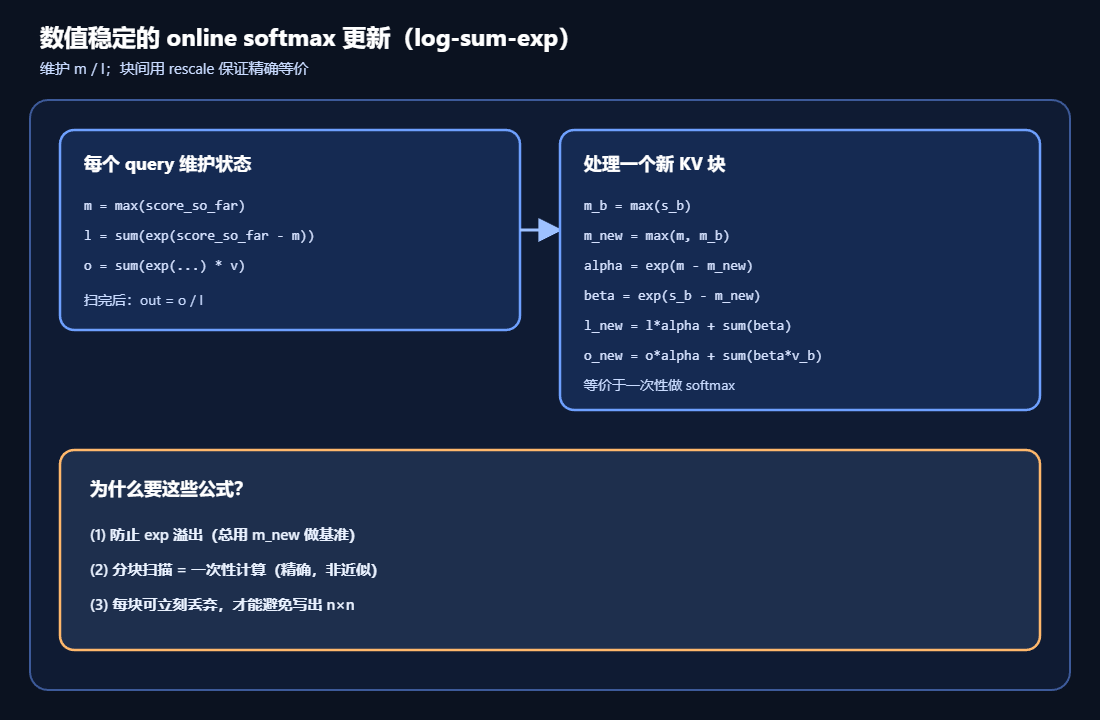
3.4.1 把“等价更新”写成可直接套用的式子
假设我们对某一行(某个 query)在扫描到当前 KV 块前,已经维护了:
- :到目前为止的最大分数
- :到目前为止的归一化因子(分母部分)
- :到目前为止的加权输出累加
当读入一个新的 KV 块,得到该块的分数向量 (长度为该块的 token 数)以及对应的 value 向量集合 后,可以做下面的精确更新:
当所有块扫描完毕,这一行的输出就是:
你可以把它记成一句话:新块先“对齐到同一个最大值基准”再累加,所以既稳定又精确。
3.5 V1 的“快”来自哪里:把“读写 ”改成“每次只读写一小块”
你可以用一个非常工程的口径来理解:
- 朴素实现:为了算出 ,你必须把 写出去;为了算 ,你又要把 写出去
→ 中间产物落到 HBM 就意味着巨大 IO - FlashAttention:把 softmax 的归一化改成“在线累计”
→ 你只需要维护 ,不需要存 或 的完整矩阵
3.6 V1 为什么会提“recompute”:Backward 不想存 ,那就用统计量重算
训练时 backward 需要大量中间量。如果你把 都存下来,显存会很糟;
V1 的策略是:forward 存更少的信息(例如 与输出 ),backward 时在片上重算必要片段。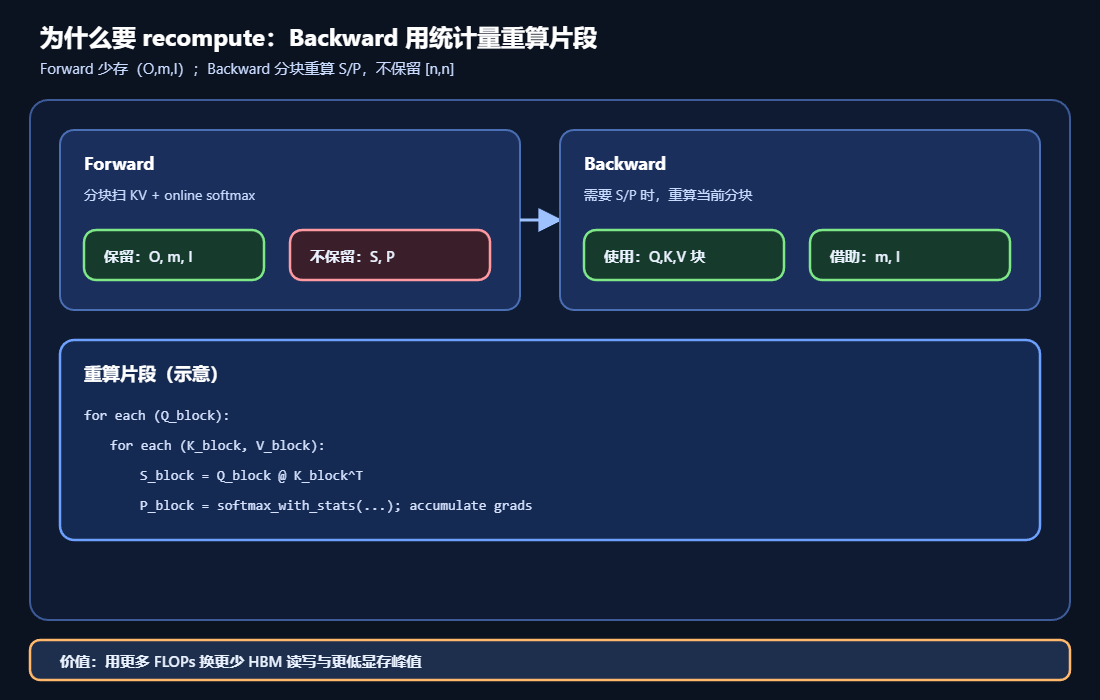
3.7 V1 的“方法论总结”:把 attention 拆成“GEMM + softmax + GEMM”,然后强行把 softmax 也塞进片上流水
如果你读论文时被细节淹没,回到这一句就能找回主线:
- 标准 attention:GEMM1 得到 写回 HBM → softmax 读 写回 → GEMM2 读 做
- FlashAttention:GEMM1 的局部块 + softmax 的局部更新 + GEMM2 的局部累加,在同一个 kernel 里完成
→ 把 从“必须存的中间矩阵”降级成“可丢弃的临时块”
3.8 论文里的 IO 复杂度你怎么理解(不死磕推导)
你可以先只记住 2 个结论:
- 标准 attention 的 IO 下界里,会出现一个不可避免的 (因为你在“触碰”并反复搬运一个 的对象)
- FlashAttention 的 IO 会随着片上 SRAM 大小 增大而显著下降(因为更大的块意味着更少的往返 HBM 次数)
论文中会用“HBM accesses / IO complexity”给出更形式化的界与最优性证明;对工程实践来说,最重要的就是:你是否写回了 这种 中间物。
4. FlashAttention‑2(2023/2024):并行与分工重构——让 kernel 更像 GEMM
4.1 V1 的瓶颈:不是算法错了,而是“并行分工不够像矩阵乘”
V1 已经大幅减少 HBM IO,但论文指出它的实际吞吐(FLOPs 利用率)仍偏低,原因通常是:
- thread block 的分配不够均衡 → occupancy 不够
- warp 间通信 / shared memory 读写过多
- 一些非 GEMM 的算子(mask、dropout、softmax 细节)占比不小
FlashAttention‑2 的目标就是:
在不改变“精确、IO‑aware”核心的前提下,把工作划分重做,让 attention 更像高效 GEMM。
4.2 论文与材料
- arXiv:
https://arxiv.org/abs/2307.08691 - 作者主页 PDF(常用引用版本):
https://tridao.me/publications/flash2/flash2.pdf
4.3 FA‑2 的关键改动
可以用三句话记住:
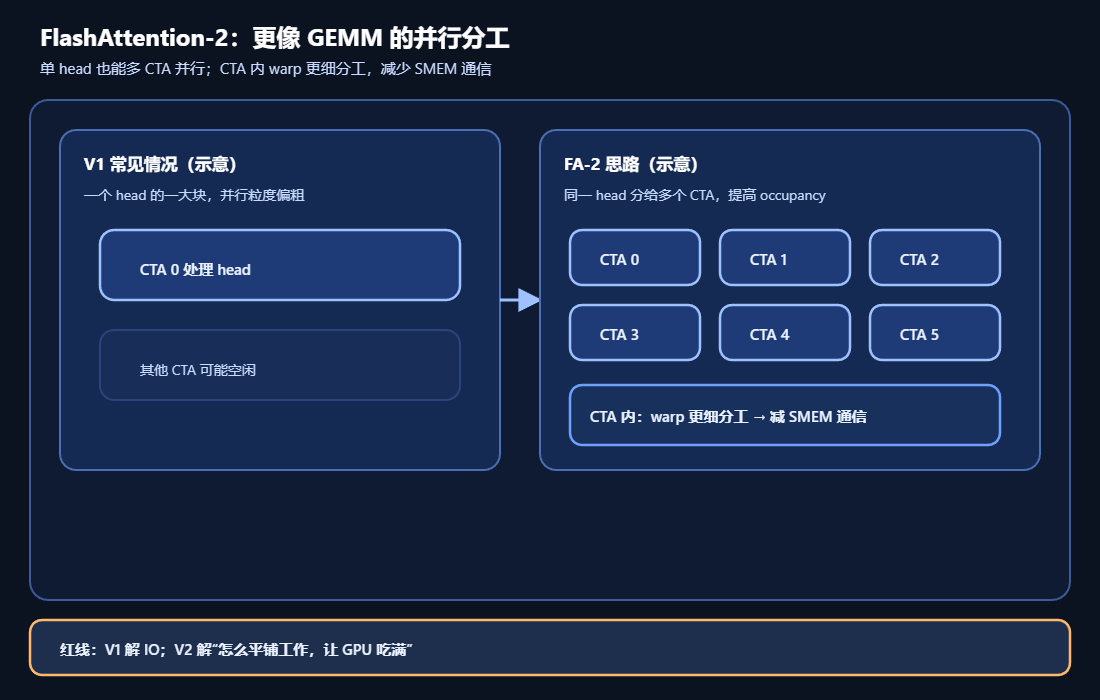
- 更好的 work partitioning:即使单个 head,也能并行到更多 thread blocks
- warp 内分工更细:减少 warp 间共享内存通信
- 减少“非 matmul”的开销:让 kernel 的时间更多花在 Tensor Core 上
4.4 为什么“长序列”会让 V1 变慢:并行度突然不够了
很多人第一次遇到 FA‑2 的动机,是在“训练长序列”时发现:
- 序列变长后,为了总 tokens 不爆,batch size 往往会变小
- 再叠加 tensor parallel / pipeline parallel 后,单卡上的 batch/head 可能更小
这会导致一个反直觉现象:
虽然序列更长、总计算更多,但单个 head 的并行粒度不足,GPU 反而吃不满。
FA‑2 的一个关键改动就是:把并行粒度进一步拆开,让一个 head 在更多维度上都能被多个 CTA 分摊,避免“长序列小 batch”时的低占用。
4.5 “更像 GEMM”是什么意思:把 attention 的工作划分改成能稳定喂饱 Tensor Cores 的形状
GEMM 很快的原因,不止是 Tensor Core 强,还因为:
- block 划分规则成熟,load/compute/store 可以稳定流水
- CTA/warp 的分工明确,通信路径短
FA‑2 的工作就是把 attention 也尽可能靠近这套成熟范式:
让更多时间花在矩阵乘上,减少软操作(mask/softmax/写回)对关键路径的拖累。
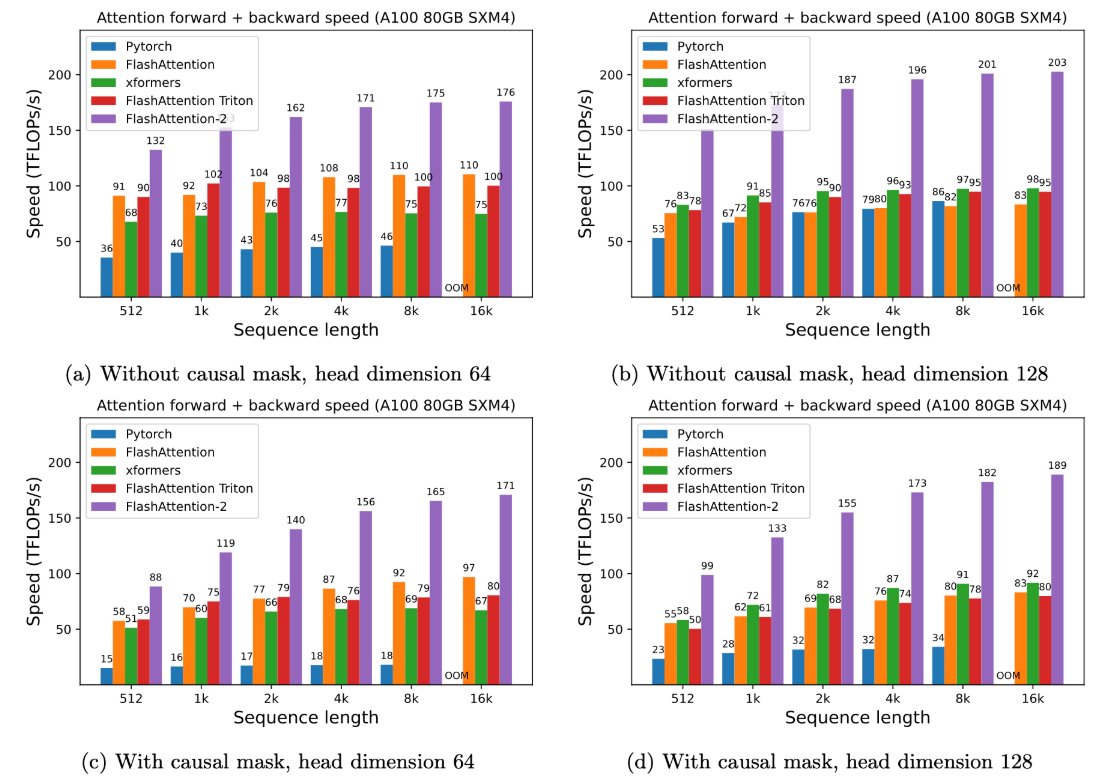
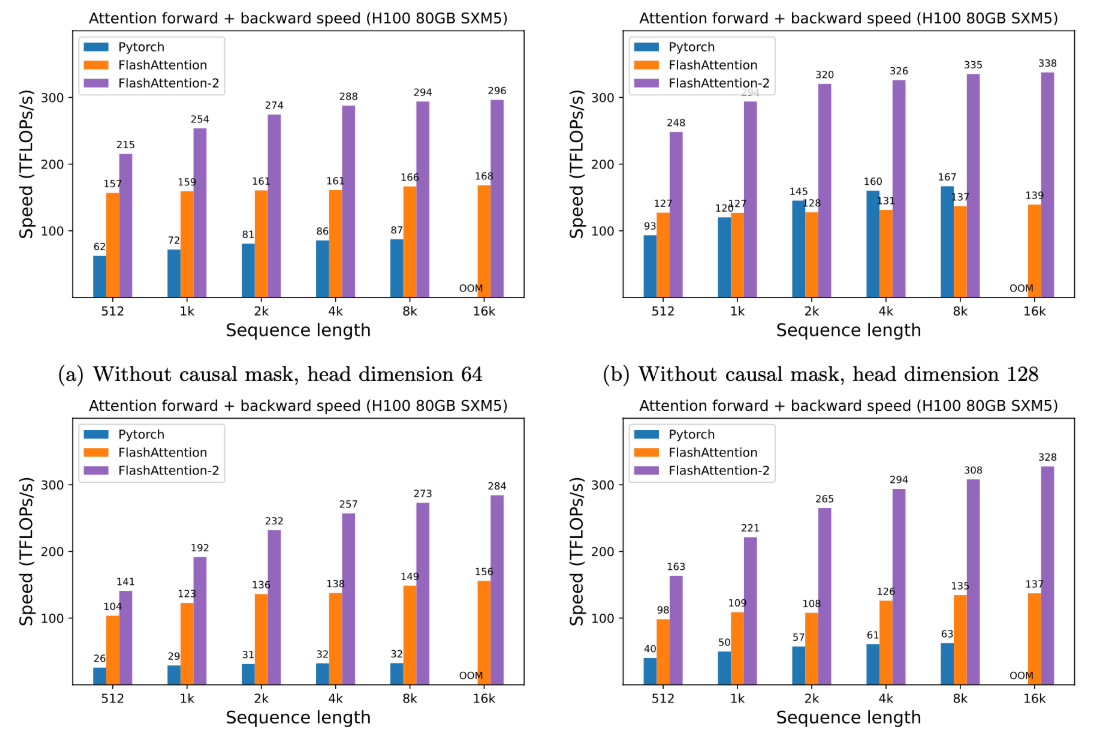
官方仓库给了一个很直观的 benchmark 图(A100 上 forward+backward 的整体对比),适合用来“定性理解:为什么要做 FA‑2”:
5. FlashAttention‑3(2024):为 Hopper/H100 设计——异步与低精度让利用率上一个台阶
5.1 发生了什么:H100 的 Tensor Core 太强,瓶颈“转移”了
FA‑2 在 A100 上能很接近 GEMM 效率,但在 H100 上反而出现“利用率不高”的情况。
原因是 Hopper 增加了很多新能力(例如更强的 Tensor Cores、TMA 等),导致瓶颈从“算不过”变成“流水没排好、搬运/softmax 单元跟不上”。
把 FA‑3 想成“把 attention 当作一个要被编排的流水线”,而不是“一个算完再算下一个”的顺序程序,会非常接近它的设计动机。下面这张图把 Hopper 的 3 个关键硬件点(WGMMA/TMA/FP8)串起来看: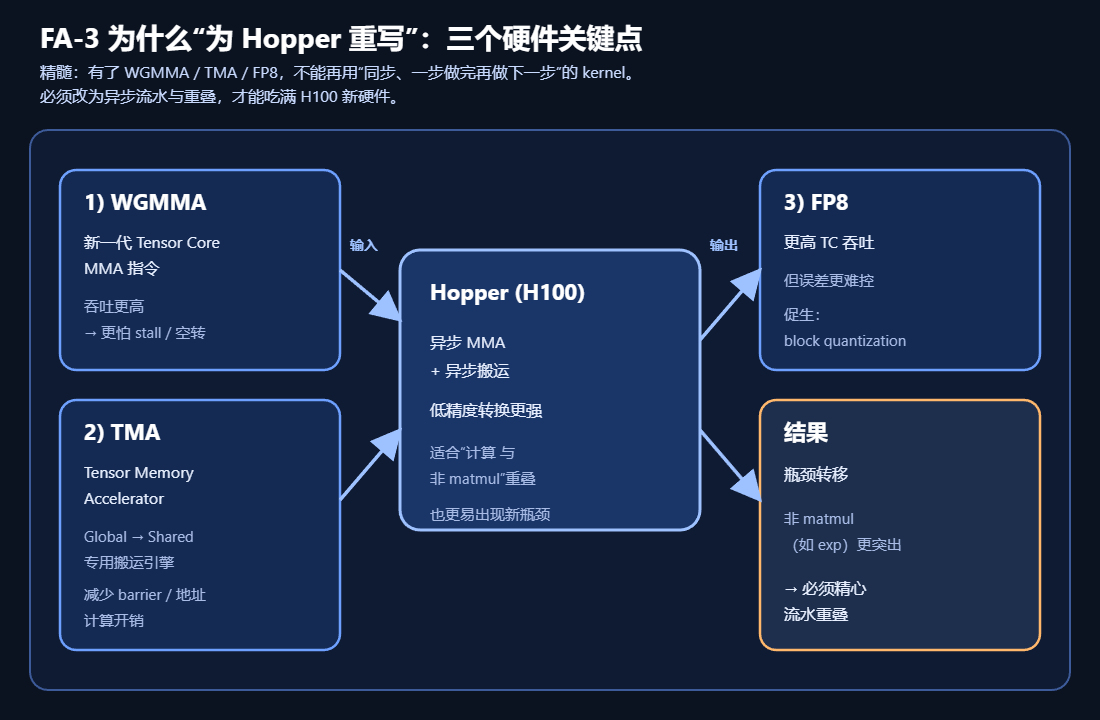
5.2 论文与材料
- arXiv:
https://arxiv.org/abs/2407.08608 - NeurIPS 2024 paper PDF:
https://papers.nips.cc/paper_files/paper/2024/file/7ede97c3e082c6df10a8d6103a2eebd2-Paper-Conference.pdf - 作者博客(强烈建议配合阅读):
https://tridao.me/blog/2024/flash3/
5.3 FA‑3 的三大技术(论文摘要级别)
- 异步重叠(warp specialization + TMA/TC overlap):让数据搬运与 matmul 真的并行
- matmul 与 softmax 交错(interleave):把 softmax 的“等待时间”塞进流水
- FP8 block quantization:利用 Hopper 的 FP8 支持,同时控制误差
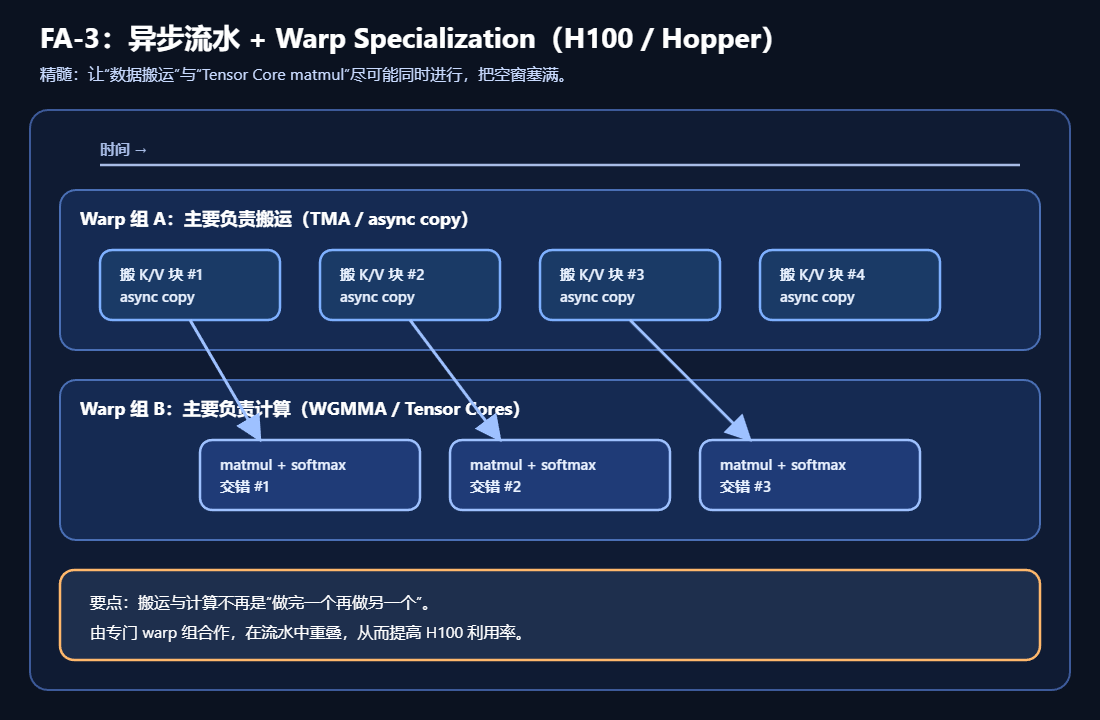
5.4 新手最容易忽略的一点:softmax 的 exp 是“特殊函数吞吐”问题,不是普通 FLOPs
FA‑3 的博客里有一个特别关键的工程直觉:
- matmul 的吞吐来自 Tensor Cores(很强)
- softmax 的 exp 来自 MUFU/SFU(吞吐远弱于 Tensor Cores)
当 Tensor Core 变得更强时,exp 的相对成本就会上升。
所以 FA‑3 的核心不只是“更快的 matmul”,而是让 exp 尽可能躲在 matmul 的阴影里(overlap/interleave)。
5.5 FP8 为什么“更快但更难”:量化误差与 outliers
FP8 让吞吐进一步提升,但它会把“数值误差”从小问题变成必须正面处理的问题。
论文/博客里强调的一个关键现象是:LLM 激活存在 outliers(极少数大幅值),会破坏量化尺度选择,导致误差暴涨。
FA‑3 使用的思路可以用一句话概括:
用“incoherent processing”(例如 Hadamard 变换 + 随机符号)把 outliers 的能量“摊开”,降低 block quantization 的最坏误差。
你不需要先掌握所有量化理论,只要记住:FP8 attention 想要靠谱,就必须把 outliers 变得更“均匀”。
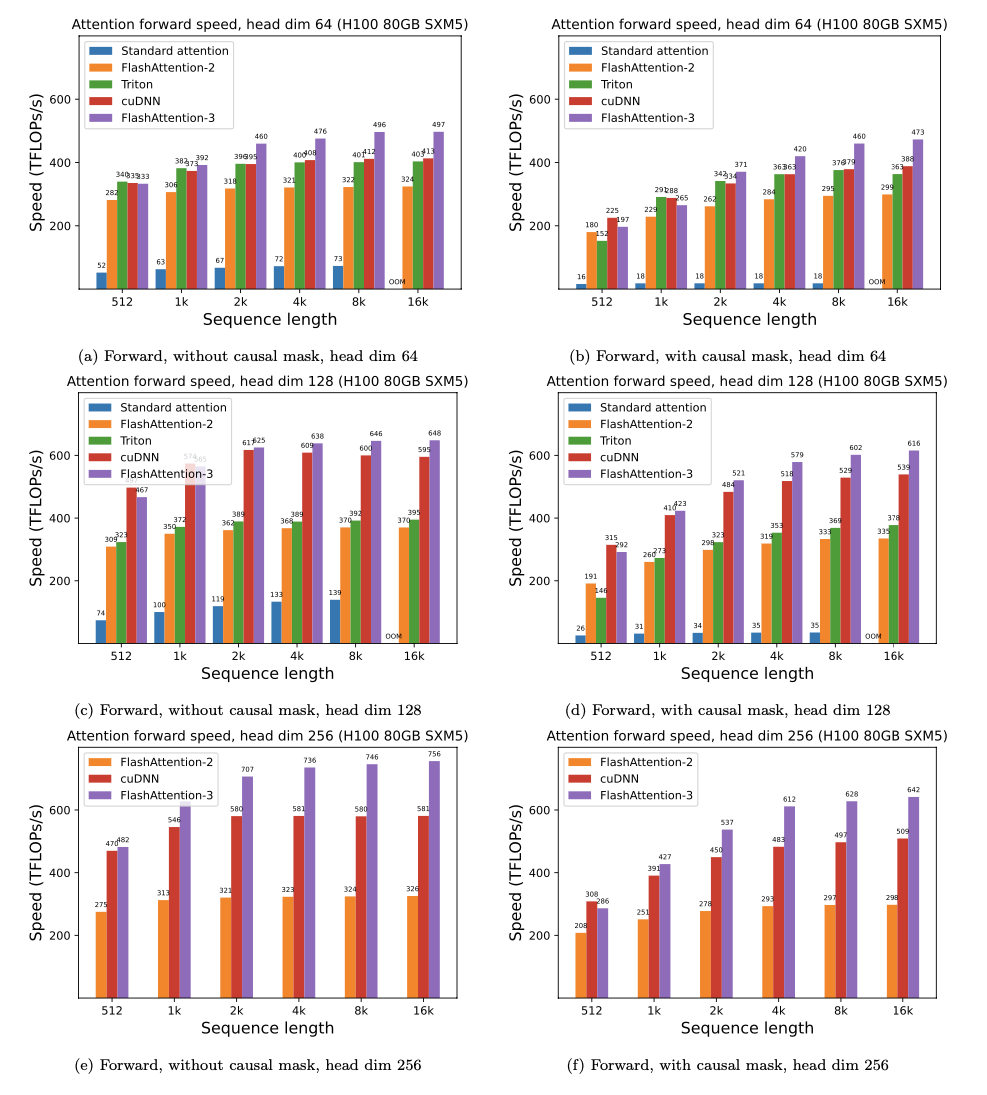
官方仓库也提供了 H100 上的对比曲线(更贴近你在 Hopper 上的真实体验):
以及 FA‑3 的一个代表性加速图(H100 FP16 forward):
6. FlashAttention‑4(2026):为 Blackwell/B200 重新做 pipeline co‑design(“硬件不对称扩展”时代)
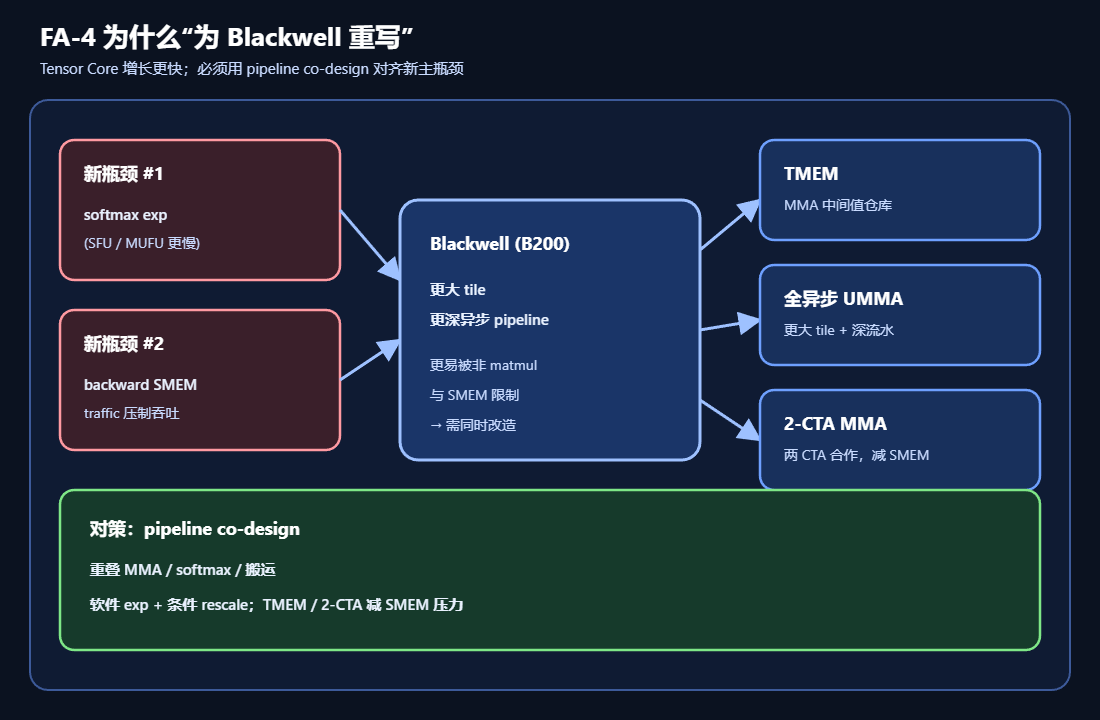
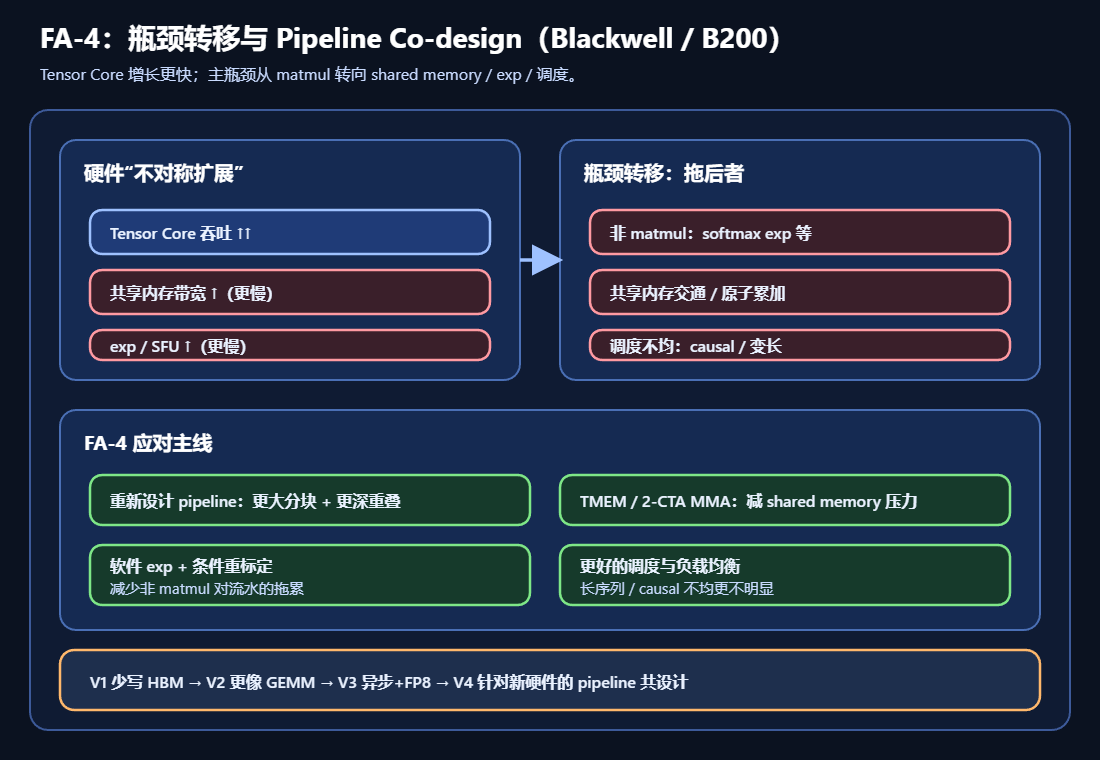
6.1 新问题:Tensor Core 吞吐再翻倍,但 shared memory 带宽 / exp 单元没等比例涨
Blackwell 的“算力涨幅”与“非 matmul 单元涨幅”不一致,这会让 attention 这种 mix(matmul + softmax + 归一化 + 访存)的 kernel 出现新瓶颈。
你可以把 FA‑4 的动机记成一句话:
Tensor Core 继续变快,但 attention 的“其他部分”没有等比例变快,所以必须对算法与流水一起做“共同设计”,把瓶颈重新压回可重叠的范围。
6.2 论文与材料
- arXiv(2026):
https://arxiv.org/abs/2603.05451 - HTML 版(更方便找图):
https://arxiv.org/html/2603.05451v1 - Princeton Lab 博客:
https://blog.ai.princeton.edu/2026/03/12/flashattention-4-algorithm-and-kernel-pipelining-co-design-for-asymmetric-hardware-scaling/
如果你只想快速建立“FA‑4 是为谁服务”的直觉,先看这张选型图: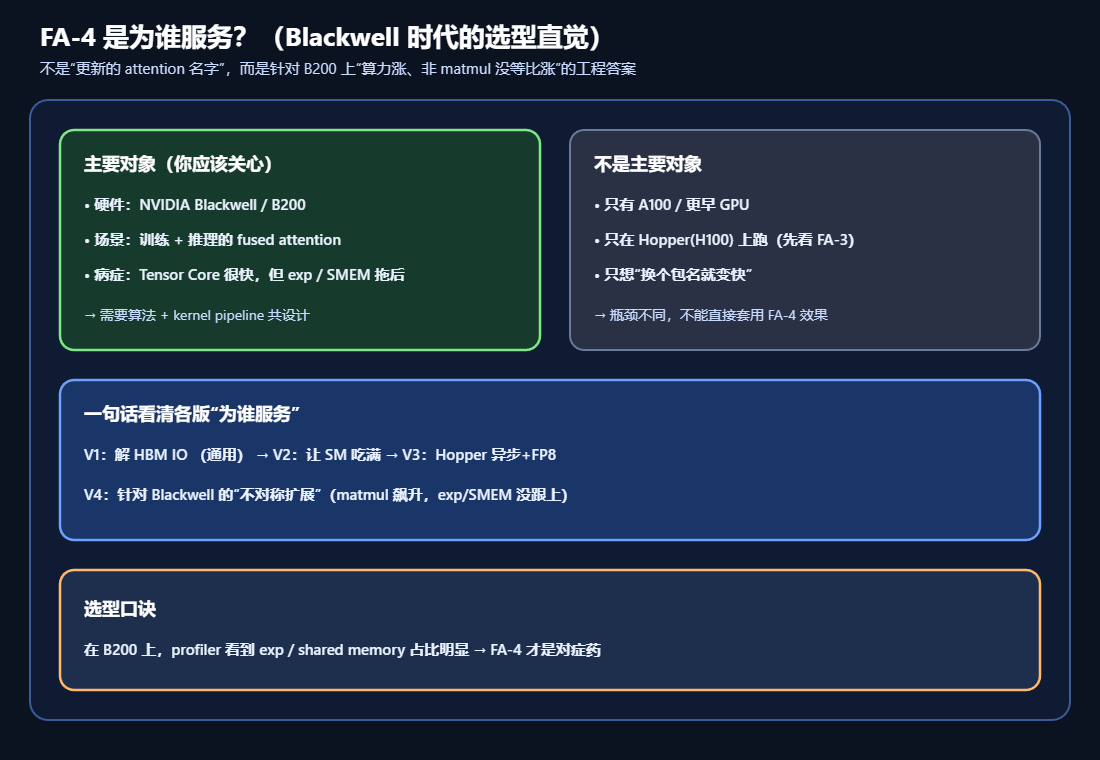
6.3 FA‑4 的关键词
你可以先记住三件事:
- pipeline 重构:把“matmul / softmax / 搬运”编排得更极致
- 2‑CTA MMA / tensor memory:减少 shared memory 压力(尤其 backward)
- 软件模拟 exp/条件重标定:减少非 matmul 瓶颈对流水的拖累
6.4 “feeds & speeds” 新手解释:为什么 softmax(exp) 会成为核心瓶颈?
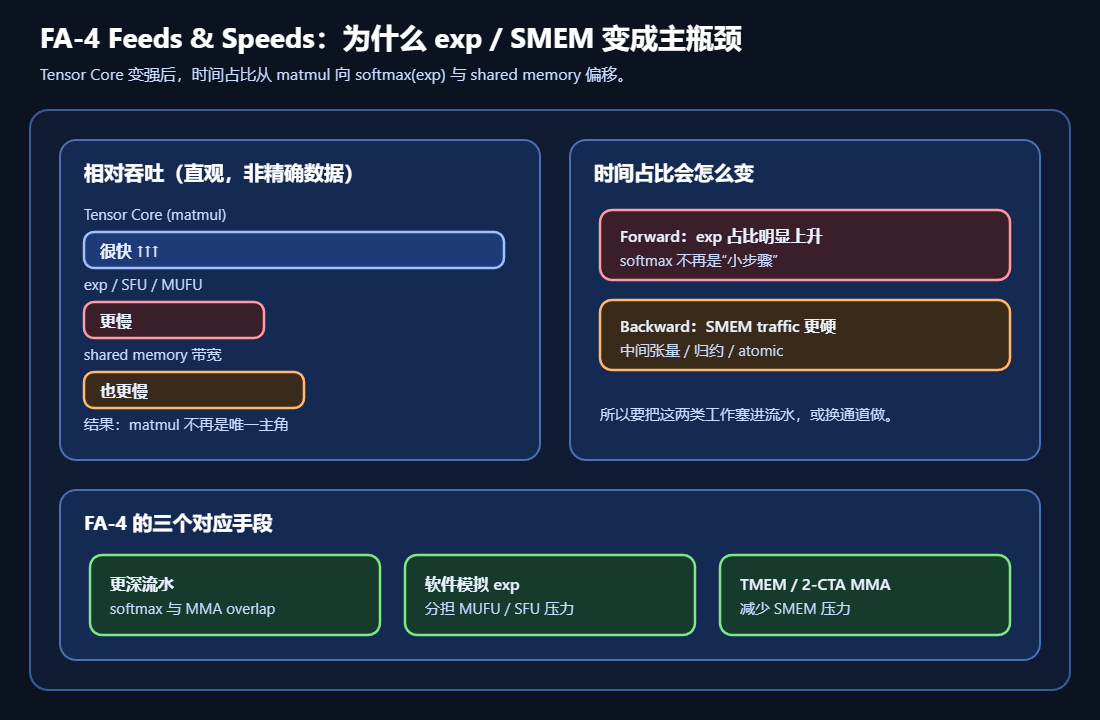
很多人误以为 attention “基本都在 matmul”,softmax 只是中间的小步骤。
但在新硬件上(例如 B200),Tensor Core 的吞吐变得极强,而 exp 等特殊函数的吞吐并不会等比例提升,导致:
- forward 里,exp 的时间占比会明显上升
- backward 里,shared memory traffic 会变成更硬的瓶颈
这就是 FA‑4 为什么要: - 把 softmax 放进更深的流水去 overlap
- 用“软件模拟 exp”去分担 MUFU 的压力
- 用 TMEM / 2‑CTA MMA 去减少 shared memory 压力
6.5 FA‑4 的两个“很工程”的点:软件 exp 与条件 rescale(为什么不影响正确性)
你会在 FA‑4 的博客/论文里看到两类听起来很“黑魔法”的表述:
- 软件模拟 exp:用多项式近似等方式,把一部分 exp 工作挪到 FMA/ALU 上做
直觉:让 MUFU/SFU 不再是唯一通道,提高有效 exp 吞吐 - 条件 rescale(conditional online softmax rescaling):不是每一步都做完全的重标定,而是“在必要时才做”
直觉:把一些向量操作从关键路径拿掉,减少非 matmul 工作量
新手最担心的是“这样会不会不精确”。这里的关键点是:
- rescale 的“偷懒”只是在中间步骤减少某些更新频率
- 最终仍然会用真实的最终统计量做归一化校正
→ 输出仍然对齐到正确的 softmax 结果(误差主要来自浮点与近似 exp 的实现策略)
6.6 Backward 为什么更难:共享内存带宽与原子累加把你卡死
相比 forward,backward 往往:
- GEMM 次数更多(链更长)
- 中间张量更多(访存更重)
- 还可能出现 dQ 的跨块归约(引入 atomic adds 与非确定性)
FA‑4 用 TMEM / 2‑CTA MMA 的一个重要目的就是:
减少 shared memory 来回搬运的字节数,并在某些路径上减少 atomic 压力。
6.7 你会在生产里真正遇到的点:deterministic backward 与调度(长尾问题)
实际训练中,很多团队关心的不只是“平均快”,还关心:
- 可复现性:atomic reduction 的顺序会导致非确定性
- 长尾:causal mask / 变长序列会让某些 tile 更短或更长,导致尾部拖慢
FA‑4 的 deterministic mode 与更好的 tile scheduler,解决的就是这类“生产级痛点”。
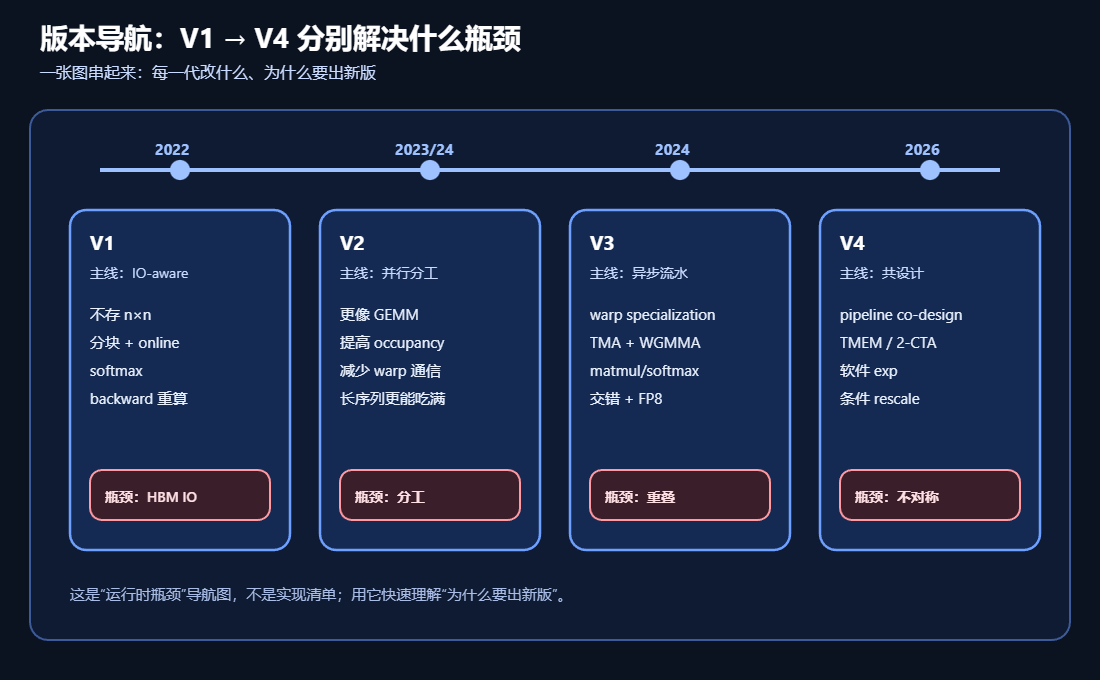
7. 一张总览图:V1→V4 到底进化了什么(给新手的“版本导航”)
8. 实践:你在工程里怎么正确使用 FlashAttention(以及常见坑)
8.1 常见使用入口(生态)
- PyTorch / xFormers / HuggingFace / vLLM / SGLang 等都会在不同路径上调用 flash‑attention 内核
- “你以为用了 flash‑attn,但其实没用上”的常见原因:
- dtype/head_dim/shape 不匹配
- causal/mask/dropout 的组合走了 fallback
- 推理侧 paged KV / prefix cache 与 kernel 支持不一致
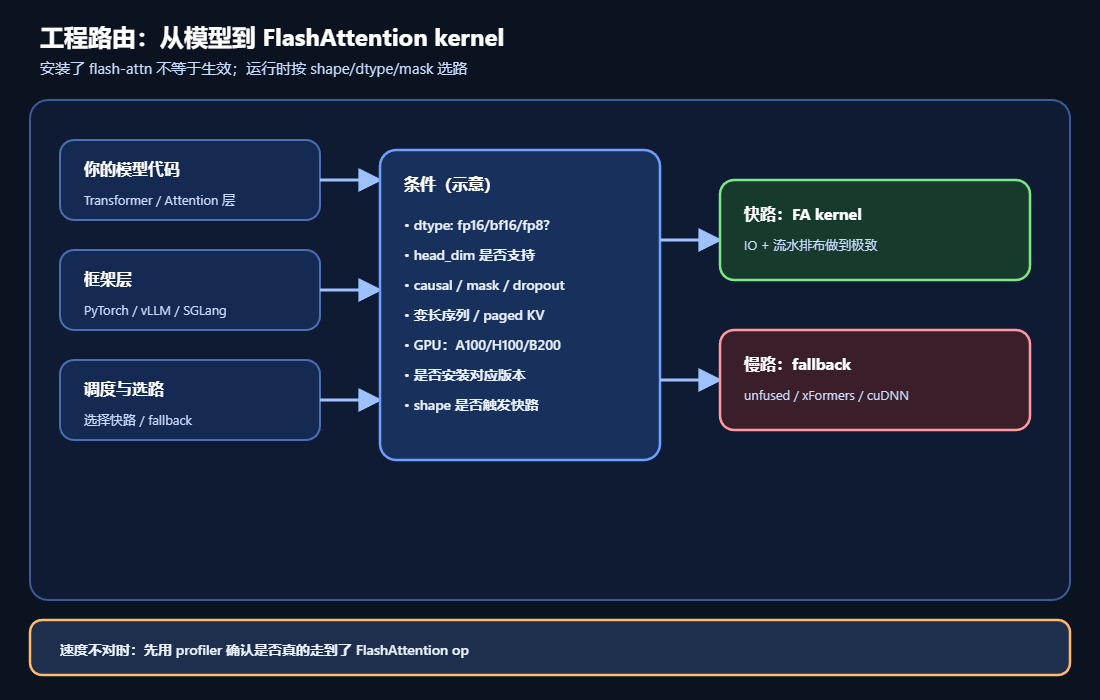
8.2 诊断清单(推荐直接照着做)
- 确认 kernel 真的被调用:日志 / profiler / op 名称
- 确认形状落在快路径:head_dim、是否 causal、是否 fp16/bf16/fp8
- 关注瓶颈指标:HBM 读写、SM 利用率、Tensor Core 利用率、launch 次数
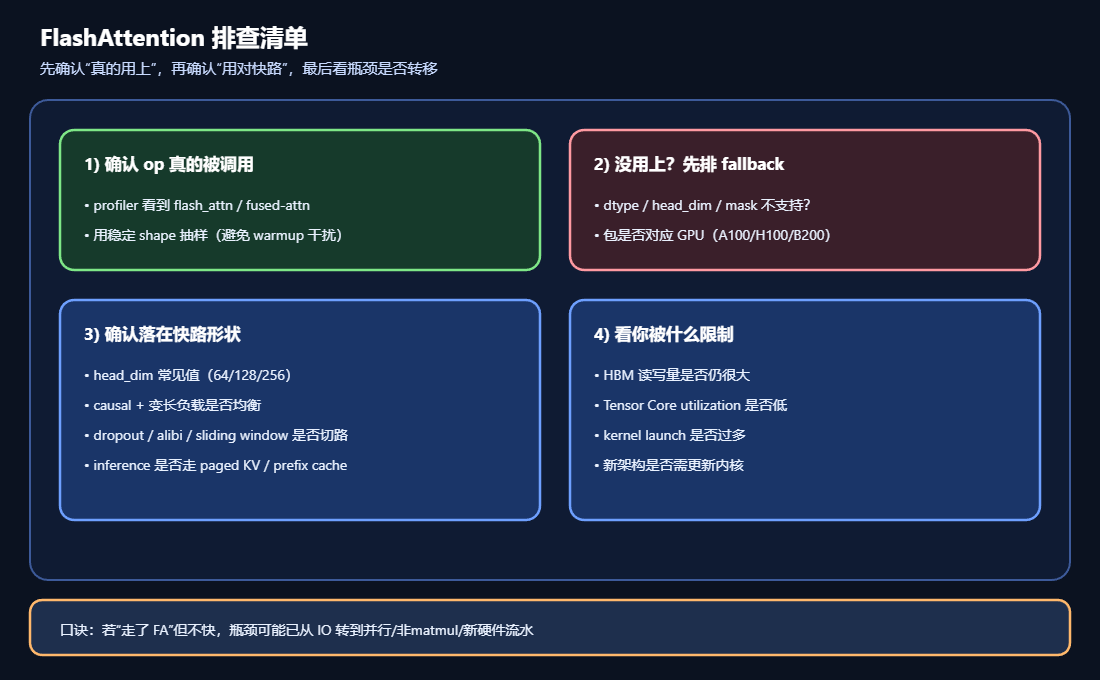
9. FAQ(新手最常问)
9.1 FlashAttention 是不是“近似注意力”?
不是。FlashAttention 的主线是 精确 softmax attention,优化的是 IO 与 kernel 编排。
9.2 为什么它能把显存从 变成近似 ?
因为它不存 的注意力矩阵,而是边算边归一化边丢弃中间块。
9.3 它和“长上下文压缩注意力”(例如 C4/C128、各种压缩/稀疏)是什么关系?
FlashAttention 解决的是 把“你要算的 attention”算得更快;
压缩/稀疏注意力解决的是 改变你要算的 attention 的结构(减少 token 交互规模)。
两者经常叠加:比如“压缩后的远场 dense attention”也可以用 FlashAttention 类 kernel 加速。
10. 参考与进一步阅读
- FlashAttention (v1) arXiv:
https://arxiv.org/abs/2205.14135 - FlashAttention‑2 arXiv:
https://arxiv.org/abs/2307.08691 - FlashAttention‑3 arXiv:
https://arxiv.org/abs/2407.08608 - FlashAttention‑4 arXiv:
https://arxiv.org/abs/2603.05451 - 代码仓库:
https://github.com/Dao-AILab/flash-attention
附录 A:术语表(新手常卡住的词)
- HBM:GPU 显存(容量大、带宽高但延迟与吞吐仍远弱于片上存储)
- SRAM(片上):寄存器、共享内存等(容量小但极快)
- tiling(分块):把矩阵拆成小块,尽量在片上算完
- online softmax:分块扫分数,同时维护 等统计量,避免存完整
- recompute:forward 少存,backward 用统计量与输入在片上重算
- CTA / thread block:GPU 上的线程块(并行调度单位)
- warp / warpgroup:warp 是 32 线程并行单位;warpgroup 是更高层组合(Hopper/Blackwell 上的编排很关键)
- WGMMA / TMA / TMEM / 2-CTA MMA:Hopper/Blackwell 的硬件特性(决定 FA‑3/FA‑4 为什么“必须重写”)
阅读导航



