
AI Infra 常用算子:GEMM、Softmax 与 Attention 入门
AI Infra 常用算子入门:从心智模型到实现细节
如果你想进入 AI Infra,最先要建立的不是“会背一堆框架 API”,而是能看懂一次前向/推理里,时间到底花在哪些算子上、这些算子为什么慢、以及工程上如何改写它们。
本文面向入门到中级读者,系统梳理 AI Infra 中最高频的算子、它们的数学语义、GPU 实现要点,以及在 Transformer / LLM Serving 中的真实形态。
🦄
本文仅用于算子入门,了解下常用的算子,后续还需要对某个算子进行针对性学习。
读完你应能:
- 用 Roofline / 访存层次解释“为什么某个算子慢”
- 讲清 GEMM、Softmax、Norm、Attention、RoPE、通信算子的实现关键路径
- 看懂一层 Transformer 如何被拆成可优化的算子图
- 知道融合、量化、并行策略分别改的是哪一类瓶颈
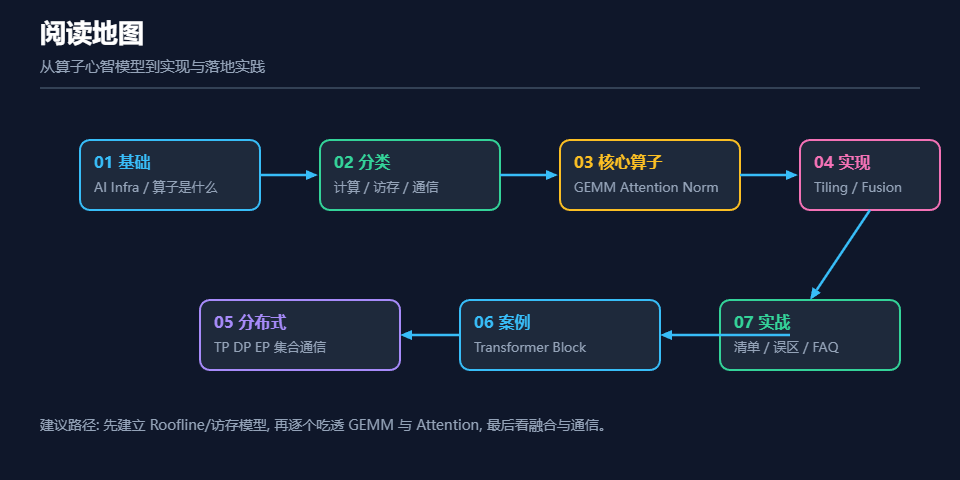
1. 为什么 AI Infra 的核心是算子
AI Infra 覆盖训练框架、编译器、推理引擎、调度系统、通信库和硬件适配。表面上看它很大,真正决定吞吐与延迟的,往往是一层层算子是否被正确实现、融合和调度。
可以把整个系统看成一座分层栈:应用发起请求,框架构图,算子真正吃掉 GPU 时间,运行时决定 launch 与图捕获方式,硬件提供算力与带宽。本文的重点,就是中间那层“算子 / Kernel”。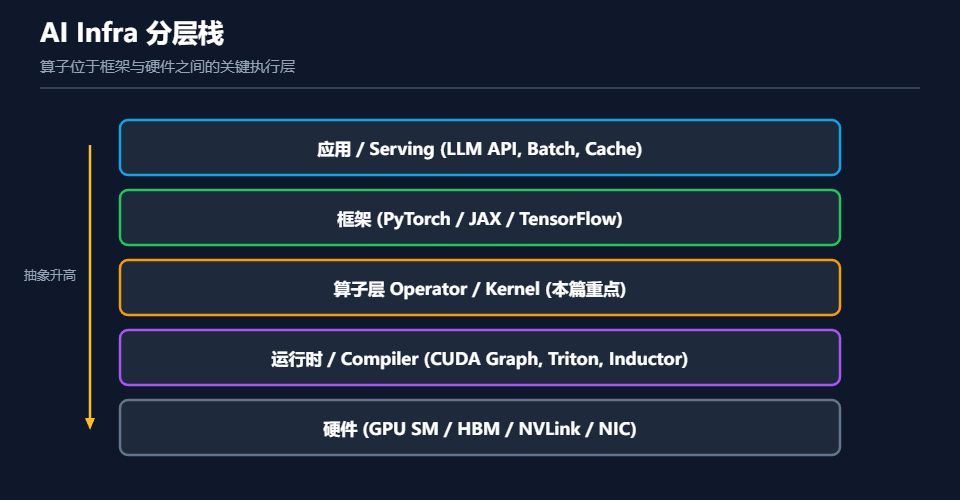
一个实用定义是:算子是一次有明确数学语义的张量变换,并附带可在特定硬件上并行执行的实现。它同时有四重属性:
- 语义:输入输出是什么,数值上做什么
- 性能:吃算力还是吃带宽,占用如何
- 数值:精度、稳定性、累加顺序
- 可组合:能否被融合、重排、与通信重叠
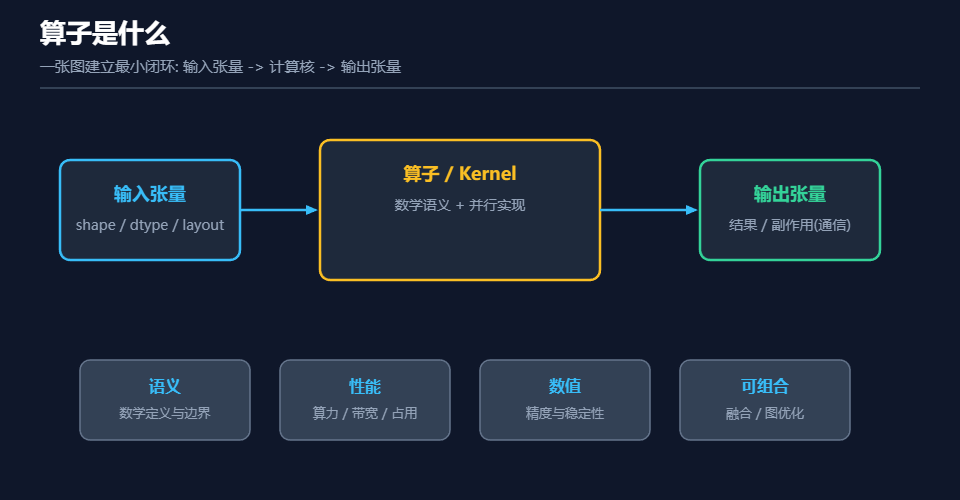
入门时一个常见混淆是把“层”和“算子”当成同一件事。nn.Linear是层;它通常会落成GEMM + bias(+activation)等算子。Serving 框架里看到的flash_attn、rmsnorm、all_reduce,才更接近真正计时的对象。
2. 先建立两张地图:分类与性能模型
2.1 算子分类
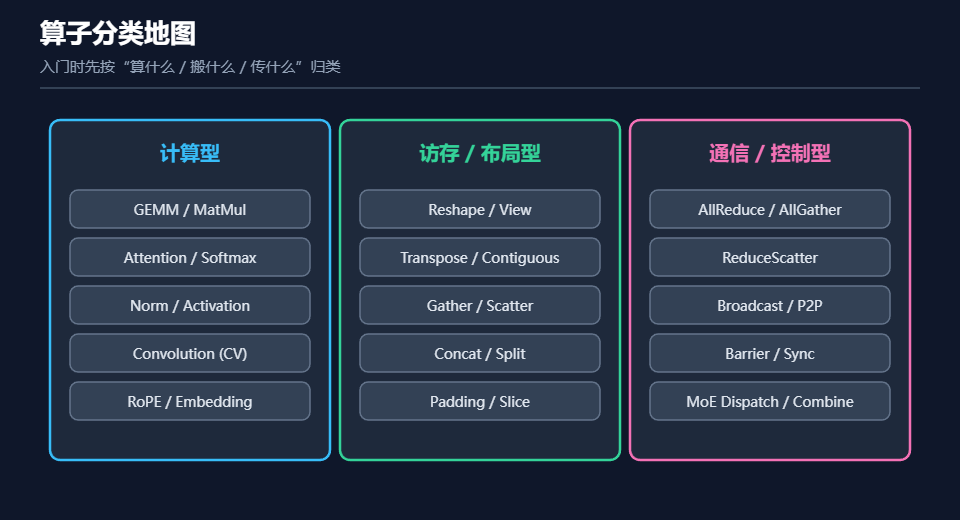
不必一开始就背几百个 API。先按三类归位:
| 类型 | 典型算子 | 你真正优化什么 |
|---|---|---|
| 计算型 | GEMM、Attention、Softmax、Norm、RoPE | 算术强度、tiling、Tensor Core |
| 访存 / 布局型 | Transpose、Contiguous、Gather、Concat | 内存布局、合并访问、减少拷贝 |
| 通信 / 控制型 | AllReduce、AllGather、ReduceScatter、AllToAll | 带宽、拓扑、计算通信重叠 |
 |
2.2 GPU 存储层次
几乎所有算子性能问题,最终都会落到“数据怎么搬”。寄存器最快但最少,共享内存/L1 次之,HBM 大但慢,跨卡/跨机更慢。优秀 kernel 的目标,就是让热数据尽量留在上层,并减少对下层的往返次数。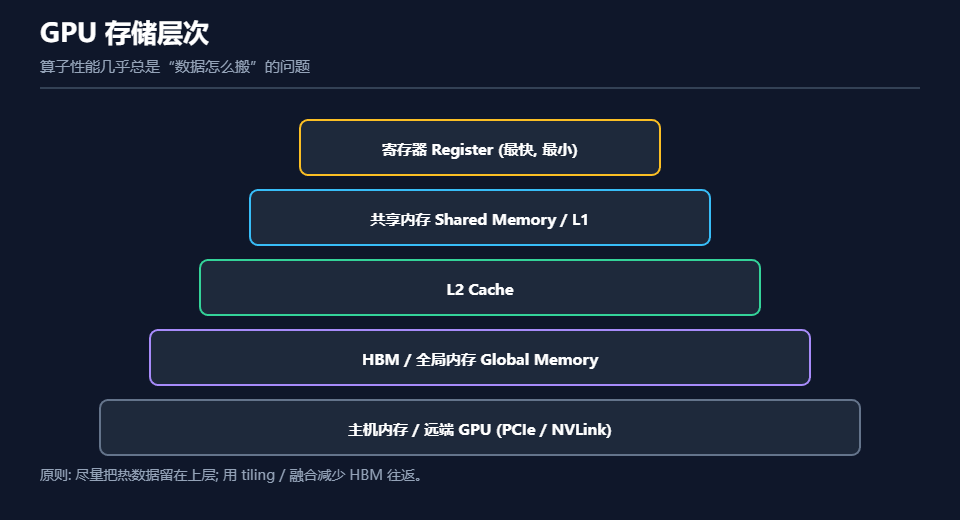
2.3 Roofline:先判断墙在哪里
Roofline 模型用“算术强度 = FLOPs / Byte”把算子分成两类趋势:
- 算术强度低:容易撞上带宽墙。Elementwise、很多 Norm/Softmax 单独跑时就是如此。
- 算术强度高:才可能撞上算力墙。大尺寸 GEMM 更接近这类。
这直接决定优化策略:对带宽墙算子,优先融合、减少读写、改善布局;对算力墙算子,优先 tiling、Tensor Core、流水线与占用。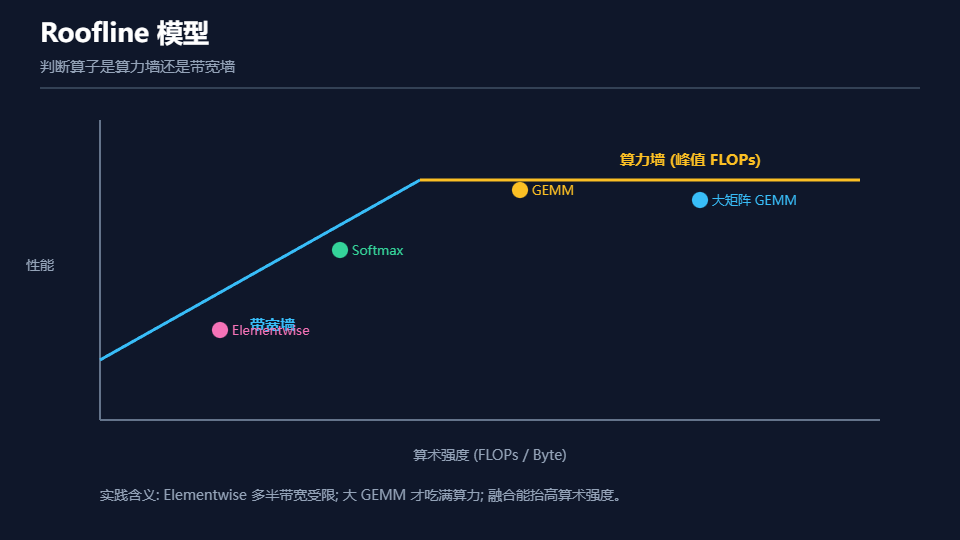
3. 核心计算算子详解
3.1 GEMM / MatMul:AI Infra 的基本盘
矩阵乘 C = A @ B 是现代深度学习里最重要的算子。Linear、QKV 投影、FFN、输出投影,本质都是 GEMM。
白话定义:把左边矩阵的每一行,和右边矩阵的每一列做点积。 这个应该大多数同学都知道。
精确定义:对形状 [M,K] 与 [K,N],计算 C[m,n] = sum_k A[m,k] * B[k,n]。
实践含义:大 GEMM 决定算力利用率;小而碎的 GEMM 往往被 launch 开销和带宽拖垮。
实现关键:Tiling
不可能把整个 A/B 一次性塞进片上内存。标准做法是切 tile:
- 选择输出块
C的一个 tile - 沿
K维循环,每次搬入A子块和B子块 - 在共享内存 / 寄存器中累加
- 写回该输出 tile
常见层级是 Threadblock tile -> Warp tile -> Thread tile。越往下,数据越靠近计算单元。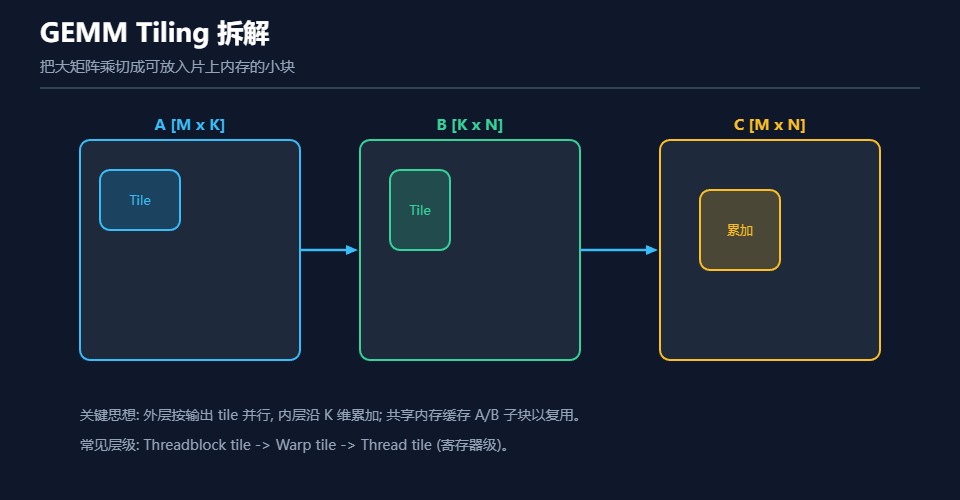
数据流与软件流水线
一次 tile 迭代通常经历:全局加载 -> 同步 -> 寄存器级 MMA/FMA -> 写回。高性能实现会做软件流水线:计算当前 tile 时预取下一块,用计算掩盖 HBM 延迟;在 NVIDIA GPU 上,核心乘法常落到 Tensor Core 的 MMA 指令。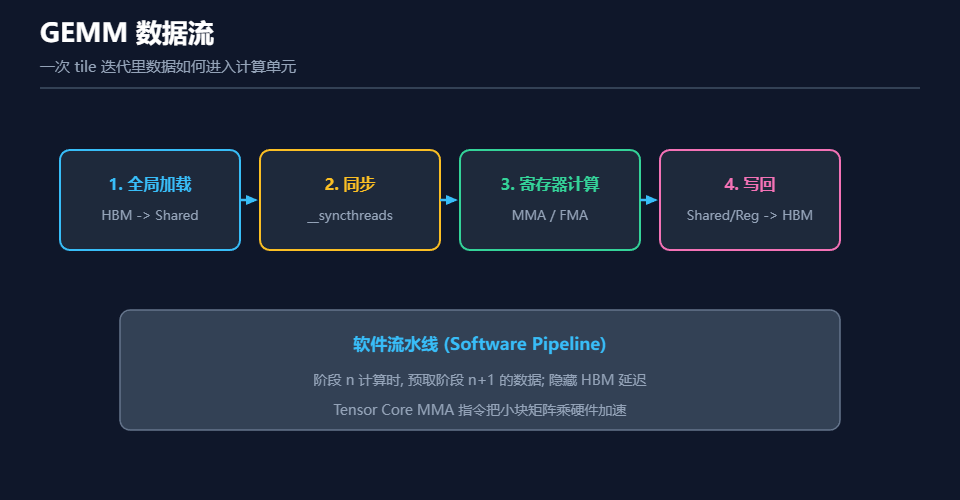
一个最小的 NumPy 语义实现如下,帮助对齐“数学语义”而不是高性能实现:
import numpy as np

def gemm(a: np.ndarray, b: np.ndarray) -> np.ndarray:
    # a: [M, K], b: [K, N]
    m, k = a.shape
    k2, n = b.shape
    assert k == k2
    c = np.zeros((m, n), dtype=np.float32)
    for i in range(m):
        for j in range(n):
            acc = 0.0
            for p in range(k):
                acc += float(a[i, p]) * float(b[p, j])
            c[i, j] = acc
    return c
工程里你几乎不会手写三层循环;但当你读 CUTLASS / Triton / cuBLAS 时,心里要能把它们还原成“带层级 tiling 的三层循环”。
实现检查清单
- 形状是否能对齐 Tensor Core 偏好的 tile(如 16 的倍数)
- 是否存在大量小 GEMM,应合并(例如 QKV 合并)
- epilogue(bias、激活、残差)能否融合进 GEMM 尾部
- 累加精度是否用 FP32,避免长
K维误差累积
Split-K:当 K 维成为瓶颈
当 K 远大于 M,N 时,按输出 tile 切分会让 SM 数量吃不饱。Split-K 沿 K 维切分,让多个 block 各算一部分和,最后做一次 reduce。代价是多一次原子加或显式归约,但能显著提高并行度。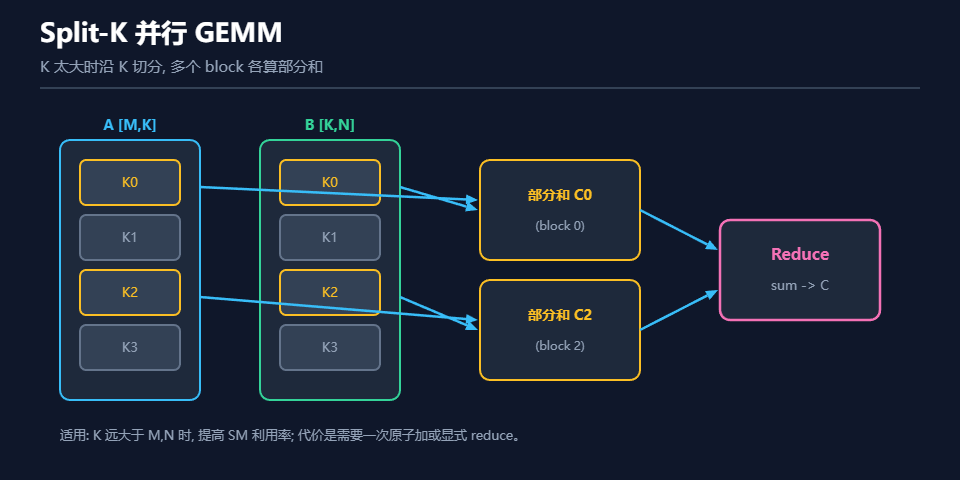
Grouped GEMM:MoE 的好朋友
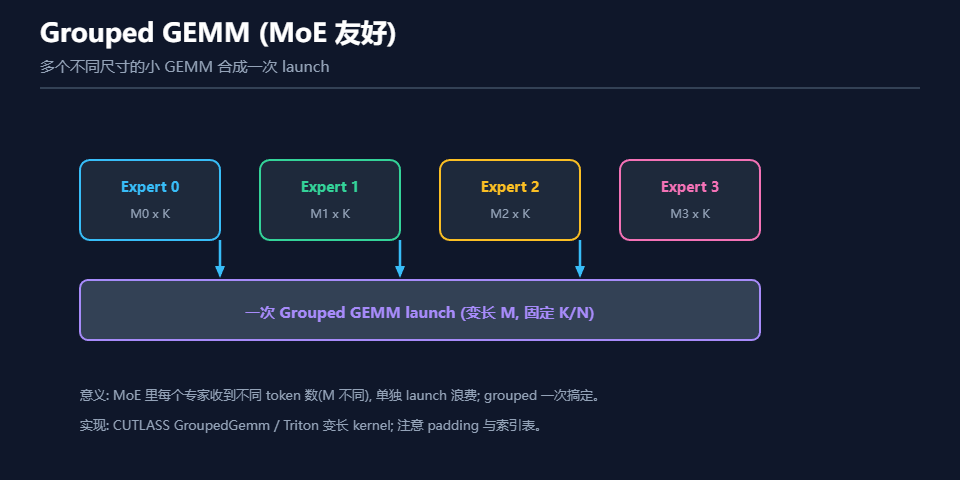
MoE 场景里每个专家收到的 token 数不同,单独 launch 一堆小 GEMM 极不划算。Grouped GEMM 把多个变长小 GEMM 合成一次 launch,由索引表描述每组的起止位置。CUTLASS、Triton 都提供这类支持。
3.2 Softmax:简单公式,复杂工程
Softmax 把一组分数变成概率分布。Attention 里它几乎无处不在。
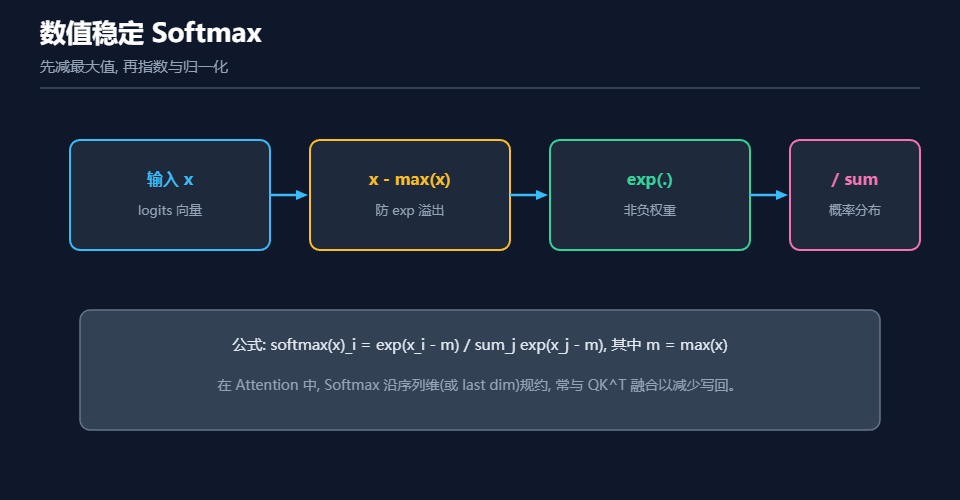
数值稳定版本必须先减最大值:
import numpy as np

def softmax_stable(x: np.ndarray, axis: int = -1) -> np.ndarray:
    x = x - np.max(x, axis=axis, keepdims=True)
    e = np.exp(x)
    return e / np.sum(e, axis=axis, keepdims=True)
Online Softmax:FlashAttention 的基石
如果必须先写出完整 S = QK^T 再 Softmax,长序列会爆显存。Online Softmax 在单遍扫描中维护运行时的 max 与 sum,允许分块更新归一化状态。这是 FlashAttention 能把中间矩阵留在片上、不落 HBM 的关键数学工具。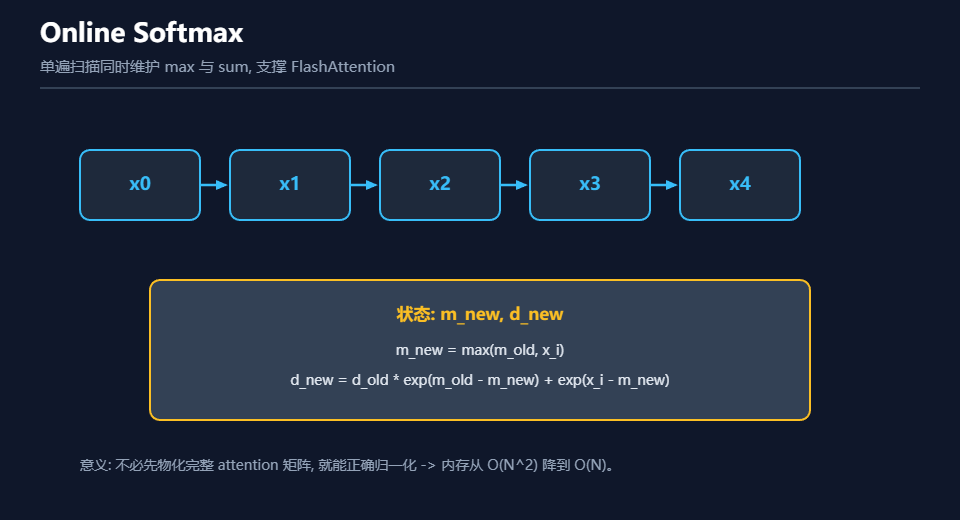
import math

def online_softmax(xs):
    m = -math.inf
    d = 0.0
    # 第一遍也可边读边更新;这里给出状态更新核
    for x in xs:
        m_new = max(m, x)
        d = d * math.exp(m - m_new) + math.exp(x - m_new)
        m = m_new
    return [math.exp(x - m) / d for x in xs]
3.3 LayerNorm / RMSNorm
归一化层用于稳定激活分布。LLM 推理里更常见的是 RMSNorm:它不做均值中心化,通常也更轻。
对单个样本的特征维度做归一化, 缩放参数, 偏移参数, 防止除零。
RMSNorm 去掉均值减去操作,只做 RMS 缩放,没有偏置,大模型常用。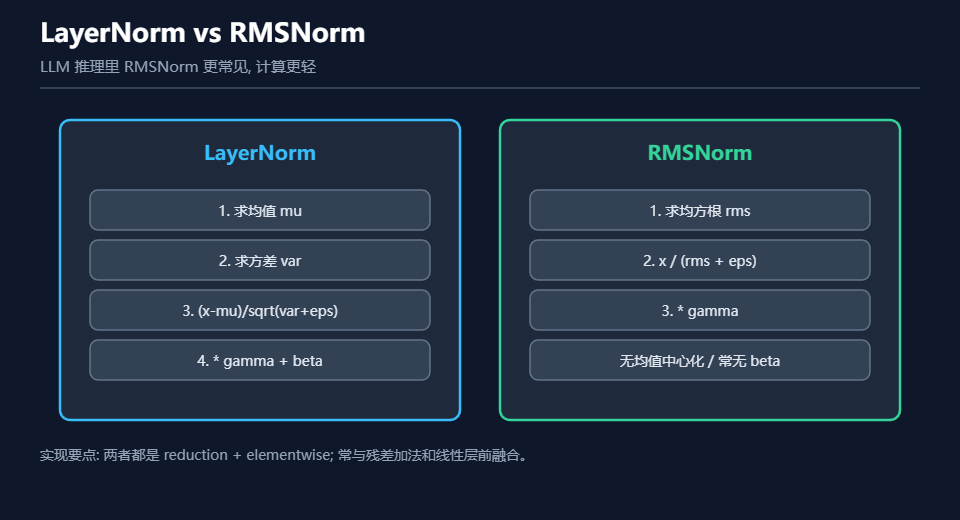
import numpy as np

def layer_norm(x, gamma, beta, eps=1e-5):
    mu = x.mean(axis=-1, keepdims=True)
    var = ((x - mu) ** 2).mean(axis=-1, keepdims=True)
    y = (x - mu) / np.sqrt(var + eps)
    return y * gamma + beta

def rms_norm(x, gamma, eps=1e-5):
    rms = np.sqrt((x ** 2).mean(axis=-1, keepdims=True) + eps)
    return (x / rms) * gamma
实现要点:
- 本质是 reduction + elementwise,单独跑常带宽受限
- 常与残差加法、后续线性层前处理融合
- 注意
eps、是否包含最后一维之外的归约轴、权重是否可学习
3.4 激活函数与 SwiGLU
旧模型常见 ReLU / GELU;现代 LLM 多用 SiLU,并在 FFN 中组成 SwiGLU。从算子视角看,激活几乎都是 elementwise,单独 launch 很不划算,应该和前后 MatMul 融合。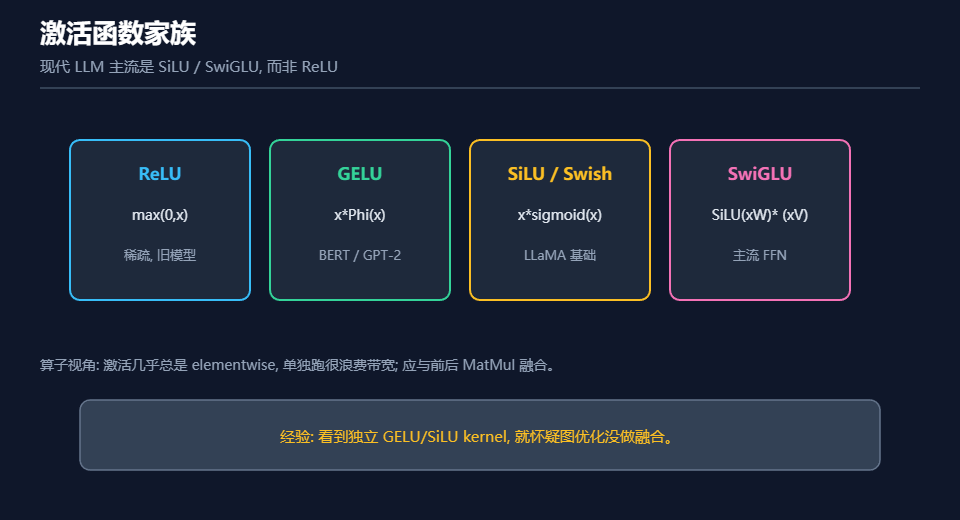
SwiGLU FFN 的结构是:一路 gate 投影经 SiLU,一路 up 投影,二者逐元相乘,再 down 投影。工程上常把 gate/up 合并成一次更宽的 GEMM。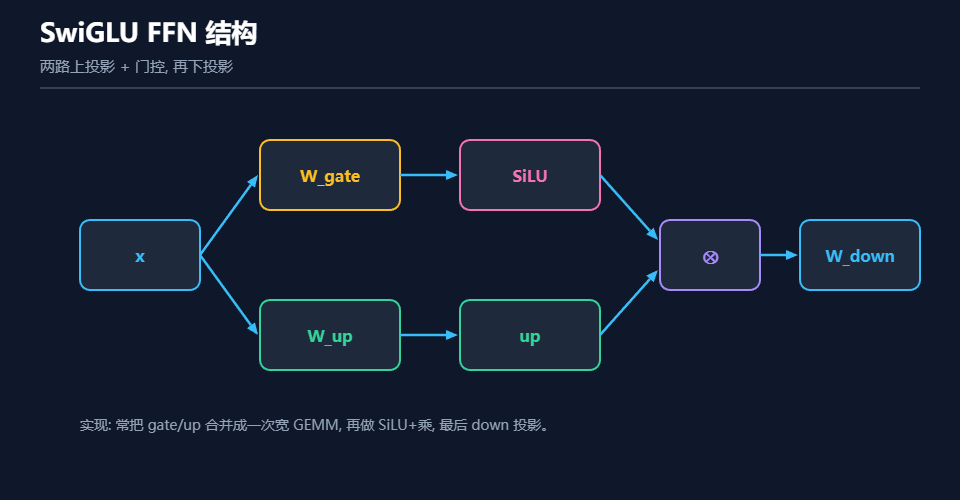
import numpy as np

def silu(x):
    return x / (1.0 + np.exp(-x))

def swiglu_ffn(x, w_gate, w_up, w_down):
    gate = silu(x @ w_gate)
    up = x @ w_up
    return (gate * up) @ w_down
3.5 Attention:从公式到 FlashAttention
标准 Scaled Dot-Product Attention:
朴素实现会物化 [B, H, S, S] 的 attention 分数矩阵。序列一长,显存和带宽都会炸。所以 AI Infra 里的 Attention 几乎总是特殊优化核,而不是三个独立算子硬拼。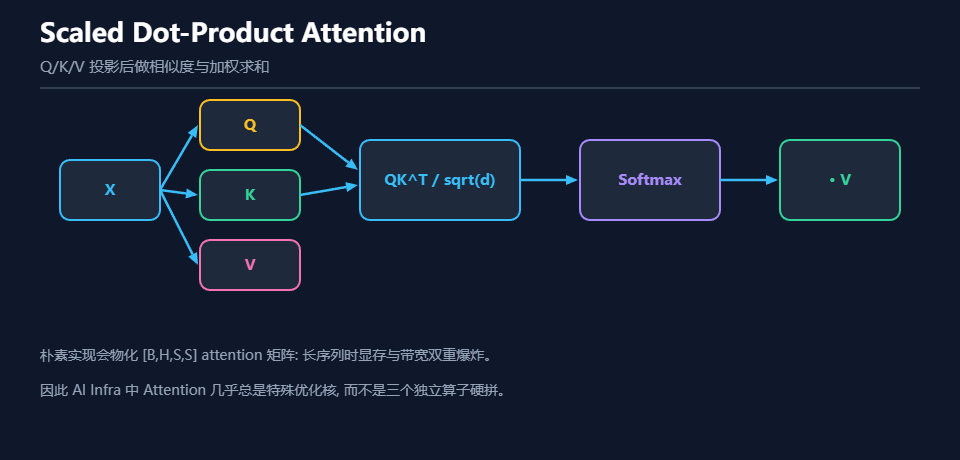
FlashAttention 的核心思想不是改数学结果,而是改 IO:
- 把
Q/K/V分块载入片上内存 - 在片上算局部
S = Qi Kj^T - 用 Online Softmax 维护归一化状态
- 累加输出块
Oi - 只把最终
O写回 HBM
于是中间大矩阵不必完整落盘,复杂度从“显存 O(S^2)”变成“按块复用的 O(S) 工作集”。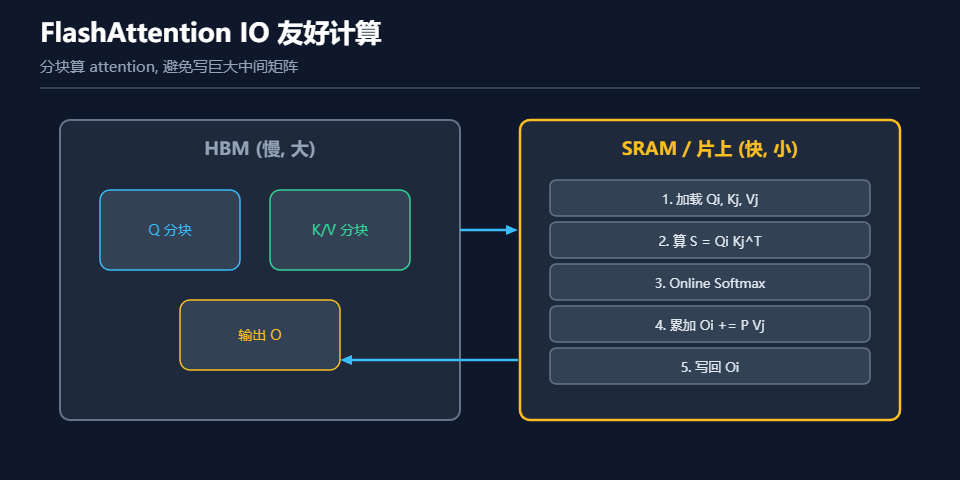
import numpy as np

def attention_naive(q, k, v, causal=False):
    # q/k/v: [S, D]
    scale = 1.0 / np.sqrt(q.shape[-1])
    scores = (q @ k.T) * scale
    if causal:
        mask = np.triu(np.ones_like(scores), k=1).astype(bool)
        scores = np.where(mask, -1e9, scores)
    p = softmax_stable(scores, axis=-1)
    return p @ v
Prefill vs Decode:同名算子,不同瓶颈
Serving 场景必须区分两个阶段:
- Prefill:一次吃完整 prompt,Q/K/V 都长,大 GEMM + FlashAttention 为主,偏算力
- Decode:每步只来 1 个新 token,读历史 KV Cache,常变成带宽墙
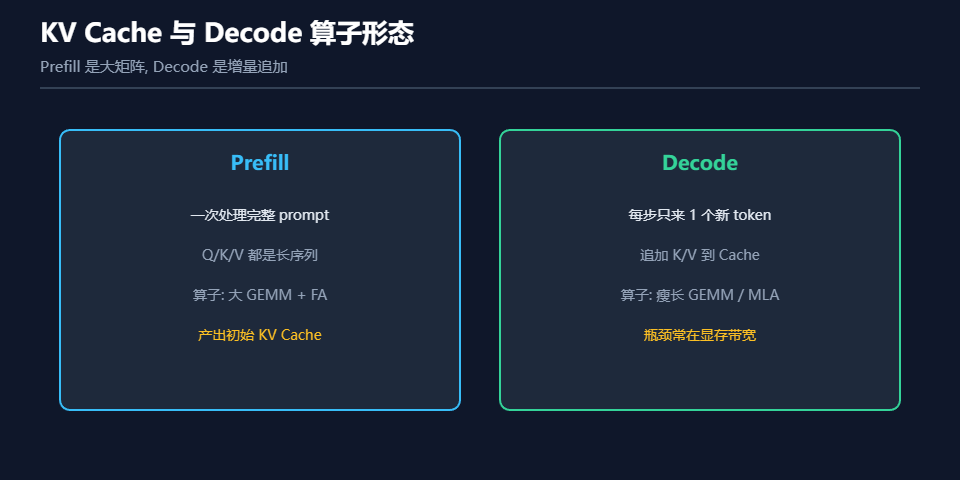
这也是为什么“Attention 优化”在训练论文和推理系统里侧重点不同:训练更关心长序列算力与显存;推理 decode 更关心 KV 读取、cache 布局、量化与 batch 调度。
Attention 变体:MHA / MQA / GQA / MLA
不同模型用不同方式压缩 KV Cache,这直接改变 decode 带宽与算子形态:
- MHA:每个 Q 头都有独立 K/V 头,KV Cache 最大,质量最好
- MQA:所有 Q 头共享 1 组 K/V,KV Cache 最小,质量略降
- GQA:分组共享,介于两者之间,是当前主流(LLaMA 系)
- MLA:低秩压缩 KV,存 latent 向量,decode 时再上投影,DeepSeek 系代表
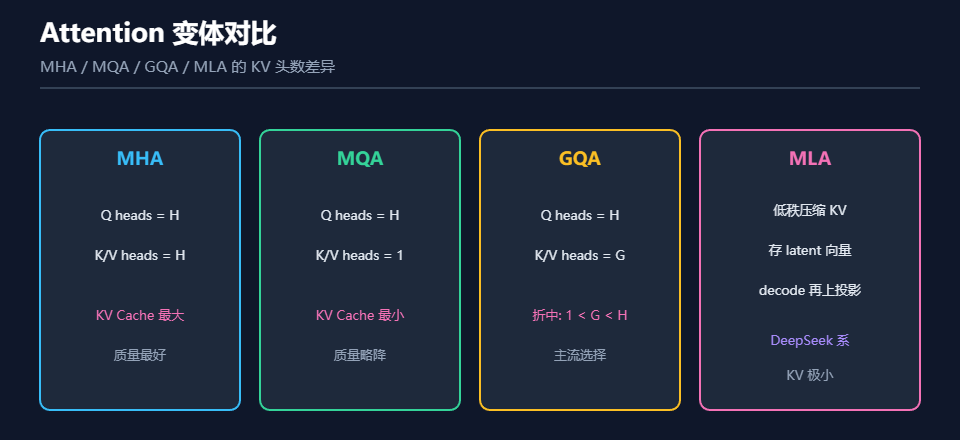
从算子视角看,GQA/MLA 改变的是 K/V 的形状与读取模式:GQA 需要广播或分组索引,MLA 则把“读 K/V”变成“读 latent + 一次小 GEMM 上投影”,从而把 decode 带宽墙转化为更可控的小算力开销。
Paged KV Cache:像虚拟内存一样管理
朴素 KV Cache 按最大序列长度预留连续显存,碎片严重且浪费。Paged KV Cache(vLLM 首推)把 KV 分成固定大小的小块,按需分配,用页表把逻辑序列映射到物理块池。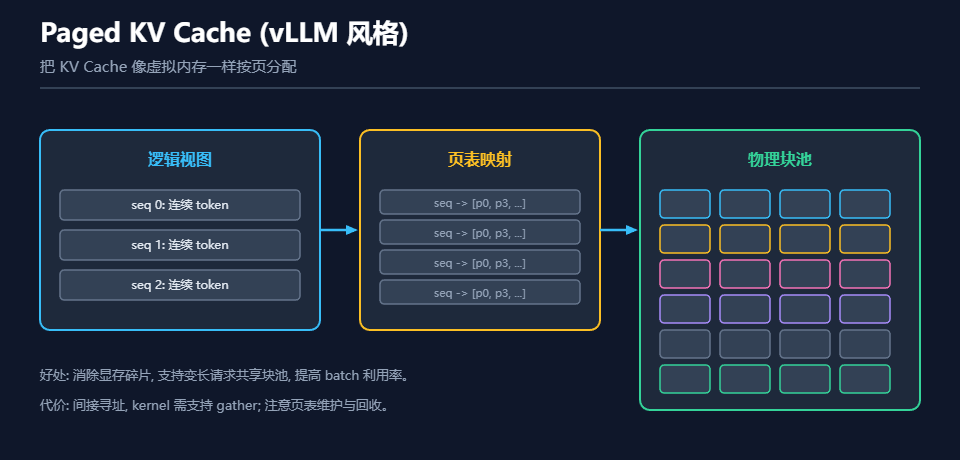
它的工程意义远超“省显存”:
- 支持变长请求混批,batch 利用率显著提升
- 块可被不同序列复用(如 prefix sharing)
- 代价是 kernel 需支持间接寻址(gather),页表维护与回收要小心
3.6 RoPE:把位置乘进向量
RoPE(Rotary Positional Embedding)通过对 Q/K 的成对维度做平面旋转,把位置信息注入注意力内积。实现上通常预计算 cos/sin 表,然后做一次融合乘加;常与 QKV 投影尾部或 attention 前处理融合。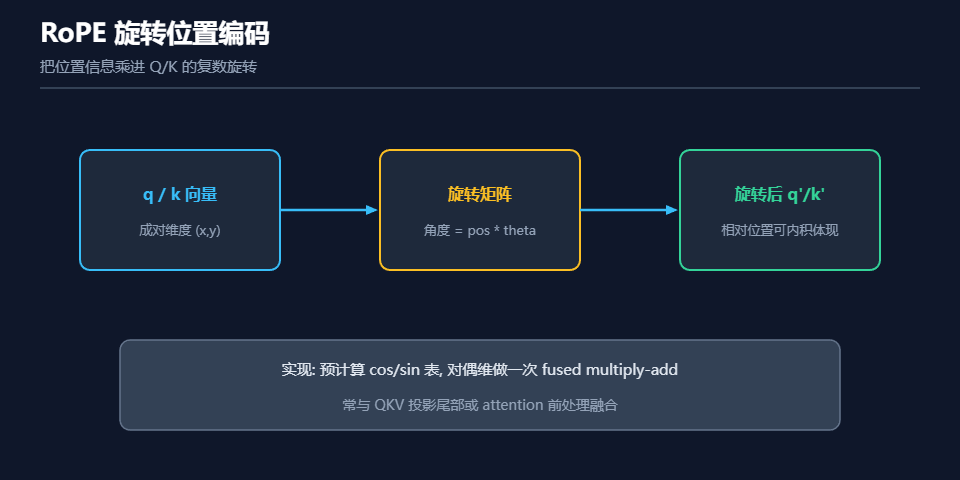
import numpy as np

def apply_rope(x, cos, sin):
    # x: [S, D], D 为偶数;成对维度旋转
    x1 = x[..., ::2]
    x2 = x[..., 1::2]
    y1 = x1 * cos - x2 * sin
    y2 = x1 * sin + x2 * cos
    out = np.empty_like(x)
    out[..., ::2] = y1
    out[..., 1::2] = y2
    return out
3.7 Embedding:看起来简单,系统里并不简单
Embedding 本质是按 token id 从大表 gather 向量。计算量不大,但大词表随机访问会打带宽和 TLB;若启用 vocab 并行,还会引入额外通信。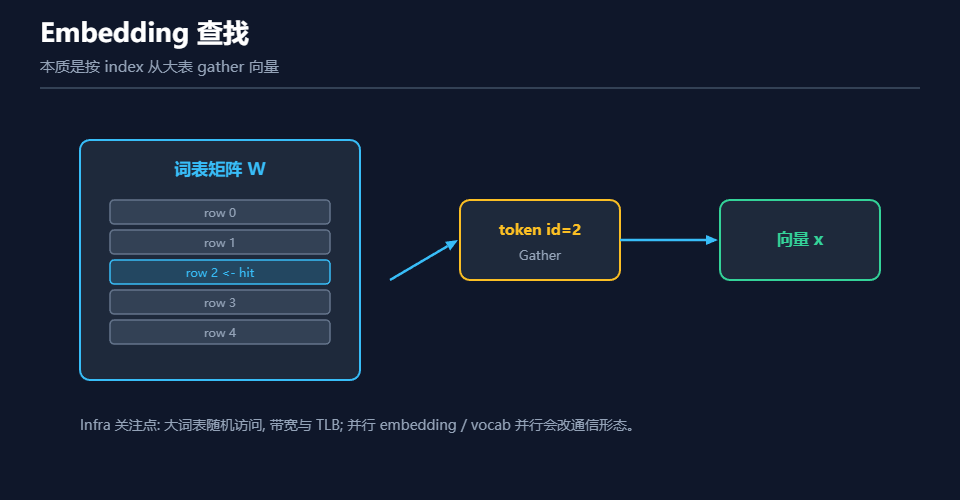
import numpy as np

def embedding_lookup(weight, token_ids):
    # weight: [V, D], token_ids: [S]
    return weight[token_ids]
3.8 卷积与 im2col(CV / 多模态侧)
LLM 为主的文章里卷积常被略过,但多模态、视觉编码器、扩散模型里它仍是主力。卷积本身是滑窗加权求和,直接实现嵌套循环很慢。工程上常用两种思路:
- im2col:把每个感受野 patch 拉成一行,卷积变成一次大 GEMM,能复用高度优化的矩阵乘库;代价是临时矩阵大
- Winograd:用代数变换减少乘法数,对小卷积核(如 3x3)有效
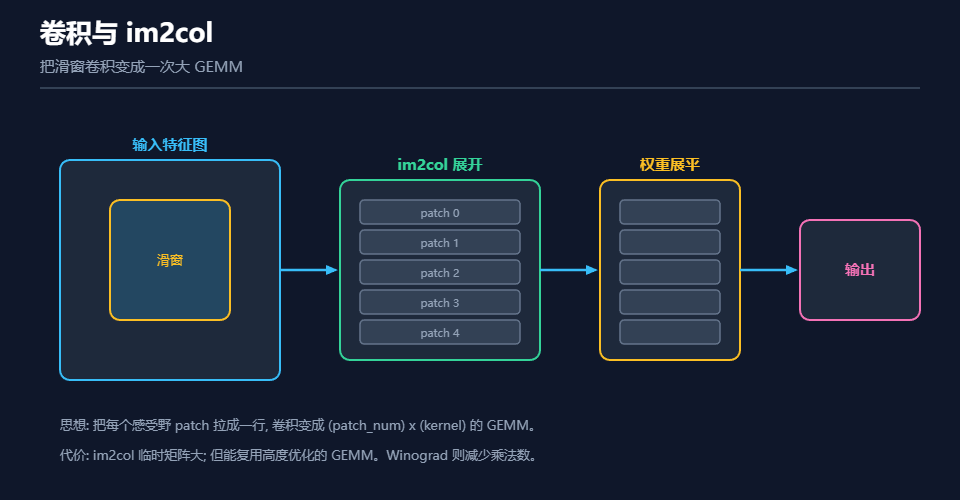
入门要点: - 现代推理引擎里卷积常被
conv -> matmul改写,或直接用 cuDNN 这类高度调优库 - 多模态模型里要注意 conv 与 attention 的 layout 转换(NCHW vs NHWC vs 序列化)
- depthwise conv 是带宽墙大户,常需特化核
4. 访存与布局算子:看不见的性能杀手
4.1 Elementwise vs Reduction
优化前先分清模式:
- Elementwise:一对一映射,易并行,常带宽受限
- Reduction:多对一规约,需要同步与树形归约,算法更讲究
Softmax、Norm、Loss 都有 reduction;Add/Mul/SiLU 多为 elementwise。融合时常把 elementwise 接到 GEMM epilogue,把 reduction 做成一次扫描或 online 算法。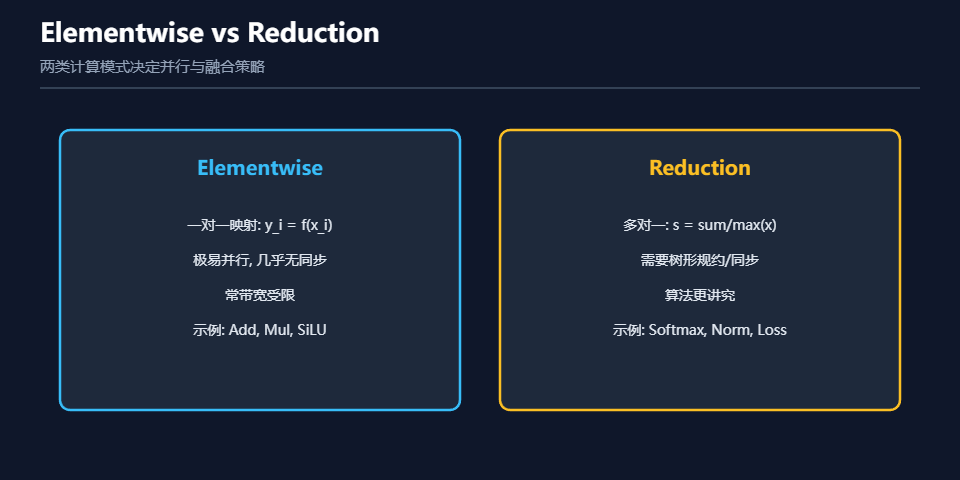
4.2 Transpose / View / Contiguous
transpose 和 view 常常只改 stride,不搬数据;一旦后续 kernel 要求合并访问或要求 contiguous,框架可能插入隐式拷贝。Profile 里突然冒出的 memcpy / contiguous,往往来自这里。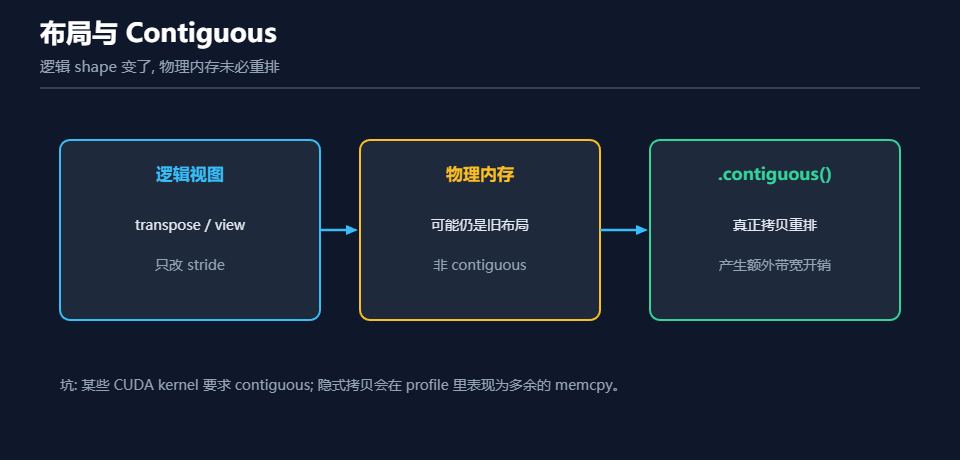
实践建议:
- 设计算子时尽量让下游直接消费目标布局
- 关注
NHWC/NCHW、row-major、head 维排列对 Attention 的影响 - KV Cache 的 layout(页式、连续、分头)会显著影响 decode 带宽
4.3 合并访问:拿到标称带宽的前提
GPU 一次访存事务能搬运一段连续字节。若 warp 内 32 个线程读的是连续地址,就能用一次事务完成,称为合并访问;若读的是跨步地址,则需要多次事务,有效带宽大幅下降。
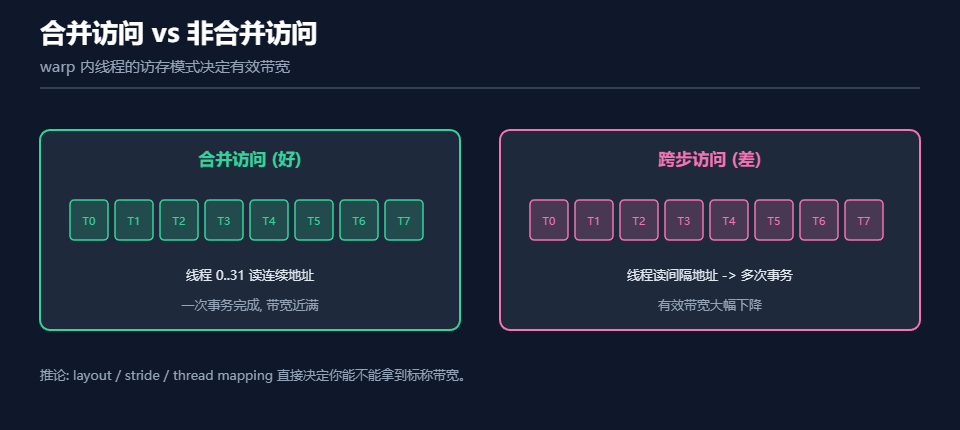
这解释了一个常见现象:同一个算子换一种 layout 或换一种 thread mapping,速度能差好几倍。写 Triton/CUDA 时,tl.load / tl.store 的指针连续性、对齐到 16/32 字节,都是基本盘。
5. 算子融合:AI Infra 最划算的优化之一
融合的目标不是“少写几个函数”,而是少写中间结果到 HBM,从而提高有效算术强度、减少 kernel launch。
典型融合:
Linear + Bias + ActivationRMSNorm + ResidualAttention内部的MatMul + Softmax + MatMul- 量化 GEMM 的
scale + dequant + epilogue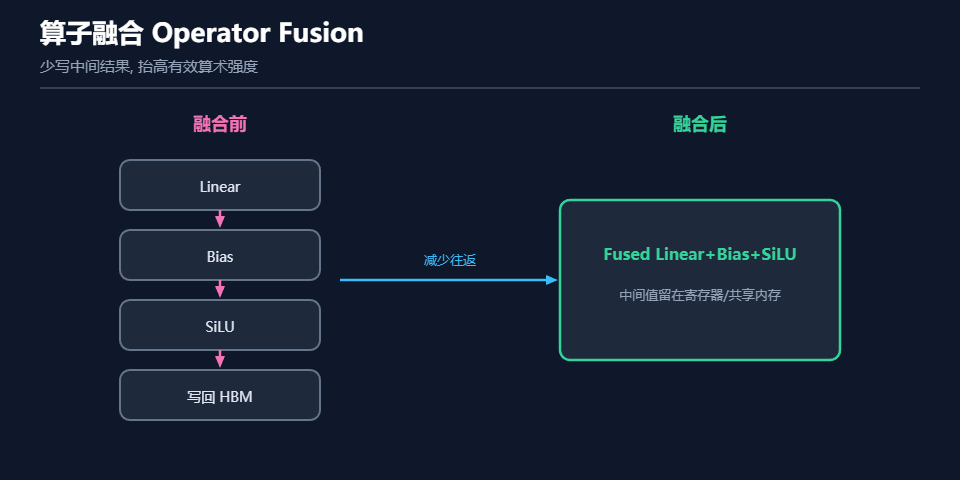
判断该不该融合,可用三个问题:
- 中间张量是否很大、是否只被下一个算子用一次?
- 融合后寄存器 / 共享内存是否还能放下?
- 融合是否破坏复用(同一个中间结果被多处消费)?
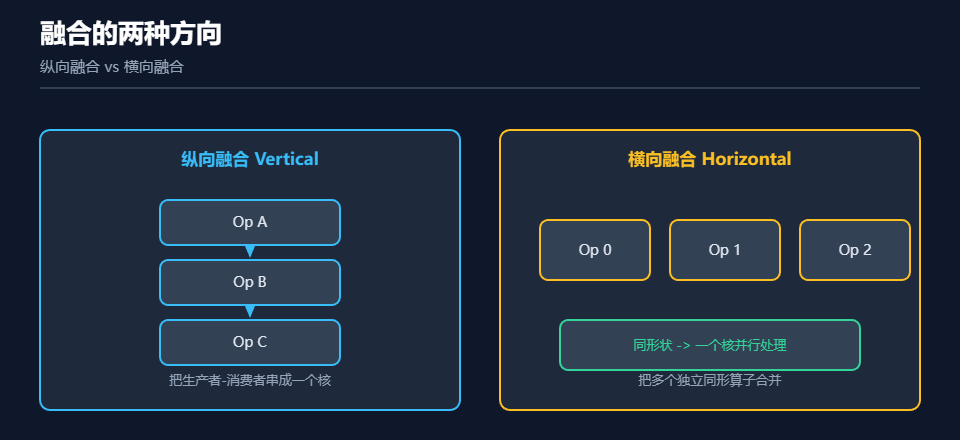
5.1 两种融合方向
- 纵向融合:把生产者-消费者串成一个核,如
Linear -> Bias -> SiLU合一 - 横向融合:把多个独立但同形的算子合并成一个核并行处理,如多个 elementwise 一起算
5.2 CUDA Graph:把 launch 开销也摊薄
decode 阶段每步只有几个小 kernel,CPU 调度 launch 本身就成了瓶颈。CUDA Graph 把整张算子图录制一次,之后每次回放只需一次 launch,CPU 几乎不参与。它特别适合结构固定的 decode loop。
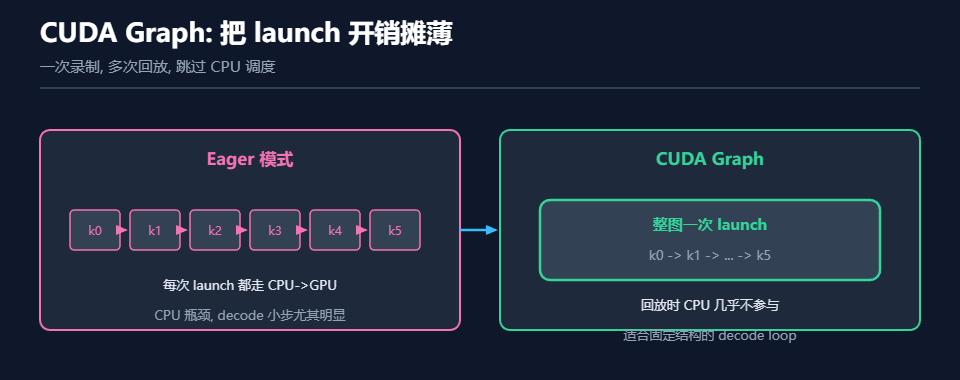
注意:CUDA Graph 要求结构固定、形状稳定;动态形状(变长 batch)需要分桶、padding 或多图管理。
6. 分布式与通信算子
单卡算子会算,不代表能做大模型。模型并行会强制插入通信算子。
6.1 AllReduce / AllGather / ReduceScatter
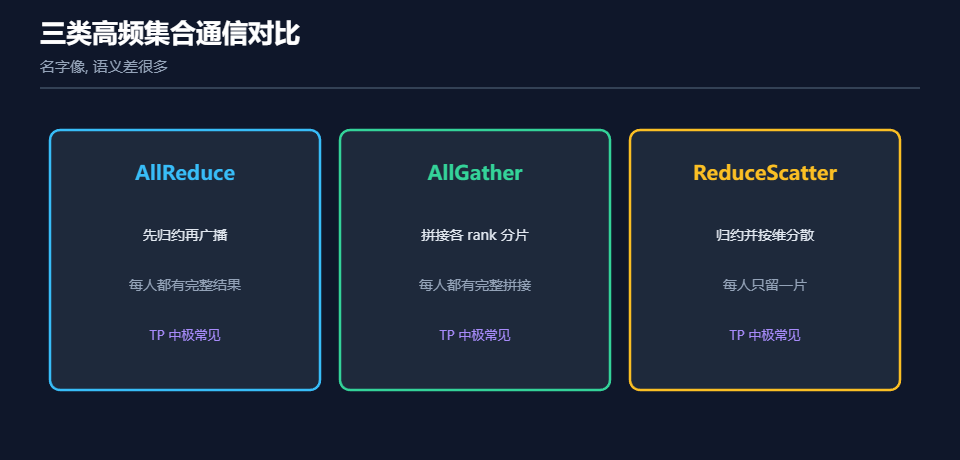
这三者最容易混:
- AllReduce:先归约再让每人拿到完整结果
- AllGather:把各 rank 的分片拼成完整张量
- ReduceScatter:归约后按维度分散,每人只留一片
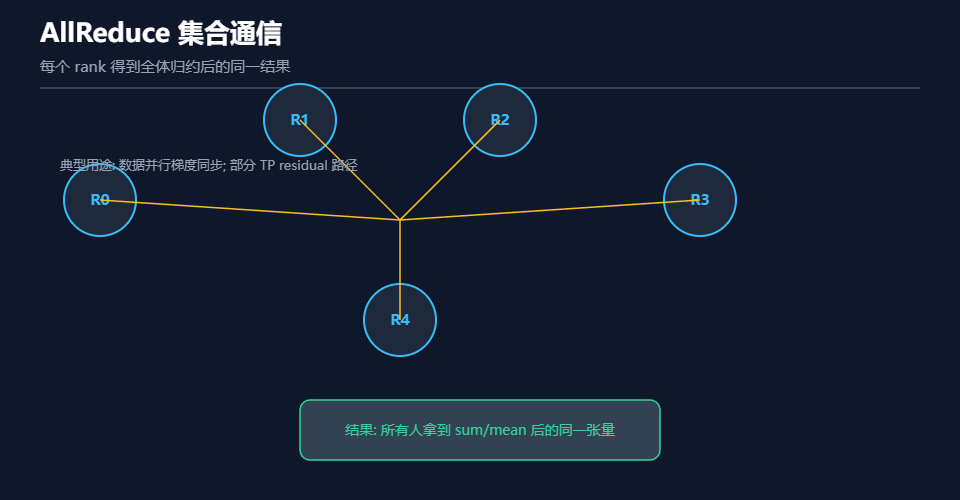
集合通信不是“调一下就行”,同一原语有不同算法实现,带宽与延迟特性不同: - Ring(环):每个 rank 只与左右邻居通信,带宽利用率高,适合大消息
- Tree(树):层级归约再广播,延迟低,适合小消息
实际库(NCCL)会按消息大小自动切换。入门时记住“大消息看带宽、小消息看延迟”即可。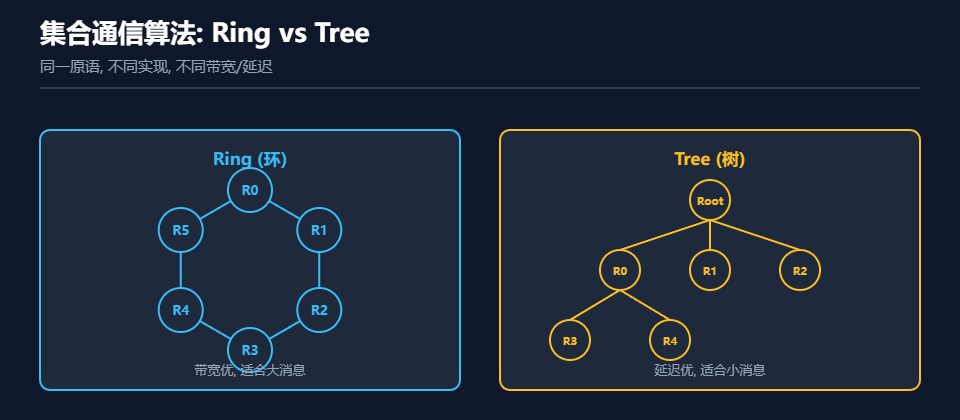
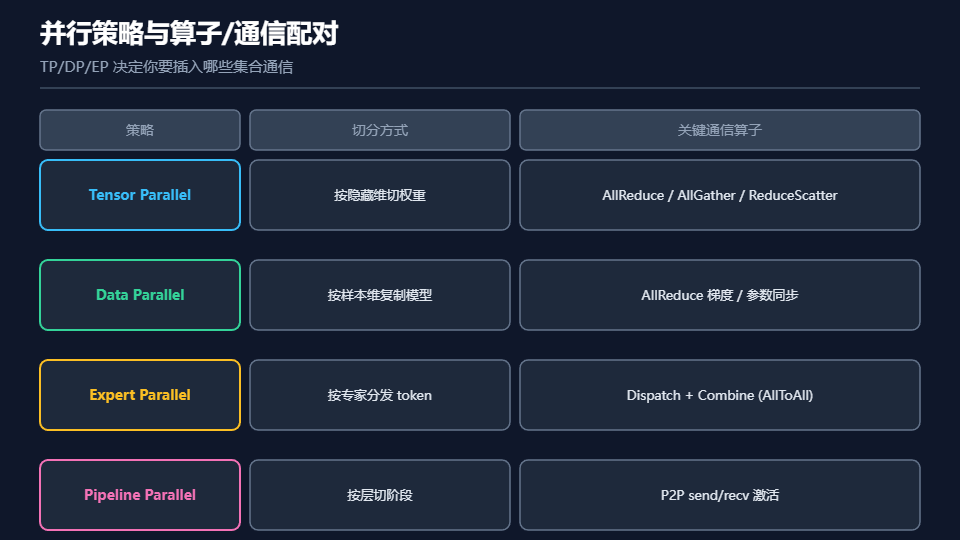
6.2 并行策略决定通信形态
| 策略 | 切分方式 | 关键通信 |
|---|---|---|
| Tensor Parallel | 按隐藏维切权重 | AllReduce / AllGather / ReduceScatter |
| Data Parallel | 按样本复制模型 | 梯度 AllReduce |
| Expert Parallel | 按专家分发 token | AllToAll(Dispatch/Combine) |
| Pipeline Parallel | 按层切阶段 | P2P send/recv |
 |
6.3 MoE 算子链
MoE 不是“多几个 FFN”这么简单,关键是路由与通信:
Router -> Dispatch(AllToAll) -> Expert GEMM -> Combine
难点通常在负载不均、通信抖动、以及专家计算与通信 overlap。对 DeepSeek / Mixtral 一类模型,MoE 通信优化和 Attention 优化同样关键。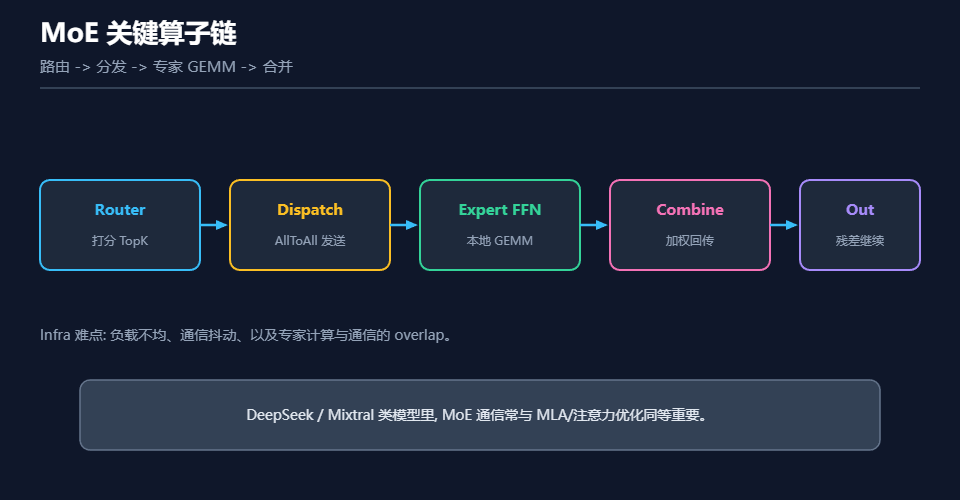
6.4 计算-通信重叠:把通信藏进计算里
TP/EP 场景下,若通信和计算串行执行,GPU 在通信期间只能空等。常见手法是把一层拆成 A/B 两半,让 A 的通信与 B 的计算重叠;或用独立 stream 把通信提交到与计算并行的队列。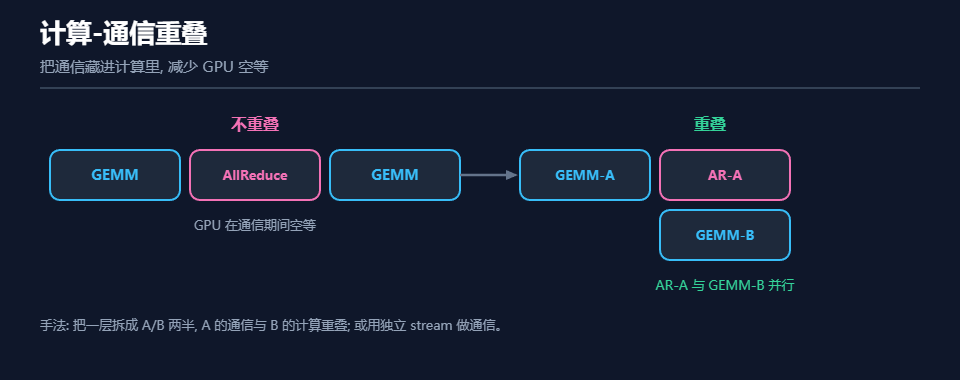
工程上这通常表现为:
- 在 GEMM 尾部 epilogue 期间启动下一层的通信
- 用
torch.cuda.Stream/ NCCL 的 group API 把多个通信组合并提交 - MoE 里把 Dispatch 与上一层的尾部计算重叠
7. 量化相关算子
推理里量化不是一个算子,而是一组算子拼图:Quantize、低精度 GEMM、Scale/Epilogue,有时还有 Dequant。趋势是尽量不单独 dequant,而是把 scale 与激活融进 GEMM 尾部。
还要区分对象:
- 权重量化:省参数显存与读带宽
- 激活量化:动态范围更难,常按 token / per-tensor 处理
- KV Cache 量化:直接打 decode 带宽痛点
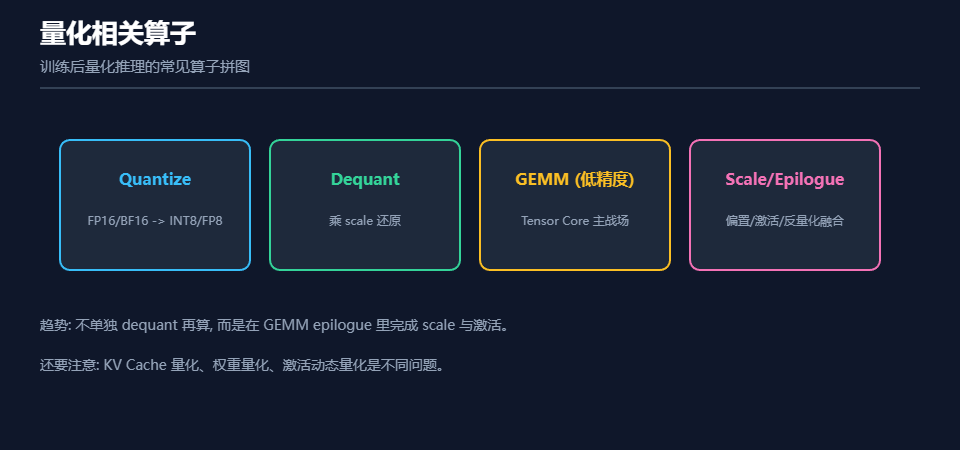
精度问题上,记住一句话:存储精度和核内累加精度不是一回事。输入可以是 FP16/BF16/FP8,核内累加常保留 FP32,再按策略写回。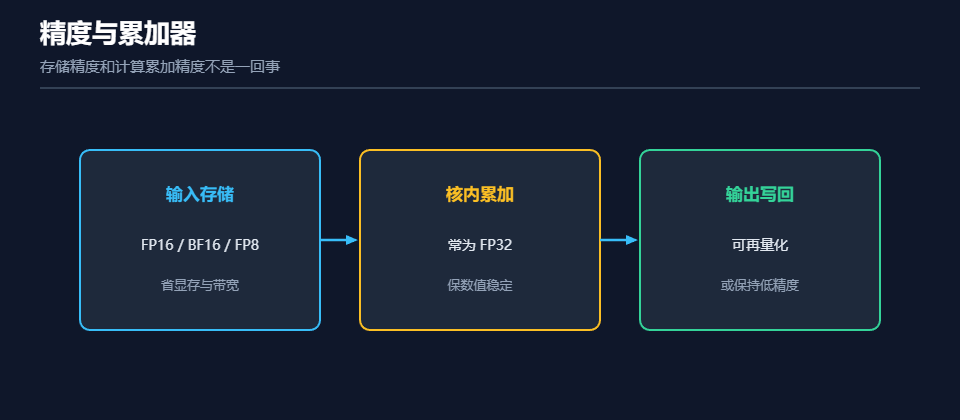
8. 实现是怎么落到硬件上的
从 Python 调用到 SM 执行,大致经过:API -> Dispatcher 选核 -> Launch 配置 -> SM/warp 执行 -> 写回与同步。优化抓手通常是:减少 launch(融合、CUDA Graph)、提高占用、重叠通信与计算。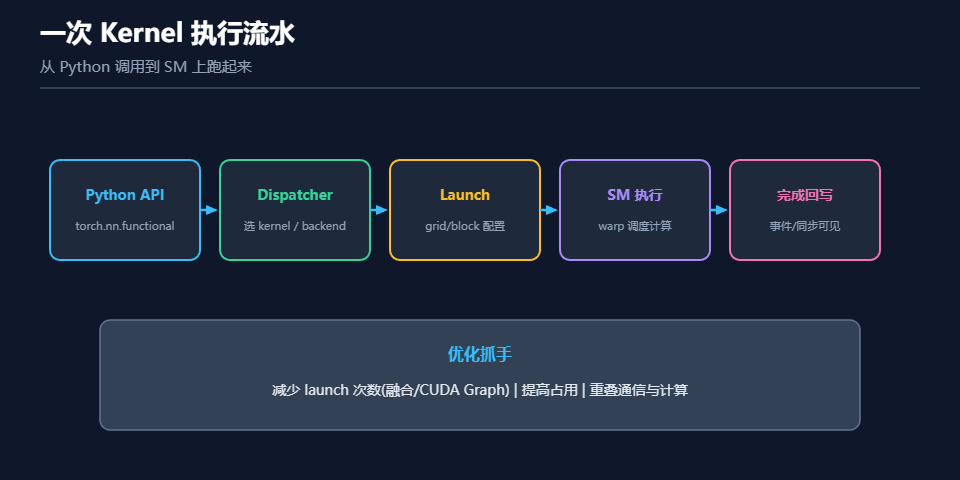
同一算子语义,可落在多层实现路径上:PyTorch aten、C++ dispatcher、CUDA/Triton/CUTLASS、再到 PTX/SASS。入门建议是:先会用会测,再理解融合边界,最后再写 Triton / CUDA。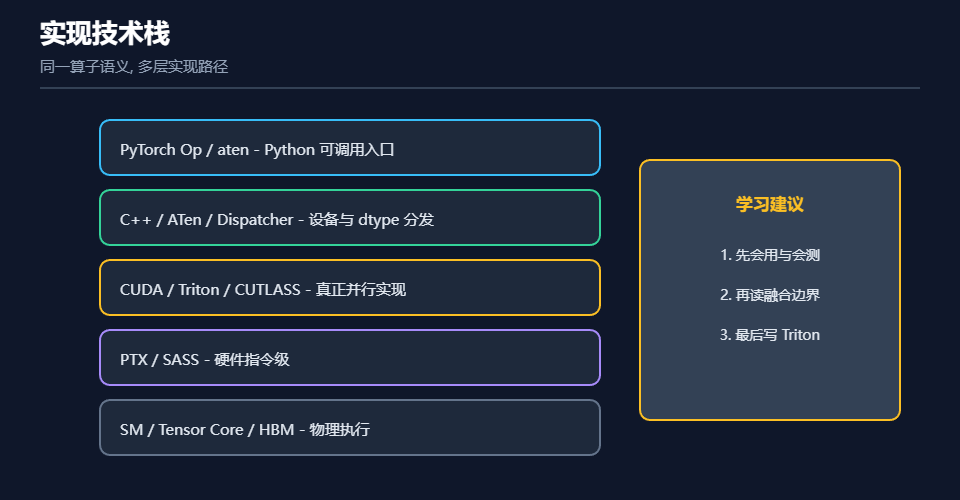
下面是一个“教学向” Triton 风格伪代码结构(示意 Softmax 行归约思想,不是完整可跑生产核):
# 伪代码:按行做稳定 softmax 的实现骨架
# for each row:
#   m = max(row)
#   d = sum(exp(row - m))
#   out = exp(row - m) / d

def softmax_kernel_skeleton(X, Y, stride, n_cols):
    row = program_id(0)
    # 1) reduce max
    m = -inf
    for off in range(0, n_cols, BLOCK):
        m = max(m, load_max(X[row], off))
    # 2) reduce sum(exp(x-m))
    d = 0.0
    for off in range(0, n_cols, BLOCK):
        d += load_sum_exp(X[row], off, m)
    # 3) write normalized values
    for off in range(0, n_cols, BLOCK):
        store_exp_div(X[row], Y[row], off, m, d)
你在真实项目中更常见的路径是:
- 用 PyTorch profiler / Nsight 找到热点
- 判断是带宽墙、算力墙,还是通信墙
- 优先找现成融合核(FlashAttention、fused RMSNorm 等)
- 仍不够时,再用 Triton 做定制 epilogue / 布局特化
8.1 Profiling 工具图谱
不同工具看不同层级的问题,组合使用才有效:
| 工具 | 看什么 |
|---|---|
| PyTorch Profiler | 算子级耗时、图结构、内存曲线 |
| Nsight Systems | kernel 时间线、overlap、CPU-GPU 关系 |
| Nsight Compute | 单 kernel 指标、占用、带宽达成率 |
| torch.profiler + TensorBoard | 趋势可视化、对比 |
| 自建 micro-bench | Roofline 校准、带宽实测 |
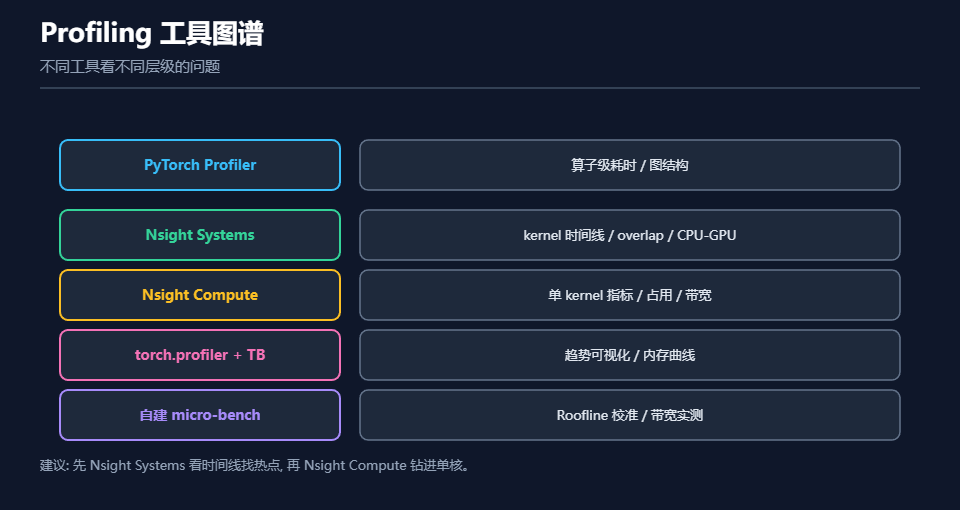 | |
| 一个推荐流程:先 Nsight Systems 看时间线找热点段,再 Nsight Compute 钻进单个 kernel 看指标,最后回到代码改融合/布局/tiling。 |
8.2 训练侧算子:前向之外的世界
本文以推理为主,但 AI Infra 入门也要知道训练侧的高频算子:
- CrossEntropy:大 vocab 上做归约,常与 logits 的 GEMM 融合
- Backward:梯度反传,GEMM 转置版,计算量常是前向的 2 倍
- Gradient Clip:先算全局 norm 再 scale,是 reduction + elementwise
- Adam Update:维护一阶/二阶矩,elementwise + reduction,是带宽墙大户
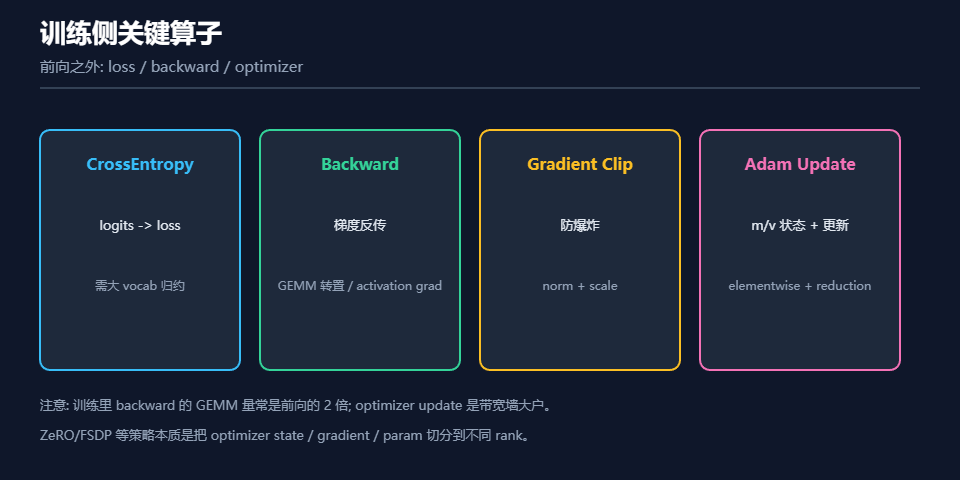
ZeRO / FSDP 等策略的本质,就是把 optimizer state / gradient / param 切分到不同 rank,用通信换显存。
9. 案例:一层 Transformer 如何拆解
把一层 Decoder Block 拆开,大致是:
- RMSNorm
- QKV GEMM(常合并)
- RoPE
- Attention(FlashAttention / MLA 等)
- Output GEMM
- Residual Add
- RMSNorm
- SwiGLU FFN(Up/Gate、SiLU⊗、Down)
- Residual Add
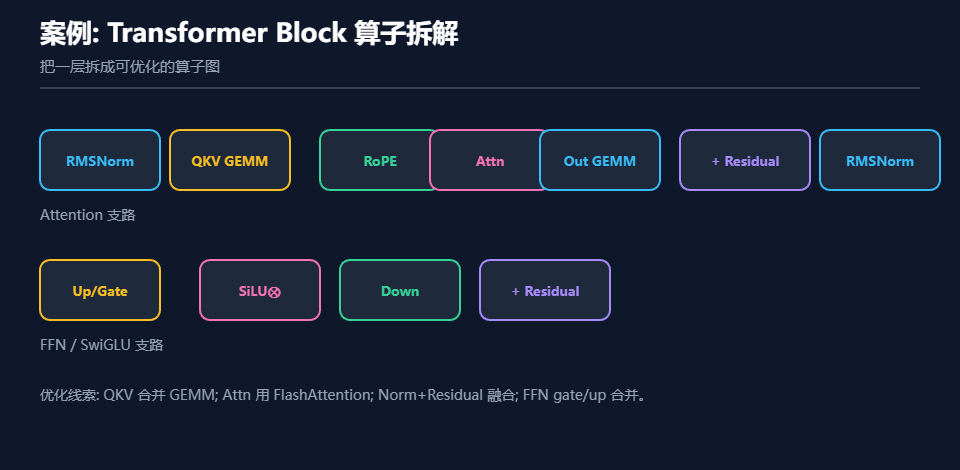
对应优化线索非常直接:
- QKV 合并,减少一次/两次小 GEMM
- Attention 走 IO 友好实现
- Norm 与 Residual 融合
- FFN 的 gate/up 合并,激活不单独落 HBM
- 分布式时在正确位置插入 ReduceScatter/AllGather,并尽量 overlap
10. 权衡:没有绝对最快的算子实现
同一个算子在不同目标下会选不同实现。短 decode 更在乎延迟与 KV 带宽;长 prefill 更在乎大 GEMM 与 FlashAttention;MoE 则经常被通信和专家均衡主导。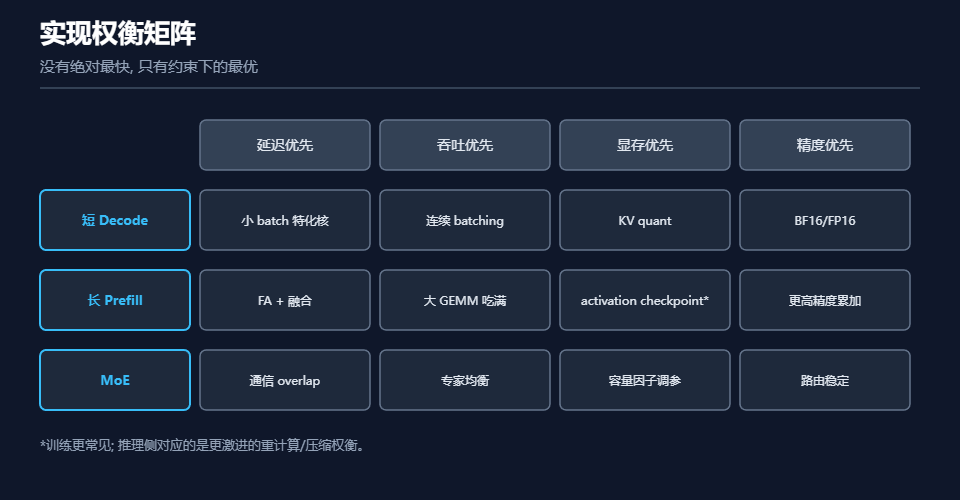
一个可执行的判断顺序:
- 先看阶段:prefill 还是 decode
- 再看并行:有没有 TP/EP 通信
- 再看精度:能否用 FP8/INT8/KV quant
- 最后才看要不要手写 kernel
11. 常见误区
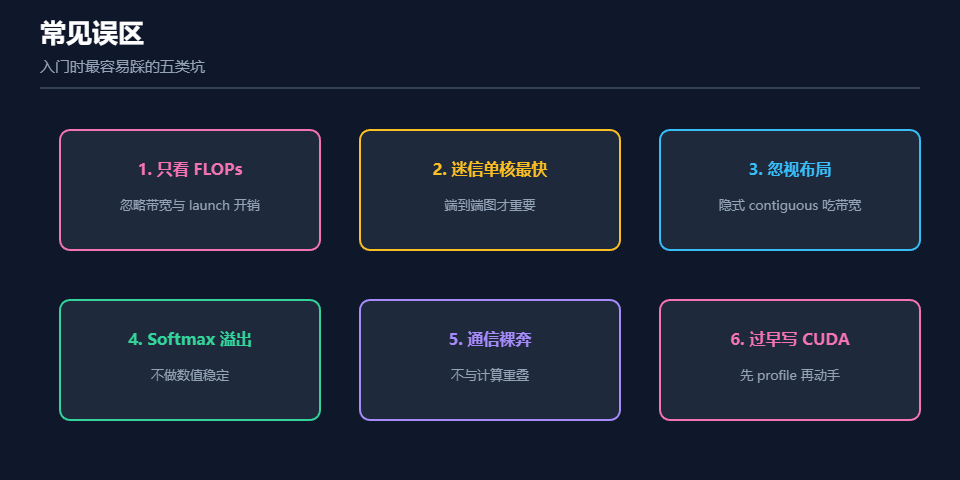
- 只看 FLOPs
很多慢,不是算得少,而是搬得多、launch 多、同步多。 - 迷信单核最快
微基准第一的 kernel,如果破坏融合或让图更碎,端到端可能更慢。 - 忽视布局
transpose后隐式contiguous会偷走带宽。 - Softmax 不做数值稳定
长序列、大 logits 时直接exp会 Inf/NaN。 - 通信裸奔
TP/EP 场景不把通信和计算重叠,GPU 会大量空等。 - 过早写 CUDA
没 profile 就手写核,是最高频的时间浪费。
12. 实践清单
12.1 看到一个热点算子时
12.2 四周学习路径
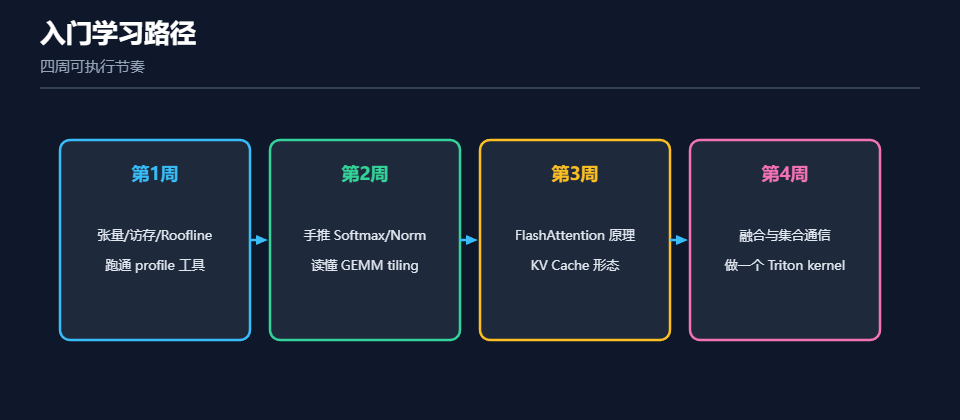
- 第 1 周:张量、访存层次、Roofline;学会 profiler
- 第 2 周:手推 Softmax/RMSNorm;读懂 GEMM tiling
- 第 3 周:FlashAttention 与 KV Cache;区分 prefill/decode
- 第 4 周:融合、集合通信;用 Triton 写一个小核并做正确性对比
12.3 最小实验建议
- 用同一输入对比
matmul + silu分离实现与融合实现的耗时 - 对长序列对比朴素 attention 与 FlashAttention 的显存
- 在 TP=2 时观察 Linear 前后的 AllReduce/AllGather 占比
- 给 decode 打开/关闭 KV 量化,看带宽与精度变化
13. FAQ
Q1. 算子和层有何区别?
层是模型构建单元,算子是执行单元。一层可能展开成多个算子,也可能被融合成一个更大的核。
Q2. 为什么 decode 好像“算得少却很慢”?
因为每步都要读增长中的 KV Cache,算术强度低,常撞带宽墙;再叠加小 batch 时 GPU 利用率不足。
Q3. 要从 CUDA C++ 入门吗?
不必立刻。先建立性能模型和算子图谱,再用 Triton 做可迭代实验,最后再深入 CUDA/CUTLASS。
Q4. Triton 够用吗?
对很多 elementwise、融合 epilogue、教学与定制核够用;极致 GEMM/Attention 仍常依赖厂商库或高度特化实现。
Q5. 如何选精度?
优先保证关键路径数值稳定(注意力累加、Norm),再在权重/KV/激活上分层量化。正确性对比集要先准备好。
Q6. 怎么验证算子正确性?
固定种子与输入,和 FP32 / 官方参考实现对比最大绝对误差与相对误差;再补边界用例:全零、极值、非对齐长度、causal mask、空序列。
Q7. GQA / MLA 改变了哪些算子?
主要改 K/V 的形状与读取:GQA 需要分组广播或索引,MLA 把“读 K/V”变成“读 latent + 小 GEMM 上投影”,从而把 decode 带宽墙换成更可控的小算力。
Q8. Paged KV Cache 值得学吗?
值得。它是现代推理引擎高吞吐的基础,理解它就理解了变长混批、prefix sharing 和显存碎片问题。
Q9. CUDA Graph 什么时候用?
结构固定、形状稳定的循环最适合,典型就是 decode loop。形状频繁变化时要分桶或重建图,反而增加复杂度。
Q10. 训练和推理的算子优化重点差在哪?
训练更关心 backward 的 GEMM、optimizer 更新、梯度通信;推理更关心 KV Cache 带宽、融合、batch 调度与 CUDA Graph。
14. 术语表
| 术语 | 含义 |
|---|---|
| Operator / Kernel | 张量计算的语义单元及其硬件实现 |
| Arithmetic Intensity | 每字节访存对应的计算量 |
| Tiling | 把大问题切成适配片上内存的小块 |
| Split-K | 沿 K 维切分 GEMM 以提高并行度 |
| Grouped GEMM | 一次 launch 跑多个变长小 GEMM |
| Epilogue | GEMM 后的尾部处理(bias/激活/写回) |
| Online Softmax | 流式维护 max/sum 的 Softmax 算法 |
| FlashAttention | IO 友好的注意力实现范式 |
| MHA / MQA / GQA / MLA | 不同 KV 头共享/压缩方式的注意力变体 |
| KV Cache | 推理时缓存历史 K/V 以避免重算 |
| Paged KV Cache | 按页分配 KV Cache, 消除碎片 |
| Coalesced Access | warp 内线程读连续地址, 拿满带宽 |
| Collective | 多卡集合通信原语 |
| Ring / Tree | 集合通信的两种算法实现 |
| Fusion | 合并多个算子以减少内存往返 |
| CUDA Graph | 录制算子图一次, 回放时跳过 CPU 调度 |
| Occupancy | SM 上活跃 warp 的利用程度 |
15. 下一步
AI Infra 入门最有效的路径,不是先把所有 API 背完,而是抓住这条主线:
算子语义 -> 访存/算力瓶颈 -> 融合与布局 -> 分布式通信 -> 精度与特化实现
你真正要反复训练的能力只有三件:
- 看到模型层时,能拆成算子图
- 看到耗时时,能判断墙在算力、带宽还是通信
- 看到优化手段时,知道它改变的是哪一项约束
下一步可以直接做两件事:
- 选一个开源 LLM 推理引擎,抓一份 decode profile,标出 Top 5 算子并归类
- 用 Triton 实现 fused
RMSNorm或Linear+SiLU,与基线对比正确性和速度
当你能把“一层 Transformer”稳定翻译成“一组可解释的算子与瓶颈”时,就已经跨过 AI Infra 入门最关键的门槛。
阅读导航



