
滑动窗口注意力 SWA:KV Cache 与长上下文推理
模型推理中的滑动窗口注意力(SWA)
什么是 SWA
Sliding Window Attention(SWA,滑动窗口注意力) 是全注意力(Full Attention)的一种"局部化"变体:每个 query token 只关注它前面最近 W 个 token(W 称为窗口大小 / window size),窗口之外的旧 token 不参与注意力计算,其 KV 也不再保留。
- 全注意力:token
t_N看到从t_0到t_{N-1}的全部历史,复杂度O(N^2)。 - SWA(window=W):token
t_N只看到t_{N-W}到t_{N-1},复杂度O(N*W),当W << N时近似线性。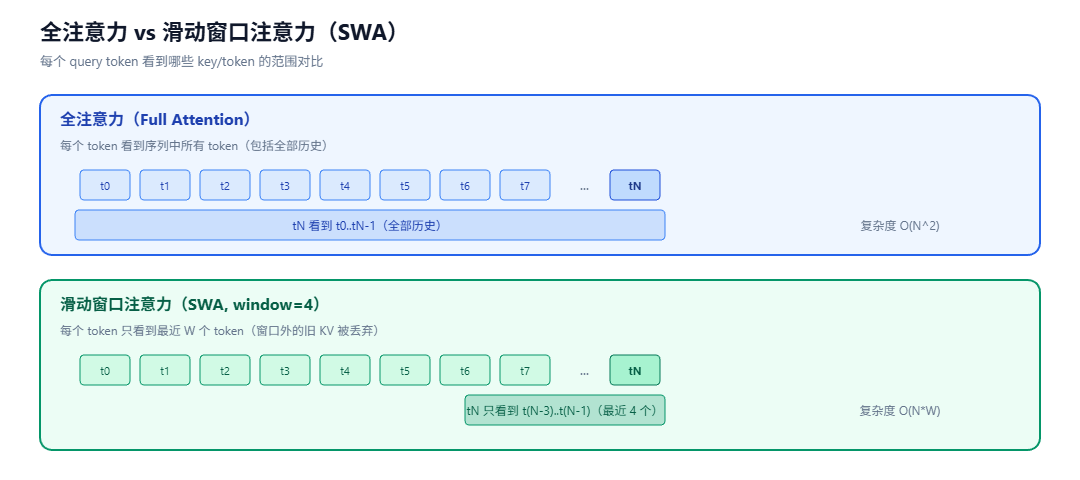
直观理解:把全注意力想象成"每个 token 都能回望整段历史",SWA 则是"每个 token 只能回望最近一段固定长度的窗口",窗口随序列推进而滑动。
典型使用 SWA 的模型:Mistral(部分版本)、Gemma2、Command-R、MiniCPM、Zaya、Mimo-v2-NextN 等。其中很多采用 Hybrid SWA(Full 层与 SWA 层交替),而不是纯 SWA。
为什么需要 SWA
全注意力的核心代价是 KV Cache 显存随序列长度线性增长:
- 序列长度
N,模型有L层,每层每 token 的 KV 占KV_size字节 - 总 KV 显存约等于
L * N * KV_size - 当
N = 128K、L = 80、KV_size较大时,KV Cache 单条请求就要几 GB 到几十 GB
这带来三个工程问题:
- batch size 上不去:显存被 KV Cache 占满,能并发的请求数少,QPS 低。
- Decode 越来越慢:每生成一个 token,都要读全部历史 KV,长序列时 decode 的访存开销随
N线性增长。 - 长上下文成本高:要支持 1M 上下文,KV 池要按 1M 规模预分配,硬件成本巨大。
SWA 的核心收益:让 KV Cache 显存与序列长度解耦,每层只存最近W个 token 的 KV,长序列时显存恒定。
代价是:丢失远距离信息——t_0 的内容 t_N 直接看不到。是否可接受取决于任务
SWA 的 KV Cache 管理
SWA 在 KV Cache 管理上的关键区别:
- 全注意力:每层都要存全部历史 N 个 token 的 KV,旧的不能丢。
- SWA:每层只存最近 W 个 token 的 KV,超出窗口的旧 KV 可以丢弃/回收。
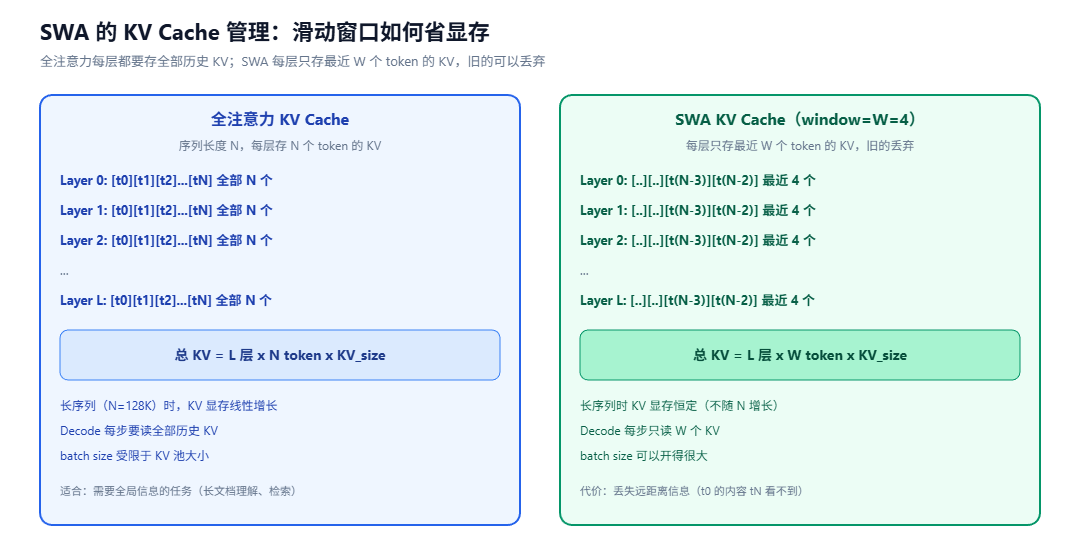
显存对比(单请求、单层):
| 方案 | 每层 KV 数量 | 总 KV 显存 | 随 N 增长 |
|-|-|-|-|
| Full Attention | N |L * N * KV_size| 线性增长 |
| 纯 SWA (window=W) | W |L * W * KV_size| 恒定 |
| Hybrid SWA | Full 层存 N,SWA 层存 W | 介于两者之间 | Full 层线性、SWA 层恒定 |
对 Decode 的影响: - 全注意力 Decode 每步读
N个 KV,长序列时访存成为瓶颈。 - SWA Decode 每步只读
W个 KV,访存恒定,长序列 decode 速度稳定。
信息流:远距离信息如何跨窗口传递
一个常见疑问:SWA 只看最近 W 个 token,那 t_0 的信息怎么传到 t_N?
答案:信息通过逐层 hidden state 搬运。单层 SWA 看不到远处,但堆叠 L 层后,有效感受野近似 L * W,类似堆叠局部卷积获得大感受野。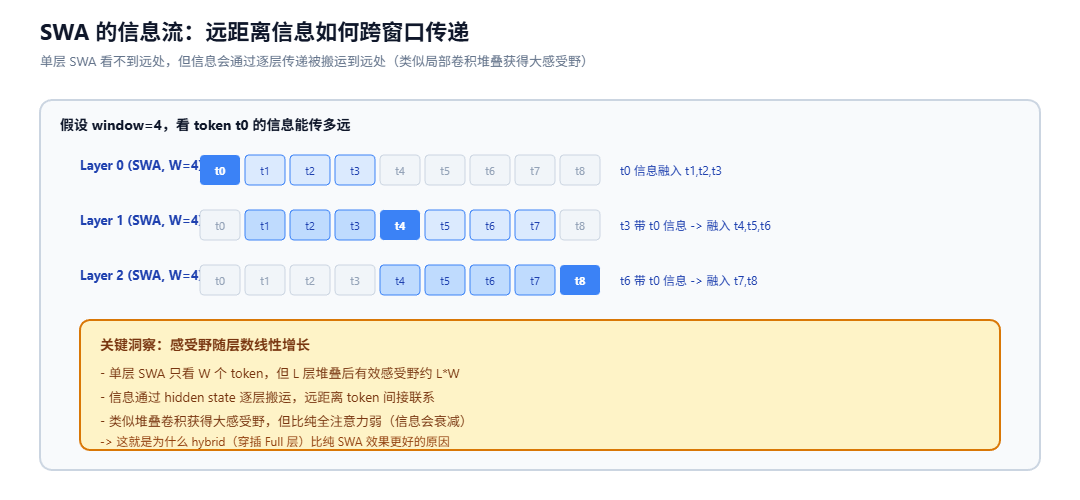
关键洞察:
- 单层 SWA 只看 W 个 token,但 L 层堆叠后有效感受野约
L * W。 - 信息通过 hidden state 逐层搬运,远距离 token 间接联系。
- 类似堆叠卷积获得大感受野,但比纯全注意力弱(信息会衰减)。
这就是为什么 Hybrid(穿插 Full 层)比纯 SWA 效果更好:Full 层提供"全局高速公路",保证远距离信息不衰减;SWA 层负责省显存。两者交替堆叠,兼顾长上下文能力与显存。
Hybrid SWA
Hybrid SWA 是工程上最常用的 SWA 形态:不是所有层都用 SWA,而是 Full Attention 层与 SWA 层交替堆叠。
- Full 层:保留全部历史 KV,负责全局信息传递。
- SWA 层:只存最近 W 个 KV,负责省显存。
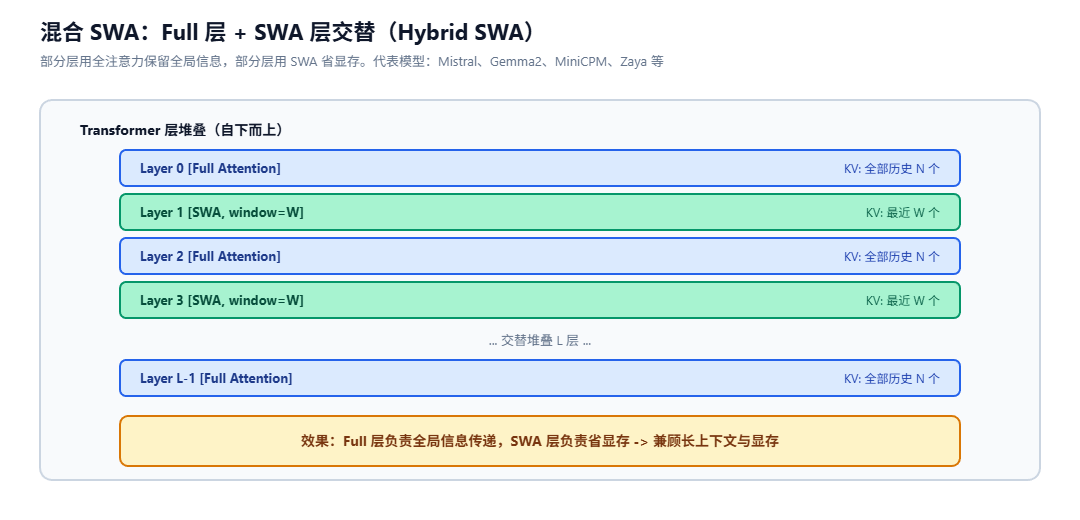
代表模型: - Gemma2:交替使用 Full + SWA 层。
- Command-R:Hybrid SWA 架构。
- MiniCPM / MiMo:Hybrid SWA。
- Mistral(部分):纯 SWA 或 Hybrid。
- Zaya:支持
swa_layers、swa_rotary_base配置,可指定哪些层用 SWA。
Hybrid 的优势:
- 远距离信息不丢失(Full 层兜底)。
- 显存比纯 Full 省(SWA 层省下大头)。
- 长上下文能力接近 Full,显存接近纯 SWA。
Hybrid 的代价:Full 层的 KV 仍随序列长度增长,所以显存不是完全恒定,只是比纯 Full 小。具体省多少取决于 Full:SWA 层的比例和窗口大小。
SGLang 的双 KV 池架构
SGLang 对 Hybrid SWA 模型采用双 KV 池设计:
full_kv_pool:存 Full Attention 层的 KV,容量大,随序列长度增长。swa_kv_pool:存 SWA 层的 KV,容量小,只存最近 W 个 token。- 两个池独立分配、独立索引(SWA 层用
swa_page_table)。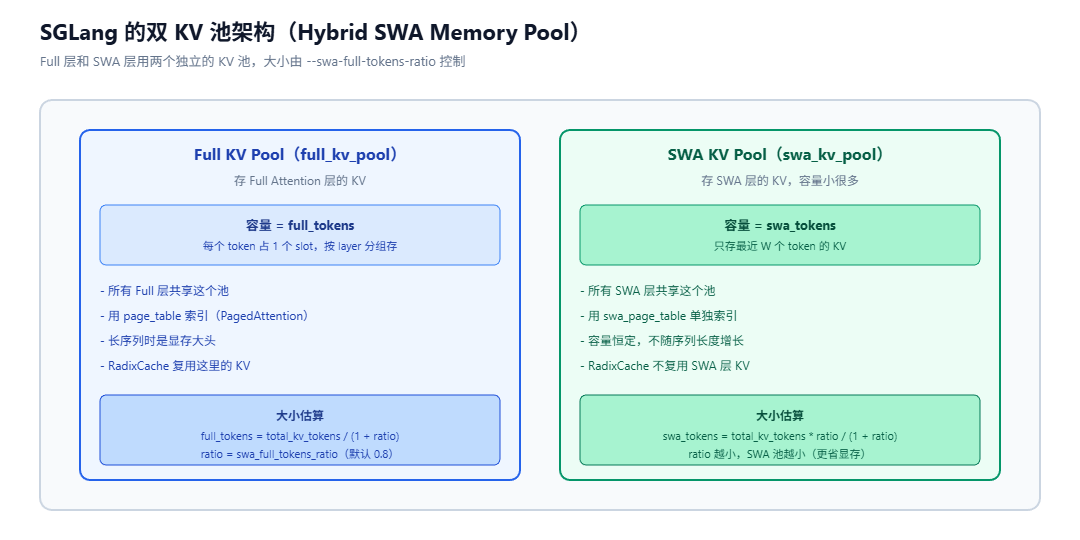
池大小估算(来自HybridSWAPoolConfigurator):
full_tokens = max_total_num_tokens
swa_tokens  = full_tokens * swa_full_tokens_ratio   # 默认 ratio = 0.8
max_total_num_tokens:SGLang 启动时根据剩余显存估算的总 KV token 预算。swa_full_tokens_ratio:SWA 层 KV token 数 / Full 层 KV token 数的比例(CLI--swa-full-tokens-ratio,默认0.8)。ratio越小,SWA 池越小,Full 池越大(更多长上下文容量,但 SWA 层并发能力下降)。
特殊情况:纯 SWA 模型(full_layers == 0)
当模型所有层都是 SWA(没有 Full 层)时,ratio 失去意义,max_total_num_tokens 直接作为 SWA 池大小,每个超出窗口的 token 都可被驱逐回收。
关键代码位置(SGLang):
python/sglang/srt/model_executor/pool_configurator.py:HybridSWAPoolConfigurator、SWAChunkCapPoolConfigurator,负责池大小切分。python/sglang/srt/mem_cache/swa_memory_pool.py:SWAKVPool,双池实现,含swa_kv_pool子池与full -> swa索引映射。python/sglang/srt/mem_cache/base_swa_memory_pool.py:BaseSWAKVPool,SWA 池抽象基类。python/sglang/srt/layers/attention/flashinfer_backend.py/flashattention_backend.py:根据layer.sliding_window_size决定该层走 SWA 还是 Full,并准备swa_page_table、swa_out_cache_loc等元数据。
SWA + Chunked Prefill
长 prompt(如 128K)通常不能一次性 prefill,要切成多个 chunk 顺序处理(--chunked-prefill-size)。SWA 层在 chunk 衔接处有特殊处理。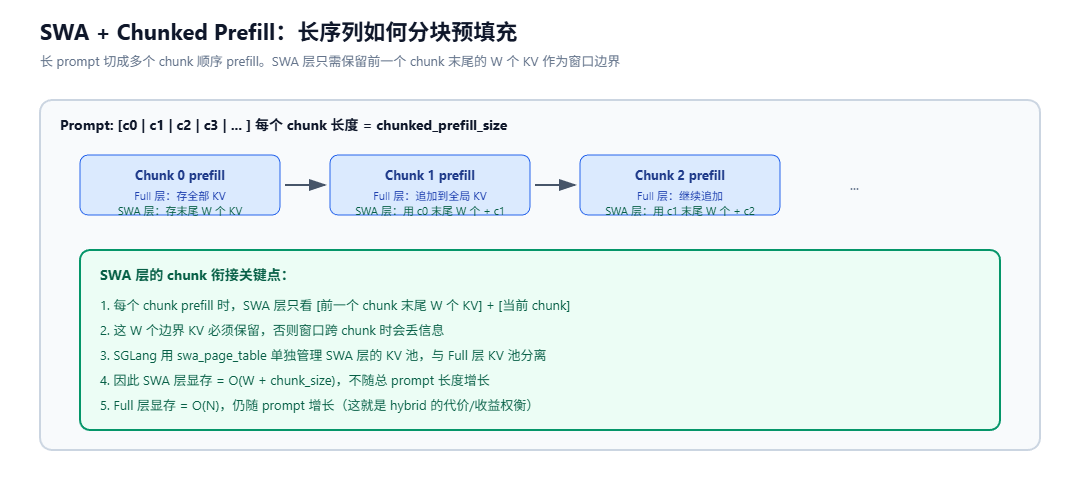
SWA 层 chunk 衔接关键点:
- 每个 chunk prefill 时,SWA 层只看
[前一个 chunk 末尾 W 个 KV] + [当前 chunk]。 - 这 W 个"边界 KV"必须保留,否则窗口跨 chunk 时会丢信息。
- SGLang 用
swa_page_table单独管理 SWA 层的 KV 池,与 Full 层 KV 池分离。 - 因此 SWA 层显存 =
O(W + chunk_size),不随总 prompt 长度增长。 - Full 层显存 =
O(N),仍随 prompt 增长(这就是 hybrid 的代价/收益权衡)。
SGLang 中相关的 prefill 长度估算(python/sglang/srt/utils/common.py):
max_prefill_len = page_size + 2 * max(sliding_window_size, chunked_prefill_size)
这个公式保证 SWA 层在 chunk 边界处有足够 KV 用于窗口衔接。
SGLang 中启用与调参
自动识别
SGLang 启动时会读取模型的 HF config,根据以下字段判断是否为 SWA / Hybrid SWA 模型:
sliding_window/sliding_window_size:窗口大小。swa_layers/swa_attention_layer_ids/full_attention_layer_ids:哪些层是 SWA / Full。sliding_window_pattern:层交替模式。
匹配到 Hybrid SWA 模型时,SGLang 自动启用HybridSWAPoolConfigurator,无需手动配置。
相关 CLI 参数
| 参数 | 作用 | 默认值 |
|---|---|---|
--swa-full-tokens-ratio | SWA 层 KV token 数 / Full 层 KV token 数的比例,范围 (0, 1]。越小 SWA 池越小、Full 池越大 | 0.8 |
--disable-hybrid-swa-memory | 关闭 Hybrid SWA 双池内存管理(不推荐,仅调试用) | False(flag 启用) |
--chunked-prefill-size | chunked prefill 的 chunk 大小,影响 SWA 边界 KV 估算 | 模型相关 |
--hybrid-kvcache-ratio | uniform 与 hybrid kv buffer 之间的混合比,0.0=纯 uniform,1.0=纯 hybrid | None |
调参建议
- SWA 模型长上下文场景:适当调小
--swa-full-tokens-ratio(如 0.5~0.7),给 Full 池更多空间,支持更长上下文;代价是 SWA 层并发下降。 - 追求高 QPS / 大 batch:调大
--swa-full-tokens-ratio(如 0.8~1.0),SWA 池更充裕,能容纳更多并发请求的窗口 KV。 - 纯 SWA 模型:
--swa-full-tokens-ratio不生效,KV 池大小直接由max_total_num_tokens决定。 - 遇到 OOM:先确认是 Full 池还是 SWA 池打满(看启动日志的
full_layer_tokens/swa_layer_tokens),再针对性调参。
启动日志示例
SGLang 启动 Hybrid SWA 模型时会打印:
Use sliding window memory pool. full_layer_tokens=XXXXX, swa_layer_tokens=XXXXX
通过这两个数字可以直观看到双池切分结果,据此判断显存预算是否合理。
适用场景决策图
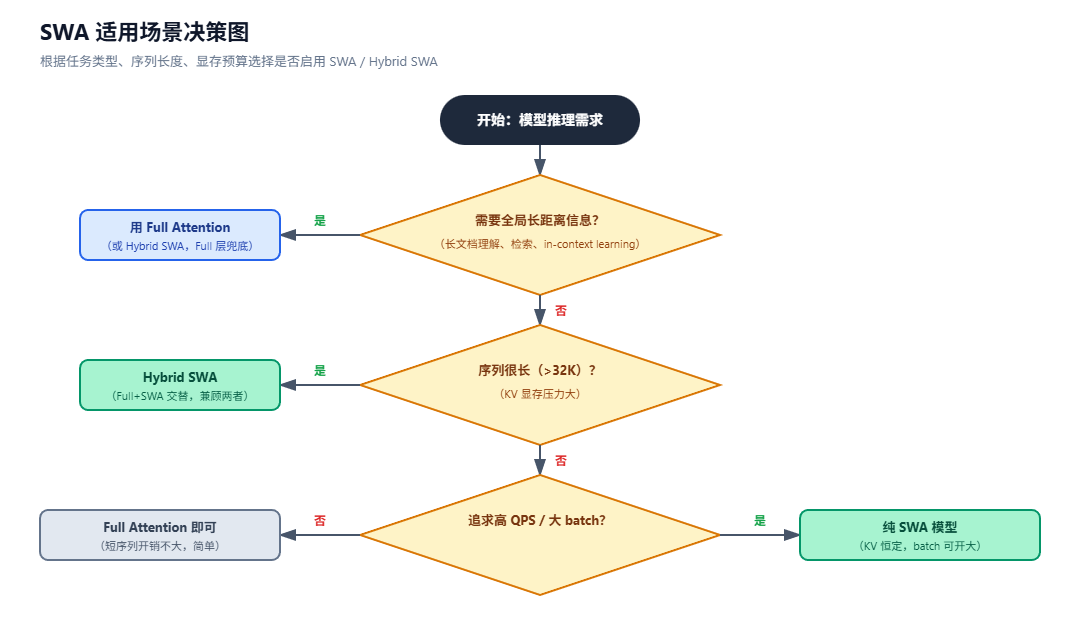
一句话总结:
- 需要全局长距离信息(长文档理解、检索、ICL)-> Full Attention,或 Hybrid SWA(Full 层兜底)。
- 序列很长(>32K)且显存紧张 -> Hybrid SWA,兼顾两者。
- 短序列 / 追求高 QPS / 大 batch -> 纯 SWA 模型,KV 恒定,batch 可开大。
- 短序列且无特殊要求 -> Full Attention 即可,简单。
常见误区与最佳实践
误区 1:SWA 完全等价于"省显存"
SWA 省显存的前提是 窗口外的旧 KV 被丢弃。如果实现上仍保留全部 KV(只是注意力计算时只看窗口内),那显存并没有省,只是计算省了。SGLang 的双池架构确保 SWA 层的旧 KV 真正被回收,显存才省下来。
误区 2:Hybrid SWA 显存恒定
Hybrid SWA 中 Full 层的 KV 仍随序列长度线性增长,只有 SWA 层恒定。所以 Hybrid SWA 的总显存仍随序列增长,只是斜率比纯 Full 小。要完全恒定,得用纯 SWA 模型。
误区 3:SWA 一定更快
SWA 在 长序列 decode 时更快(访存恒定)。但短序列时,全注意力的 flashattention kernel 已经高度优化,SWA 的窗口裁剪反而可能引入额外开销(如边界处理、page table 查询)。是否更快要看序列长度与窗口大小的相对关系。
误区 4:所有层都该用 SWA
纯 SWA 会丢失远距离信息,对需要全局理解的任务(长文档 QA、检索、in-context learning)效果差。Hybrid SWA 通过穿插 Full 层保留全局能力,是更稳妥的选择。
最佳实践
- 优先用 Hybrid SWA 而非纯 SWA,除非明确不需要远距离信息。
- 窗口大小 W 由模型 config 决定,不要随意改;它和模型训练时的配置强相关。
- chunked prefill size 要 >= 窗口大小,否则 SWA 边界衔接开销大。
- 监控双池使用率,根据实际负载调
--swa-full-tokens-ratio。 - RadixCache 只复用 Full 层 KV,SWA 层 KV 不参与 radix 复用(因为窗口外的旧 KV 已被回收)。这意味着 SWA 模型的 prefix cache 命中收益主要来自 Full 层。
小结
| 维度 | Full Attention | 纯 SWA | Hybrid SWA |
|---|---|---|---|
| 每层 KV | N | W | Full 层 N,SWA 层 W |
| 总显存 | L*N*KV_size | L*W*KV_size(恒定) | 介于两者 |
| 长序列 decode | 越来越慢 | 恒定快 | Full 层慢、SWA 层快 |
| 远距离信息 | 完整保留 | 丢失(仅靠层间传递) | Full 层保留 |
| 适合任务 | 长文档理解、检索、ICL | 短上下文、高 QPS | 兼顾两者 |
| SGLang 池 | 单池 | 单 SWA 池 | 双池(full + swa) |
| 核心结论: |
- SWA 通过"只看最近 W 个 token"把 KV Cache 显存与序列长度解耦,是长序列推理省显存的关键技术。
- 纯 SWA 显存恒定但丢远距离信息;Hybrid SWA 用 Full 层兜底,兼顾长上下文能力与显存,是工程主流。
- SGLang 用双 KV 池(
full_kv_pool+swa_kv_pool)实现 Hybrid SWA,通过--swa-full-tokens-ratio控制池切分比例,启动日志可直接看到切分结果。 - SWA 与 Chunked Prefill 衔接时需要保留前一个 chunk 末尾 W 个 KV 作为窗口边界,SGLang 在
swa_page_table中单独管理。 - 是否启用 SWA / 选 Hybrid 还是纯 SWA,取决于任务对远距离信息的需求、序列长度和显存预算。
阅读导航



