
BPE 与 WordPiece:大模型 Tokenizer 编码原理
大模型 BPE 与 WordPiece 编码
1. 为什么要研究 Tokenizer
大模型并不直接读取字符、单词或句子。模型真正接收的是整数形式的 token id,再通过 Embedding 表把这些整数转换成向量。
原始文本
-> Tokenizer
-> token 片段
-> token id
-> Embedding 向量
-> Transformer
因此,BPE 和 WordPiece 是模型输入层的核心组成。Tokenizer 会直接影响:
输入会被切成多少 token
上下文窗口能容纳多少文字
Prefill 需要多少计算
KV Cache 占用多少显存
请求能否命中 Prefix Cache
输入和输出 token 计费
中文、代码、emoji 和罕见字符的表达效率
同一句话如果被切成 20 个 token 或 50 个 token,对推理服务来说并不是小差异:Prefill 计算、KV Cache、排队时间和 token 成本都会随 token 数变化。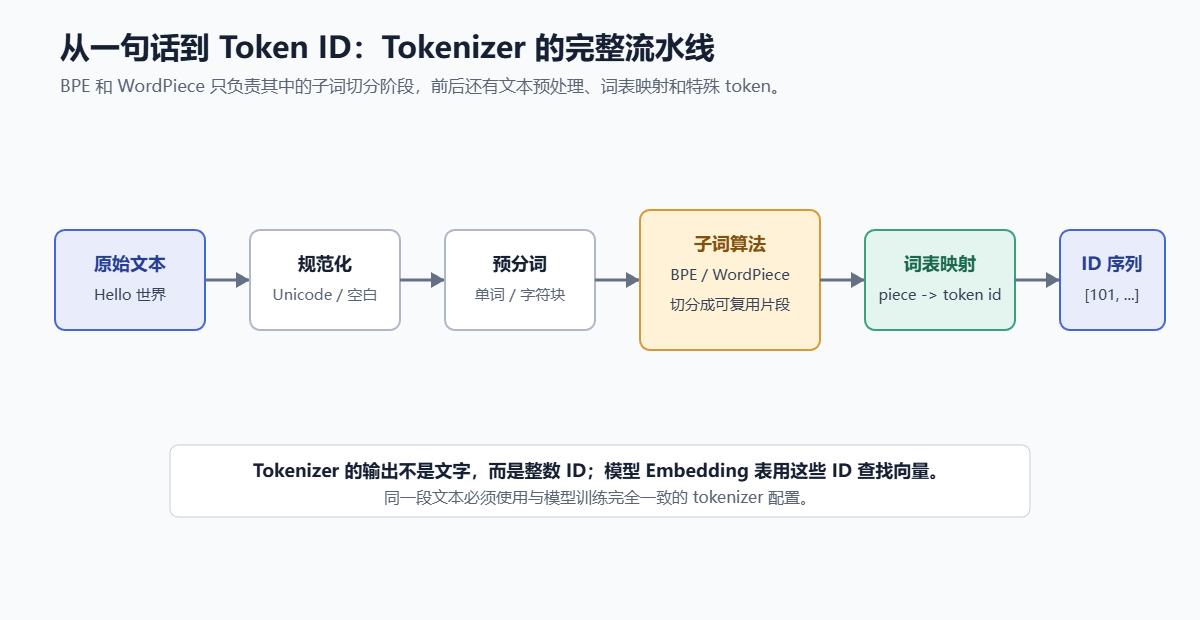
图 1:BPE 和 WordPiece 位于整个 Tokenizer 流水线的中间,但它们的输出会直接决定模型看到的序列长度。
2. Token 是什么
Token 可以理解为模型词表中的一个可复用文本片段。它可能是:
一个完整单词:the
一个词的一部分:ing
一个字符:中
多个字符:tion
一个标点:,
一个空格与单词的组合:Ġthe
一个 byte 片段
特殊控制符:<bos>、<eos>、<pad>
Token 不固定等于“一个字”或“一个单词”。同一个 Tokenizer 可能把不同字符串切成不同数量的 token:
常见英文单词:通常能形成较完整的 token
生僻英文词:可能被切成多个 subword
中文:可能按字、词或 byte 片段切分
代码:标识符、下划线、括号和运算符可能分别成为 token
emoji:可能由多个 Unicode code point 或 byte 片段组成
3. 为什么不直接使用“一个词一个 token”
如果一个词一个 token,词表会遇到两个问题。
3.1 词表会非常大
自然语言中的词形数量非常多:
walk
walks
walked
walking
unwalkable
如果每种形式都单独放入词表,词表规模会快速膨胀。
3.2 新词和拼写变化无法处理
用户会不断产生:
新产品名
人名和地名
代码变量名
网址和文件路径
拼写错误
混合语言文本
如果整个字符串不在词表中,纯词级 Tokenizer 只能使用 [UNK],丢失大量信息。
子词 Tokenizer 的折中方案是:
常见片段保留为一个 token
罕见词拆成多个已知片段
必要时继续退回字符或 byte
这就是 BPE 和 WordPiece 要解决的问题。
4. 子词编码的核心思想
子词模型希望在两个目标之间平衡:
词表不能无限大
序列不能过长
可以把它想象成积木系统:
少量基础积木
-> 组合成常见词片段
-> 组合成更多新词
词表中的片段越大,序列通常越短,但词表和模型 Embedding 参数越大;片段越小,词表越小,但输入 token 数会增加。
Tokenizer 的工程目标不是让每个词都只有一个 token,而是让整个语料分布下的平均 token 数、词表大小和未知字符率处于合理平衡。
5. BPE 是什么
BPE 的全称是 Byte Pair Encoding,最初是压缩领域的一种字节对替换方法,后来被用于子词 Tokenizer。
在大模型语境中,BPE 的基本思想是:
从字符或 byte 级别开始
统计语料中相邻符号 pair 的频率
合并出现频率最高的 pair
把合并结果加入词表
重复执行,直到达到目标词表大小
例如,语料中经常出现:
low
lower
lowest
经过统计后,l 和 o 频繁相邻,于是合并为 lo;之后 lo 和 w 可能继续合并为 low。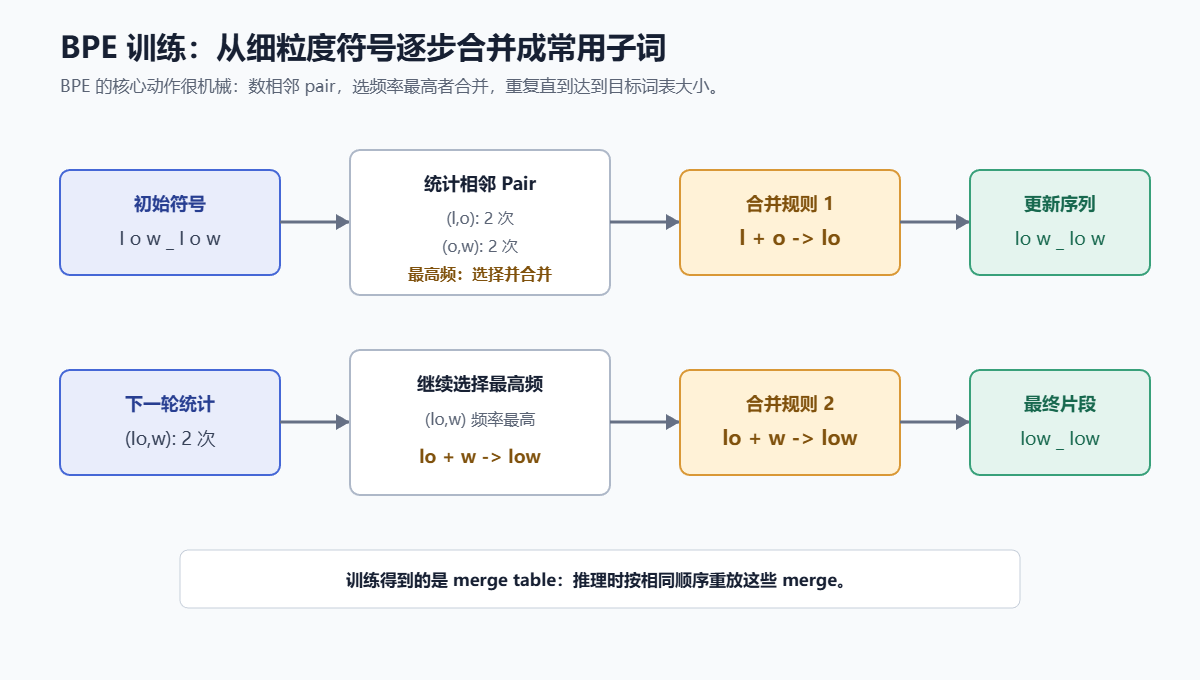
图 2:BPE 训练不断合并最高频相邻 Pair,并把每次合并写入 merge table。
6. BPE 训练过程:逐步展开
第一步:准备训练语料
语料可以包含:
普通文本
网页
书籍
代码
多语言内容
数学符号
特殊标记
Tokenizer 训练语料最好接近模型未来实际使用的分布,否则词表可能偏向错误领域。
第二步:确定初始符号集合
传统字符级 BPE 可以从字符开始:
low -> l o w
Byte-level BPE 则从 UTF-8 byte 开始,初始符号集合通常覆盖 0 到 255 的 byte 值,再通过 merge 学习常见 byte 组合。
第三步:统计相邻 Pair
假设语料经过初始切分后包含:
l o w
l o w e r
l o w e s t
相邻 Pair 可能包括:
(l, o)
(o, w)
(w, e)
(e, r)
(e, s)
(s, t)
对整个语料统计它们的出现次数。
第四步:合并最高频 Pair
假设:
(l, o) 出现 10,000 次
(o, w) 出现 9,000 次
则先执行:
l + o -> lo
词表新增 lo,语料中的对应序列更新为:
lo w
lo w e r
lo w e s t
第五步:重新统计并继续合并
此时 (lo, w) 可能成为最高频 Pair:
lo + w -> low
继续执行:
low e r
low e s t
之后可能学习到:
e + r -> er
low + er -> lower
第六步:直到词表达到目标大小
如果初始词表有 V0 个基础符号,目标词表大小是 V_target,需要进行的合并轮数大致为:
Merge Count ≈ V_target - V0
实际还要减去特殊 token、保留 token 和可能重复的候选片段。
7. BPE 训练伪代码
下面是概念性伪代码:
vocab = initial_symbols(corpus)
merges = []

while len(vocab) < target_vocab_size:
    pair_counts = count_adjacent_pairs(corpus)
    best_pair = argmax(pair_counts)
    new_symbol = merge(best_pair)

    corpus = replace_pair(corpus, best_pair, new_symbol)
    vocab.add(new_symbol)
    merges.append(best_pair)
真实生产实现会使用高效的数据结构、增量更新 Pair 计数、并行统计和特殊 token 处理,否则大语料训练会非常慢。
8. BPE 推理编码过程
BPE 训练完成后,会保存至少两类信息:
vocab:token 片段到 token id 的映射
merges:Pair 的合并顺序或优先级
推理时对新输入:
1. 进行同样的规范化和预分词
2. 转成初始字符或 byte 序列
3. 查找当前序列中可合并的 Pair
4. 按训练时 merge priority 选择规则
5. 合并并更新序列
6. 直到没有可应用的规则
7. 将最终片段映射为 token id
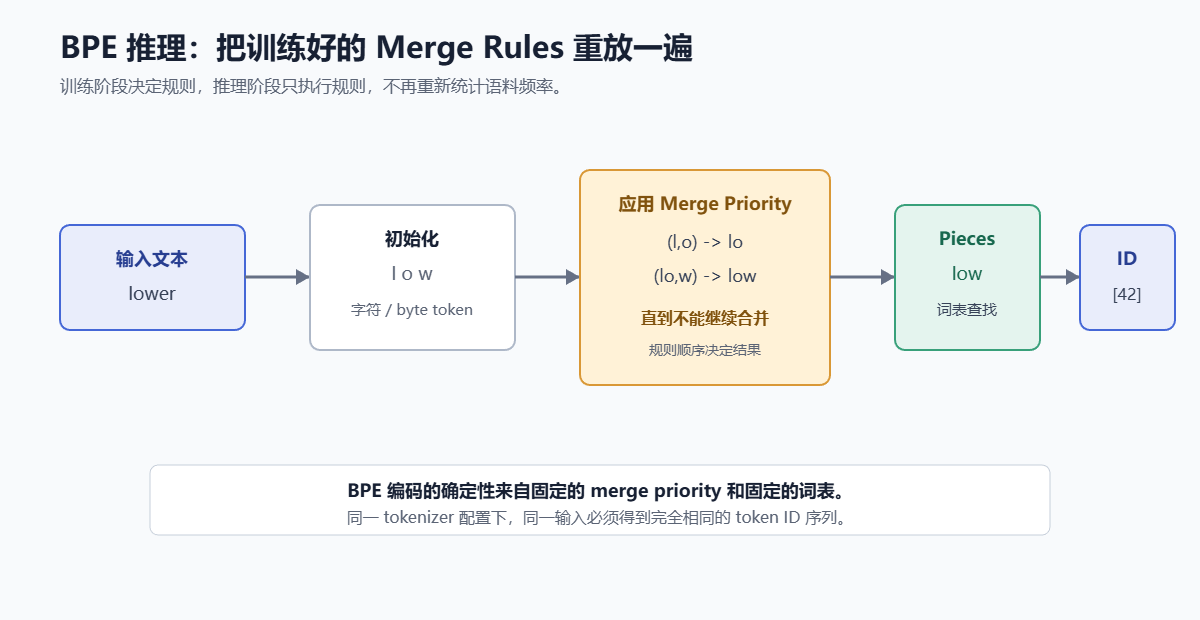
图 3:推理阶段不再统计语料频率,而是按固定的 merge priority 重放训练结果。
9. BPE 的关键细节:合并顺序
BPE 不能只保存“哪些 Pair 合并过”,还必须保存优先级。
例如当前序列为:
a b c
同时存在:
(a,b) -> ab
(b,c) -> bc
如果两条规则都可以应用,先合并哪一条会影响最终结果:
先合并 (a,b):ab c
先合并 (b,c):a bc
因此 BPE 的 merge table 是推理确定性的核心。Tokenizer 版本、词表文件和 merge 文件不一致,可能导致完全不同的 token 序列。
10. BPE 训练与推理的区别
| 阶段 | 输入 | 核心动作 | 输出 |
|---|---|---|---|
| 训练 | 大规模语料 | 统计 Pair、选择合并、更新词表 | vocab + merges |
| 推理 | 一条新文本 | 按固定规则重放合并 | token pieces + ids |
| 训练阶段可能耗费大量 CPU、内存和语料扫描时间;推理阶段要求稳定、低延迟和完全确定性。 |
11. Byte-level BPE
Byte-level BPE 的思路是:先把 Unicode 文本编码为 UTF-8 byte,再在 byte 或 byte 片段上进行 BPE。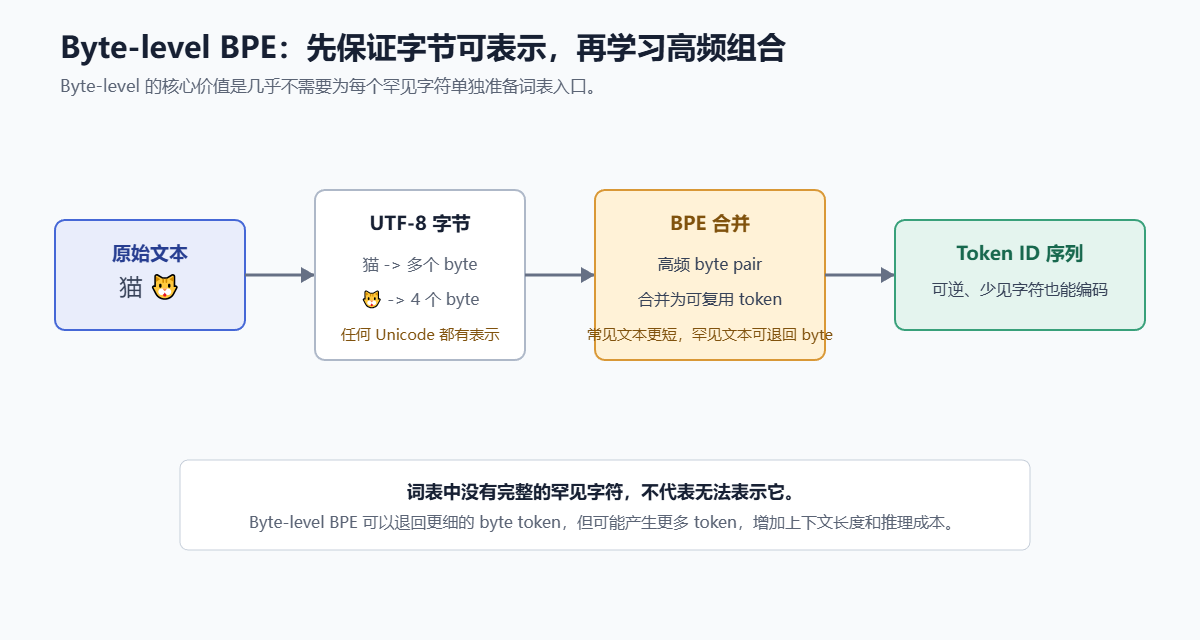
图 4:Byte-level BPE 能覆盖罕见 Unicode,但少见字符可能退回更细 byte 片段,从而产生更多 token。
它的主要优点:
初始基础集合固定
几乎不需要为每个 Unicode 字符单独加入词表
罕见字符通常不会直接变成 [UNK]
对混合语言、代码和任意文本更稳健
它的代价:
一个字符可能对应多个 UTF-8 byte
罕见文本可能被切得很碎
token 数可能增加
中文、emoji 和特殊符号的序列效率依赖词表训练情况
Byte-level BPE 不是“每个 byte 一个 token”。高频 byte 组合仍然会通过 merge 变成更大的 token。
12. WordPiece 是什么
WordPiece 也是一种子词算法,最早广泛用于 BERT 系列模型。它与 BPE 的共同点是:
都使用子词
都希望用有限词表覆盖大量词形
都可以把新词拆成多个片段
关键差异主要在:
训练时如何选择要合并的 Pair
推理时如何从词表中寻找片段
词首与非词首片段如何标记
未知词如何处理
13. WordPiece 训练的打分方式
BPE 常用相邻 Pair 的原始频率作为合并依据;WordPiece 通常使用一种考虑单元频率的打分方式。
一个常见的概念性公式是:
score(x, y)
≈ freq(xy) / (freq(x) × freq(y))
不同实现的具体统计和归一化方式可能不同,但直觉是相同的:不仅看 xy 出现多少次,还看 x、y 各自本来有多常见。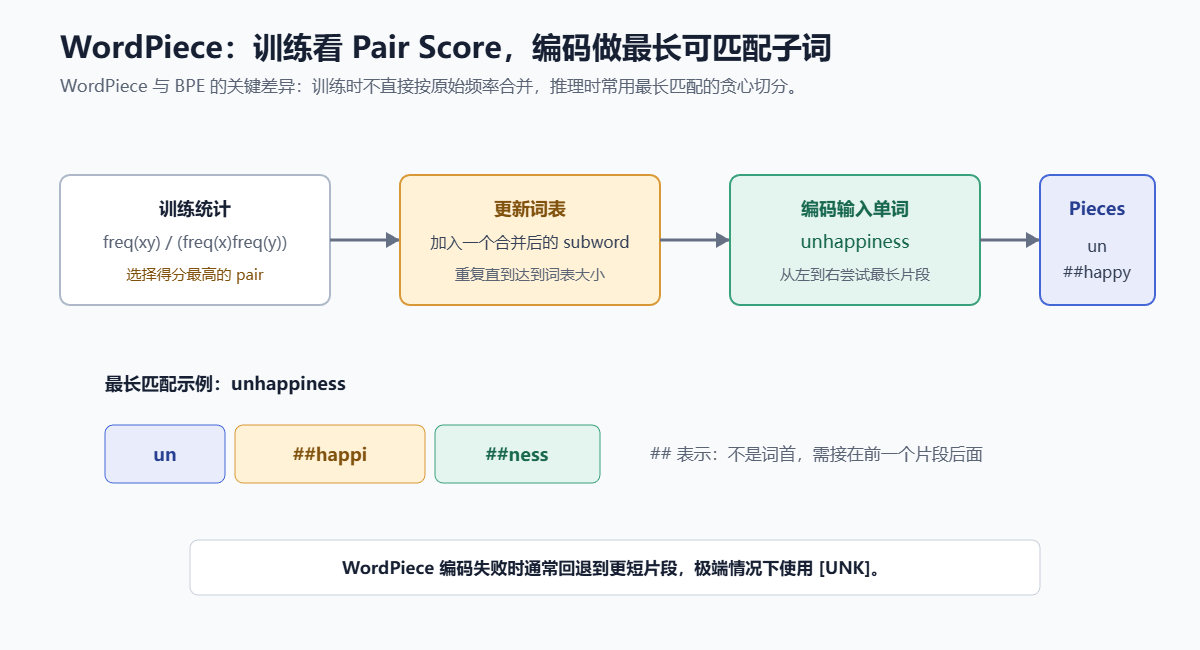
图 5:WordPiece 训练阶段根据 Pair score 更新词表,推理阶段通常从当前位置寻找最长可匹配子词。
14. WordPiece 训练流程
概念上可以分为:
1. 初始化基础词片段
2. 统计词片段与相邻 Pair
3. 计算每个 Pair 的 score
4. 选择 score 最高的 Pair
5. 合并为新的词片段
6. 更新语料表示和统计
7. 重复直到达到词表大小
与 BPE 对比:
BPE:更接近“哪个相邻 Pair 出现得最多”
WordPiece:更接近“哪个 Pair 相对于组成它的单元更有组合价值”
15. WordPiece 推理:最长匹配与贪心切分
WordPiece 编码时,常见做法是从一个词的左侧开始,尝试最长的词表片段。
例如词表包含:
un
##happi
##ness
##happy
对:
unhappiness
一种切分是:
un ##happi ##ness
其中 ## 表示该片段不是词首,应该接在前一个片段后面。
概念性伪代码:
def wordpiece_encode(word, vocab):
    pieces = []
    start = 0

    while start < len(word):
        end = len(word)
        matched = None

        while end > start:
            sub = word[start:end]
            if start > 0:
                sub = "##" + sub

            if sub in vocab:
                matched = sub
                break
            end -= 1

        if matched is None:
            return ["[UNK]"]

        pieces.append(matched)
        start = end

    return pieces
这是一种典型的最长匹配贪心思想,具体实现可能使用 Trie、缓存、Fast Tokenizer 优化和特殊 token 分支。
16. 为什么 WordPiece 使用 `##`
WordPiece 通常需要区分:
词首片段
词中或词尾片段
例如:
playing
可能编码为:
play ##ing
ing 作为词首和作为词尾,其统计意义和拼接位置不同。## 让词表明确记录它是一个非词首片段。
BPE 的实现也可能使用空格标记,例如:
Ġplaying
或其他边界标记,但具体符号取决于 tokenizer 实现。
17. BPE 与 WordPiece 的核心对比
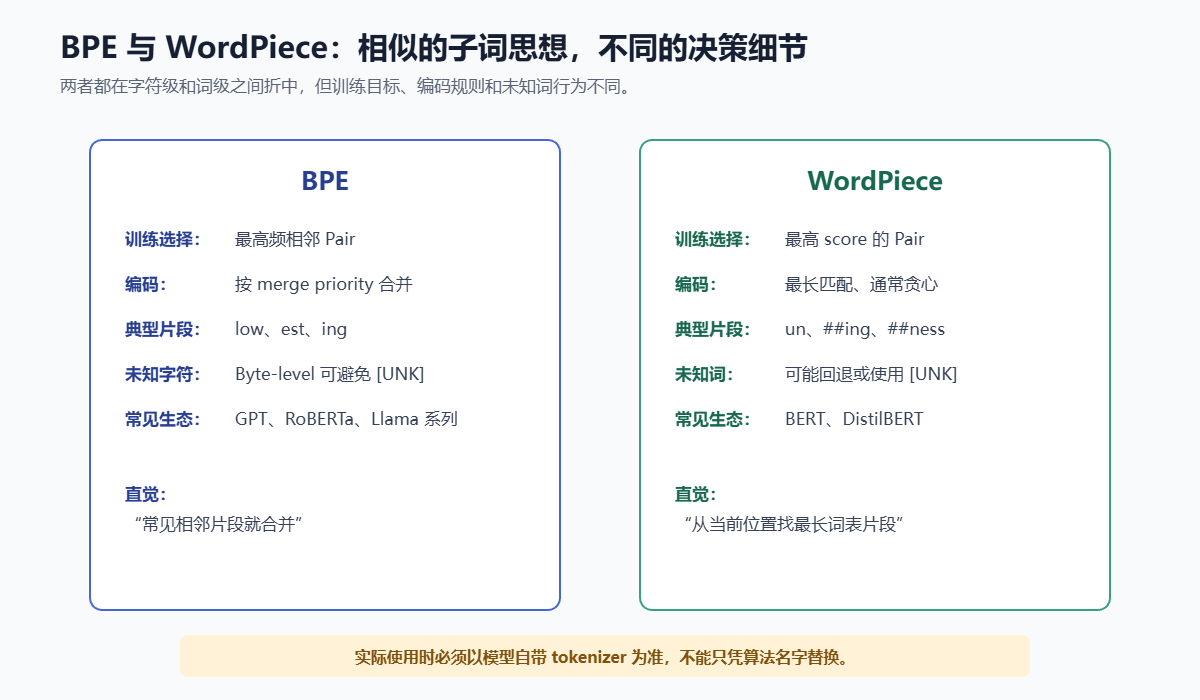
*图 6:两者都采用子词,但 BPE 更强调 merge priority,WordPiece 更常见的是最长词表匹配和 `##` 边界标记。*
| 对比维度 | BPE | WordPiece |
|---|---|---|
| 全称 | Byte Pair Encoding | WordPiece |
| 训练选择 | 常见 Pair 的频率 | Pair score,考虑组成单元频率 |
| 推理策略 | 按 merge priority 重放合并 | 常见为最长匹配贪心 |
| 片段边界 | 依实现而定,可能用空格标记 | 常见 ## 表示非词首 |
| 罕见字符 | Byte-level BPE 可细化到 byte | 传统实现可能回退到 [UNK] |
| 常见模型 | GPT、RoBERTa、Llama 等路线 | BERT、DistilBERT 等路线 |
| 重要文件 | vocab、merges、tokenizer config | vocab、tokenizer config、special tokens |
| 不能仅凭算法名称替换 tokenizer。即使两个模型都叫 BPE,预分词规则、Unicode 处理、空格标记、特殊 token、词表和 merge priority 不同,也会产生不同结果。 |
18. 中文、代码和 Unicode 如何处理
18.1 中文
中文没有天然的空格分词边界,因此行为高度依赖训练语料和词表。
常见情况:
一个汉字一个 token
多个常见汉字组成一个 token
罕见字退回多个 byte token
中文标点单独成为 token
中英文和数字按照不同片段组合
例如:
大模型推理优化
可能变成:
大模型 / 推理 / 优化
也可能变成:
大 / 模 / 型 / 推 / 理 / 优 / 化
不能通过肉眼准确判断 token 数,必须调用目标模型对应的 tokenizer。
18.2 代码
代码通常包含大量标识符、驼峰命名、下划线、括号、点号、操作符、缩进和换行。
get_user_profile(user_id)
可能被切成:
get / _ / user / _ / profile / ( / user / _ / id / )
也可能某些常见标识符片段已经存在于词表中,切分会更紧凑。
18.3 Unicode、emoji 和罕见字符
用户看到的一个“字符”不一定对应一个 Unicode code point,也不一定对应一个 UTF-8 byte。可能存在组合字符、变体选择符、emoji sequence、零宽连接符和不同 Unicode 规范化形式。
Tokenizer 通常要明确:
是否做 Unicode normalization
是否按 code point 处理
是否按 UTF-8 byte 处理
是否支持 byte fallback
Byte-level BPE 覆盖能力更稳健,但罕见字符可能产生更多 token,导致输入长度膨胀。
19. 特殊 Token
Tokenizer 通常还需要处理特殊 token:
[CLS]、[SEP]、[PAD]、[UNK]
<bos>、<eos>
<|user|>、<|assistant|>
特殊 token 不是普通文本片段,通常不会参与普通 BPE merge 或 WordPiece 匹配。
如果配置错误,可能出现:
模型无法正确识别对话角色
停止 token 不生效
Batch Padding 行为异常
Prompt Cache 前缀不一致
模型输出格式异常
20. Tokenizer 与大模型推理的关系
输入 token 数设为 N,线性层 Prefill FLOPs 粗略为:
F_prefill ≈ 2 × P × N
KV Cache 线性随 token 数增长:
KV Cache
= token 数
× Layer 数
× 2
× KV Head 数
× Head Dim
× dtype bytes
长上下文 Attention 的主要项近似与 N² 相关:
F_attention ∝ N²
如果 tokenizer 让 token 数增加 20%,线性 Prefill 主项约增加 20%,Attention 理论主项可能增加:
1.2² = 1.44
即约 44%。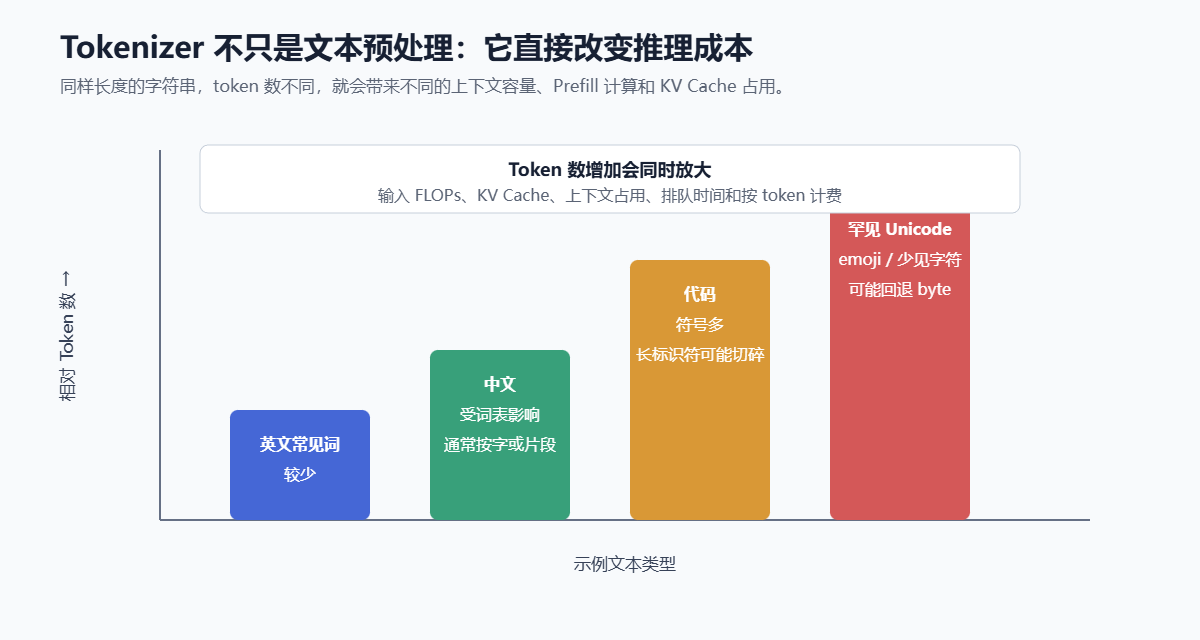
图 7:Tokenizer 的切分效率会直接传导到上下文长度、Prefill、KV Cache、排队和成本。
21. Tokenizer 与 Prefix Cache
Prefix Cache 复用的是已经计算好的 token 前缀及其 KV Cache,因此要求:
文本字节相同
Tokenizer 配置相同
规范化结果相同
特殊 token 序列相同
前缀 token ID 完全相同
即使人眼看起来文本一样,普通空格与不换行空格、不同 Unicode normalization、换行符差异、动态时间、角色标记和模板版本变化,都可能影响 token 序列。
22. Tokenizer 词表大小如何影响系统
词表更大:
常见片段更容易成为单 token
平均 token 数可能下降
Embedding 和 LM Head 参数增大
Tokenizer 内存和查表规模增大
词表更小:
模型词表参数减少
罕见词更容易被切碎
平均输入 token 数可能增加
上下文和推理成本增加
如果训练语料主要是英文,中文和代码可能被切得很碎;如果主要是自然语言,代码标识符和符号的切分效率可能较差。
23. Tokenizer 评测指标
建议至少观察:
平均 token 数
P95 / P99 token 数
每字节 token 数
每词 token 数
中文 token 效率
英文 token 效率
代码 token 效率
emoji / Unicode 回退率
[UNK] 比例
特殊 token 识别准确率
可以定义一个简单的压缩效率:
Tokens per Byte
= token 数 / UTF-8 字节数
该值越低,通常代表序列更紧凑,但不能脱离质量和词表成本单独优化。
24. 如何验证模型使用的 Tokenizer
部署前应从模型目录或官方配置读取:
tokenizer.json
tokenizer_config.json
vocab.json
merges.txt
vocab.txt
special_tokens_map.json
重点检查:
Tokenizer 类型
词表大小
是否 Byte-level
是否使用 WordPiece ## 标记
是否有 byte fallback
bos / eos / pad / unk token
chat template
最大长度配置
不能因为模型名称相似,就直接复用另一个模型的 tokenizer。
25. 一个完整的工程计算示例
假设同一段业务文本在两个 tokenizer 下的结果不同:
Tokenizer A:输入 4,000 token
Tokenizer B:输入 5,000 token
线性 Prefill 主项比例:
F_B / F_A
≈ 5,000 / 4,000
≈ 1.25
Tokenizer B 的线性 Prefill 主项约高 25%。
Attention 主项比例:
F_attention_B / F_attention_A
≈ (5,000 / 4,000)²
≈ 1.5625
长上下文 Attention 理论主项约高 56.25%。
KV Cache 比例:
KV_B / KV_A
≈ 5,000 / 4,000
≈ 1.25
Tokenizer 的 25% token 膨胀,可能同时造成:
Prefill FLOPs +25%
KV Cache +25%
Attention 理论主项 +56.25%
26. 常见实现错误
错误一:把字符数当成 token 数
字符数、Unicode code point 数、UTF-8 byte 数和 token 数不是同一个概念。
错误二:只按空格切英文
子词 tokenizer 会进一步处理词内部片段、标点和空格边界。
错误三:把 BPE 和 WordPiece 词表混用
即使片段看起来相似,merge 规则、边界标记和 ID 映射也可能完全不同。
错误四:忽略特殊 token
手动拼接 Prompt 时如果漏掉角色标记、EOS 或模板,模型行为可能异常。
错误五:只测试平均样本
长代码、中文文档、emoji、URL 和罕见字符往往决定 P99 token 长度。
27. 一页式理解框架
BPE
训练:统计最高频相邻 Pair 并合并
推理:按 merge priority 重放合并
优势:实现简单、Byte-level 路线覆盖广
风险:罕见文本可能产生很多 byte token
WordPiece
训练:根据 Pair score 选择组合
推理:通常从当前位置寻找最长词表片段
标记:常见 ## 表示非词首片段
风险:传统实现可能使用 [UNK] 处理无法覆盖的词
工程侧
token 数
-> Prefill 计算
-> Attention 长度平方项
-> KV Cache
-> 排队与成本
28. 最终总结
BPE 和 WordPiece 都是在词表大小和序列长度之间寻找平衡的子词编码方法。
BPE 的核心是:
统计相邻 Pair 频率
逐轮合并高频 Pair
推理时重放固定 merge priority
WordPiece 的核心是:
通过 Pair score 选择更有组合价值的片段
推理时从当前位置寻找最长可匹配子词
常见使用 ## 标记非词首片段
在大模型推理中,Tokenizer 不是无关紧要的前处理模块:
Tokenizer 决定 token 数
token 数决定 Prefill 和 KV Cache
长上下文 token 数还会放大 Attention 的平方项
实际部署时最重要的原则是:
始终使用与模型训练严格匹配的 tokenizer。
评估 tokenizer 时,应使用真实的中文、英文、代码、RAG 文档、URL、emoji 和长尾输入,观察平均值与 P99,而不是只用几句简单英文做测试。
阅读导航



