
GQA 与 MQA 原理:注意力结构如何影响 KV Cache
GQA、MQA 为什么对大模型推理很重要
GQA(Grouped Query Attention)和 MQA(Multi-Query Attention)是大模型推理中非常重要的 Attention 架构设计。它们最直接的价值不是让模型参数量变小,而是减少 KV Cache、降低 Decode 阶段的显存带宽压力,并提高长上下文和高并发时的可服务能力。
如果只记住一句话,可以记为:
🎉
MHA:每个 Query Head 都有自己的 K/V,质量表达能力最充分,但 KV Cache 最大。
GQA:多个 Query Head 共享一组 K/V,在质量和推理效率之间折中。
MQA:所有 Query Head 共享同一组 K/V,KV Cache 最小,但共享最强、质量风险相对更高。
先看一张总览图。可以把 Query Heads 想象成多个提问者,把 KV Heads 想象成可供查询的资料视角:MHA 给每个提问者一套独立资料;GQA 让一组提问者共享一套资料;MQA 则让所有提问者共用同一套资料。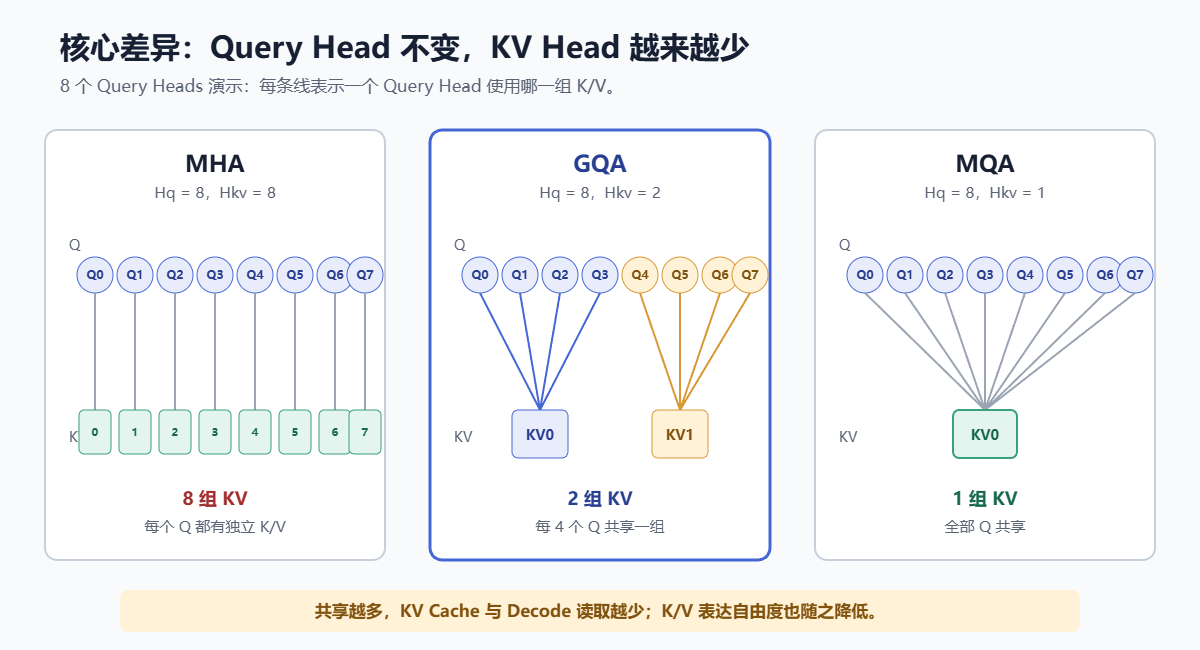
图 1:从 MHA 到 GQA 再到 MQA,Query Head 数保持不变,KV Head 数逐步减少。连线表示 Query Head 使用哪一组 K/V。
本文从 Attention 的基本张量、显存公式、Decode 带宽、质量权衡到部署选择,完整说明为什么它们会直接影响推理服务设计。
1. 为什么 Attention 会成为推理问题
Decoder-only 大模型以自回归方式生成文本:每次生成一个 token,并将它追加到已有上下文后面。
已有上下文:t1, t2, t3, ..., tS
下一步:生成 t(S+1)
再下一步:生成 t(S+2)
在每一层 Attention 中,当前 token 需要对历史 token 做注意力计算。若每一步都重新计算历史 token 的 Key(K)和 Value(V),生成越往后,重复计算越多,推理成本会迅速失控。
因此推理系统会把历史 token 的 K 和 V 缓存起来:
历史 token
-> 计算并缓存其 K 和 V
-> 下一个 token 直接读取历史 K/V
-> 不再重复计算历史 token 的 K/V
这块缓存就是 KV Cache。
在 Decode 阶段,模型每生成一个 token,都需要:
1. 读取模型权重,计算当前 token 的 Q、K、V
2. 将当前 token 的 K、V 写入 KV Cache
3. 读取历史 KV Cache
4. 用当前 Q 对历史 K 做 Attention Score
5. 用 Attention Score 对历史 V 加权求和
6. 经过后续网络,得到下一个 token 的概率
因此,KV Cache 的大小和读取量会随着上下文长度、并发和模型结构增长。MHA、GQA、MQA 的关键差别,正是它们需要存多少 K/V。
2. 先理解 Q、K、V 和 Head
给定一层 Transformer 的隐藏状态 X,Attention 会通过三组投影矩阵生成:
Q = X × Wq
K = X × Wk
V = X × Wv
其中:
Q,Query:当前 token 想从历史信息中查询什么。K,Key:每个历史 token 提供什么索引信息。V,Value:每个历史 token 实际携带的内容信息。
单头 Attention 可以写为:
Attention(Q, K, V) = Softmax(Q × K^T / sqrt(d_head)) × V
但一个大模型不会只使用一个 Attention Head,而是会将隐藏维度拆成多个 Head。假设:
隐藏维度 d_model = 4096
Query Head 数 Hq = 32
每个 Head 的维度 d_head = 128

4096 = 32 × 128
多个 Head 可以关注不同模式,例如:
一个 Head 关注代词指代
一个 Head 关注代码括号匹配
一个 Head 关注前文实体
一个 Head 关注局部语法关系
MHA、GQA、MQA 并不会改变 Query Head 的数量含义。它们主要改变的是:有多少组 Key/Value Head 被保存,以及每个 Query Head 使用哪一组 K/V。
3. MHA:传统多头注意力
MHA 是 Multi-Head Attention,即传统多头注意力。
在 MHA 中:
Query Head 数 Hq = KV Head 数 Hkv
若有 32 个 Query Head,就有 32 个 Key Head 和 32 个 Value Head:
Q0 使用 K0、V0
Q1 使用 K1、V1
Q2 使用 K2、V2
...
Q31 使用 K31、V31
它的优点是表达能力最充分:每个 Query Head 都有独立的 K/V 表示空间。
它的代价是:每一层都要缓存所有 Head 的 K 和 V。因此 KV Cache 会非常大。
对于一个 token、一个 Transformer 层,MHA 的 KV Cache 大小为:
KV Bytes / token / layer
= 2
× Hq
× d_head
× bytes_per_element
其中 2 表示 K 和 V 两份缓存。
4. MQA:所有 Query Head 共享一组 K/V
MQA 是 Multi-Query Attention。
在 MQA 中:
Query Head 数 Hq:保持不变
KV Head 数 Hkv:固定为 1
假设有 32 个 Query Head:
Q0 使用 K0、V0
Q1 使用 K0、V0
Q2 使用 K0、V0
...
Q31 使用 K0、V0
所有 Query Head 共享同一组 K/V。
这使 KV Cache 从原来的 32 组下降为 1 组。若其他条件相同,MQA 的 KV Cache 是 MHA 的:
Hkv / Hq = 1 / 32
也就是说,显存理论上仅为 MHA 的 1/32。
但代价也很直观:不同 Query Head 都需要从同一份 K/V 表示中获取信息。模型在 Attention 中的表达自由度下降,质量可能受到影响,尤其是在需要复杂多头关系、长上下文定位或高难度推理的任务上。
5. GQA:在 MHA 和 MQA 之间取得折中
GQA 是 Grouped Query Attention。
它的规则是:多个 Query Head 共享一组 K/V,但不是所有 Query Head 都共享同一组。
假设:
Query Head 数 Hq = 32
KV Head 数 Hkv = 8
那么每 4 个 Query Head 共享一组 K/V:
Q0、Q1、Q2、Q3     使用 K0、V0
Q4、Q5、Q6、Q7     使用 K1、V1
Q8、Q9、Q10、Q11   使用 K2、V2
...
Q28、Q29、Q30、Q31 使用 K7、V7
分组大小为:
Group Size = Hq / Hkv
           = 32 / 8
           = 4
因此,GQA 保留了 8 组独立的 K/V,而不是 MQA 的 1 组,也不需要 MHA 的 32 组。
可以把三者排成一条连续的光谱:
MHA                    GQA                       MQA
Hkv = Hq               1 < Hkv < Hq              Hkv = 1
质量表达最充分          质量与效率折中              KV 最小
KV Cache 最大           KV Cache 中等               KV Cache 最小
GQA 之所以在现代 LLM 中非常常见,是因为它通常能用显著更低的推理成本,保留接近 MHA 的模型质量。
图 1 里的 GQA 使用 8 个 Query Heads 和 2 个 KV Heads,因此每 4 个 Query Heads 形成一组。真实模型中的 Hq/Hkv 就是每组共享者的数量。例如 Hq=64、Hkv=8,表示每 8 个 Query Heads 共享一组 K/V。
6. 用一组具体数字比较三者的 KV Cache
假设一个模型有如下配置:
Layer 数 L = 80
Query Head 数 Hq = 64
Head Dim d_head = 128
KV 精度 = BF16 = 2 Bytes
比较三种架构:
MHA:Hkv = 64
GQA:Hkv = 8
MQA:Hkv = 1
完整 KV Cache 公式:
KV Cache Bytes / token
= L
× 2
× Hkv
× d_head
× bytes_per_element
6.1 MHA 的单 token KV Cache
80 × 2 × 64 × 128 × 2
= 2,621,440 Bytes
≈ 2.5 MiB / token
6.2 GQA 的单 token KV Cache
80 × 2 × 8 × 128 × 2
= 327,680 Bytes
≈ 320 KiB / token
与 MHA 比:
320 KiB / 2.5 MiB = 1 / 8
6.3 MQA 的单 token KV Cache
80 × 2 × 1 × 128 × 2
= 40,960 Bytes
≈ 40 KiB / token
与 MHA 比:
40 KiB / 2.5 MiB = 1 / 64
汇总如下:
| 架构 | Hq | Hkv | 每 token KV Cache | 相对 MHA |
|---|---|---|---|---|
| MHA | 64 | 64 | 2.5 MiB | 1x |
| GQA | 64 | 8 | 320 KiB | 1/8 |
| MQA | 64 | 1 | 40 KiB | 1/64 |
| 注意:这里的每 token 是指一个请求在全部 80 层上新增一个位置所需要的 K 和 V;不是仅指某一层。 | ||||
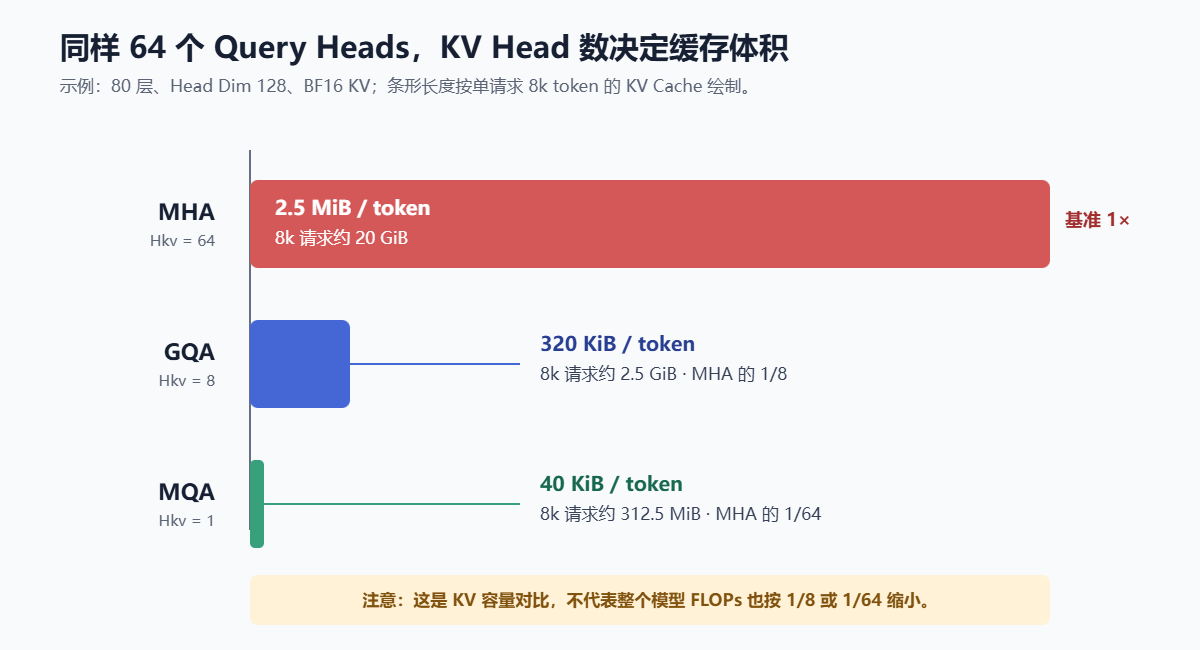 | ||||
| 图 2:在相同层数、Head Dim 和 KV 精度下,KV Cache 与 Hkv 成正比。GQA/MQA 最直观的收益就是让代表缓存容量的条形大幅缩短。 |
7. 对长上下文和并发意味着什么
继续使用上面的模型配置。假设一个请求最终占用:
上下文 + 输出 = 8,000 token
单请求的 KV Cache:
| 架构 | 单 token KV | 8k token 单请求 KV |
|---|---|---|
| MHA | 2.5 MiB | 20 GiB |
| GQA | 320 KiB | 2.5 GiB |
| MQA | 40 KiB | 312.5 MiB |
若整个实例可留给 KV Cache 的空间为 50 GiB,只从 KV 容量角度估算最大并发: | ||
| 架构 | 每请求 KV | 理论最大并发 |
| - | - | - |
| MHA | 20 GiB | 2 个请求 |
| GQA | 2.5 GiB | 20 个请求 |
| MQA | 312.5 MiB | 约 163 个请求 |
真实部署还要考虑显存碎片、Prefix Cache、请求长度分布、运行时 Buffer 和安全余量,因此不能直接把理论值作为 max_num_seqs。但这个例子非常直观地说明: |
Hkv 的数量,直接决定了长上下文和高并发是否具备工程可行性。
8. 为什么 GQA/MQA 对 Decode 尤其重要
Prefill 和 Decode 的硬件特征不同。
8.1 Prefill
Prefill 一次处理很多输入 token,GPU 可以做较大的矩阵运算,通常更偏向计算密集型。
GQA/MQA 当然会减少 Prefill 时生成和写入 KV 的量,但其最显著收益不一定体现在 Prefill 的总时长上。
8.2 Decode
Decode 每次只生成一个 token。此时每个活跃请求都要读取历史 KV Cache;上下文越长,读取量越大。
对单个请求、单层、当前上下文长度为 S 的 Decode,KV 的原始存储读取量近似为:
KV Read Bytes / layer
≈ 2 × S × Hkv × d_head × bytes_per_element
完整模型乘以层数:
KV Read Bytes / generated token
≈ L × 2 × S × Hkv × d_head × bytes_per_element
所以在相同上下文长度 S 下:
GQA 的 KV Cache 读取量约为 MHA 的 Hkv_GQA / Hq
MQA 的 KV Cache 读取量约为 MHA 的 1 / Hq
这会降低 HBM 带宽压力。长上下文、高并发 Decode 时,这种节省尤其重要。
下面这张图把一次 Decode 的数据流展开:当前 token 仍然会生成完整的 Query Heads;GQA 减少的是 K/V 投影输出、写入 KV Cache 的数据,以及后续从 HBM 读取的历史 K/V 数据。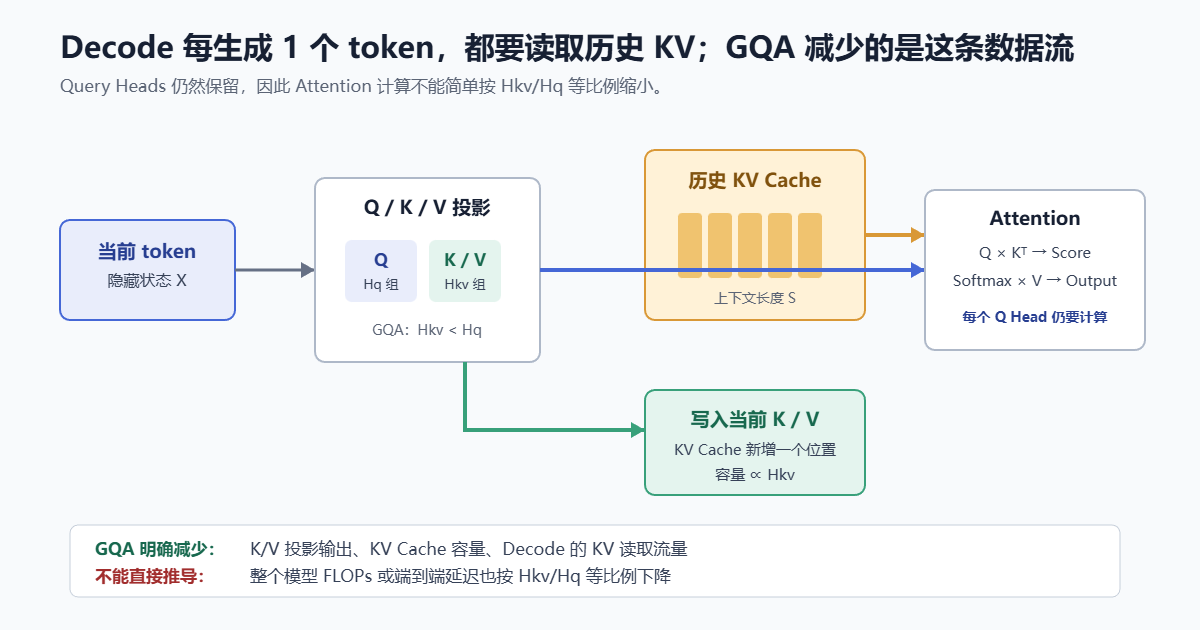
图 3:绿色路径是 GQA 明确缩小的 K/V 数据流;蓝色 Query 路径仍然保留,因此不能把整个模型计算量直接除以分组比例。
9. 一个需要澄清的点:GQA 不等于 Attention FLOPs 按比例减少
这是非常容易混淆的地方。
在 GQA 和 MQA 中,Query Head 数 Hq 通常保持不变。每个 Query Head 仍然要计算自己对历史 token 的注意力分数,并得到自己的 Attention 输出。
因此,从数学上的 Attention 计算量看,主要项仍与 Hq 相关:
QK^T 和 Attention × V 的计算
仍然需要对每个 Query Head 执行
也就是说:
GQA/MQA 最确定的收益:KV Cache 容量和 KV 访存减少。
GQA/MQA 不应简单理解为 Attention FLOPs 也按 Hkv/Hq 等比例减少。
在真实实现中,K/V 共享可以带来更好的数据复用、更少的 K/V 投影输出和更低的内存流量,因此整体性能常会提升;但提升幅度取决于模型、上下文长度、batch、Kernel 和硬件,不应仅用 Hkv 的比例推导。
图 3 可以用来快速区分“容量收益”和“计算收益”:KV Cache 容量及其原始读取量近似按 Hkv 缩小;但每个 Query Head 仍要产生自己的 Attention Score 和输出,所以 Attention FLOPs 与端到端延迟不会按相同比例缩小。
10. 对 Q、K、V 投影参数量有什么影响
🌅
Hq:Query Head 数量
Hkv:Key/Value Head 数量
假设隐藏维度:
d_model = Hq × d_head
传统 MHA 的投影输出维度通常是:
Q 投影:Hq × d_head
K 投影:Hq × d_head
V 投影:Hq × d_head
GQA 中:
Q 投影:Hq × d_head
K 投影:Hkv × d_head
V 投影:Hkv × d_head
MQA 则是:
Q 投影:Hq × d_head
K 投影:1 × d_head
V 投影:1 × d_head
因此,GQA/MQA 还会减少 K/V 投影矩阵的参数量和计算量。但在大型 Decoder 模型中,MLP 和 Q/O 投影通常仍占据大量参数与计算,因此不能把整个模型参数量按同样比例缩小。
GQA 的主要工程价值仍是:
更少的 KV Cache
+ 更少的 Decode KV 读取
+ 更高的有效并发
+ 更低的长上下文服务成本
11. GQA 的质量为什么通常比 MQA 更稳
从表达能力角度看:
MHA:每个 Q Head 有独立的 K/V 表示。
GQA:每组 Q Head 共享一组 K/V 表示。
MQA:所有 Q Head 共享同一组 K/V 表示。
🎉
当 K/V 被共享时,不同 Query Head 能区分的历史表示会减少。MQA 的共享最强,信息瓶颈也最明显。
GQA 保留多个 KV Group,让不同类别的 Query Head 可以使用不同的 K/V 子空间。因此它通常比 MQA 更接近 MHA 的能力,同时保留绝大部分推理侧收益。
但质量差异不是由架构名字单独决定的。还受到以下因素影响:
模型预训练方式
训练 token 数与数据质量
模型规模
Hq/Hkv 的分组比例
是否从 MHA 模型转换或继续训练
是否使用长上下文扩展训练
实际任务类型
工程上不能仅凭“GQA 一般很好”就假设质量无损。应使用真实业务评测集比较。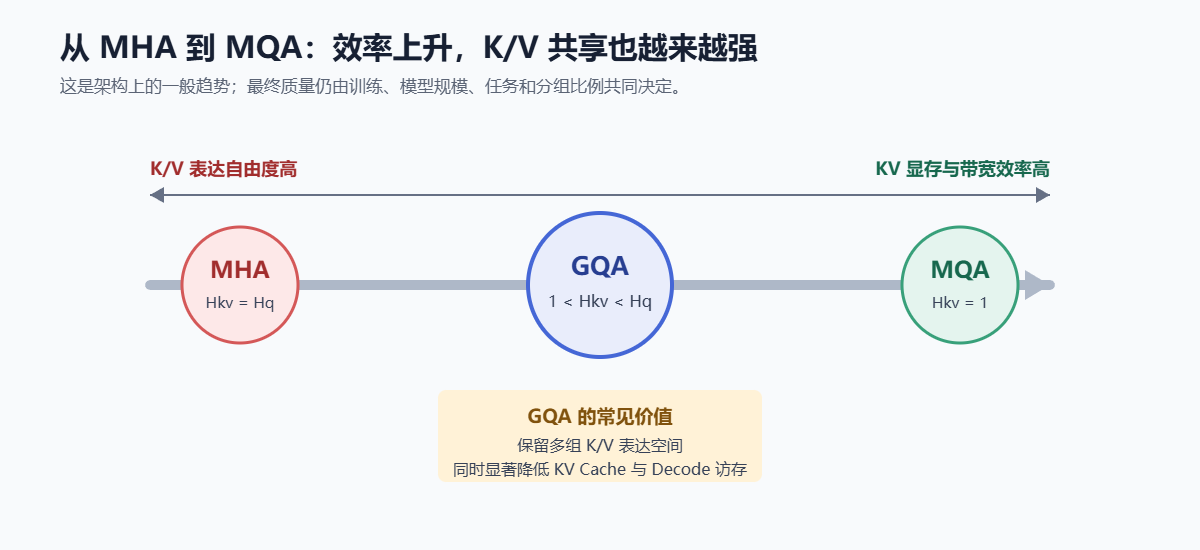
图 4:GQA 位于 MHA 和 MQA 之间。它保留多组 K/V 表达空间,同时获得大部分 KV 显存和带宽收益,因此经常成为现代推理模型的折中选择。
这张图表达的是架构趋势,不是固定质量排名。一个训练充分的 MQA 模型可能优于另一个训练不足的 MHA 模型;实际选型仍应以同一业务评测集、同一 SLO 和同一硬件条件下的结果为准。
12. 从已有 MHA 模型转换为 GQA:为什么需要继续训练
若一个模型原本是 MHA,想直接将 KV Heads 从 Hq 压缩到更少的 Hkv,不能只是在推理时丢弃部分 K/V Head。那会破坏模型已学习到的 Attention 表示。
常见思路是:
MHA 检查点
-> 将若干 K/V Head 做平均或合并初始化为一个 Group
-> 得到 GQA 结构
-> 进行继续预训练或微调
-> 恢复质量
这个过程常被称为从 Multi-Head Attention 向 Grouped Query Attention 的转换。需要继续训练的原因是:模型必须适应“多个 Query Head 共享 K/V”的新信息通路。
对 Infra 工程师而言,关键结论是:GQA 是模型架构和权重的一部分,不是可以随意在 Serving 配置里打开的通用开关。部署端只能使用模型本身定义的 num_key_value_heads。
13. 如何从模型配置判断它使用了哪种架构
在 Hugging Face 风格的模型配置中,通常可见:
{
  "num_attention_heads": 64,
  "num_key_value_heads": 8,
  "head_dim": 128,
  "num_hidden_layers": 80
}
判断方法:
num_key_value_heads == num_attention_heads
=> MHA

num_key_value_heads == 1
=> MQA

1 < num_key_value_heads < num_attention_heads
=> GQA
该配置示例中:
Hq = 64
Hkv = 8
64 / 8 = 8
说明每 8 个 Query Heads 共享一组 K/V,是 GQA。
14. 实际部署时如何计算 KV Cache
拿到模型配置后,使用下面的公式:
KV Bytes / token
= num_hidden_layers
× 2
× num_key_value_heads
× head_dim
× kv_dtype_bytes
再计算单请求容量:
KV Bytes / request
= KV Bytes / token
× (输入 token 数 + 已生成 token 数)
若要估算一组请求的 KV 占用:
KV Bytes / all requests
= Σ[每个请求的上下文长度]
× KV Bytes / token
当使用 Tensor Parallel(TP)时,KV Head 往往在各 GPU 上分片。理想情况下,单卡 KV 占用可以近似为:
单卡 KV Bytes / token
≈ 全模型 KV Bytes / token / TP size
但实际应以所用框架的模型切分方式和显存观测为准。某些配置下 Head 数不能被 TP size 整除,或者框架会有额外复制和 Buffer。
15. 示例:为什么两个同为 70B 的模型并发能力会不同
假设模型 A 和模型 B 都是 70B,均为:
80 层
64 个 Query Heads
Head Dim = 128
BF16 KV Cache
差别仅在 num_key_value_heads:
模型 A:Hkv = 64,MHA
模型 B:Hkv = 8,GQA
那么:
模型 A:2.5 MiB / token
模型 B:320 KiB / token
在 8k token 请求下:
模型 A:约 20 GiB / request
模型 B:约 2.5 GiB / request
即使两者参数量、权重精度和 GPU 数量相同,模型 B 仍可以用约 1/8 的 KV Cache 支持同样长度的请求。
因此,在比较候选模型的服务成本时,不能只比较:
模型参数量
权重精度
benchmark 分数
还必须比较:
num_hidden_layers
num_attention_heads
num_key_value_heads
head_dim
最大上下文长度
KV Cache dtype
16. GQA/MQA 与 KV Cache 量化如何叠加
GQA/MQA 减少的是 KV 的“元素数量”,KV Cache 量化减少的是每个元素的“字节数”。二者可以叠加。
公式仍然是:
KV Bytes / token
= L × 2 × Hkv × d_head × bytes_per_element
例如:
MHA + BF16 KV:Hkv = 64,bytes = 2
GQA + BF16 KV:Hkv = 8,bytes = 2
GQA + FP8 KV:Hkv = 8,bytes = 1
相对于 MHA + BF16 KV:
GQA + BF16 KV:约 1/8
GQA + FP8 KV:约 1/16
这会显著提升长上下文、高并发时的 KV 容量,但也需要验证 FP8 KV 对模型质量、长上下文检索和稳定性的影响。
17. 部署决策:什么时候 GQA/MQA 的价值最大
GQA/MQA 的收益在以下场景尤为明显:
长上下文
KV Cache 与上下文长度线性增长。上下文从 8k 提升到 128k 时,KV 容量需求增长 16 倍。此时 Hkv 较少的模型会明显更容易部署。
高并发在线服务
每个活跃请求都有一份 KV Cache。高 QPS、长输出、流式连接会使 Active Sequences 增加,GQA 可直接扩大安全并发上限。
Decode 主导的业务
例如聊天、Agent、多步骤工具调用、长文本生成。Decode 反复读取 KV Cache,减少 KV 读取能缓解 HBM 带宽压力。
GPU 显存紧张
模型权重已经占用大部分显存时,剩余的 KV Pool 决定服务是否有实际吞吐。GQA 可以让同一组 GPU 支持更多请求,或者让模型以更少 GPU 部署。
成本敏感场景
若 GQA 模型在真实任务质量上达到要求,其单位 token 成本和每实例吞吐通常更具优势。
18. 选型和压测时应重点观察什么
若在 MHA、GQA、MQA 模型之间选择,建议至少比较以下内容。
质量维度
真实业务成功率
结构化输出正确率
工具调用成功率
代码、数学和推理任务
长文档问答与信息定位
多轮对话一致性
安全与拒答行为
性能维度
TTFT P50 / P95 / P99
TPOT P50 / P95 / P99
Input TPS
Output TPS
安全最大并发
KV Cache 使用率
KV Free Blocks
抢占、Swap、重算次数
长短请求混合下的尾延迟
成本维度
同等 SLO 下需要的 GPU 数
每百万 input token 成本
每百万 output token 成本
每成功请求成本
可承载的最大上下文
不要只比较单请求 tokens/s。单请求速度相近的两个模型,可能因为 Hkv 不同而在高并发时有完全不同的吞吐、P99 和成本曲线。
19. 常见误解
误解一:GQA 只是一个推理框架参数
不是。GQA/MQA 是模型结构的一部分,权重训练时已经决定。推理框架读取模型配置并按其 num_key_value_heads 分配 KV Cache。
误解二:GQA 会将整个模型计算量降低到 1/8
不准确。GQA 最明确的收益是 K/V 投影、KV Cache 和 KV 访存减少;Query Heads 和模型的 MLP 仍然存在,Attention 的主要计算也不会简单按 KV Head 比例缩小。
误解三:MQA 一定比 GQA 更好
不一定。MQA 的显存效率最佳,但共享最强。若质量、长上下文能力或复杂任务表现下降,节省的 GPU 成本可能不值得。
误解四:有 GQA 就不需要管理上下文长度
不对。GQA 只是降低线性系数;KV Cache 仍然会随着上下文长度和并发线性增长。128k 上下文的单请求压力依然很大。
误解五:KV Cache 小就一定更快
KV Cache 小通常有利于高并发和 Decode 带宽,但最终性能还取决于权重精度、模型大小、Kernel、硬件、TP 通信、调度器、batch 和请求长度分布。
20. 总结
MHA、GQA、MQA 的核心区别是 KV Head 数:
MHA:Hkv = Hq
GQA:1 < Hkv < Hq
MQA:Hkv = 1
推理侧最关键的公式是:
KV Cache Bytes / token
= Layer 数
× 2
× KV Head 数
× Head Dim
× 每元素字节数
因此,在其他条件相同的情况下:
KV Cache、长上下文成本和高并发压力
与 Hkv 成正比。
GQA 的工程价值在于:它通常能在接近 MHA 质量的前提下,大幅减少 KV Cache 和 Decode 阶段的 K/V 访存,使长上下文和高并发推理更可行。MQA 则将该优化推到极致,但需要更谨慎地验证模型质量。
对 AI Infra 工程师而言,看到模型配置中的 num_key_value_heads 时,应立即联想到:
每 token KV Cache
最大上下文能力
安全并发
Decode 带宽
TTFT / TPOT 尾延迟
GPU 数量与单位 token 成本
这也是为什么,模型参数量相同并不代表推理服务成本相同。
阅读导航



