
PD 分离数据流:KV 生成、传输与 Decode 交接
PD 分离:KV 是怎么算出来、又怎么搬到 Decode 的
⛱️
读完这篇,你应该能说清三件事:
- Prefill 和 Decode 各自干什么
- KV 什么时候算、什么时候传、传完 Decode 怎么接着生成
- “传几次、每次大概多大”大概怎么估
0. 先用一句话说清
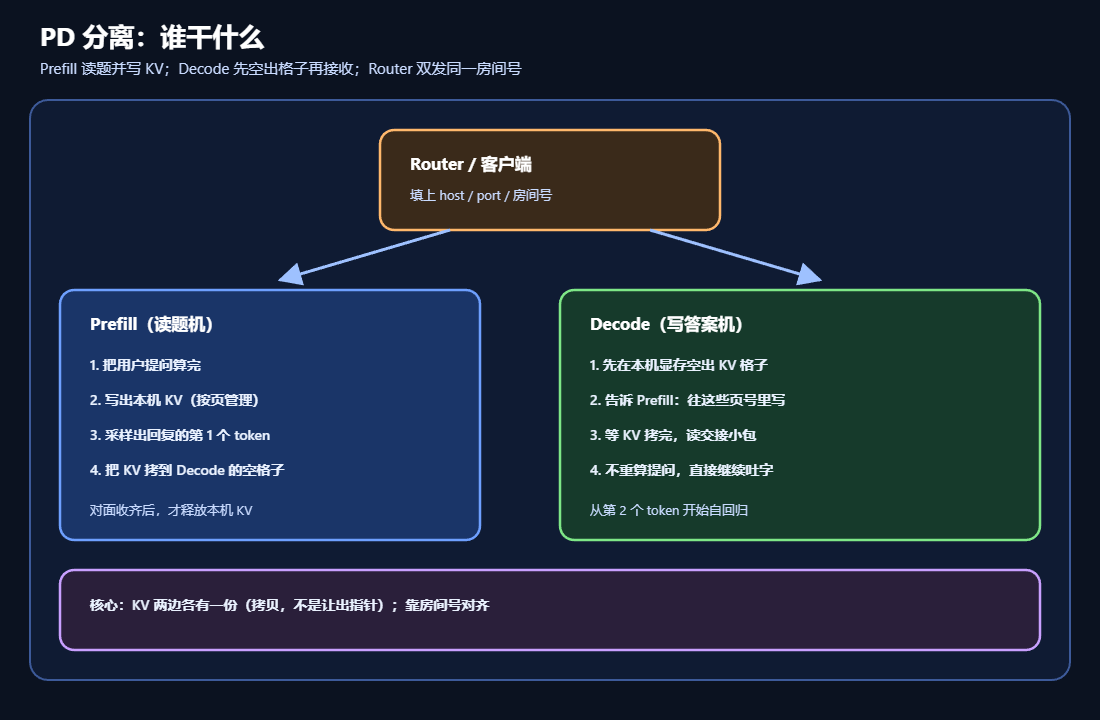
Prefill 负责:把用户输入(prompt)跑一遍,写出 KV,并采样出回复的第 1 个 token。
Decode 负责:先在自己显存里空出一批 KV 格子,告诉 Prefill「往这些格子里写」;收到 KV 后,从第 2 个 token 开始继续生成。
真正搬数据的是传输引擎(默认 Mooncake,走 RDMA 等高速通路),按「页」拷贝;最后再附带一小包交接信息(第 1 个 token、缓存命中统计等)。
几个词的人话:
| 术语 | 人话 |
|-|-|
| Prefill | 「读题」阶段:把整段提问一次算完 |
| Decode | 「写答案」阶段:一个 token 一个 token 往外吐 |
| KV | Attention 算出来的中间缓存,后面生成必须靠它,不能丢 |
| 页(page) | KV 在显存里的管理单位,一般若干个 token 合成一页再传 |
| bootstrap_room | 这次请求的「房间号」,Prefill/Decode/传输三边都靠它对上号 |
1. 为什么要把 Prefill 和 Decode 拆开
本来它们跑在同一台引擎上,会互相抢:
| 问题 | 人话 |
|---|---|
| 互相抢占 | 突然来一长串提问,正在吐字的请求就被拖慢,尾延迟变差 |
| 吃的资源不一样 | Prefill 主要吃算力;Decode 主要吃显存和带宽 |
| 扩容方式不一样 | Prefill 可以多加几台「读题机」;Decode 往往按「能同时挂多少会话的 KV」来扩 |
| 拆开之后: | |
| 角色 | 干什么 |
| - | - |
| Prefill | 读完提问、写 KV、采样出回复第 1 个字;只生成 1 个 token(max_new_tokens=1) |
| Decode | 先空出显存格子 → 收 KV → 接着往下生成 |
| Bootstrap 服务 | Prefill 上的「通讯录」:告诉 Decode 怎么连过来 |
| Router | 给请求填上「找谁会合」的三个字段,并分别打到 Prefill 和 Decode |
2. 会合靠三个字段:host / port / room
每个请求都会带(通常由 Router 自动填):
| 字段 | 人话 |
|---|---|
bootstrap_host | Prefill 那台机器的地址 |
bootstrap_port | 会合服务端口,常见默认 8998 |
bootstrap_room | 这次请求的唯一房间号 |
| 两端直连、不经 Router 时,客户端自己也得带上这三个字段。 |
特殊地址 2.2.2.2(fake host)只用于热身/探活,不走真传 KV。
bootstrap_room 会用在三处:
- 查「这个请求该找 Prefill 的哪一路」
- 双方控制消息、传输状态表的主键
- 交接小包里的校验码:防止张冠李戴(串包)
启动示例:
# Prefill
--disaggregation-mode prefill
--disaggregation-transfer-backend mooncake
--disaggregation-bootstrap-port 8998
--disaggregation-ib-device mlx5_0

# Decode
--disaggregation-mode decode
--disaggregation-transfer-backend mooncake
3. 其实有三层,别混成「HTTP 把 KV 传过去」
很多人以为:Prefill 用 HTTP 把 KV POST 给 Decode。
不对。 实际是三层,各干各的: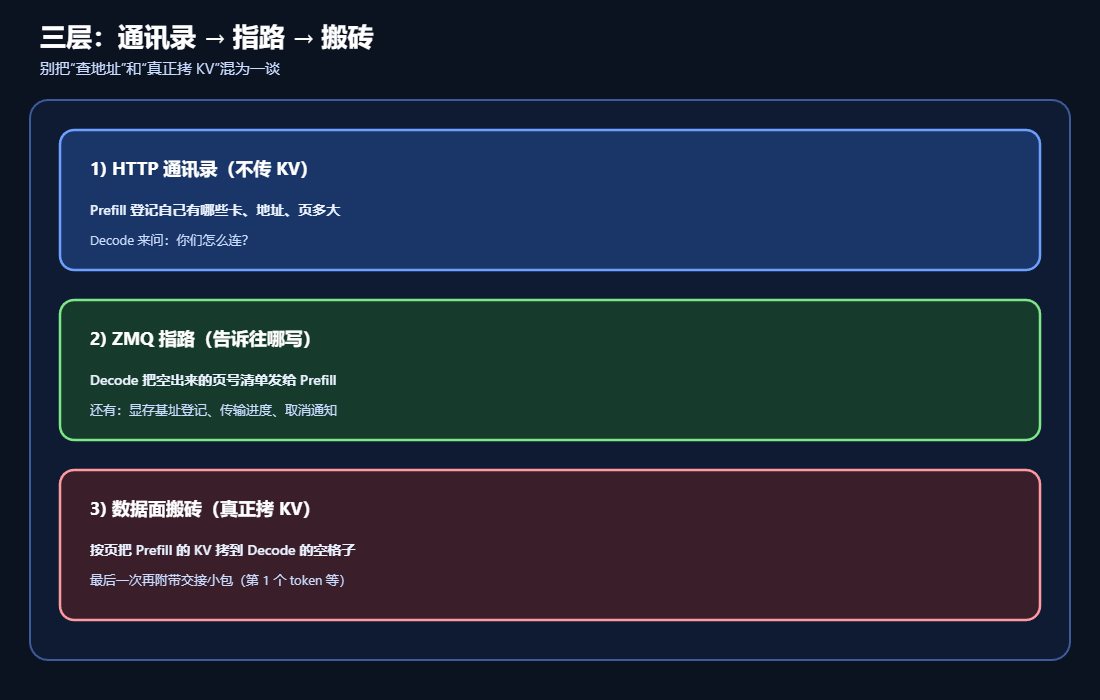
3.1 第一层:HTTP「通讯录」(不传 KV)
Prefill 启动一个小 HTTP 服务,登记自己有哪些 GPU、地址、页大小等。
Decode 来问:「你们拓扑长什么样?」
| 接口 | 人话 |
|---|---|
PUT /route | Prefill 各卡登记自己 |
GET /route | Decode 拉取通讯录 |
register_dp_rank / query_dp_ranks | 用房间号查该找 Prefill 哪一路 |
GET /health | 探活 |
3.2 第二层:ZMQ「指路」(告诉对方往哪写)
先一次性登记:对端显存缓冲区的地址、每页多大、有哪些层……
每个请求再发一次:「请写到我这批页号上」。
关键信息包括:
| 内容 | 人话 |
|---|---|
| 目的页号列表 | Decode 空出来的那些 KV 格子编号 |
| aux 槽位 | 放「第 1 个 token」等小交接信息的格子 |
| decode_prefix_len | Decode 本地已经命中多少前缀,可以少传 |
| 状态索引 | Mamba 等额外状态(有才传) |
| 另外还会同步「传到哪一步了」、以及取消(ABORT)。 |
3.3 第三层:数据面「搬砖」(真正拷 KV)
把 Prefill 显存里的 KV 按页拷到 Decode 已经空好的格子;
最后一次再附带交接小包。
常见后端:
| 名字 | 人话 |
|---|---|
| mooncake(默认) | 高速拷贝(RDMA 等) |
| nixl / mori / ascend | 其它硬件路线 |
| fake | 测试用,假传 |
4. 从头到尾发生了什么
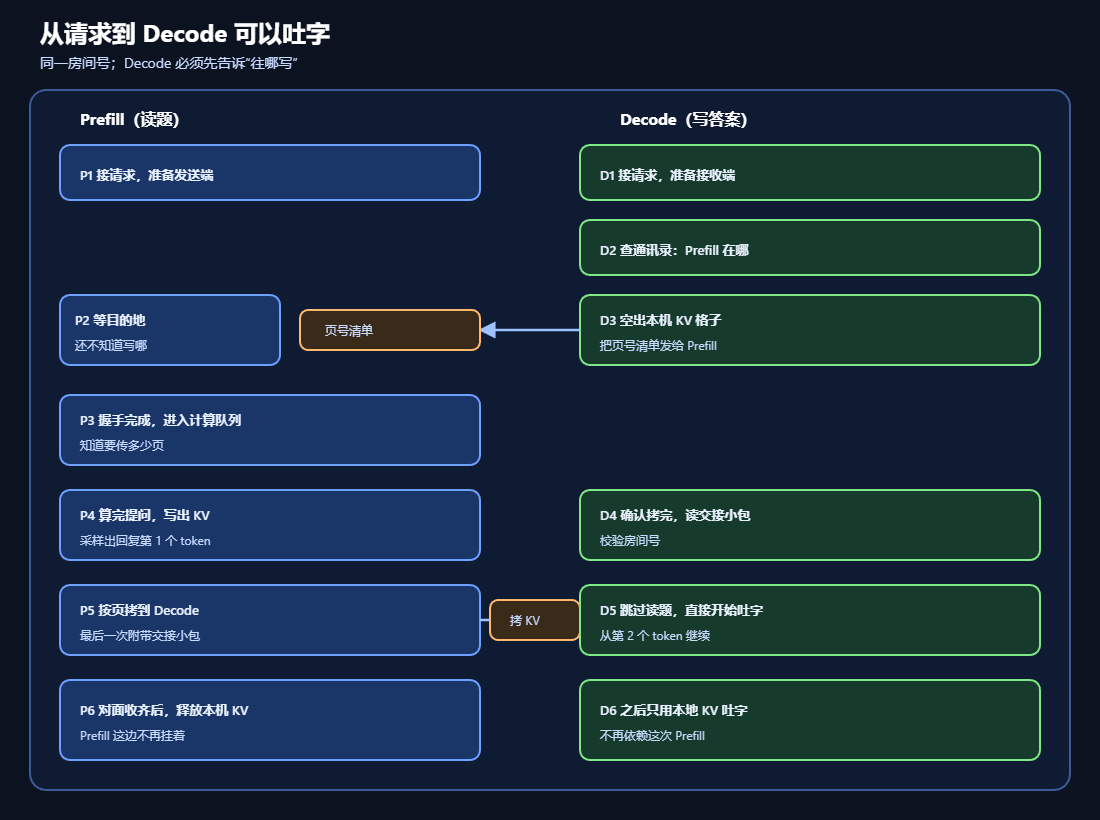
用人话按时间线写:
- Router 把同一个房间号的请求,分别发给 Prefill 和 Decode。
- Decode 先查通讯录,在自己显存里空出 KV 格子,把「页号清单」发给 Prefill。
- Prefill 等到这份清单后,才开始(或继续)正式排队计算。
- Prefill 算完提问 → 写出本机 KV → 采样出回复第 1 个 token。
- Prefill 按页把 KV 拷到 Decode;最后一次捎上交接小包。
- Decode 确认拷完且小包校验通过 → 当作「提问已经算完」→ 进入正常吐字循环。
- Prefill 确认对面收齐后,才释放自己这边的 KV 显存。
死规矩: Decode 不先空出格子、不把页号告诉 Prefill,Prefill 不能开传。
否则 Prefill 会卡在「等输入/等目的地」(WaitingForInput)。
5. 传输状态:走到哪一步了
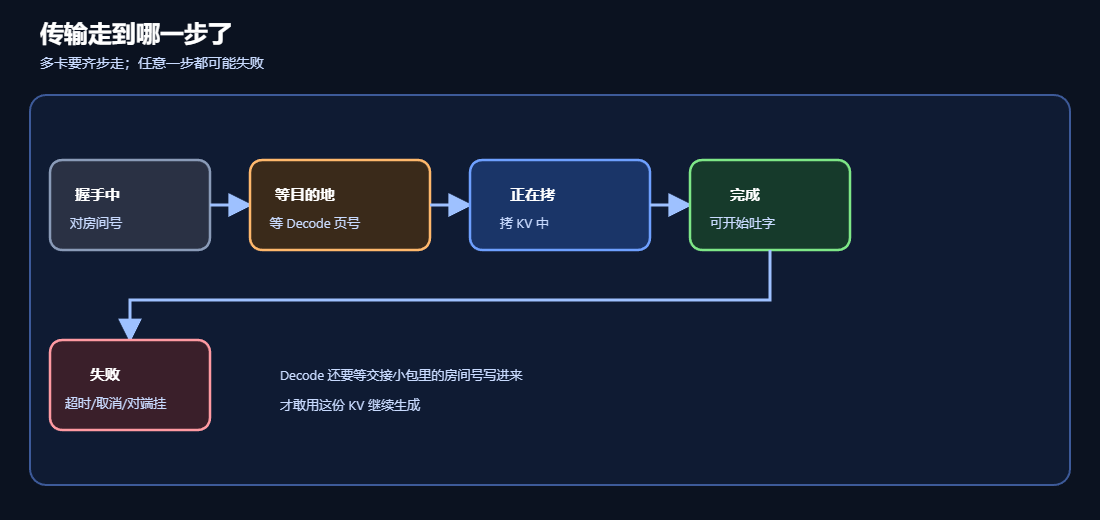
可以记成五个阶段:
| 状态 | 人话 |
|---|---|
| Bootstrapping | 还在握手、对房间号 |
| WaitingForInput | Prefill 在等 Decode 的「页号清单」 |
| Transferring | 正在拷 KV |
| Success | 拷完且(Decode 侧)交接信息也对上了 |
| Failed | 超时、对端挂了、被取消等 |
| 多卡时,各卡要「齐步走」:不能有的卡已经 Success、有的还在传。 |
Decode 还多一道门:传输引擎报成功了,还要等交接小包里的房间号真正写进来,才敢用。
6. Prefill:KV 怎么来,又怎么变成「可传的页」
6.1 怎么算出来的
和普通服务一样:Attention 前向把 K/V 写进本机 KV 池。
PD 没有另造一套网络专用 KV 格式;差别只在「算完之后怎么导出、拷走」。
6.2 怎么变成页再传
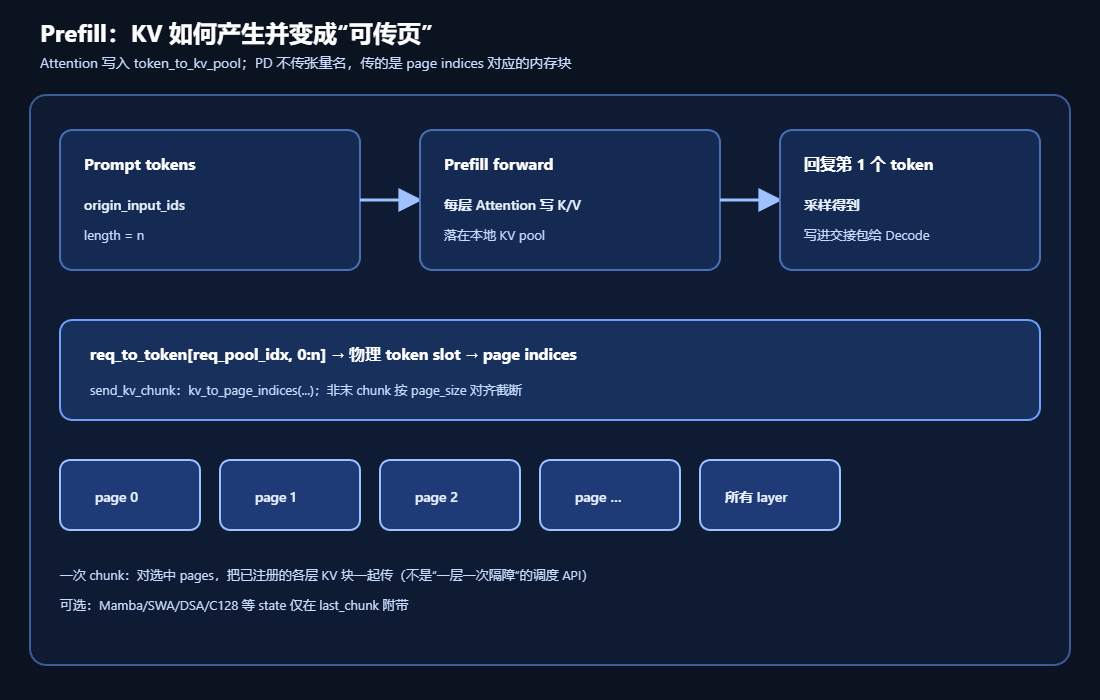
人话步骤:
- 决定这段要传提问里的哪一段 token(从哪传到哪)。
- 中间段:只传到整页为止,半页先留着。
- 把 token 在显存里的位置,换算成「页号」。
- 最后一段:先把第 1 个 token 等写进交接小包。
- 把页号交给传输引擎去拷。
6.3 Prefill 侧排队在干什么
| 步骤 | 人话 |
|---|---|
| 进 bootstrap 队列 | 建发送端,强制只生成 1 个 token |
| 握手完成 | 知道要传多少页、交接小包用哪个槽 |
| 算完一轮 | 采样出第 1 个 token,请求进入「等传完」队列 |
| 发 KV | 按段调用发送 |
| 传完 | 释放本机 KV |
6.4 长提问可以「边算边传」
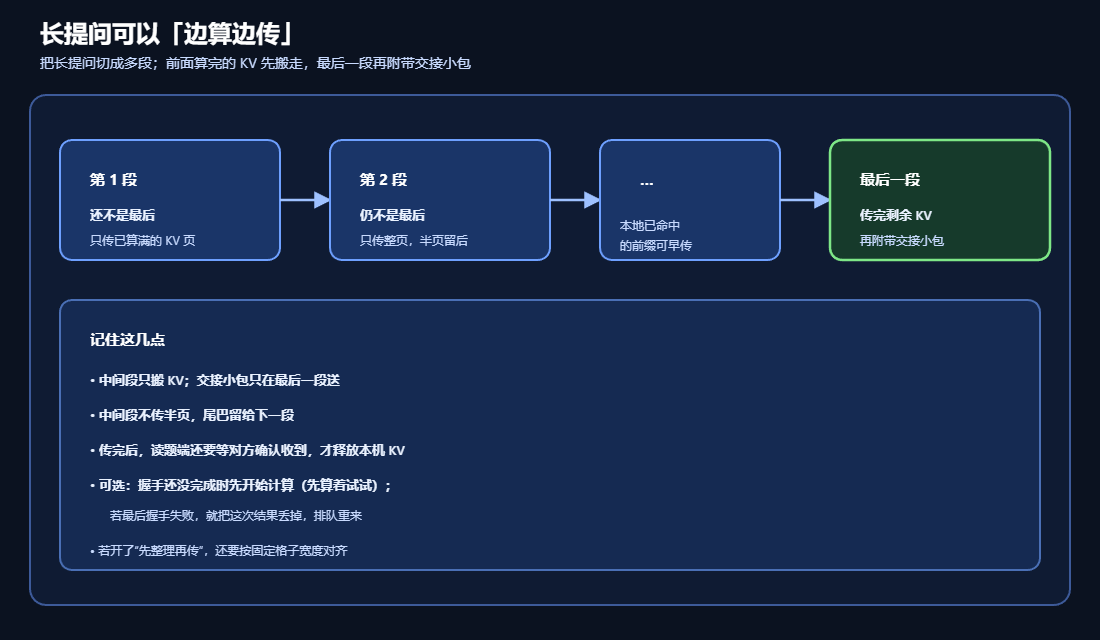
把长提问切成多段:
| 哪一段 | 传什么 |
|---|---|
| 中间段 | 只传已经算满的 KV 页(不传半页) |
| 最后一段 | 剩余 KV 页 + 交接小包(+ 可选额外状态) |
| 好处:前面算完的可以先搬,和后面计算重叠。 |
代价:中间段必须整页对齐,尾巴可能拖到下一段。
另外两点可选优化:
- 本地已命中的前缀:Prefill 自己缓存里已经有提问前缀时,可以尽早先把这部分 KV 推走。
- 先算着试试(源码里叫 optimistic prefill):握手还没完全完成时,也可以先开始算;若最后握手失败,就把这次结果丢掉、重新排队。正常理解成「为了省时间先干着,不成再重来」。
7. Decode:必须先空出格子,再喊 Prefill 来写
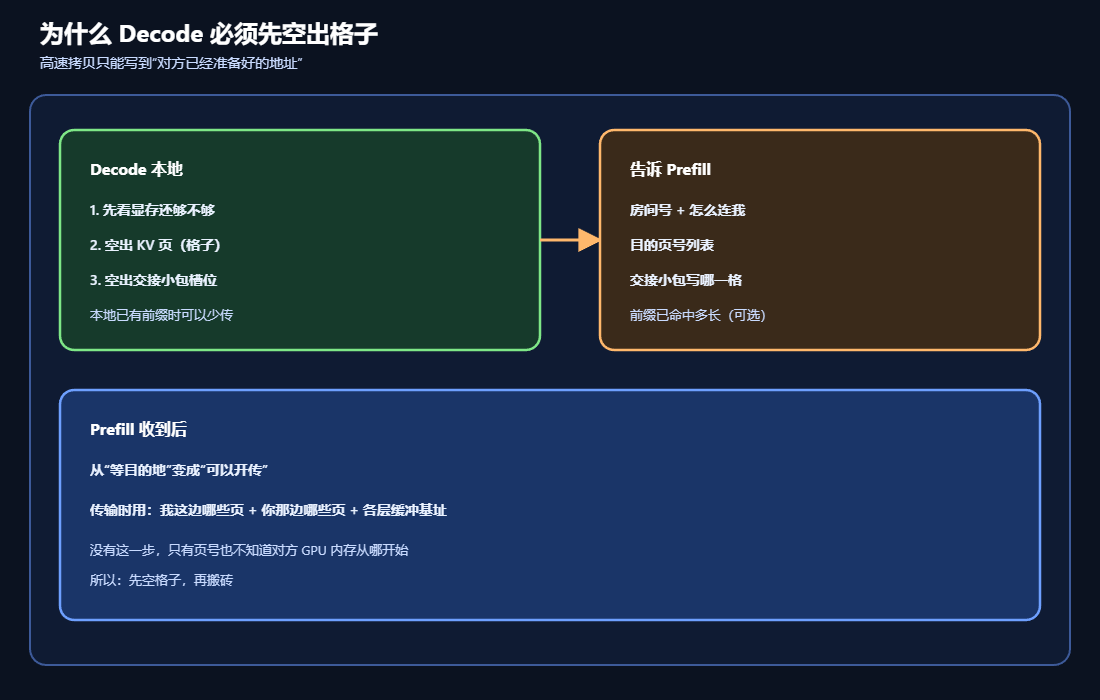
7.1 为什么必须 Decode 先分配?
高速拷贝是「写到对方已经准备好的地址」。
Decode 不先空出格子,Prefill 只知道「提问有多长」,不知道写到哪块显存。
所以固定顺序是:
- Decode 估一下显存还够不够(要算上正在吐字的、正在收 KV 的)。
- 空出本机 KV 页 + 交接小包槽位。
- 把目的页号发给 Prefill。
- Prefill 才能开传。
7.2 Decode 两条队列
| 队列 | 人话 |
|---|---|
| 预分配队列 | 查通讯录、握手、空格子、发页号清单 |
| 传输等待队列 | 等拷完、读交接小包、校验房间号 |
| Decode 不会再跑一遍提问计算。 |
KV 齐了之后,请求被当成「已经读完题」,直接进入吐字循环。
7.3 交接小包提交时做什么
- 把回复第 1 个 token 写进请求
- 带上缓存命中、logprob 等(如果有)
- 核对房间号:对不上就当串包,直接失败
- 然后当作 prefill 已完成,进入正常 decode
8. 一次传输到底搬什么
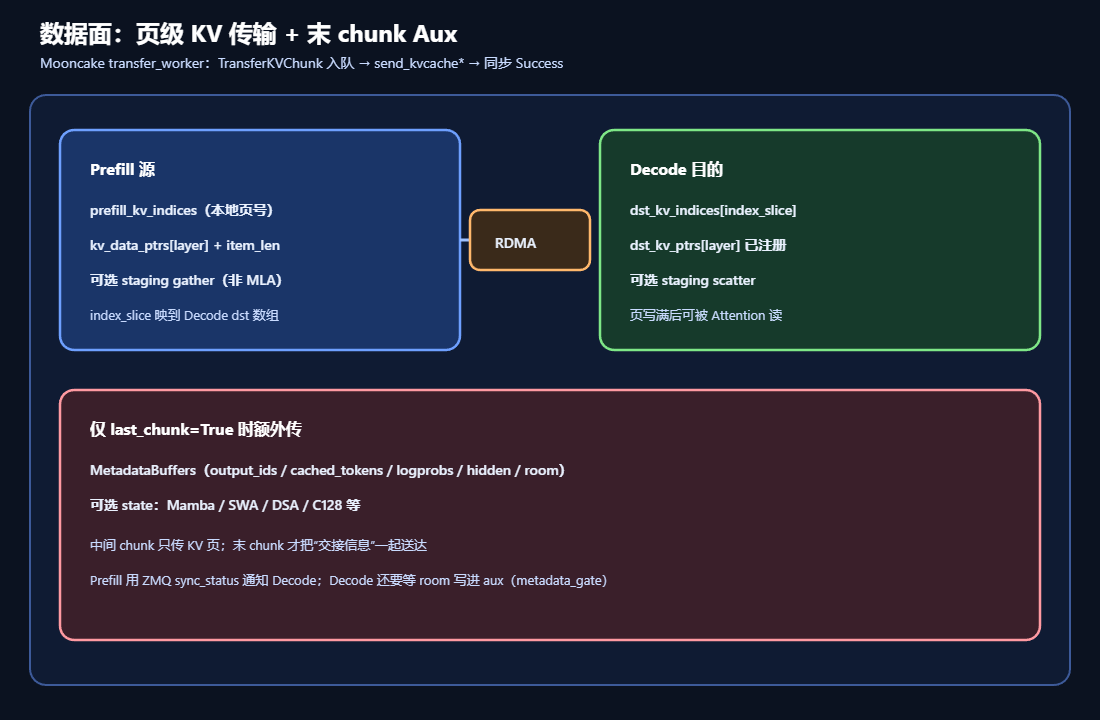
8.1 直观理解
选定一批页号 → 把 Prefill 上这些页里、各层 Attention 的 KV → 拷到 Decode 对应页。
不是「先传完第 0 层再传第 1 层」那种调度屏障;
同一批里往往多层一起提交给传输引擎。
8.2 为什么还要交接小包?
KV 页只解决「上下文缓存」。
Decode 还需要知道:
- 回复已经生成到哪个字了(第 1 个 token)
- 缓存命中了多少、要不要带 logprob / 投机解码状态等
这些放在交接缓冲(MetadataBuffers)里,只在最后一段一起传。
8.3 先整理再传(staging)
页号很碎时,可以先在中间缓冲区拼成连续块再拷,Decode 再拆开。
用来减少「碎页太多、拷贝次数爆炸」。
8.4 正在传的时候别乱动页
如果显存池会做整理/搬家,必须等没有在飞的传输再搬,否则对面还在往旧地址写。
9. 切多少包、每包多大(重点)
这里的「包」不是网卡那种固定 4KB 小包,而是下面四层。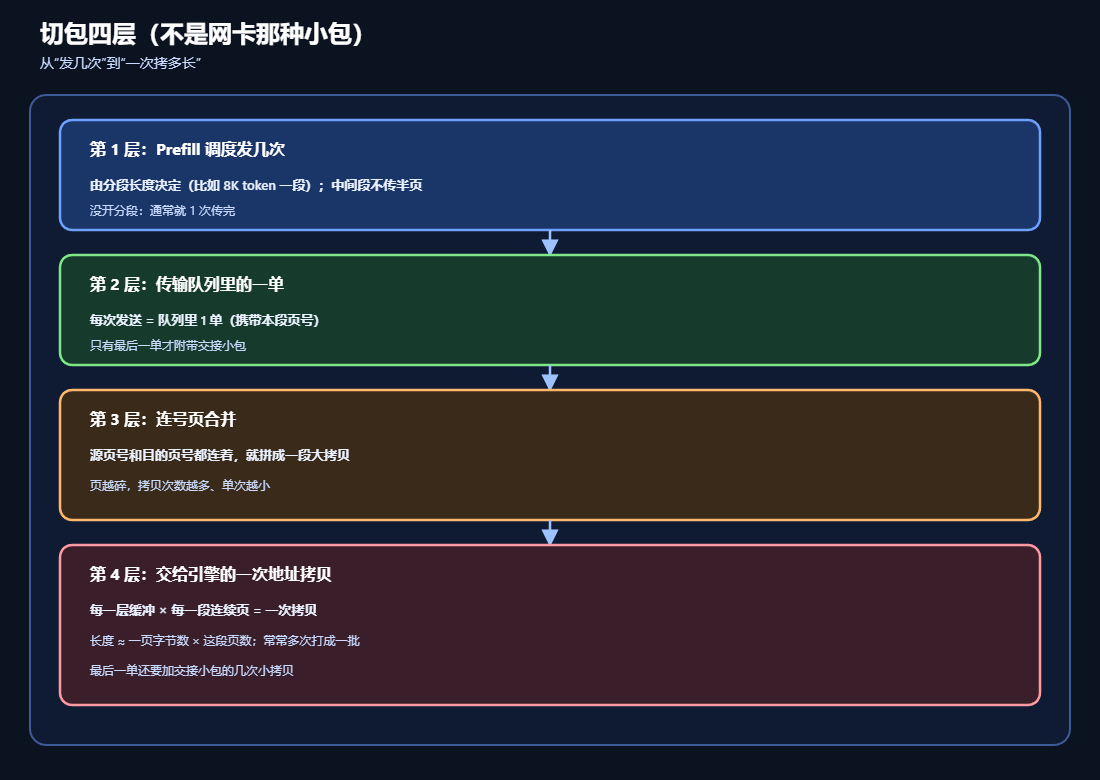
9.1 四层分别是什么
| 层级 | 人话 | 大概多大 |
|---|---|---|
| 第 1 层 | Prefill 调度「发几次」 | 每次大约对应一段 chunked_prefill_size 的全部层 KV |
| 第 2 层 | 每次真正入传输队列的一单 | 这一单里的那些页;最后一单再加交接小包 |
| 第 3 层 | 把「源页号和目的页号都连号」的合成一段 | 连续几页拼成一次大拷贝 |
| 第 4 层 | 交给引擎的一次地址拷贝 | 「某一层缓冲 × 一段连续页」的字节数 |
| 默认 Mooncake:同一单里多个第 4 层拷贝,常常打成一批一起提交。 |
9.2 第 1 层:调度发几次?
要传的 token 数 ≈ 提问长度 − Decode 本地已命中前缀
页数 ≈ 向上取整(要传 token 数 / 每页 token 数)
| 配置 | 大约发几次 |
|---|---|
| 没开分段 prefill | 1 次(整段一次传完) |
--chunked-prefill-size C | 大约 提问长度 / C 次;前面几次只传 KV,最后一次带交接小包 |
| 还开了 staging | 上面每一次还可能再拆细 |
| 中间段规则:不传半页,半页留给后面。 |
9.3 第 2 层:队列里的「一单」是什么
每次发送入队 1 单,大致带:
- 本段要拷的源页号列表
- 对应到 Decode 目的页号的哪一段
- 是不是最后一单(最后一单才带交接小包)
最后一单即使 KV 页已经传完、只剩交接小包,也要再发一次。
9.4 一页有多大?看 kv_item_lens
启动时 KV 池会登记:每个缓冲上「一页占多少字节」。
- 普通多头 Attention:通常每层有 K、V 两套
- MLA 等:往往是压缩后的整块
人话公式(常见情况):
某一层、一页的 K(或 V)
  ≈ 每页 token 数 × 本卡 kv 头数 × 头维度 × 每个数占几个字节

一页、整模型
  ≈ 把所有登记缓冲的「一页字节数」加起来   (记作 B_页)

这一段要传的 KV
  ≈ 这一段页数 × B_页
指标里的 transfer_total_bytes,基本就是按「页数 × 每页字节」累加出来的。
示意数字(只帮助建立量级,以你机器实测为准):
假设:每页 16 token,60 层,本卡 8 个 kv 头,头维度 128,bf16:
一层 K 的一页 ≈ 16×8×128×2 = 32 KiB(V 同理)
一页整模型    ≈ 60×(32+32) KiB ≈ 3.75 MiB
若分段大小 8192 token:
一段约 512 页 ≈ 512×3.75 MiB ≈ 1.9 GiB
32K 提问、没有本地前缀命中:大约 4 段,总共大约 7.5 GiB 量级的 KV 要搬。
换 MLA/FP8/不同切分,数字会差很多——以登记时的每页字节为准。
9.5 第 3/4 层:一次拷贝有多大
如果 Prefill 和 Decode 两边的页号都是连号的,就合成一次大拷贝:
拷贝长度 = 一页字节数 × 这一段连续页数
| 页排得怎样 | 拷贝次数 | 单次大小 |
|---|---|---|
| 两边都连号 | 少(理想 1 次/缓冲) | 可以很大(几百 MB~GB) |
| 完全打散 | 约等于页数 | 每次大约就是一页 |
再乘「有多少个层缓冲」(普通情况大约 2 × 层数)。 |
Prefill/Decode 的张量并行不一致、或开了序列维切分时,可能改走「按头切片 / 按 token 交错」,会更碎、单次更小。
9.6 交接小包有多大?
比 KV 小几个数量级。大致是:
| 内容 | 大概 |
|---|---|
| 第 1 个 token | 几十字节(有 padding) |
| 缓存命中计数等 | 几十字节 |
| logprob / 隐藏状态等 | 有就更大一点(KB~几十 KB) |
| 最后一单 = 剩余 KV + 全部交接小字段(+ 可选额外状态)。 |
9.7 一张估算总表
已知:要传 token 数 N,分段大小 C,每页 token 数 P,每页字节 B:
总页数     ≈ N / P
调度次数   ≈ N / C          (没开分段就是 1)
每段页数   ≈ C / P
每段字节   ≈ 每段页数 × B
总 KV 字节 ≈ 总页数 × B
交接小包   ≈ 很小,只加在最后一次
9.8 别和「网卡小包」搞混
| 容易误会 | 实际 |
|---|---|
| 固定 64KB 切很多小包 | 按「页 / 分段」切;一次拷贝常常很大 |
| 必须一层传完再传下一层 | 同一单里多层常常一起提交 |
| HTTP 上传 KV | HTTP 只做通讯录;KV 走专用传输引擎 |
核对真实流量:看 transfer_total_bytes 和传输日志里的页数,别去数 TCP 段。 |
10. 交接小包到底是什么(重点)
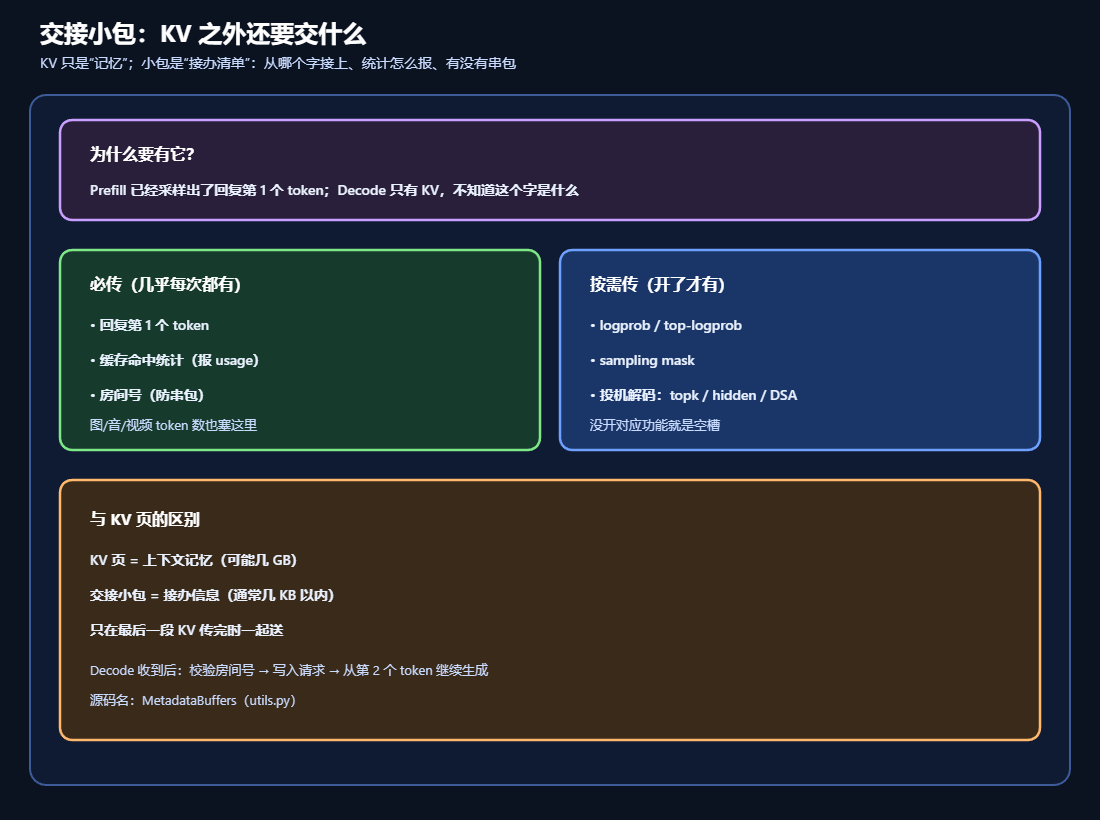
源码里叫 MetadataBuffers(disaggregation/utils.py)。
文档里说的「交接小包」,指的就是它。
10.1 先分清:KV 页 ≠ 交接小包
| KV 页 | 交接小包 | |
|---|---|---|
| 装什么 | Attention 的 K/V 缓存(「记忆」) | Prefill 算完后要交给 Decode 的接办信息 |
| 多大 | 常常几百 MB~几 GB | 通常几 KB 以内(相对 KV 很小) |
| 传几次 | 可以边算边传,多段 | 只在最后一段一起传 |
| 没有它会怎样 | Decode 没法接着算 Attention | Decode 不知道「回复已经生成到哪了」、usage/校验也会缺 |
| 一句话: |
KV 解决「读过什么」;交接小包解决「从哪个字接上、统计怎么报、有没有拿错包」。
10.2 为什么必须有交接小包?
PD 拆开后,Prefill 和 Decode 是两台(或两套)进程:
- Prefill 已经采样出了回复的第 1 个 token
(因为 Prefill 被设成只生成 1 个 token。) - Decode 不会再跑一遍提问,它直接用收到的 KV 继续吐后面的字。
- 可是:光有 KV,Decode 并不知道第 1 个 token 是什么。
- 第 1 个 token 是 Prefill 根据最后一步 logits 采样出来的;
- 它不在 KV 矩阵里,也不会自动出现在 Decode 本地。
所以必须单独捎一包信息过去,至少包括:
- 「回复第 1 个字是这个」→ Decode 写进
output_ids,再从第 2 个字继续 - 「缓存命中了多少」→ 两边 usage 统计才对得上
- 「房间号」→ 防止两个请求的交接槽位撞车、张冠李戴
没有这包,会出现例如: - Decode 收到了 KV,却不知道该往用户流里先吐哪个字
- 或者误用了别人槽位里的交接数据(串包),生成错乱
10.3 小包里具体有什么
Prefill 在最后一段发送前调用 MetadataBuffers.set_buf(req) 填槽;
Decode 传完后 get_buf → _commit_transfer_to_req 读出来写回请求。
A. 几乎每次都用到的(核心)
| 字段 | 人话 | Decode 拿来干什么 |
|---|---|---|
output_ids[0] | Prefill 采样出的回复第 1 个 token | output_ids.append(...),作为已生成内容;后面从第 2 个继续 |
cached_tokens[0] | Prefill 侧前缀缓存命中了多少 token | 填 usage / cached_tokens;并用来避免和 Decode 本地命中重复计算 |
cached_tokens[1..3] | device / host / storage 各命中多少 | 分层缓存统计 |
cached_tokens[4..6] | 图 / 音 / 视频在 prompt 里占了多少 token | 多模态 usage(在 Prefill 算好再传来,Decode 不用重算) |
bootstrap_room | 这次请求的房间号 | 和本请求房间号比对;对不上就当串包,直接失败 |
output_ids、cached_tokens、bootstrap_room 在实现里都做成「一行至少约 64 字节」的小张量(有 padding),方便 RDMA 按固定槽位拷贝。 |
B. 你开了功能才有意义的
| 字段 | 什么时候有 | 干什么 |
|---|---|---|
output_token_logprobs_* | 请求要返回 logprob | 第 1 个生成 token 的 logprob |
output_top_logprobs_* | 同上,且要 top-k | 第 1 个 token 的 top logprobs |
sampling_mask_* | 开了 sampling mask 相关返回 | 第 1 个 token 的采样掩码信息 |
output_topk_p / output_topk_index | 开了投机解码(如 EAGLE) | 把 Prefill 侧的 draft 交接状态给 Decode |
output_hidden_states | 投机解码 | draft 需要的隐藏状态 |
output_dsa_topk_indices | DSA / 相关投机路径 | 索引类交接;无效时填 -1 |
| 没开这些功能时,对应槽位基本是空的/默认值,但仍占用固定布局(方便高速拷贝,不用每次改协议形状)。 |
10.4 什么时候传?怎么传?
中间段 KV:只传页,不带小包
最后一段:剩余 KV 页 + 交接小包(+ 可选 Mamba/SWA 等状态)
传输上:对小包里每个张量做一次「槽位 → 槽位」拷贝(send_aux):
源:Prefill 的 MetadataBuffers[本请求槽位]
目的:Decode 的 MetadataBuffers[事先空好的槽位]
Decode 侧还有一道门(metadata gate):
即便 KV 拷贝引擎报成功了,也要等小包里的 bootstrap_room 真正写进来,才提交请求——避免「KV 到了、接办信息还没到」就开吐字。
10.5 Decode 收到后做了什么(接办流程)
- 读出小包各字段
- 核对房间号(0 或与预期不符 → abort)
- 把第 1 个 token 写入本请求的
output_ids - 写入缓存命中、多模态计数、logprob/投机状态(若有)
- 当作「提问已经算完」,进入正常 decode 循环(从第 2 个 token 起)
特殊情况:PD 回退重拉(rebootstrap)时,有时会强制沿用「边界上已经吐过的那个 token」,避免同一字吐两遍——那是进阶路径,日常理解可先记住「正常情况就是用小包里的第 1 个 token」。
10.6 和「状态」(Mamba/SWA 等)别混
有的模型除了普通 KV,还有额外状态(Mamba、滑动窗口、DSA 等)。
那些往往也在最后一段附带传,但它们是另一类「模型状态索引/内容」,
不是这里说的交接小包(MetadataBuffers)。
交接小包专指:第 1 个 token + usage/校验 + 可选采样/投机元数据 这一固定槽位池。
10.7 设计成「固定小槽位池」的原因
- 高速拷贝喜欢固定地址、固定长度,不喜欢每次临时拼 JSON
- 多个请求共用一块大缓冲,用
metadata_buffer_index(槽位号)区分 - 所以要靠
bootstrap_room防「槽位复用撞车」
11. Prefill 本地释放时机 vs Decode 本地占用
| 谁 | 什么时候占 / 放 |
|---|---|
| Prefill | 算的时候占着;传成功之后才释放 |
| Decode | 空格子时就已经占上了;之后一直给这个请求用 |
| 所以: |
- Prefill 若传不完、堆积很多「等传完」,显存会顶满
- Decode 若预分配太猛,也会先被占满
相关参数:--num-reserved-decode-tokens、--disaggregation-decode-extra-slots(给正在收 KV 的请求留余量)。
12. Decode 本地已有前缀时:可以少传
若 Decode 开了前缀缓存(radix / HiCache):
- 先看本地已经命中提问的多长前缀
- 告诉 Prefill「前缀这么长不用传」
- Prefill 只传后面多出来的那截
- 本地命中部分自己恢复
注意:少传的是 KV 页;最后的交接小包通常还是要(第 1 个 token 等)。
估算字节时,按「提问长度 − 已命中前缀」来算。
13. 出问题怎么查
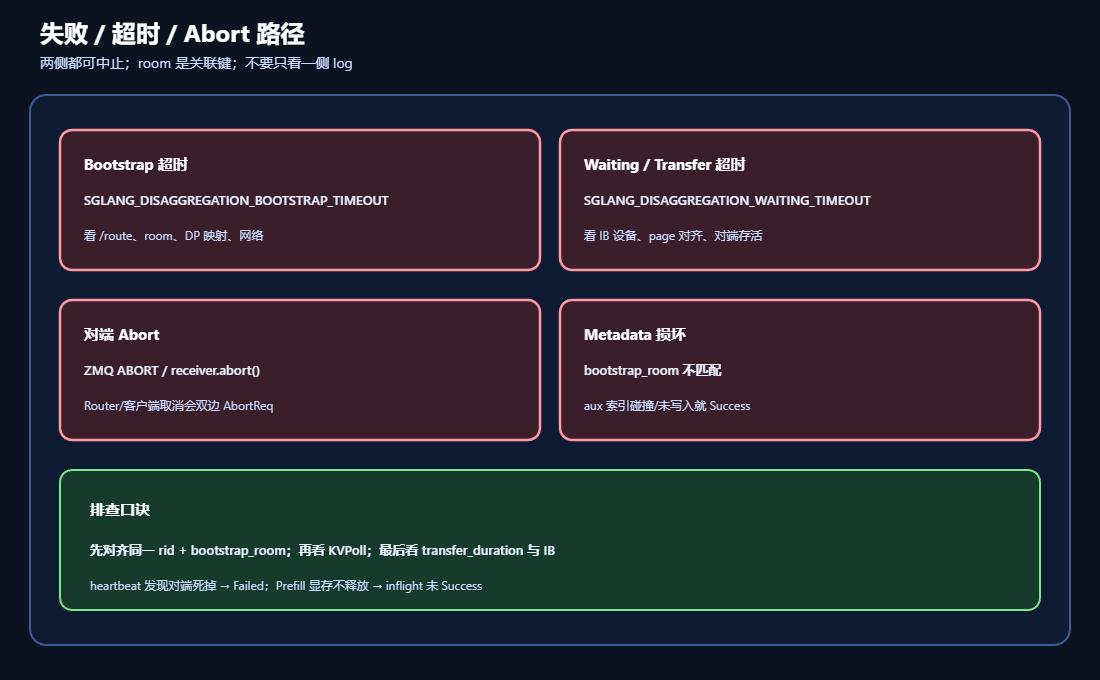
| 现象 | 先看什么 |
|---|---|
| 一直在握手 / 等目的地 | 房间号是否一致;Prefill 通讯录是否登记成功;页号清单有没有发出去 |
| 一直在传输、超时 | 网卡/IB、超时时间、页是否对齐、对端是否还活着 |
| 第 1 个 token 不对 / 房间号对不上 | 交接槽位是否冲突;是不是最后一单没带小包 |
| Prefill 显存不降 | 传没成功,释放走不掉 |
| 两边同时 Abort | 多半是客户端/Router 取消;用同一个请求 id + 房间号对齐两边日志 |
| 很久但传输耗时≈0 | 可能根本没进有效拷贝,卡在握手或等页号清单 |
| 页不多却极慢 | 页太碎、拷贝次数爆炸;或走了更碎的切头/切序列路径 |
常见超时环境变量:SGLANG_DISAGGREGATION_BOOTSTRAP_TIMEOUT、SGLANG_DISAGGREGATION_WAITING_TIMEOUT(默认大约 300 秒)。 |
任一侧取消,会通知另一侧一起收尾。
14. 和 Router、/generate 的关系
| 场景 | 谁填房间号三件套 |
|---|---|
| 走 PD Router | Router 填,并双发 Prefill + Decode |
| 直连两台 | 客户端自己填 |
| 热身 / 探活 | 用 fake 地址 |
| 记住:对齐日志靠「请求 id + 房间号」,不要只盯着某条 HTTP 连接。 |
15. 建议阅读源码顺序
disaggregation/utils.py— 模式、交接缓冲、选哪个传输后端disaggregation/base/conn.py— 状态枚举、发送/接收抽象disaggregation/common/conn.py— 通讯录 HTTP、超时、公共逻辑disaggregation/prefill.py— Prefill 排队、发送、算完后处理disaggregation/decode.py— 预分配、等待传输、进入吐字disaggregation/mooncake/conn.py— 默认怎么真正拷disaggregation/common/utils.py— 「一单传输」结构、连续页合并mem_cache/memory_pool.py— 一页多少字节怎么算出来managers/scheduler.py— 何时挂上 PD 逻辑
16. 读完自测
- KV 是只存在一边,还是 Prefill / Decode 各自有一份?
- 为什么 Decode 必须先发「页号清单」,Prefill 才能传?
- 中间段和最后一段,各传什么?
- 房间号在通讯录、控制消息、交接小包里各起什么作用?
- Prefill 什么时候才能释放本机 KV?Decode 什么时候开始占用格子?
- 传输报成功了,但交接小包里房间号还是 0,会怎样?
- 分段 8192、每页 16 token、32K 提问(无本地前缀),大约传几段?每段大约多少页?
kv_item_lens里一个数表示什么?某层一页 32KiB、连续 100 页,单次拷贝大约多大?
参考答案:- 两边各自有一份;传输是拷贝,不是把指针让出去。
- 因为只能写到 Decode 已经空好的地址。
- 中间:KV 页;最后:KV 页 + 交接小包(+ 可选状态)。
- 找哪一路 Prefill;会话主键;防串包校验。
- Prefill:传成功后;Decode:预分配时。
- 校验失败,请求 abort,避免用错上下文继续生成。
- 大约 4 段;每段大约 512 页。
- 「某一个缓冲上,一页占多少字节」;约
32KiB × 100 = 3.125 MiB。
17. 名字速查(对着源码搜)
| 名字 | 人话 |
|---|---|
send_kv_chunk | Prefill 调度层:发这一段 |
TransferKVChunk | 传输队列里的一单 |
group_concurrent_contiguous | 把连号页合成一次大拷贝 |
_send_kvcache_generic | 真正拼地址并提交拷贝 |
MetadataBuffers | 交接小包(第 1 个 token 等) |
get_new_prebuilt_batch | Decode:KV 齐了,跳过读题,直接吐字 |
get_contiguous_buf_infos | 登记缓冲区,算出每页字节数 |
阅读导航



