
DP 与 DPA 的区别:SGLang 并行部署与路由
DP和DPA的区别是什么?
本文主要说明数据并行(DP)与数据并行 Attention(DPA)之间的区别、如何正确启用各模式,以及简要介绍如何在生产级 DP 部署中使用 SGLang Model Gateway(SMG)。
三种策略总览
在进入细节前,先用一张图建立全局印象(同样 8 张 GPU,三种放法截然不同):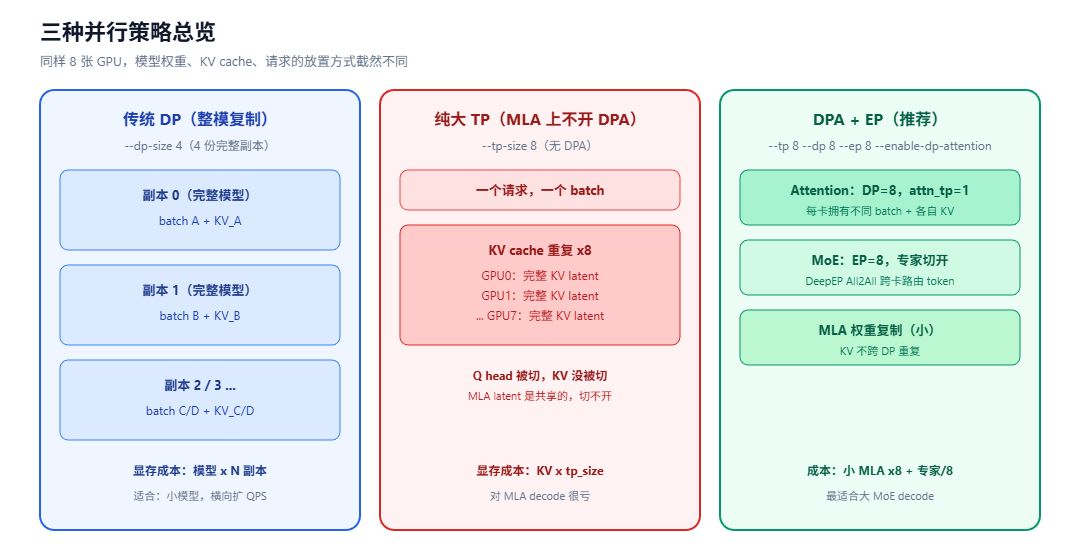
| 策略 | 复制对象 | KV 是否重复 | 适合场景 |
|---|---|---|---|
| 传统 DP | 整模 × N 副本 | 各副本独立(无跨副本重复) | 小中模型,扩 QPS |
| 纯大 TP(MLA) | 权重按 TP 切 | KV × tp_size 重复 | 不推荐用于 MLA decode |
| DPA + EP | 小 MLA × dp + experts / ep | KV 不重复 | 大 MoE / MLA decode |
数据并行(DP)
数据并行(DP) 是最常见的并行策略:在多个 GPU 组上复制完整模型,并行处理不同批次的请求。每组 GPU 独立处理请求。配合后续将介绍的路由策略,在 SGLang Model Gateway 中使用合适的路由算法后,serving 系统的吞吐可接近线性倍增。
主要特点
- 每个副本拥有模型的完整拷贝
- 请求被分发/散射到各副本
- 单次请求的推理过程中副本之间无通信(简单 DP 场景)
显存成本直觉
传统 DP 总显存 ≈ N_replicas × (FullModel + 各副本自己的 KV)
这意味着:模型越大,能开的副本数越少。对 700GB 级 MoE,单副本都吃力,再复制 N 份几乎不现实——这正是 DPA 出现的原因。
适用场景
| 适合传统 DP | 不适合传统 DP |
|---|---|
| 单卡/小 TP 就能装下完整模型(如 7B、70B) | 超大 MoE(如 700GB),单副本都吃力,复制 N 份更不现实 |
| 目标是横向扩 QPS(多副本分担请求量) | 目标是解决"单副本装不下"——这需要 EP/DPA,不是靠多副本 |
| Llama 类 GQA 模型(KV head 多,TP 友好) | MLA 模型 + 长 KV decode(KV 重复问题严重,见下一节) |
问题背景:MLA 上大 TP 的 KV 重复
在介绍 DPA 之前,先讲清楚它要解决的问题:为什么 MLA 模型用大 TP 时 KV cache 会重复,以及为什么这特别伤 Decode。
理解了这一节,就能明白 DPA 为什么要把 Attention 从「大 TP」改成「按请求 DP」。
张量并行(TP)的常规做法
推理中最常见的并行策略是 张量并行(TP):把每一层的权重按某个维度切到多张 GPU 上,各卡算一部分再 all-reduce 汇总。对 GQA 类模型,TP 通常按 head 切,效果良好。
但对 MLA(Multi-Head Latent Attention)模型,TP 会出现一个根本性问题。
为什么 MLA 的 KV 切不开?
先回顾普通 GQA 的情况,再对比 MLA,就能看出差别。
GQA:KV 有多个 head,TP 按 head 切
GQA(Grouped-Query Attention)有多个 KV head(比如 num_kv_heads=8)。每个 KV head 是一组独立的 K/V 向量,彼此之间没有共享。做 TP 时,刚好可以把这些 KV head 分给不同 GPU:
num_kv_heads = 8,  tp_size = 8

GPU 0  存 KV head 0     (只算属于 head 0 的那部分 attention)
GPU 1  存 KV head 1
GPU 2  存 KV head 2
...
GPU 7  存 KV head 7

8 张卡加起来 = 1 份完整的 KV(被切开了,没有重复)
总 KV 显存 ≈ 1×
前提是 num_kv_heads >= tp_size,每卡至少能分到 1 个 KV head。这是 TP 对 GQA 友好的原因。
MLA:KV 是一份共享 latent,没有多个 head 可切
MLA(Multi-Head Latent Attention)的设计是先把 KV 压缩成一份 低秩 latent 向量(维度 ≈ kv_lora_rank,如 512),所有 Q head 都共享这一份 latent,再在 attention 时展开。
TP 切的是 Q head(Q 有很多个,可以切),但这份 KV latent 是 共享的、只有一份,没有"多个 KV head"可以分给不同卡。每张卡上都有部分 Q head,要算 attention 就需要完整的 KV latent → 每张卡都得存一份完整 KV。
kv_lora_rank = 512(一份共享 latent),  tp_size = 8

GPU 0  存 完整 KV latent     (因为本地有 Q head,需要完整 KV 才能算 attention)
GPU 1  存 完整 KV latent     (同样的原因,复制一份)
GPU 2  存 完整 KV latent
...
GPU 7  存 完整 KV latent

8 张卡加起来 = 8 份相同的 KV(重复了!)
总 KV 显存 ≈ 8× = tp_size ×
代码依据:SGLang 里 MLA 的
kv_a_proj是ReplicatedLinear(MQA 风格,每卡都复制),cache 的v_head_dim = kv_lora_rank;Q 的 head 才按attn_tp_size切开。
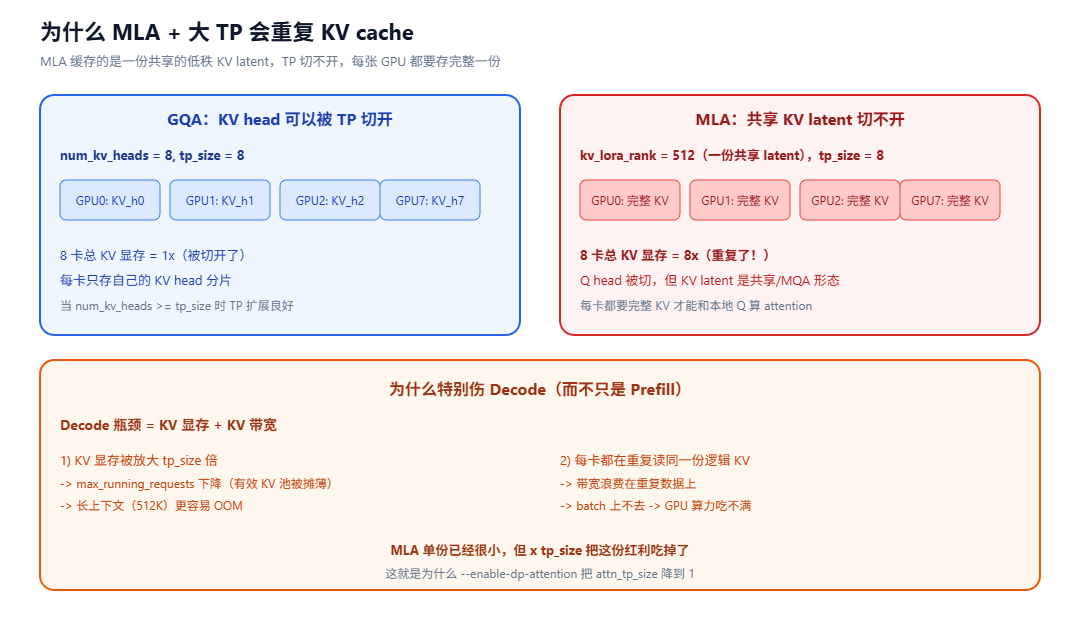
下图对比了 GQA 与 MLA 在 TP 下的 KV 放置差异:
| 模型类型 | TP 下 KV 总显存 | 原因 |
|-|-|-|
| GQA(num_kv_heads >= tp) | ≈ 1× | KV 有多个 head,按 head 切到各卡,不重复 |
| MLA / MQA(共享 latent) | ≈ tp_size × | KV 只有一份共享 latent,切不开,每卡复制一份 |
一句话:GQA 的 KV 有多个 head 能被 TP 切开,MLA 的 KV 是一份共享 latent 切不开,只能每卡复制一份。
为什么特别伤 Decode?
Decode 的瓶颈是 KV 显存 + KV 带宽,而非算力:
| 后果 | 原因 |
|---|---|
max_running_requests 下降 | 有效 KV 池被复制摊薄 |
| 长上下文(512K)先 OOM | KV 是显存大头 |
| 吞吐上不去 | batch 上不去 → GPU 算力吃不满 |
| 每卡重复读同一份逻辑 KV | 带宽浪费在重复数据上 |
| Prefill 更偏算力,所以「KV 重复」在 Decode 上尤其疼。 |
小结:问题与方向
问题:  MLA + 大 TP  →  KV latent 切不开  →  每卡复制  →  KV 显存 x tp_size
        特别伤 Decode(KV 是 decode 瓶颈)

方向:  别在 Attention 上用大 TP
        改成按请求做 DP(每卡拥有不同请求的 KV)
        → 这就是 DPA
下一节介绍的 DPA,正是为了解决这个问题:把 Attention 从「大 TP 切 head」改成「按请求 DP 分 KV」,让 KV 不再跨 TP 复制。
数据并行 Attention(DPA)
数据并行 Attention(DPA),亦称 DP Attention,是一种高级并行策略。DPA 对 Multi-Head Latent Attention(MLA) 模型(如 DeepSeek、MiniMax、Kimi-K2)收益最大,同时也支持 Qwen 等 标准 attention 模型。
上一节我们看到,MLA + 大 TP 会导致 KV cache 重复 × tp_size,特别伤 Decode。DPA 的核心思路就是:不在 Attention 上用大 TP,改成按请求做数据并行——每张卡拥有不同请求的 KV,互不重复。
DPA 如何工作
DPA 通过对 attention 组件专门应用数据并行 来克服上述限制。
核心公式
attn_tp_size = tp_size / dp_size / attn_cp_size
公式里三个量的含义:
| 变量 | 含义 | 默认值 | 怎么设 |
|---|---|---|---|
tp_size | world_size,这个分布式组的总 GPU 数(CLI --tp-size) | — | 按硬件拓扑设 |
dp_size | Attention 侧的数据并行度(CLI --dp-size) | 1 | 开 DPA 时设 > 1 |
attn_cp_size | Attention 上下文并行度(CLI --attention-context-parallel-size) | 1 | 长序列切分 attention 计算时设 > 1 |
attn_tp_size | 真正的 Attention 张量并行度(由公式算出,不是直接设) | — | 派生量 |
attn_cp_size是什么? 它是 Attention Context Parallelism(注意力上下文并行),把一个超长序列的 attention 计算按序列维度切到多张卡上(而不是按 head 切)。主要用于超长上下文 prefill 场景(比如百万 token),单卡算不下整段 attention 时用它分摊。大多数场景用不到,保持默认 1 即可,公式里就简化为attn_tp_size = tp_size / dp_size。
开启 DPA 后,CLI 的--tp-size实际表示 world_size(总 GPU 数),而真正的 Attention TP 由上式算出。代码依据见python/sglang/srt/layers/dp_attention.py:
attn_dp_size = dp_size if enable_dp_attention else 1
attn_tp_size = tp_size // attn_dp_size // attn_cp_size
server_args.py 中也有注释:# The tp_size is the world size, not the real tensor parallel size。
三种典型配置
下图展示了同一组 8 GPU 下的三种配法: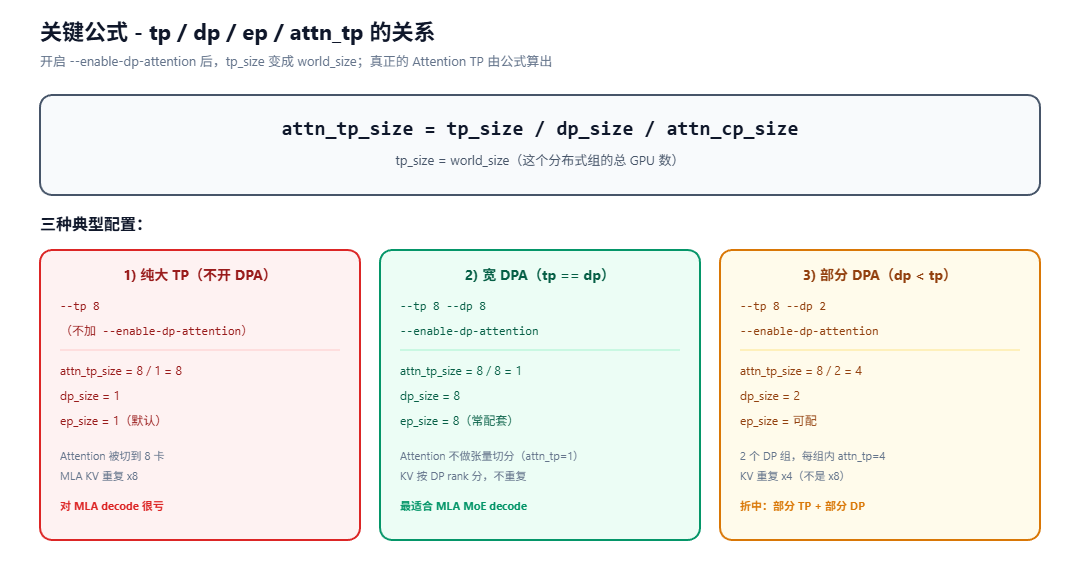
| 配置 | 命令 | attn_tp | KV 重复 | 适用 |
|---|---|---|---|---|
| 纯大 TP | --tp 8 | 8 | ×8 | 不推荐 MLA decode |
| 宽 DPA | --tp 8 --dp 8 --enable-dp-attention | 1 | 不重复 | MLA MoE decode(推荐) |
| 部分 DPA | --tp 8 --dp 2 --enable-dp-attention | 4 | ×4 | 折中 |
关键理解:DPA 不是「和(大)TP 一起用」,而是 借用
tp_size当 world,用来削弱或取代 Attention 大 TP。宽 DPA 时attn_tp=1,Attention 完全不做张量切分。
DPA 架构与数据流
下图展示一次 Decode step 中,请求如何在 DPA + EP 下流动: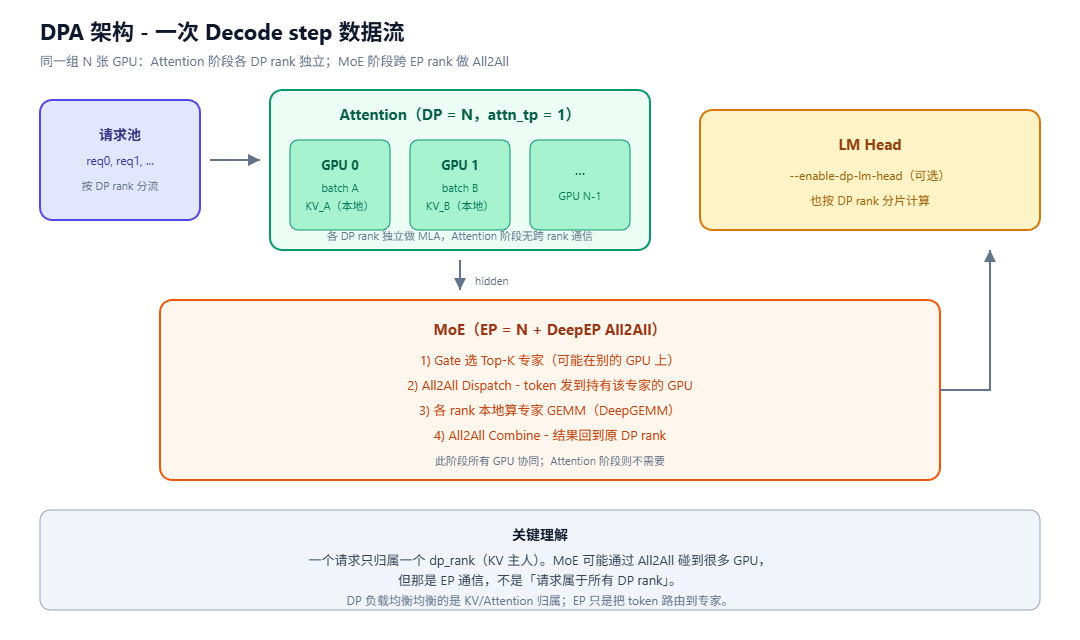
要点:
- 请求归属唯一:每个请求钉在 某一个
attn_dp_rank,该 rank 存 KV、做 MLA。 - Attention 阶段独立:各 DP rank 互不通信,可处于不同 forward 状态(prefill / decode / idle)。
- MoE 阶段协同:Top-K expert 可能在别的卡上 → DeepEP All2All 把 token 送过去再拉回来。这是 EP 通信,不是「请求属于所有 DP」。
- LM Head 可选
--enable-dp-lm-head,也按 DP 分片计算。
启用 DPA 时,在 server 启动命令中加入 --enable-dp-attention。
激活逻辑
DPA 通过 server 参数(CLI 或 config)显式启用。须同时设置 --dp-size 与 --enable-dp-attention:
python -m sglang.launch_server \
    --model-path deepseek-ai/DeepSeek-V3 \
    --tp 8 \
    --dp-size 8 \
    --enable-dp-attention
重要:--dp-size 须大于 1 DPA 才能生效。当 dp_size == 1(默认)时,--enable-dp-attention 会自动禁用。还须满足约束 tp_size % dp_size == 0。
MLA 模型的标准 DP
MLA 模型当然也可使用标准 DP。若要对 MLA 模型启用标准 DP:先独立启动各 MLA 模型副本(可逐个启动并启用 DPA);各副本启动后,再启动 SMG 并将所有副本接入 SMG。SMG 的详细说明见下文。
DPA 与传统 DP 可以嵌套
对 MLA 大模型,常见生产形态是 内层 DPA + 外层传统 DP: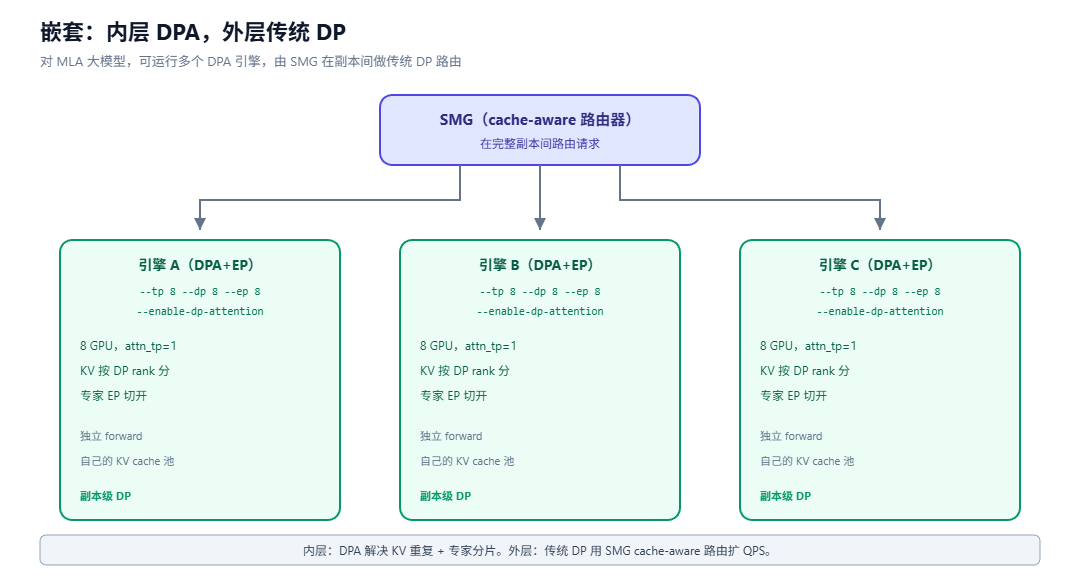
- 内层(引擎内):DPA + EP 解决「装得下 + KV 不爆」
- 外层(引擎间):多个 DPA 引擎作为完整副本,SMG 做 cache-aware 路由扩 QPS、容错
SMG
 ├─ Engine A: --tp 8 --dp 8 --ep 8 --enable-dp-attention   ← 内部 DPA+EP
 ├─ Engine B: 同上配置                                       ← 独立副本
 └─ Engine C: 同上配置                                       ← 独立副本
这种嵌套让两层各司其职:DPA 管单引擎内的并行效率,SMG 管副本间的吞吐与可靠性。
SGLang Model Gateway(SMG)
前面讲的是「引擎内」的并行(DPA/EP)。当需要横向扩 QPS 时,可以运行多个完整引擎副本,由 SGLang Model Gateway(SMG) 在副本间做路由。SMG 是 Rust 实现的生产级路由器,支持 cache-aware 路由、健康检查、熔断、Prometheus 指标等,是生产部署的推荐方案。
SMG 的详细配置(启动方式、负载均衡策略、监控、K8s 集成等)可以直接看sglang官方文档。
一句话区分:DPA/EP 是「一个引擎内部」怎么切模型;SMG 是「多个引擎副本之间」怎么分发请求。两者可以嵌套使用(内层 DPA+EP,外层 SMG 多副本)。
参考
| 策略 | 使用场景 | 主要收益 |
|---|---|---|
| 传统 DP | 小中模型,扩 QPS | 整模复制,副本间不通信 |
DPA(--dp-size N --enable-dp-attention) | DeepSeek/MLA 模型 | 消除 KV cache 重复,提升吞吐 |
| DPA + EP | DeepSeek/GLM 大 MoE 模型 | 相对 vanilla TP 显著吞吐提升 |
| SMG | 多副本生产部署 | 副本间 cache-aware 路由(详见专文) |
| DeepSeek 推荐生产配置: |
- 为 attention 层启用 DPA(
--dp-size 8 --enable-dp-attention) - 为 MoE 层启用 EP(
--ep 8 --moe-a2a-backend deepep) - 多副本时使用 SMG
阅读导航



