
KV Cache 显存使用率:OOM、排队与尾延迟风险
KV Cache 已使用显存比例为什么决定 OOM 和排队风险
KV Cache 已使用显存比例之所以能反映 OOM 和排队风险,是因为它代表了推理服务还剩多少可接纳新 token 和新请求的容量。
模型权重通常是固定的,而 KV Cache 会随着活跃请求数和上下文长度持续增长:
KV Cache 占用
≈ 活跃请求数
× 每个请求当前 token 数
× 每 token 的 KV 显存
下面这张图先给出全文最重要的直觉:模型权重像已经固定摆放在仓库里的设备,KV Cache 则像不断进入仓库的货物。每生成一个 token,就要再占用一点货架;请求完成后,对应货架才会释放。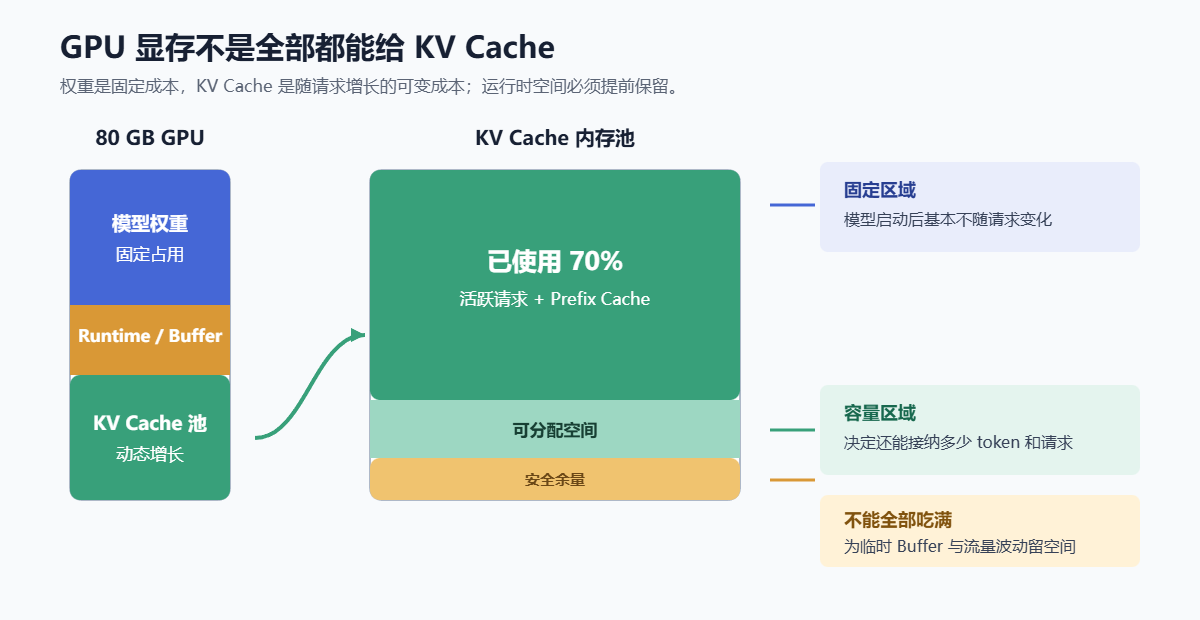
KV Cache 只占 GPU 总显存的一部分,但它是决定请求容量的主要动态区域。
例如,一台实例留给 KV Cache 的空间是 50GB,每个长请求最终需要 2.5GB:
当前已有 18 个请求
KV 已用 = 18 × 2.5GB = 45GB
KV 使用率 = 90%
剩余空间 = 5GB
此时最多只能再容纳约 2 个同等长度的请求。问题在于,请求不是一开始就占满 2.5GB,它会在生成过程中持续增长;而且新请求可能带着更长的 Prompt 进来。因此仅剩 5GB 时,服务已经非常接近容量边界。
1. 先区分总显存和 KV Cache 显存池
GPU 总显存并不全部属于 KV Cache。真实显存构成通常是:
GPU 总显存
= 模型权重
+ KV Cache
+ Attention / GEMM Workspace
+ CUDA Graph 预留
+ NCCL 等通信 Buffer
+ CUDA Runtime
+ 框架元数据与显存碎片
为了避免运行时临时申请显存失败,推理框架一般会为 KV Cache 划分一个受限的内存池,而不是任意使用全部剩余显存。
因此需要区分两个指标:
GPU 总显存使用率
KV Cache 池使用率
前者用于观察整张 GPU 的压力;后者更直接反映调度器还能否接纳新的 token 和请求。
读图时要特别注意“安全余量”:它不是浪费,而是为临时 Workspace、通信 Buffer、请求突增和长度预测误差预留的缓冲区。如果把它也分给 KV Cache,系统在静态压测中可能表现很好,却会在线上突发流量时突然 OOM。
2. 为什么 KV Cache 会导致 OOM
每当一个请求进行 Prefill 或生成一个新 token 时,系统都需要为其 KV Cache 分配空间。
对已有请求而言:
继续 Decode
-> 新生成一个 token
-> 为该 token 申请新的 KV Block
-> 写入该 token 在所有 Transformer 层的 K 和 V
对新请求而言:
新请求到达
-> 执行 Prefill
-> 为输入 Prompt 的 token 分配 KV Block
-> 之后 Decode 仍会持续申请新的 KV Block
如果没有足够的 KV Block:
请求继续生成
-> 需要新 KV Block
-> KV Cache Pool 已满
-> 无法分配显存
-> OOM、请求失败、抢占或重算
Paged Attention 能减少碎片、提高实际可用容量,但不能创造额外显存。KV Cache 池真的满了,系统仍然无法继续容纳 token。
为什么 KV 使用率不是 100% 才可能 OOM
即使 KV Cache 显示只用了 90%,仍可能发生 OOM,主要有三类原因。
第一类是运行时临时显存。Attention、GEMM、CUDA Graph、采样或通信都可能需要临时 Buffer;如果没有预留足够空间,临时分配也可能失败。
第二类是显存碎片。系统的总剩余显存看起来足够,但未必存在满足某次分配需要的可用块。Paged KV 能缓解 KV 内部碎片,但不能覆盖全部运行时分配模式。
第三类是并发增长。许多请求会同时进入下一轮 Decode,当前的 KV 使用率只是瞬时值;调度器若接受了太多尚未完成的请求,下一轮申请新 Block 时可能同时触顶。
这也是为什么生产服务不应把显存长期顶到 100%,通常要为运行时开销和请求长度波动保留余量。
3. 为什么 KV Cache 高使用率会导致排队
当剩余 KV 空间不足以安全容纳一个新请求时,调度器通常不会立刻让它进入 GPU 执行,而是等待已有请求完成后释放 KV Cache:
新请求到达
-> 调度器估算本轮所需 KV Block
-> 当前可用 Block 不够
-> 新请求不进入执行 batch
-> 请求停留在 waiting queue
-> Queue Time 上升
-> TTFT 上升
所以会出现一种现象:GPU 似乎还没有完全满载,但用户的首 token 时间已经明显变差。根因不是 GPU 完全没有空闲,而是推理引擎没有足够的 KV 容量来安全接纳新请求。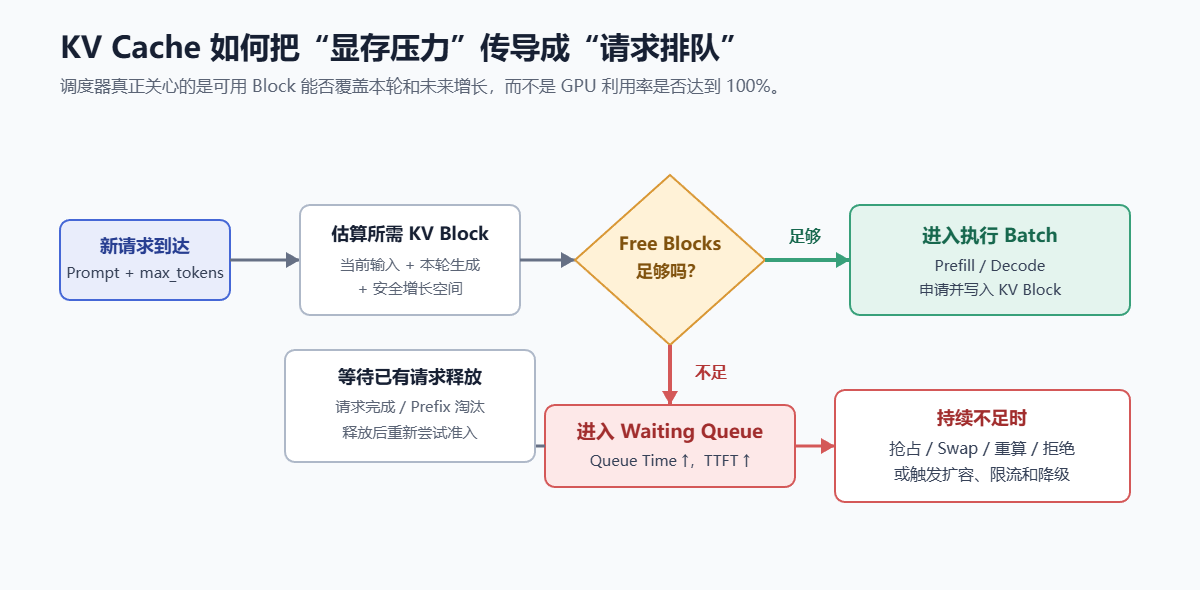
请求能否进入执行 batch,取决于调度器能否拿到足够的 KV Block。拿不到时,请求先进入 Waiting Queue,而不是继续盲目申请显存。
调度器为什么不能只看当前占用
假设一个请求当前只处理了 1,000 token,但业务允许它达到:
输入 6,000 token
+ 最大输出 2,000 token
= 最多 8,000 token
如果系统只按当前的 1,000 token 占用来接纳大量请求,后续所有请求一起 Decode 时会争抢 KV 空间,最终导致 OOM 或频繁抢占。
因此,可靠的调度器通常会基于当前可用 KV Block、即将执行的 token 数、请求的生成上限和调度策略做准入控制,而不是只看一个当前使用率数字。
下面的时间线说明了为什么“当前还有空间”不等于“未来有空间”。A、B、C 三个请求在 Decode 中持续增长,总 KV 占用不断逼近上限。新请求 D 到达时,即使 GPU 仍在工作,它也只能等 A 完成并释放 Block。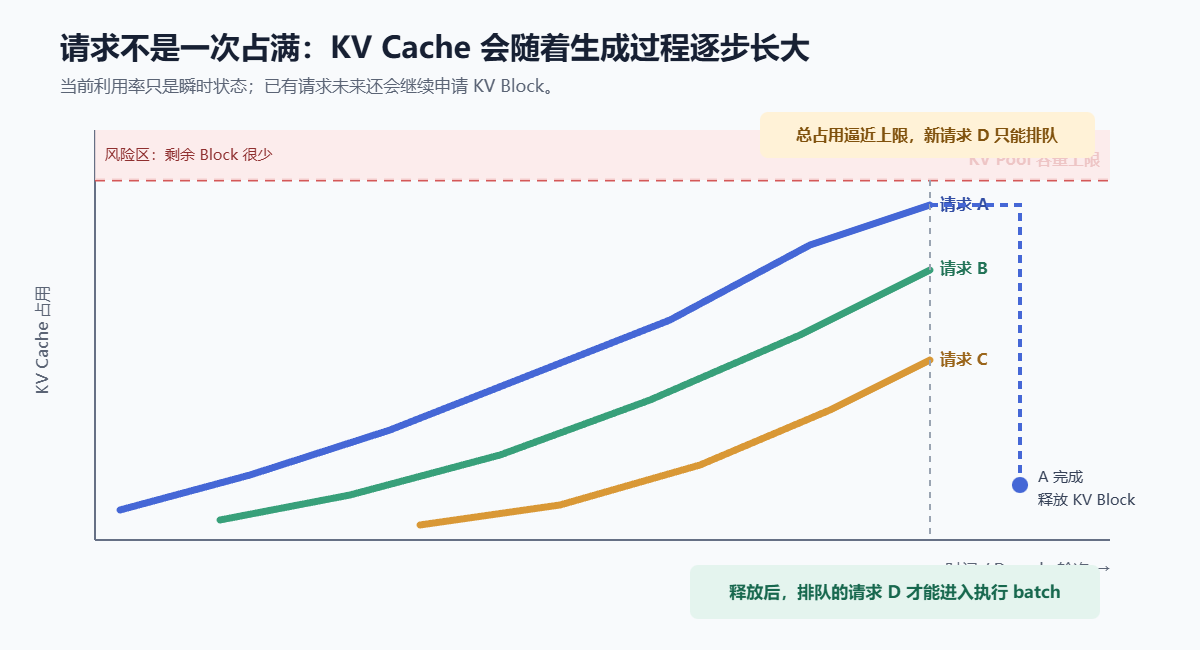
KV Cache 是随生成进度增长的状态。容量规划必须考虑活跃请求的未来增长,而不只是当前水位。
4. 为什么高 KV 使用率会拉高 P95 和 P99
即使没有 OOM,高 KV 使用率也常导致尾延迟恶化:
KV 接近满
-> 新请求难以进入 batch
-> 等待时间增加
-> 长请求占据 slot 更久
-> 短请求被长请求拖住
-> 活跃请求更多,单轮 Decode 更拥挤
-> TPOT 和 TTFT 的尾延迟上升
这里需要区分两种延迟:
| 延迟 | 高 KV 使用率造成的典型影响 |
|---|---|
| TTFT | 新请求无法进入 Prefill / Decode batch,排队时间增长 |
| TPOT | 活跃序列更多,单轮 Decode 更重;Prefill 争抢资源时输出也可能卡顿 |
| E2E | TTFT 和 TPOT 任一恶化都会拉长总请求时间 |
| 长请求会占用更多 KV Block,并且持续更久。若短请求与长请求共用一个队列和 KV 池,短请求也会被长请求挤压,这就是尾延迟明显大于平均延迟的常见原因。 | |
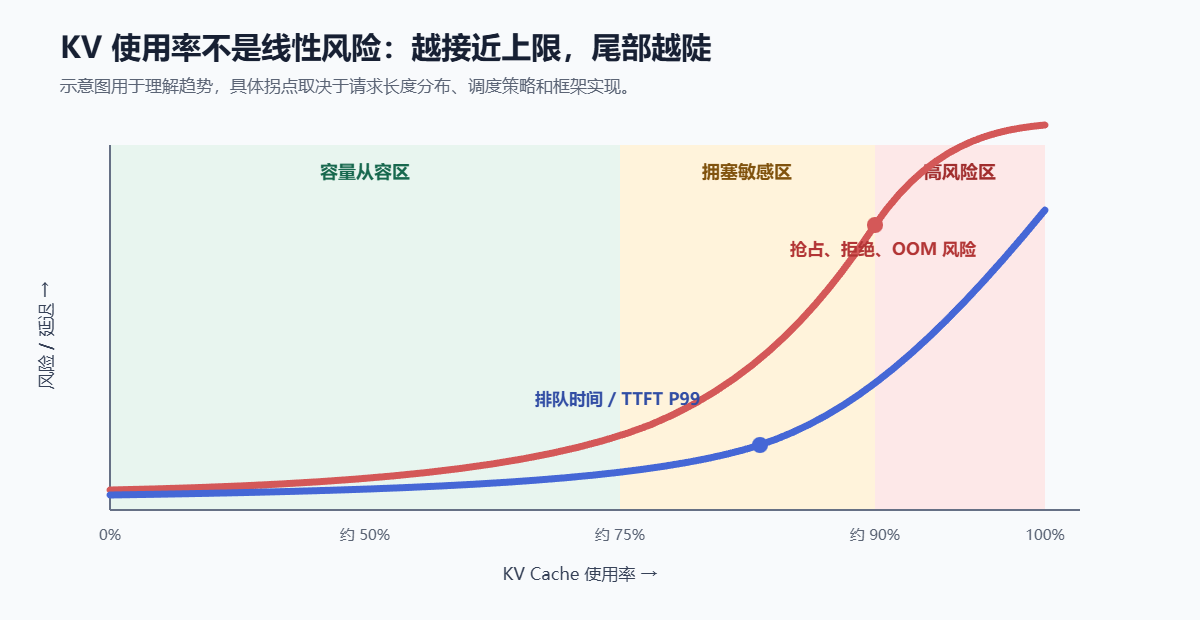 | |
| 风险通常不是线性增长。进入容量边界后,少量流量或上下文增长就可能让 Queue Time、TTFT P99 和抢占次数快速上升。 |
5. 抢占、Swap 与重算会发生什么
部分推理框架在 KV 不足时不会立刻让请求失败,而会采用抢占策略:
暂停部分请求
-> 释放其 KV Cache
-> 让高优先级或新请求先执行
-> 被暂停请求后续恢复
恢复方式可能包括将 KV Cache 放到 CPU 内存、再传回 GPU,或直接重新执行 Prefill。后者可概括为重算:
释放请求 A 的 KV Cache
-> 请求 A 稍后恢复
-> 重新处理它的历史 Prompt
-> 重建 KV Cache
这能避免立即失败,但代价是:
- 被抢占请求的 TTFT 或 E2E 延迟大幅升高。
- 重算会增加 GPU Prefill 负载。
- 额外负载会进一步加剧排队。
- 极端情况下可能形成拥塞循环。
因此,出现频繁抢占、Swap 或重算时,不能将它当作正常吞吐能力的一部分。它通常是容量不足、请求长度失控或调度策略不匹配的信号。
6. 一个完整的容量示例
假设:
KV Cache 可用池:50GB
每个请求当前平均占用:1.5GB
每个请求最终可能增长到:2.5GB
当前活跃请求数:24
当前占用:
24 × 1.5GB = 36GB
KV 使用率 = 72%
表面上看还剩 14GB,似乎可以继续接纳 9 个平均请求。
但若现有 24 个请求都继续增长到最终长度:
24 × 2.5GB = 60GB
已经超过 50GB 的 KV 池。
这说明只按当前利用率评估容量是不够的。需要同时考虑:
活跃请求数
当前上下文长度分布
最大输出长度
未来 token 增长速度
长请求比例
Prefix Cache 占用
调度器的准入和抢占策略
7. 如何正确监控
不要只盯着 KV 使用率一个数字。至少一起看:
KV Cache Usage %
KV Free Blocks
Waiting Queue Length
Queue Time P95/P99
Active Sequences
Preempted Requests
Swapped Requests
Recomputed Tokens
OOM / Rejected Requests
TTFT P95/P99
请求输入、输出、上下文长度分布
它们之间的关系可以概括为:
KV Free Blocks 下降
-> 新请求准入受限
-> Waiting Queue 上升
-> Queue Time 上升
-> TTFT P95/P99 上升

KV Pool 耗尽
-> 抢占 / Swap / 重算 / 拒绝请求
-> 或显存分配失败
-> 服务稳定性下降
8. 使用率阈值应如何理解
下面是常用的经验区间,而不是固定规则:
| KV 使用率 | 常见状态 |
|---|---|
| < 60% | 通常比较从容 |
| 60% - 80% | 正常高负载,需要观察长度分布 |
| 80% - 90% | 接近容量边界,应重点看 Queue Time 和 P99 |
| > 90% | 长请求或流量突发时容易排队、抢占或拒绝请求 |
| 这些阈值必须结合请求分布解释: |
- 请求长度稳定、输出上限较低时,90% 可能仍能稳定运行。
- 输入长度差异很大,且有 32k、128k 长尾请求时,即使 70% 也可能存在明显风险。
- 若 Prefix Cache 占用大且频繁失效,瞬时容量变化会更大。
- 若系统需要滚动发布或容忍一个副本故障,长期高利用率会使冗余失效。
真正应该看的是:剩余 KV 容量能否覆盖未来一段时间的请求增长,而不是当前瞬时使用率。
因此,真正需要寻找的不是某个通用的 80% 或 90% 数字,而是自己服务的“拥塞拐点”。这个拐点要通过真实长度分布的并发爬坡压测得到:当 Output TPS 不再明显增长,而 Queue Time、TTFT P99 或抢占次数开始陡升时,就已经超过了适合长期运行的容量区间。
9. 工程上的应对措施
当 KV Cache 长期处于高水位时,优先按以下顺序处理:
- 限制最大上下文和最大输出长度,先控制最直接的 KV 增长来源。
- 将短请求与长上下文请求隔离到不同队列或不同实例池。
- 启用 Paged KV Cache,减少分配和碎片浪费。
- 使用 Chunked Prefill,避免超长 Prompt 突然吞掉大量 KV 和计算资源。
- 使用 Prefix Cache,但为其容量和失效行为设置观测。
- 评估 FP8 / INT8 KV Cache 量化,并用真实业务评测验证质量。
- 降低
max_num_seqs或设置更保守的 token budget,优先保护 P95/P99。 - 横向增加推理副本,用 Data Parallel 分散活跃请求。
- 设置基于 token、上下文长度和租户优先级的限流,而不是只按 QPS 限流。
10. 总结
KV Cache 已使用显存比例越高,系统可接纳的新请求和新 token 越少。当剩余空间不足时,调度器只能让请求排队、抢占旧请求、执行重算,或最终触发显存分配失败。
因此,KV Cache 使用率并不只是一个显存图表指标。它直接连接了以下问题:
上下文长度
并发能力
请求准入
Queue Time
TTFT
TPOT 尾延迟
抢占和重算
OOM 风险
实例扩容需求
生产环境应将它与 KV Free Blocks、排队时间、活跃序列、请求长度分布和抢占次数一起监控,才能判断服务是真正健康,还是只是暂时没有 OOM。
阅读导航



