
KV Cache 显存计算:注意力布局与 DeepSeek 示例
大模型 KV Cache 占用多少显存?从零讲透,用 DeepSeek-V4-Flash 走一遍
这篇文档面向第一次接触 KV cache 的读者。读完之后你会:理解 KV cache 为什么存在、它的字节到底由哪些因子决定、为什么不同模型算法完全不同、并能自己手算 DeepSeek-V4-Flash 在 1M 上下文下的 KV cache 占用。
参考工具:kvcache.ai KV Cache Size Calculator、LMCache 计算器(本文公式与这两个工具一致)。
阅读地图
文章按"为什么 → 是什么 → 怎么算 → 实例 → 避坑"的顺序展开:
- 为什么会有 KV cache —— 用显存换计算时间
- Attention 的 K 和 V 是什么 —— 三个向量的角色
- 标准公式 —— MHA/GQA/MQA 通用算法
- 三种注意力头布局 —— 为什么 KV 头数能省显存
- DeepSeek-V3 的 MLA —— 把 KV 压进低秩潜空间
- DeepSeek-V4 的混合注意力 —— 三种层各管一段
- V4 的压缩比地图 —— 看懂 compress_ratios(44 个条目)
- V4 的混合精度 —— 一条 entry 拆三段各用不同精度
- V4-Flash 完整计算 —— 5 步算出 1M token 的占用
- 不同场景的结果表 —— batch 和上下文怎么影响
- 常见误区 —— 5 个最容易踩的坑
- 动手算的 6 步清单 —— 拿到任意模型都能算
1. 为什么会有 KV Cache
大模型生成文本时是"一个 token 一个 token"往外吐的。每生成第 N 个 token,模型都要"看"前面所有的 token,才能决定下一个该是什么。这个"看"的过程就是 Attention。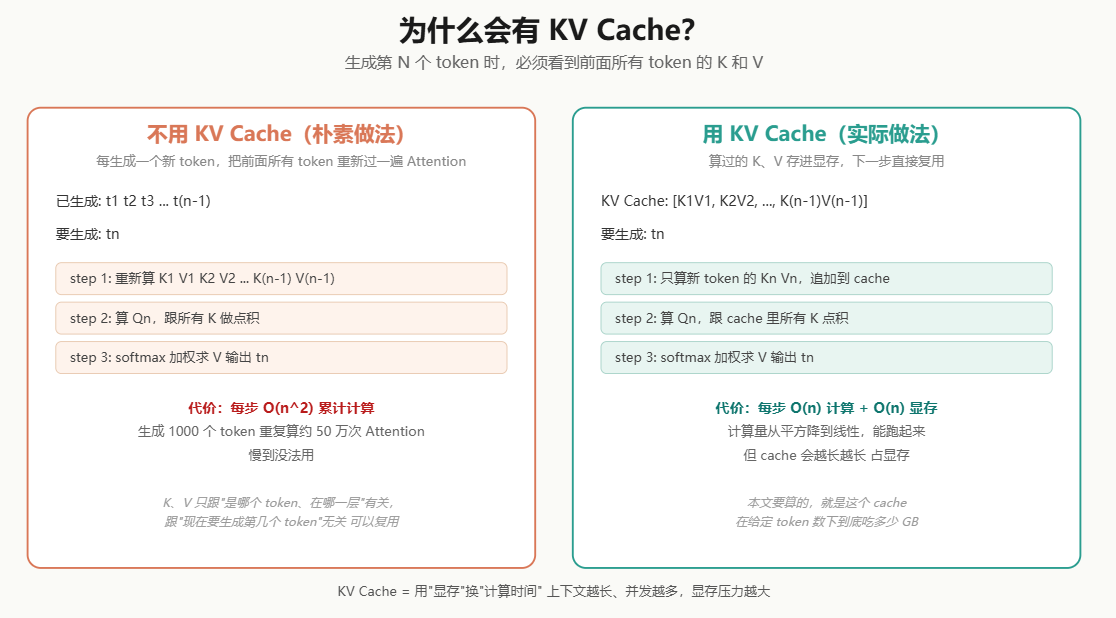
关键观察:每个 token 在每一层算出的 K(Key)和 V(Value)只跟"它是哪个 token、在哪一层"有关,跟"现在要生成第几个 token"无关。所以一旦算出来,后面每一步都能复用,没必要重算。
把算过的 K、V 存进显存反复用 = KV Cache。代价是显存:上下文越长、并发越多,cache 越大。本文要算的就是这个 cache 在给定 token 数下到底吃多少 GB。
2. Attention 的 K 和 V 到底是什么
每个已输入的 token 在每一层都会被三个不同的"投影矩阵"变换,得到三份向量:
- Q(Query,查询):当前 token "在找什么"
- K(Key,键):这个 token "是什么",用来被别人匹配
- V(Value,值):这个 token "要传出去的内容"
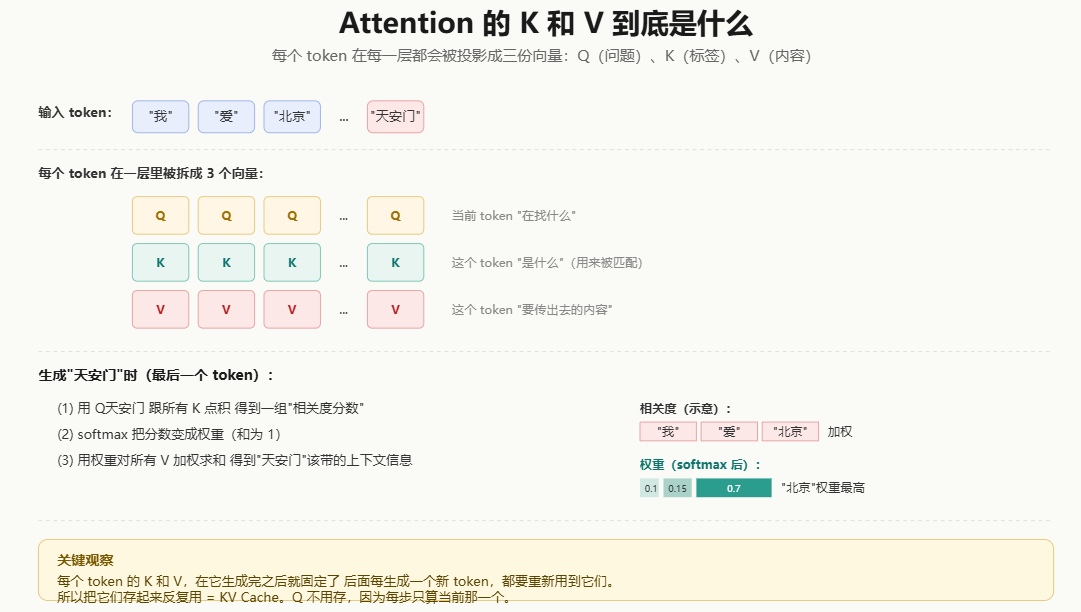
一个关键区分:Q 属于"当前要预测的位置的上一个 token",K、V 属于所有已输入的历史 token。比如上下文是"我 爱 北京",要预测下一个 token(假设是"天安门"),那么"天安门"此刻还不是输入、没有 Q/K/V;真正用来召唤它的是"北京"的 Q——它去跟"我/爱/北京"的 K 点积、softmax 得权重、对 V 加权求和,输出向量再过 LM head 才预测出"天安门"。等"天安门"被生成出来进入上下文后,它才会被算出自己的 K/V(存进 cache),它的 Q 则用来预测再下一个 token。
为什么只缓存 K 和 V,不缓存 Q? 因为每一步只算当前那一个 token 的 Q(用完就丢),但所有历史 token 的 K、V 都要被反复用到。所以缓存 K、V 才有意义。
3. 标准公式:每个因子在数什么
对于最常见的 MHA / GQA / MQA 注意力,KV cache 的字节总数是一个连乘: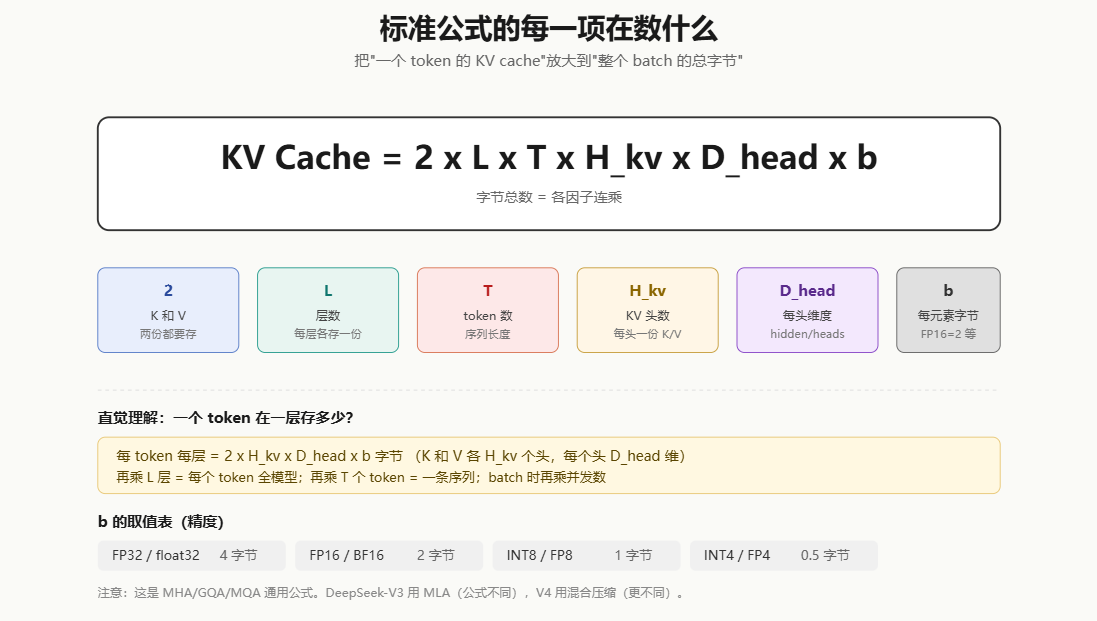
KV Cache(字节) = 2 × L × T × H_kv × D_head × b
每一项的含义:
| 因子 | 含义 | 直觉 |
|---|---|---|
2 | K 和 V 各存一份 | 两份张量 |
L | 层数(num_hidden_layers) | 每层各存一份 |
T | token 数(序列长度) | 每个 token 都要存 |
H_kv | KV 头数(num_key_value_heads) | 每个头一份 K/V |
D_head | 每头维度 = hidden_size / num_attention_heads | 每头多少维 |
b | 每个元素的字节数 | 由精度决定 |
精度 b 的取值:FP32 = 4 字节、FP16/BF16 = 2 字节、INT8/FP8 = 1 字节、INT4/FP4 = 0.5 字节。量化能直接把 KV cache 砍一半甚至更多。 |
直觉理解:先算"一个 token 在一层存多少"(2 × H_kv × D_head × b),再乘 L 层得到"一个 token 全模型存多少",再乘 T 个 token 得到"一条序列存多少",batch 时再乘并发数。
4. 三种注意力头布局:MHA / GQA / MQA
标准公式里 H_kv(KV 头数)是关键变量。不同模型架构让 KV 头数从"和 Q 头一样多"减到"只有 1 个",KV cache 随之缩小: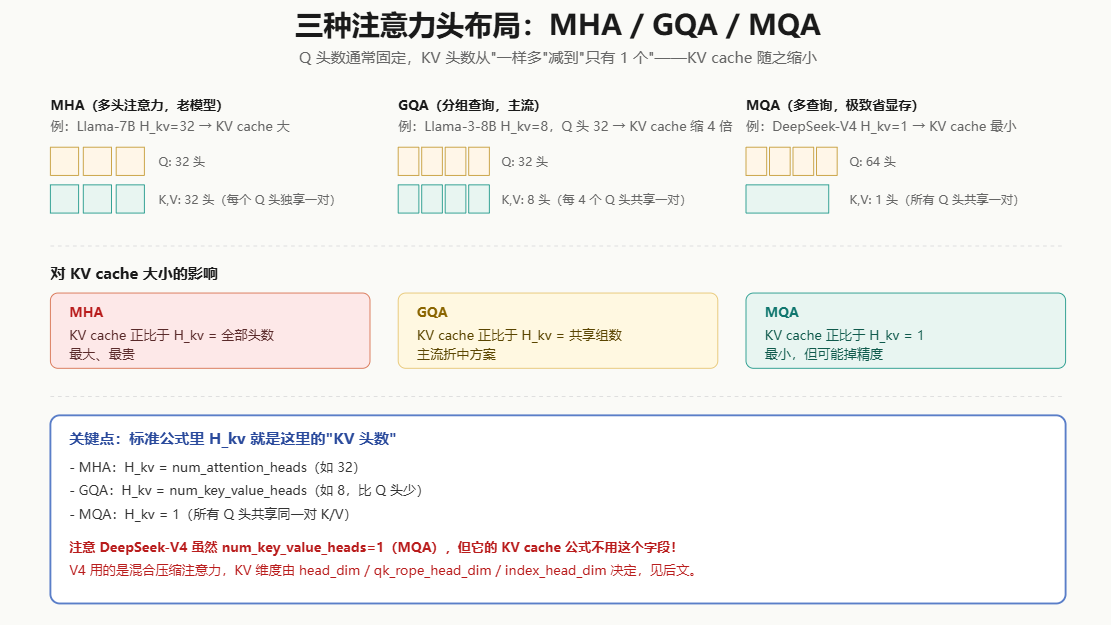
- MHA(多头注意力):每个 Q 头独享一对 K/V,
H_kv = num_attention_heads(如 32)。KV cache 最大。代表:早期 Llama、GPT。 - GQA(分组查询注意力):几个 Q 头共享一对 K/V,
H_kv < num_attention_heads(如 Q=32, KV=8)。KV cache 缩 4 倍。代表:Llama-3、Qwen。 - MQA(多查询注意力):所有 Q 头共享同一对 K/V,
H_kv = 1。KV cache 最小,但可能掉一点精度。代表:DeepSeek-V4。
重要提醒:DeepSeek-V4 虽然
num_key_value_heads=1(属于 MQA),但它的 KV cache 公式根本不用这个字段。V4 用的是混合压缩注意力,KV 维度由head_dim、qk_rope_head_dim、index_head_dim决定。下面会详细讲。
5. DeepSeek-V3 的 MLA:把 KV 压进低秩潜空间
V3 没有走"减少 KV 头数"这条路,而是用了 MLA(Multi-head Latent Attention):不存原始 K/V,只存一个低维"潜向量",用时再上投影还原。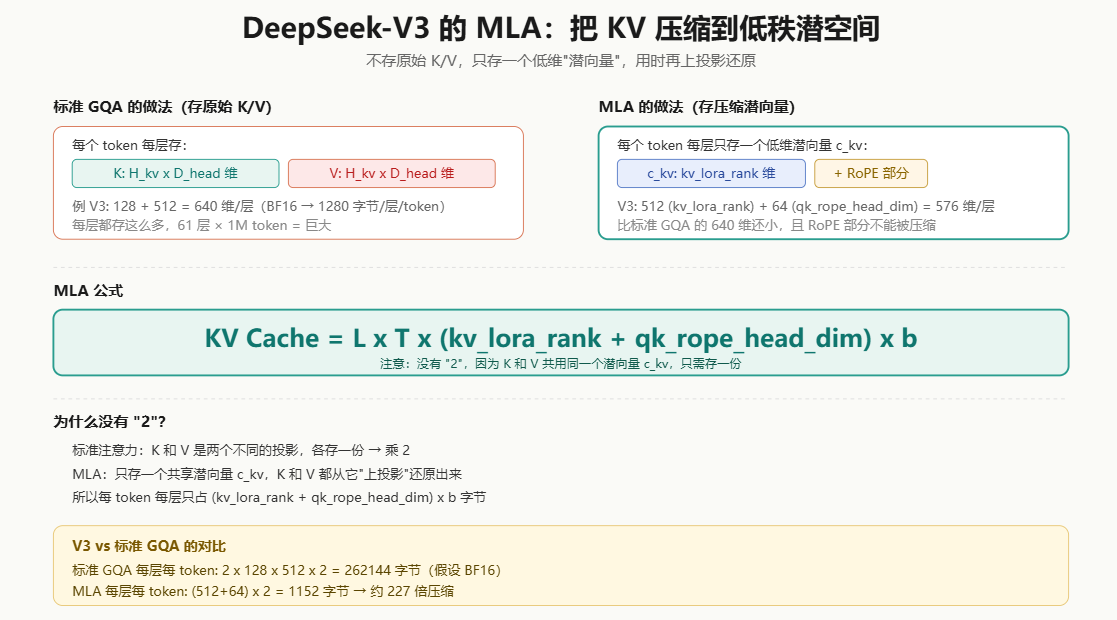
MLA KV Cache = L × T × (kv_lora_rank + qk_rope_head_dim) × b
注意没有 "2":标准注意力 K 和 V 是两个不同投影,各存一份要乘 2;MLA 里 K 和 V 共用同一个潜向量 c_kv,只需存一份。
V3 的数字:kv_lora_rank=512、qk_rope_head_dim=64,所以每层每 token 存 (512+64) × 2 = 1152 字节(BF16)。对比标准 GQA 的 2 × 128 × 512 × 2 = 262144 字节,约 227 倍压缩。
为什么 RoPE 部分单独算?因为旋转位置编码(RoPE)对精度敏感、不能被低秩压缩,所以这部分维度原样存,其余压进潜空间。
6. DeepSeek-V4 的混合注意力:三种层各管一段
V4 又换了一套思路:不是所有层都用同一种注意力,而是按层分配三种注意力,每种对长程信息的处理方式不同,KV cache 大小也完全不同。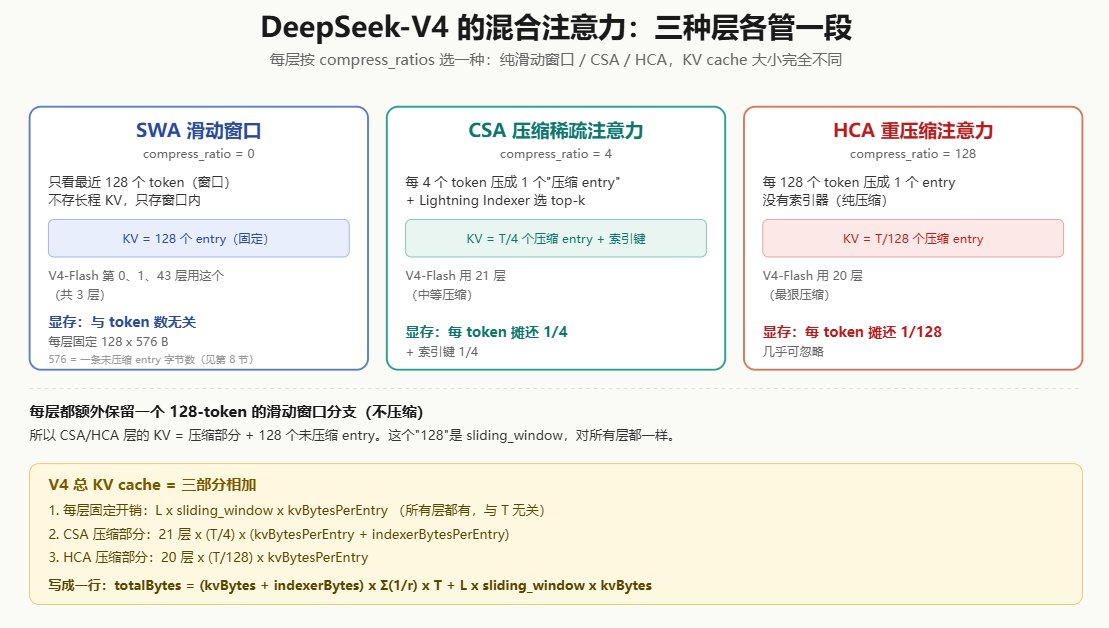
- SWA(滑动窗口注意力,
compress_ratio=0):只看最近 128 个 token,不存长程 KV。每层固定 128 个未压缩 entry,与 token 数无关。 - CSA(压缩稀疏注意力,
compress_ratio=4):每 4 个 token 压成 1 个"压缩 entry",再用 Lightning Indexer 选 top-k。每 token 摊还1/4份压缩 KV +1/4份索引键。 - HCA(重压缩注意力,
compress_ratio=128):每 128 个 token 压成 1 个 entry,没有索引器。每 token 摊还1/128份压缩 KV,几乎可忽略。
关于 576 这个数:图里出现的
576 B是一条未压缩 KV entry 在 V4 混合精度下的字节数,等于(head_dim − qk_rope_head_dim) × 1 + qk_rope_head_dim × 2 = (512−64)×1 + 64×2 = 576。NoPE 部分(448 维)用 FP8,RoPE 部分(64 维)用 BF16。这个拆分的完整说明在第 8 节,SWA/CSA/HCA 三种层里"未压缩 entry"都用这个同一个 576。
关键细节:每层(不管哪种)都额外保留一个 128-token 的未压缩滑动窗口分支,用来保留近期细节。所以 CSA/HCA 层的 KV = 压缩部分 + 128 个未压缩 entry。
V4 总 KV cache 由三部分相加:
totalBytes = (kvBytesPerEntry + indexerBytesPerEntry) × Σ(1/r) × T
           + L × sliding_window × kvBytesPerEntry
- 第一项:所有压缩层的长程 KV,按各自的压缩比摊还
- 第二项:所有层的滑动窗口固定开销,与 T 无关
7. V4-Flash 的压缩比地图
V4-Flash 的 config.json 里有一个 compress_ratios 数组,每个数字告诉那一层用哪种注意力。注意:num_hidden_layers=43(transformer 层),但 compress_ratios 有 44 个条目——多出来的 1 个是 MTP(Next-N 预测)层,它也有自己的注意力,所以 LMCache 计算器用 compress_ratios.length = 44 作为层数: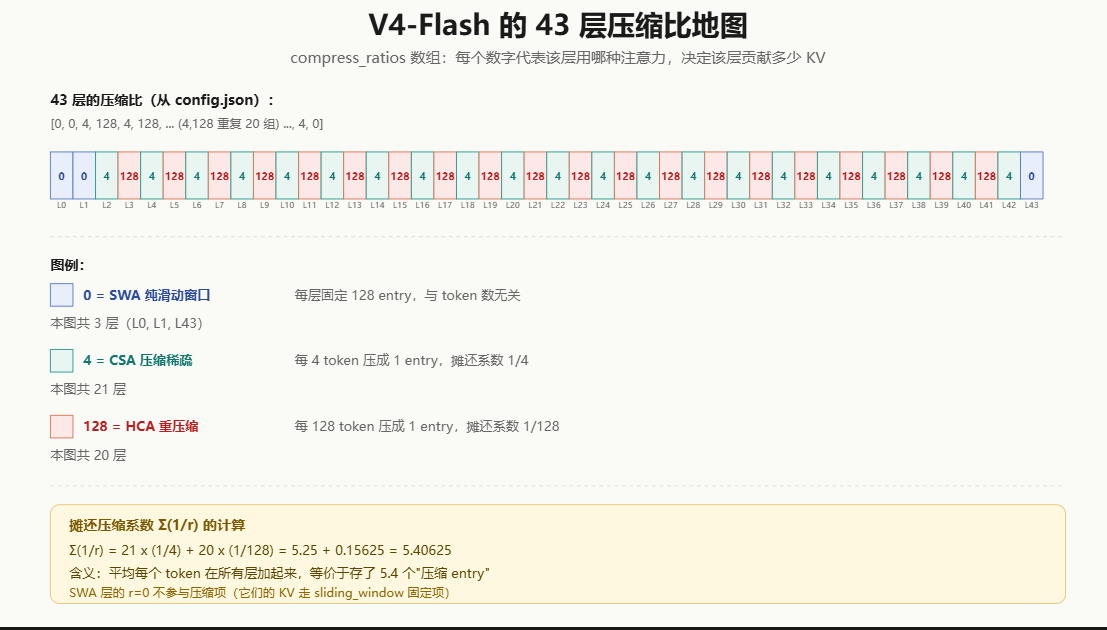
compress_ratios = [0, 0, 4, 128, 4, 128, 4, 128, ..., 4, 128, 4, 0]
                   L0 L1 L2  L3  L4  L5 ...             L41 L42 L43
模式:开头 2 层 SWA(L0、L1),中间 40 层是 4, 128 交替(CSA、HCA 各 20 层),最后 2 层是 4, 0(CSA + SWA)。第 44 个条目(L43,值=0)对应 MTP 层。
数一下:
r=0(SWA):3 层(L0、L1、L43)r=4(CSA):21 层r=128(HCA):20 层
合计 44 个压缩比条目(43 transformer + 1 MTP)。
摊还压缩系数 Σ(1/r)(只对 r>0 的层求和,SWA 层的 KV 走固定项):
Σ(1/r) = 21 × (1/4) + 20 × (1/128) = 5.25 + 0.15625 = 5.40625
含义:平均每个 token 在所有压缩层加起来,等价于存了 5.4 个"压缩 entry"。这就是 V4 比 V3 还省的根本原因——长程 KV 被压到平均 1/8 以下。
8. V4 的混合精度:一条 entry 拆三段各用不同精度
V4 还有一个省显存的招:不统一用一种精度,而是按"维度角色"分别选最省的格式。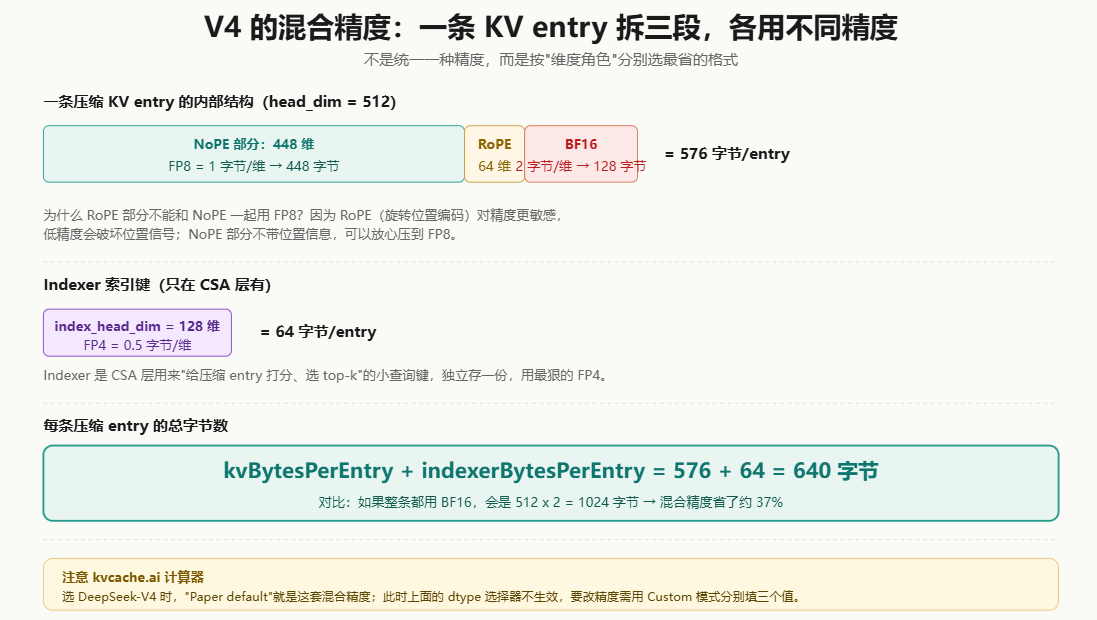
一条压缩 KV entry 的内部结构(head_dim = 512):
- NoPE 部分:448 维(不带位置信息)→ FP8 = 1 字节/维 → 448 字节
- RoPE 部分:64 维(带旋转位置编码)→ BF16 = 2 字节/维 → 128 字节
- 合计
kvBytesPerEntry = 448 + 128 = 576字节
为什么 RoPE 不能和 NoPE 一起用 FP8?因为旋转位置编码对精度敏感,低精度会破坏位置信号;NoPE 部分不带位置信息,可以放心压到 FP8。
Indexer 索引键(只在 CSA 层有):index_head_dim = 128 维 → FP4 = 0.5 字节/维 → 64 字节。Indexer 是 CSA 层用来给压缩 entry 打分、选 top-k 的小查询键,独立存一份,用最狠的 FP4。
所以每条压缩 entry 的总字节数:
kvBytesPerEntry + indexerBytesPerEntry = 576 + 64 = 640 字节
对比:如果整条都用 BF16,会是 512 × 2 = 1024 字节,混合精度省了约 37%。
kvcache.ai 计算器提示:选 DeepSeek-V4 时,"Paper default"就是这套混合精度;此时上面的 dtype 选择器不生效(因为 V4 的 KV 是混合精度,统一精度没意义)。要改精度需用 "Custom" 模式分别填 NoPE / RoPE / Indexer 三个值。
9. V4-Flash 完整计算:5 步算出 1M token 的 KV cache
把前面所有概念串起来,代入实际数字。配置来自 deepseek-ai/DeepSeek-V4-Flash 的 config.json:
| 参数 | 值 |
|---|---|
num_hidden_layers L | 43(transformer 层) |
head_dim | 512 |
qk_rope_head_dim | 64 |
index_head_dim | 128 |
sliding_window | 128 |
compress_ratios | [0,0,4,128,...,4,0](44 项 = 43 transformer + 1 MTP;CSA×21 + HCA×20 + SWA×3) |
max_position_embeddings | 1,048,576 (1M) |
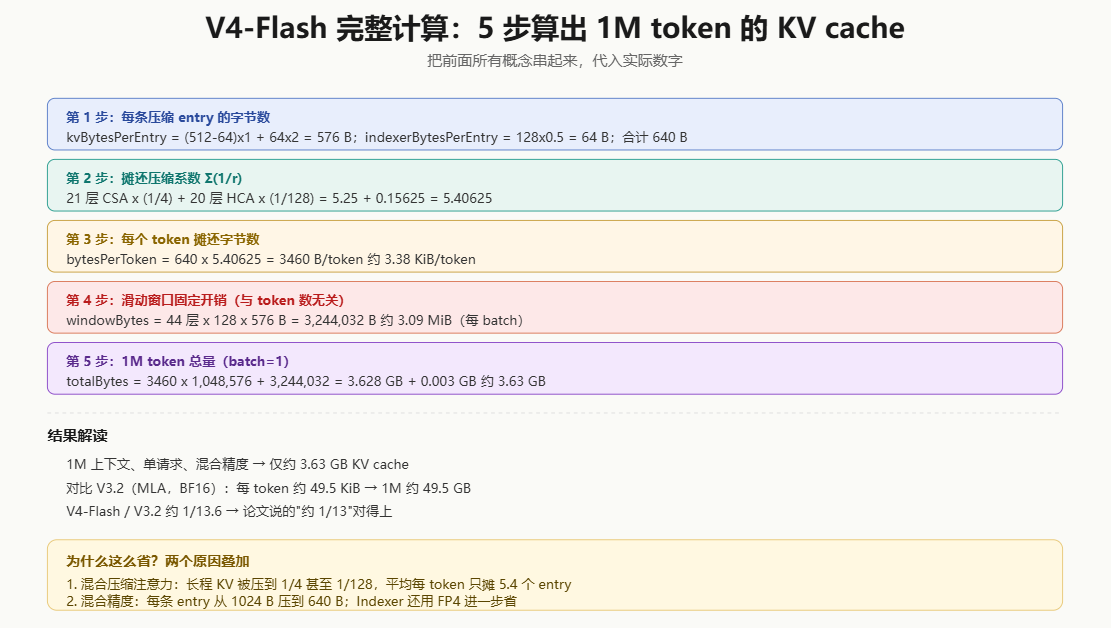 | |
| 第 1 步:每条压缩 entry 的字节数 |
kvBytesPerEntry      = (512 − 64) × 1 + 64 × 2 = 448 + 128 = 576 B
indexerBytesPerEntry = 128 × 0.5 = 64 B
合计 perEntry = 640 B
第 2 步:摊还压缩系数
Σ(1/r) = 21 × (1/4) + 20 × (1/128) = 5.25 + 0.15625 = 5.40625
第 3 步:每个 token 摊还字节数
bytesPerToken = 640 × 5.40625 = 3460 B/token ≈ 3.38 KiB/token
第 4 步:滑动窗口固定开销(与 token 数无关)
windowBytes = 44 × 128 × 576 = 3,244,032 B ≈ 3.09 MiB(每 batch)
(用 44 而不是 43,因为 compress_ratios 有 44 个条目,含 MTP 层;LMCache 计算器也用这个长度。)
第 5 步:1M token 总量(batch=1)
totalBytes = 3460 × 1,048,576 + 3,244,032
           ≈ 3.628 × 10⁹ B + 3.09 MiB
           ≈ 3.63 GB
结果解读:1M 上下文、单请求、混合精度 → 仅约 3.63 GB KV cache。对比 V3.2(MLA,BF16)每 token 约 49.5 KiB → 1M 约 49.5 GB,V4-Flash / V3.2 ≈ 1/13.6,正好对应论文说的"约 1/13"。
为什么这么省?两个原因叠加:① 混合压缩注意力把长程 KV 压到平均 1/8 以下;② 混合精度把每条 entry 从 1024 B 压到 640 B,Indexer 还用 FP4。
10. 不同场景的结果表
按 bytesPerToken × T × batch + windowBytes × batch 估算: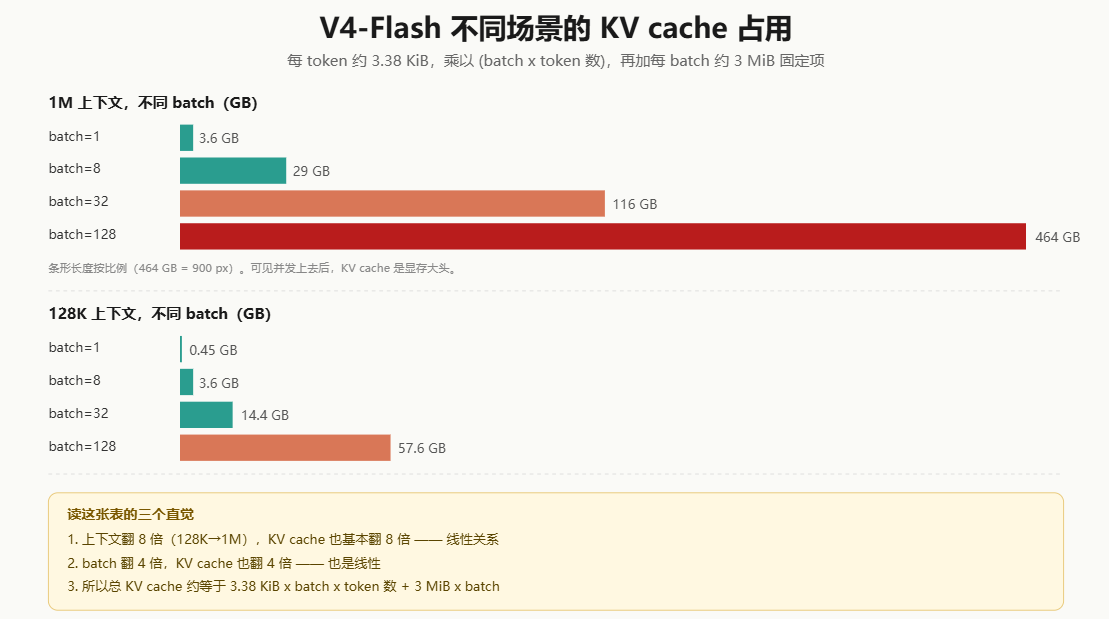
| Batch | 128K tokens | 1M tokens |
|---|---|---|
| 1 | ~0.45 GB | ~3.63 GB |
| 8 | ~3.6 GB | ~29 GB |
| 32 | ~14.4 GB | ~116 GB |
| 128 | ~57.6 GB | ~464 GB |
| 三个直觉: |
- 上下文翻 8 倍(128K→1M),KV cache 也基本翻 8 倍——线性关系
- batch 翻 4 倍,KV cache 也翻 4 倍——也是线性
- 所以总 KV cache 约等于
3.38 KiB × batch × token 数 + 3 MiB × batch
短上下文时滑动窗口固定项占比稍大,长上下文时可忽略;但 batch 越大固定项也线性增长,高并发场景别漏。
11. 常见误区
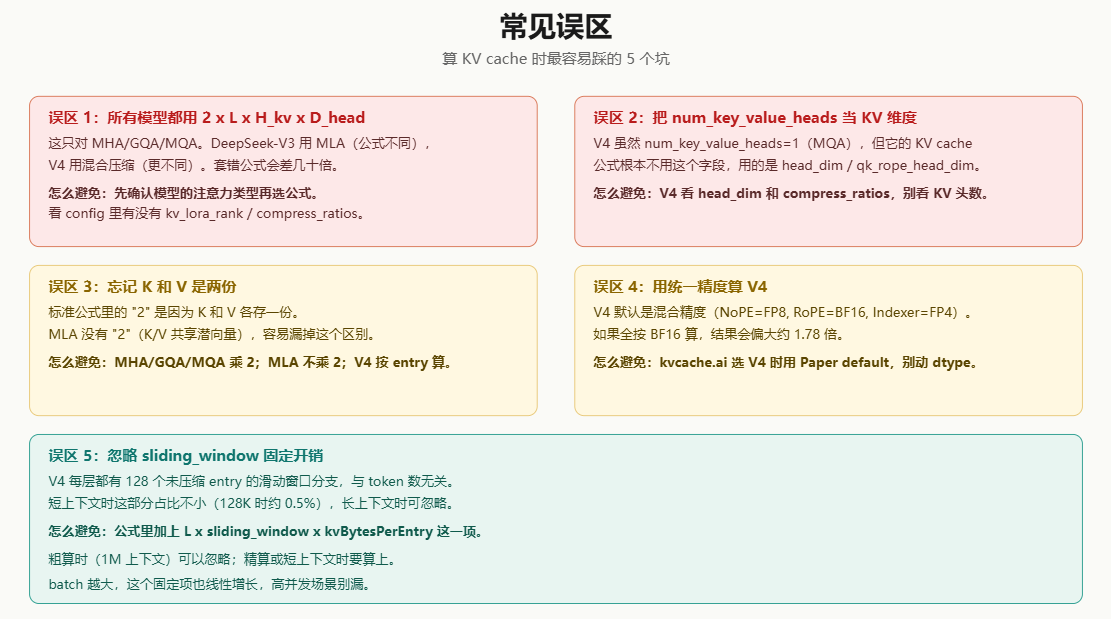
误区 1:所有模型都用 2 × L × H_kv × D_head。 只对 MHA/GQA/MQA。V3 用 MLA(公式不同),V4 用混合压缩(更不同)。套错公式会差几十倍。避免:先看 config 里有没有 kv_lora_rank / compress_ratios 确认注意力类型。
误区 2:把 num_key_value_heads 当 KV 维度。 V4 虽然 num_key_value_heads=1(MQA),但它的 KV cache 公式根本不用这个字段,用的是 head_dim 和 compress_ratios。避免:V4 看 head_dim 和 compress_ratios,别看 KV 头数。
误区 3:忘记 K 和 V 是两份。 标准公式里的 "2" 是因为 K 和 V 各存一份。MLA 没有 "2"(K/V 共享潜向量),容易漏。避免:MHA/GQA/MQA 乘 2;MLA 不乘 2;V4 按 entry 算。
误区 4:用统一精度算 V4。 V4 默认是混合精度(NoPE=FP8, RoPE=BF16, Indexer=FP4)。如果全按 BF16 算,结果会偏大约 1.78 倍。避免:kvcache.ai 选 V4 时用 Paper default,别动 dtype。
误区 5:忽略 sliding_window 固定开销。 V4 每层都有 128 个未压缩 entry 的滑动窗口分支,与 token 数无关。短上下文时占比不小,长上下文时可忽略。避免:公式里加上 L × sliding_window × kvBytesPerEntry 这一项;粗算(1M)可忽略,精算或短上下文时要算上。
12. 动手算的 6 步清单
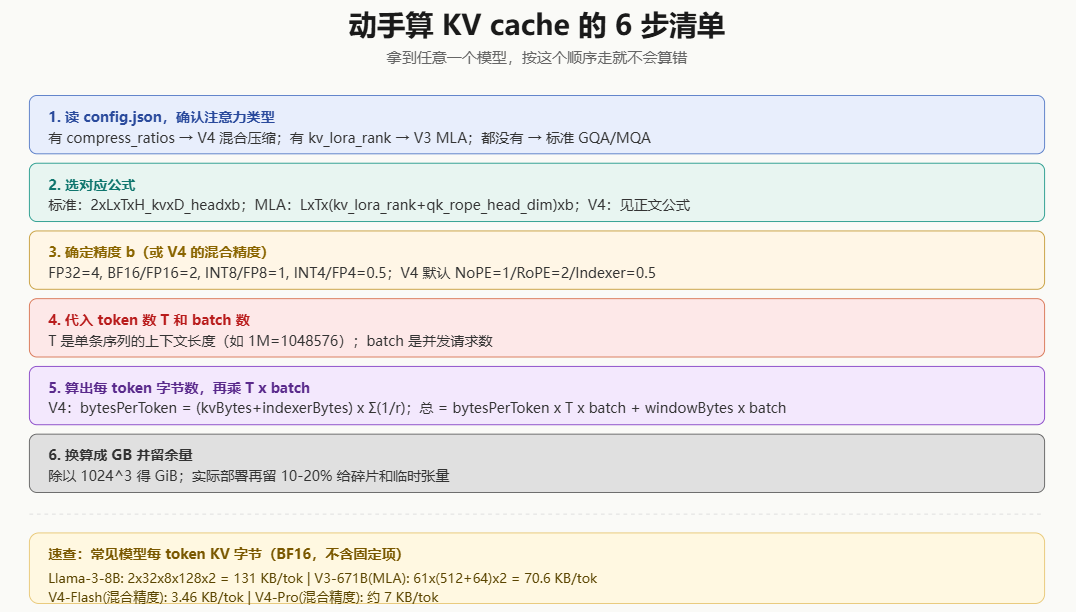
拿到任意一个模型,按这个顺序走就不会算错:
- 读 config.json,确认注意力类型:有
compress_ratios→ V4 混合压缩;有kv_lora_rank→ V3 MLA;都没有 → 标准 GQA/MQA - 选对应公式:标准
2×L×T×H_kv×D_head×b;MLAL×T×(kv_lora_rank+qk_rope_head_dim)×b;V4 见正文公式 - 确定精度 b(或 V4 的混合精度):FP32=4, BF16/FP16=2, INT8/FP8=1, INT4/FP4=0.5;V4 默认 NoPE=1/RoPE=2/Indexer=0.5
- 代入 token 数 T 和 batch 数:T 是单条序列的上下文长度(如 1M=1048576);batch 是并发请求数
- 算出每 token 字节数,再乘 T × batch:V4:
bytesPerToken = (kvBytes+indexerBytes) × Σ(1/r);总 =bytesPerToken × T × batch + windowBytes × batch - 换算成 GB 并留余量:除以
1024³得 GiB;实际部署再留 10-20% 给碎片和临时张量
速查:常见模型每 token KV 字节(BF16,不含固定项)
| 模型 | 每 token KV |
|-|-|
| Llama-3-8B(GQA) |2×32×8×128×2≈ 131 KB/tok |
| DeepSeek-V3-671B(MLA) |61×(512+64)×2≈ 70.6 KB/tok |
| DeepSeek-V4-Flash(混合精度) | ≈ 3.46 KB/tok |
| DeepSeek-V4-Pro(混合精度) | ≈ 7 KB/tok |
FAQ
Q1:kvcache.ai 计算器选 V4 后 dtype 不能选,是 bug 吗?
不是。V4 的 KV 是混合精度(NoPE/RoPE/Indexer 各不同),统一精度没意义。要改精度用 "Custom" 模式分别填三个 bytes/dim 值。
Q2:V4 的 num_key_value_heads=1 到底有什么用?
它说明 V4 是 MQA 结构(所有 Q 头共享一对原始 K/V),但因为 V4 实际存的是压缩后的潜向量而非原始 K/V,这个字段不直接出现在 KV cache 公式里。它影响的是注意力计算时的头分组,不是缓存大小。
Q3:为什么 V4 比 V3 还省?V3 不是已经用 MLA 了吗?
V3 的 MLA 把每层每 token 压到 (512+64)×2=1152 B(BF16)。V4 在此基础上又做了两件事:① 混合压缩注意力把长程 KV 按层压到 1/4 ~ 1/128,平均每 token 只摊 5.4 个 entry(V3 是每层都存一份潜向量);② 混合精度把每条 entry 从 1024 B 压到 640 B。两者叠加得到约 1/13 的进一步压缩。
Q4:滑动窗口那 128 个 entry 会不会随 batch 变大爆炸?
会线性增长。windowBytes = L × sliding_window × kvBytesPerEntry × batch。batch=128、1M 上下文时这部分约 0.4 GB,相对 464 GB 总量可忽略;但 batch=128、128K 上下文时约占 0.4 GB / 57.6 GB ≈ 0.7%,仍小。短上下文高并发时才需要留意。
Q5:FP8/FP4 量化会不会影响精度?
会,但 V4 的设计是"按角色分配精度":不带位置信息的 NoPE 部分用 FP8(对精度不敏感),位置敏感的 RoPE 用 BF16,索引键用 FP4(只用于打分排序,不直接参与注意力输出)。这种分配在尽量省显存的同时把精度损失控制在可接受范围。
Q6:算出来的数和实际显存占用对不上怎么办?
公式算的是"纯 KV cache 字节"。实际显存还包括:模型权重、激活值、临时张量、框架开销、碎片。KV cache 通常只是其中一部分(长上下文高并发时才是大头)。差 10-20% 正常,差几倍就要检查公式或参数是否选错。
Q7:Q 是不是就是输入的 prompt?
不是。这是 attention 里最常见的命名陷阱。"Query / Key / Value"这套术语是从信息检索借来的(Query = 搜索框里的查询条件,Key = 记录的标签,Value = 记录的内容),不是从"问答"来的——"Query"在这里不等于"用户提的问题"。
在大模型里,每个输入 token 都会同时产生 Q、K、V 三个向量,它们都来自这个 token 自己,只是经过三个不同的学习矩阵(W_Q、W_K、W_V)投影:
token "北京" 的隐藏状态 h
   ├── W_Q · h  →  Q(北京)
   ├── W_K · h  →  K(北京)
   └── W_V · h  →  V(北京)
所以:
- Q 不是 prompt:prompt 里的每个 token 都会产生 Q,也会产生 K、V——三者地位平等,都是从 token 投影出来的不同视角
- K/V 也不是"答案/知识库":它们和 Q 同源,都是输入 token 自己的变换
- "Query"在 attention 里的真实含义更接近"这个 token 现在想去关注哪些其他 token",而不是"用户问的问题"
那 prompt 在这幅图里是什么?prompt 就是最初喂进去的那批 token,它们和后面生成出来的 token 没有本质区别: - Prefill 阶段:把 prompt 的所有 token 一次性喂进去,每个都算出 Q/K/V,K/V 存进 cache。Q 用来在 prompt 内部做"每个 token 看它前面的 token"的自注意力。
- Decode 阶段:每生成一个新 token,这个新 token 也算出自己的 Q/K/V;它的 Q 去看 cache 里所有历史 K(包括 prompt 的 K 和之前生成 token 的 K),预测下一个 token;它的 K/V 也存进 cache。
一句话:prompt 是输入;Q、K、V 都是每个输入 token 经过三个不同矩阵投影出来的三份向量。Q 来源于 prompt,但不等于 prompt;prompt 同时也派生了 K 和 V。
总结
KV cache 大小的计算没有"一个公式走天下",关键先分清模型的注意力类型:
- 标准 MHA/GQA/MQA:
2 × L × T × H_kv × D_head × b,KV 头数是主变量 - DeepSeek-V3 MLA:
L × T × (kv_lora_rank + qk_rope_head_dim) × b,存低秩潜向量,不乘 2 - DeepSeek-V4 混合压缩:
(kvBytes + indexerBytes) × Σ(1/r) × T + L × sliding_window × kvBytes,按层压缩比摊还 + 混合精度
DeepSeek-V4-Flash 在 1M 上下文、batch=1、混合精度下,KV cache 仅约 3.63 GB——这是混合压缩注意力(长程 KV 压到平均 1/8)和混合精度(每条 entry 从 1024 B 压到 640 B)两个机制叠加的结果,约为 V3.2 的 1/13。
记住三个线性关系:KV cache 与 token 数 线性、与 batch 数 线性、与 精度字节数 线性。做容量规划时用 每 token 字节数 × batch × token 数 做粗估,再补上滑动窗口固定项和 10-20% 余量即可。
文章与配图由作者整理,公式与https://kvcache.ai/tools/kv-cache-size-calculator / https://docs.lmcache.ai/\_static/kv_cache_calculator.html 计算器一致。V4 配置参数来自 deepseek-ai/DeepSeek-V4-Flash 的 config.json。
阅读导航



