
KV Cache 容量与使用率:延迟、吞吐及稳定性
KV Cache 容量与使用率:它们如何影响 LLM 推理的延迟、吞吐和稳定性
读者定位:面向做 LLM 推理服务、压测、容量规划或性能排障的工程读者。本文关注 KV cache 的容量和使用率,而不是泛泛介绍 Transformer。
阅读地图:先把问题框住
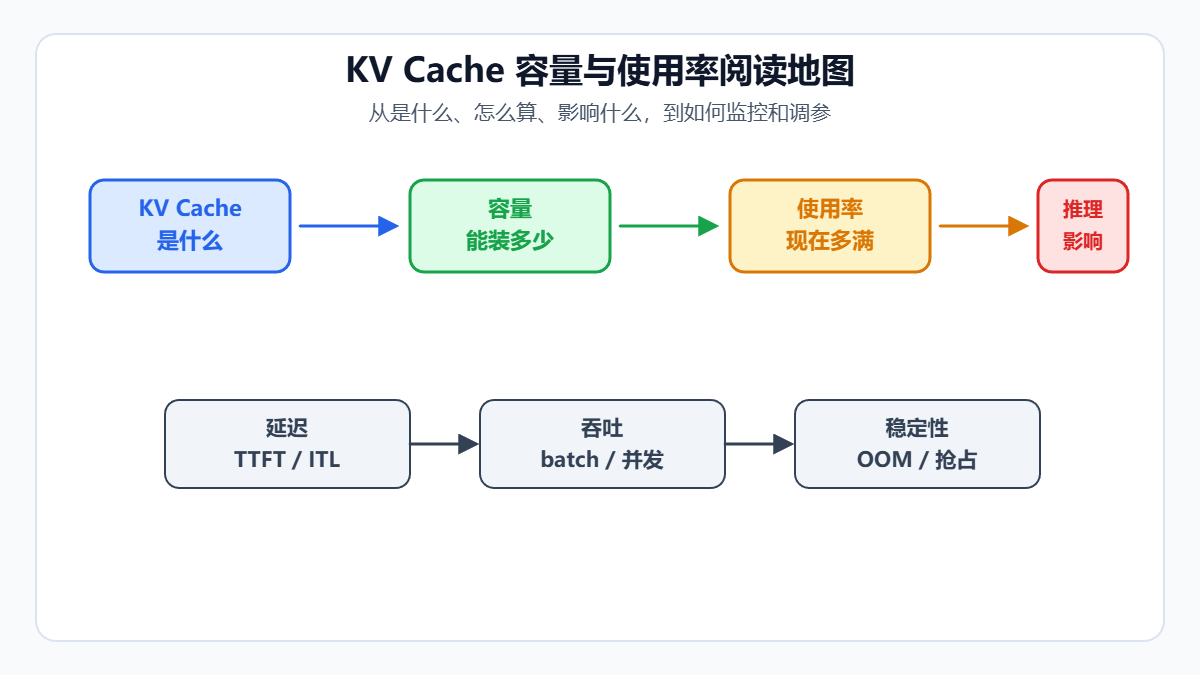
KV cache 是大模型推理里最容易被低估的资源。模型权重决定“能不能把模型放上 GPU”,KV cache 决定“同一时刻能服务多少上下文、多少并发、多少输出”。如果 KV cache 规划错了,系统可能不是算力不够,而是被显存容量、显存带宽、内存碎片、抢占重算和排队拖住。
本文重点解释两个概念:
| 概念 | 白话解释 | 它影响什么 |
|---|---|---|
| KV cache 容量 | 这台服务实例能为历史 token 留出多少 K/V 缓存空间 | 最大上下文、最大并发、准入、OOM 风险 |
| KV cache 使用率 | 当前这些缓存空间有多少被活跃请求、可复用前缀或保留块占用 | 延迟、吞吐、抢占、排队和可用余量 |
| 读完后,你应该能判断:为什么同一个模型在相同 GPU 上,短请求很稳、长上下文却抖;为什么 GPU 利用率不低但 tokens/s 上不去;为什么 80% 使用率可能是健康,也可能是事故前兆。 |
知识点 1:KV Cache 在推理中到底做什么
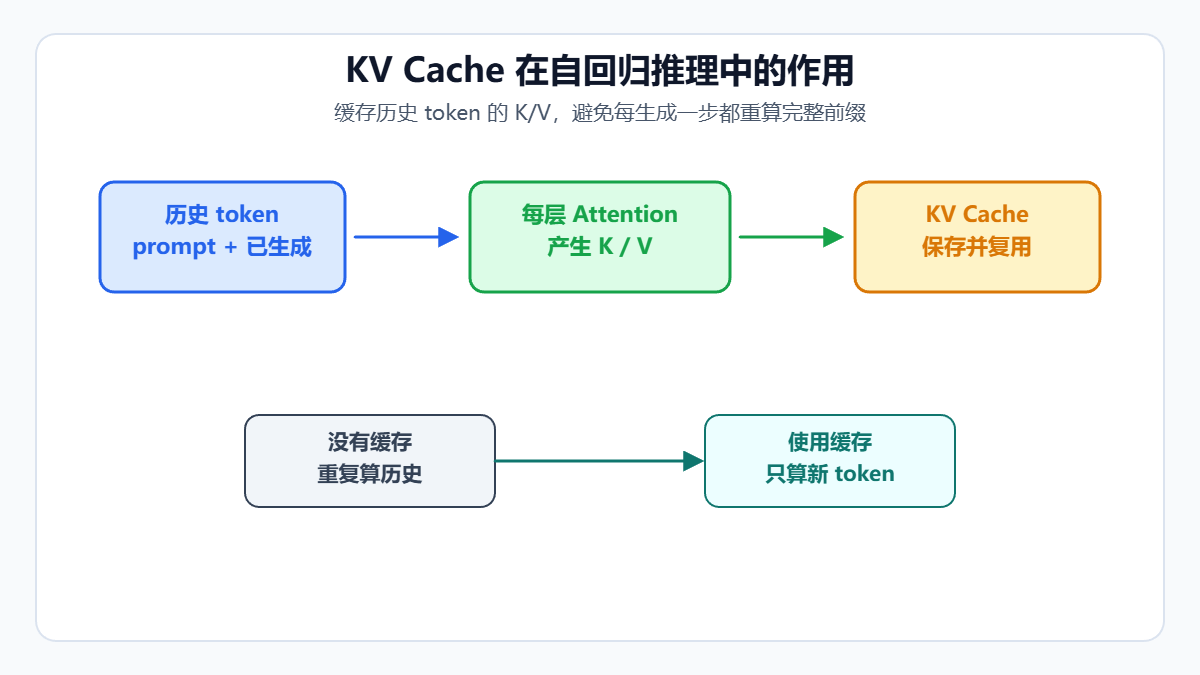
自回归模型生成文本时,每一步都要基于之前所有 token 预测下一个 token。没有 KV cache 时,第 1000 个 token 的生成需要反复处理前 999 个 token 的 attention 相关表示,历史越长,重复计算越多。
KV cache 的作用是把每一层 attention 为历史 token 计算出的 key 和 value 保存下来。下一步生成时,模型只需要为新 token 计算新的 K/V,再读取历史 K/V 参与 attention,而不必重新计算所有历史 token 的 K/V。
实践含义很直接:KV cache 用显存换速度。它让 decode 从“反复重算整段历史”变成“持续读取并追加缓存”。这会明显加速生成,但也让推理服务的关键瓶颈从纯计算扩展到显存容量和显存带宽。
知识点 2:KV Cache 容量怎么算
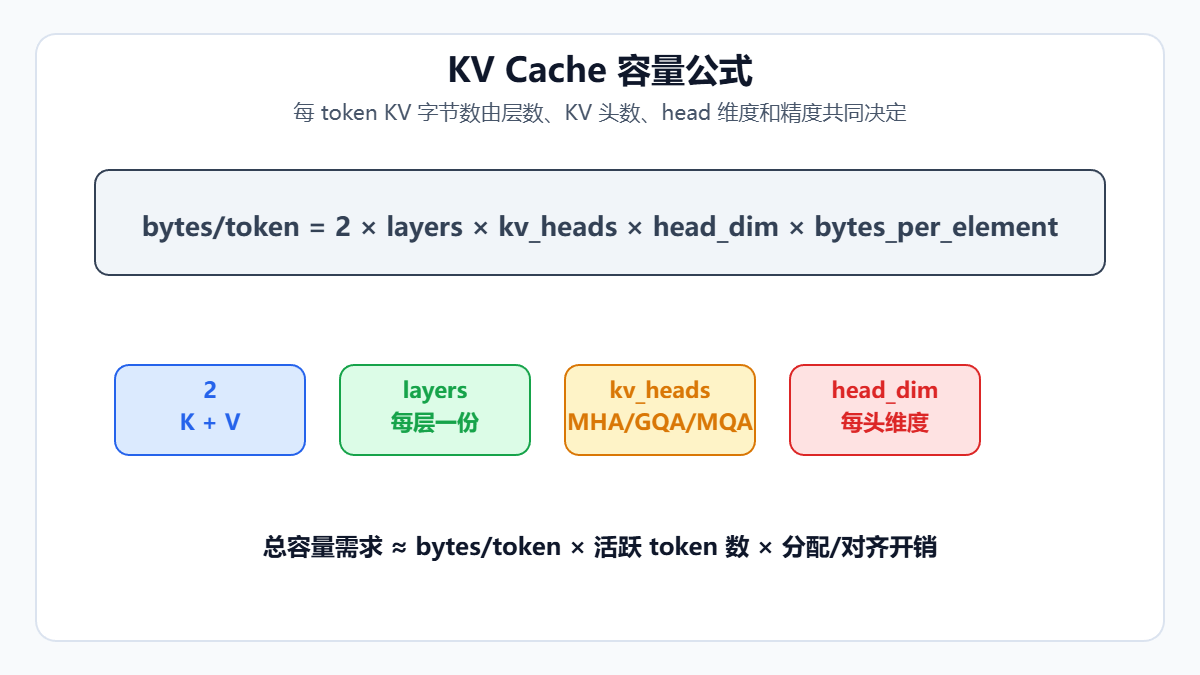
一个实用估算公式是:
KV bytes per token ≈ 2 × num_layers × num_kv_heads × head_dim × bytes_per_element
KV total bytes ≈ KV bytes per token × active_tokens × allocation_overhead
公式里的 2 表示 key 和 value 两份缓存。num_layers 是 Transformer 层数。num_kv_heads 是 KV 头数,不一定等于 query heads;使用 GQA/MQA 的模型会显著减少 KV 头数。head_dim 是每个 attention head 的维度。bytes_per_element 取决于 KV cache 精度,例如 BF16/FP16 通常是 2 字节,INT8 通常是 1 字节。
举一个不绑定具体模型的例子:一个 32 层、8 个 KV 头、head_dim 为 128、BF16 KV 的模型,每个 token 的 KV 约为:
2 × 32 × 8 × 128 × 2 = 131072 bytes ≈ 128 KiB/token
如果单个请求保留 128K token 的上下文,理论 KV 就接近 16 GiB。并发 4 个类似请求时,KV 理论需求约 64 GiB,还没算 block 对齐、运行时预留、激活、通信 buffer 和框架开销。这个数量级解释了为什么长上下文推理首先会撞上 KV cache,而不是只撞上模型权重。
知识点 3:容量和使用率不是一回事
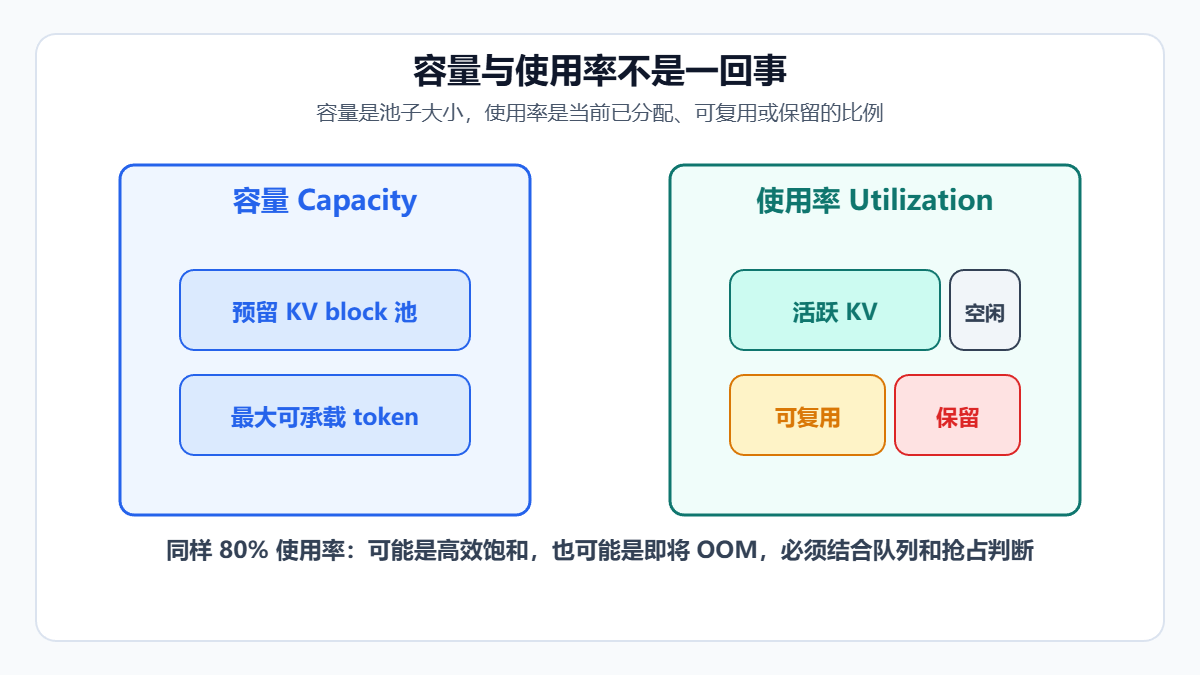
KV cache 容量是“池子多大”。例如 TensorRT-LLM 文档说明运行时会在初始化时预分配 paged KV cache pool,然后在运行时分配 block;vLLM 的 PagedAttention 也把 KV cache 切成固定大小 block,并通过 block table 管理逻辑 token 到物理 block 的映射。
KV cache 使用率是“池子现在有多满”。但“满”的构成很关键:里面可能有活跃请求必须保留的 KV,也可能有可复用的 prefix cache,还可能有优先级保留、等待淘汰或暂时不可回收的 block。
所以 80% 使用率本身不能直接说明健康或危险:
| 场景 | 80% 使用率代表什么 |
|---|---|
| 活跃请求稳定、无抢占、队列低 | 可能是高效利用 |
| 新请求排队变长、抢占升高 | 可能即将容量不足 |
| 大量可复用前缀命中 | 可能是用容量换 TTFT |
| 大量冷 KV 不淘汰 | 可能是回收策略有问题 |
| 容量是硬约束,使用率是状态信号。两者必须和请求分布、队列、抢占、命中率、延迟一起读。 |
知识点 4:KV Cache 的生命周期
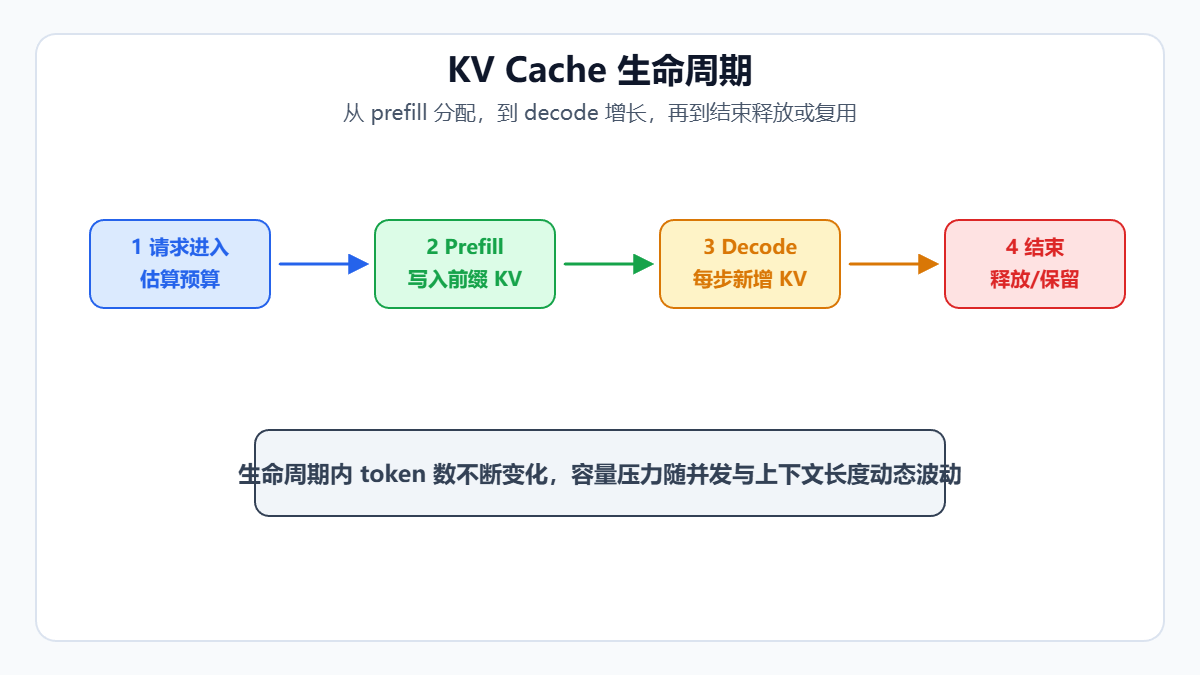
一个请求进入系统后,调度器通常要估算它会占用多少 KV token:输入 prompt 需要 prefill,后续输出会在 decode 中逐步增长。Prefill 完成后,前缀 token 的 KV 已经写入缓存;decode 每生成一个新 token,KV cache 就多一小段。
请求结束后,KV 可以被释放,也可以被保留用于复用。例如系统提示词、常见模板、多轮会话历史、相同 RAG 前缀,都可能在后续请求中命中缓存,从而降低 TTFT。
生命周期视角能解释一个常见现象:服务的 KV 使用率不是只跟输入长度有关,也跟输出长度、请求结束速度、复用保留策略和淘汰策略有关。两个 prompt 一样长的请求,如果一个输出 20 token,一个输出 2000 token,对 KV cache 的占用轨迹完全不同。
知识点 5:容量决定准入、并发和最大上下文
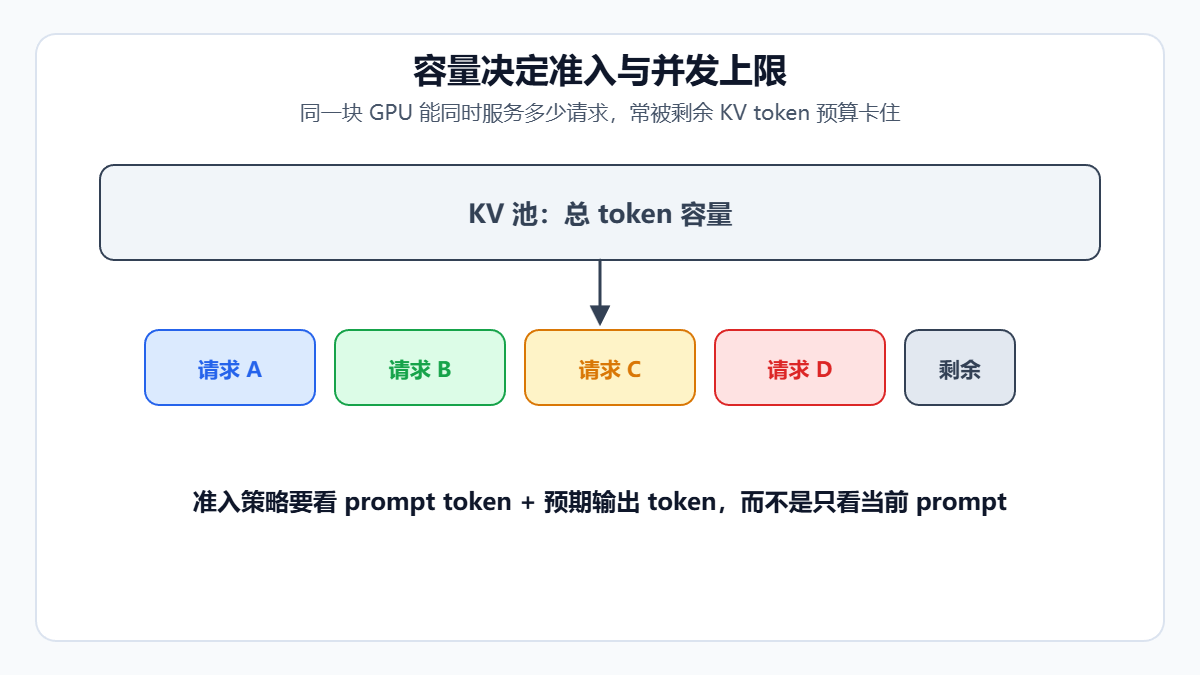
推理服务不是只要模型权重放得下就能接任意流量。每个活跃请求都需要 KV cache,且 KV 随上下文和输出增长。容量不足时,调度器只能排队、拒绝、抢占、换出到 CPU、重算,或者降低并发。
准入控制至少要考虑三部分:
| 部分 | 为什么重要 |
|---|---|
| 输入 prompt token | Prefill 完成后这些 token 的 KV 需要保留 |
| 预计输出 token | Decode 会不断追加 KV,长输出会吃掉余量 |
| 安全余量 | 防止请求输出超预期、复用池不可回收、框架预留不够 |
| 这也是为什么很多服务会设置最大上下文长度、最大并发序列数、最大 batched tokens、最大输出长度和请求级 quota。它们看似是产品或调度参数,本质上经常是在保护 KV cache 池不被打爆。 |
知识点 6:使用率如何影响 TTFT 与 ITL
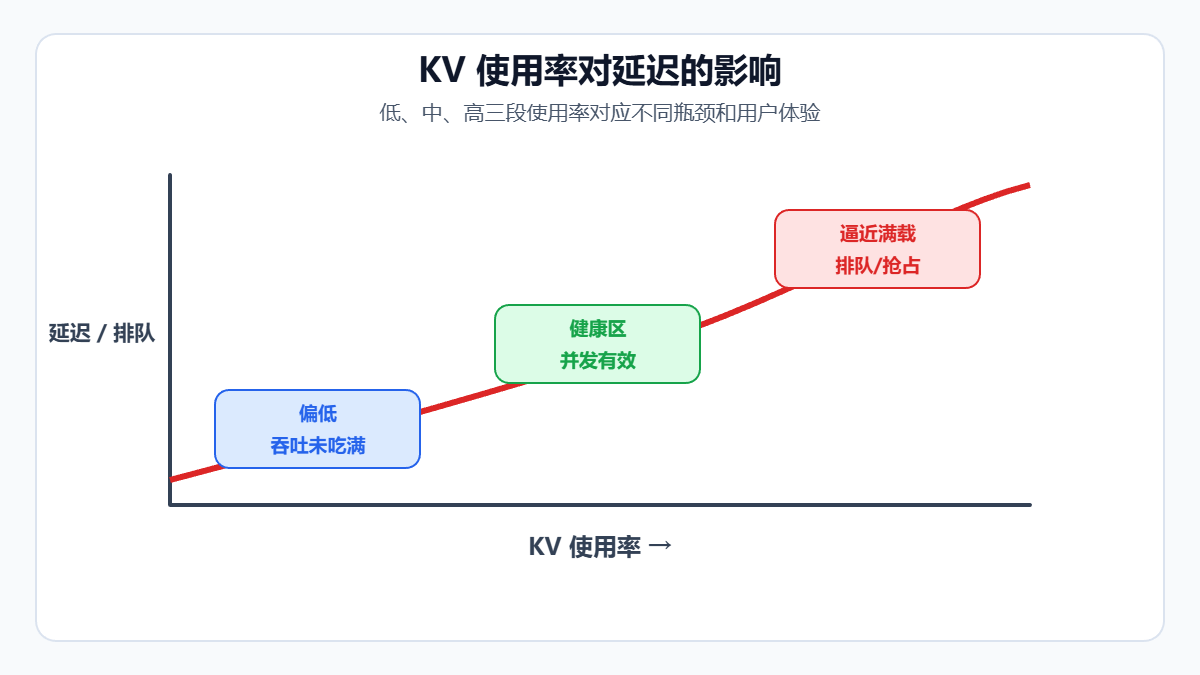
TTFT 受 prefill 计算、排队和 KV 分配影响。KV 使用率过高时,新请求可能无法立刻分配足够 block,或者需要等待其他请求结束、淘汰冷 KV、抢占低优先级请求。这会直接拉长 TTFT。
ITL 受 decode 调度、KV 读取带宽和 batch 组成影响。上下文越长,每一步 decode 要读取的历史 KV 越多;使用率高时,活跃序列多、KV 读写压力大,内存带宽和缓存局部性可能成为瓶颈。若系统发生抢占或重算,ITL 也会抖动。
一个健康区间通常不是越低越好,也不是越高越好。过低可能说明你预留了太多 KV 但并发没跑起来,吞吐浪费;过高则会让排队、抢占和 OOM 风险非线性上升。实际健康区间要靠压测确定,并且要按 prompt 长度和输出长度分桶。
知识点 7:KV 容量如何影响 Batch 与吞吐
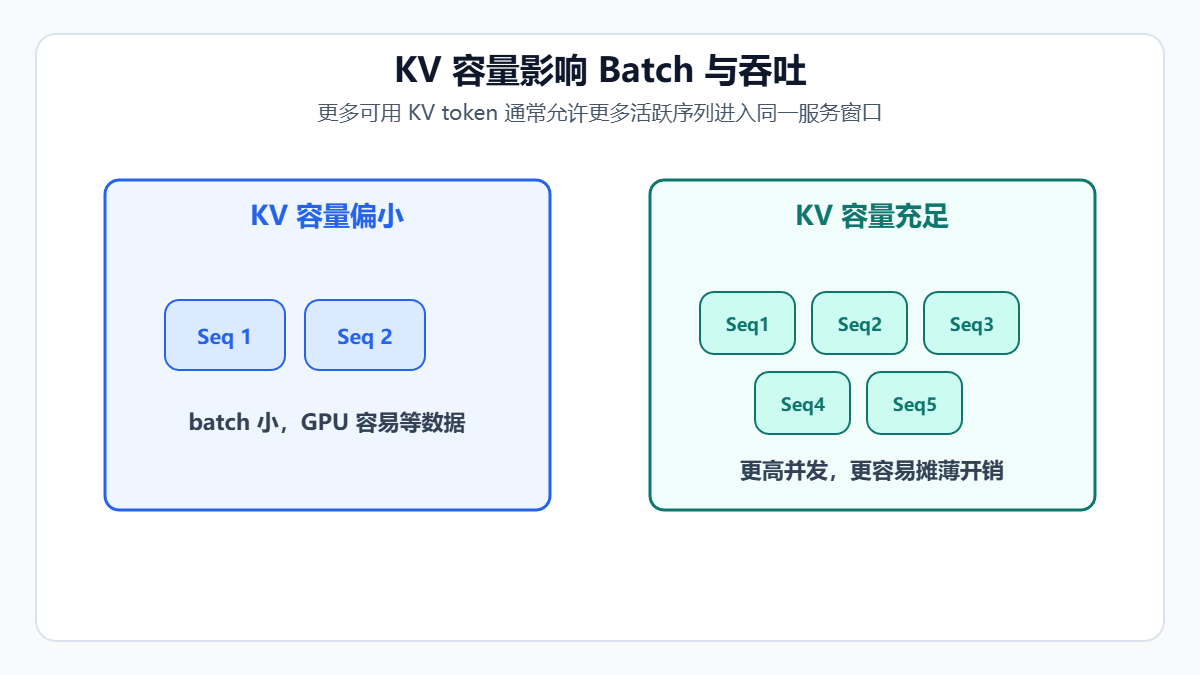
LLM 服务的吞吐通常需要足够多活跃序列来摊薄 GPU 开销。Decode 阶段每个请求每轮只生成一个 token,如果活跃序列太少,GPU 计算单元可能吃不饱;如果 KV cache 容量允许更多序列同时驻留,调度器就能组成更大的有效 batch。
PagedAttention 论文指出,传统 KV 管理会因为动态增长、碎片和重复复制浪费大量内存,限制 batch size;vLLM 通过接近零浪费的 KV 管理和跨请求共享,在相同延迟水平下提升吞吐。这背后的核心就是:释放出来的 KV 容量可以转化为更大的 batch、更高并发或更长上下文。
但容量不是吞吐的唯一条件。如果模型已经被计算瓶颈卡住,或者 batch 过大导致排队和尾延迟超过 SLO,继续增加 KV 容量也不一定提高有效吞吐。真正有意义的是“SLO 内吞吐”:在 TTFT/ITL p95/p99 达标前提下,系统能处理多少请求和 token。
知识点 8:容量不是带宽,放得下不等于读得快
🏕️
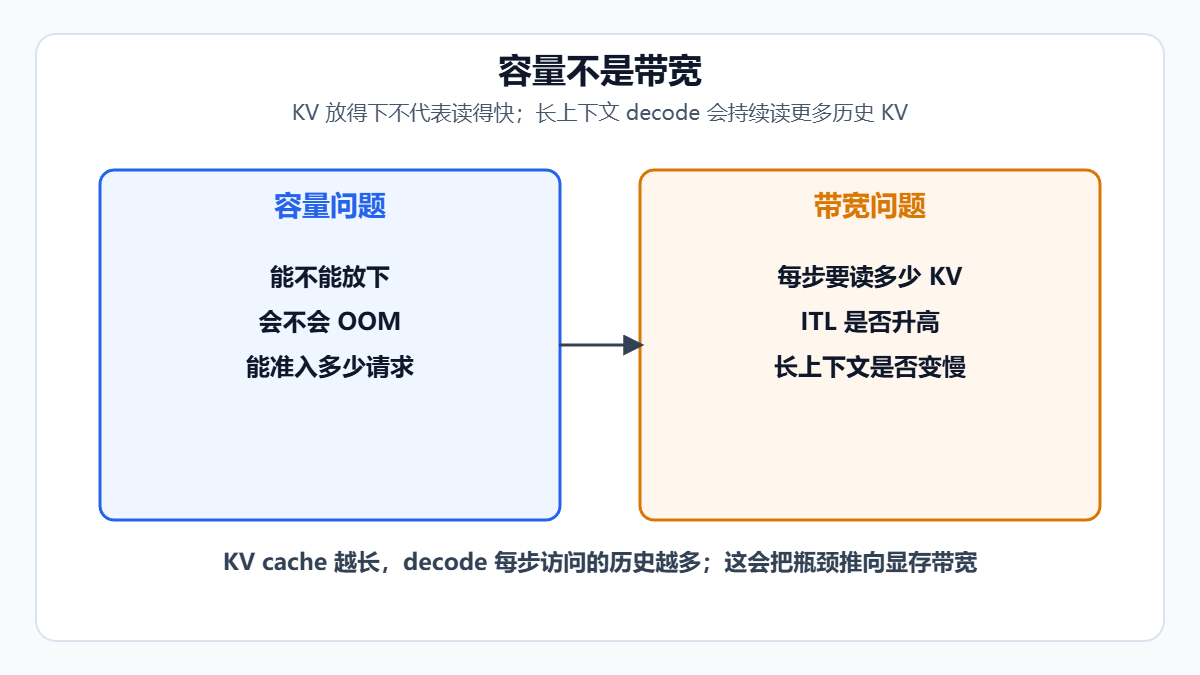
KV cache 有两个不同瓶颈:容量瓶颈和带宽瓶颈。容量瓶颈回答“能不能放下这些历史 token”;带宽瓶颈回答“每一步 decode 能不能足够快地读这些历史 KV”。
长上下文请求即使 KV 放得下,decode 每一步也要访问更长的历史 KV。随着上下文增长,每生成一个 token 的 attention 读访问越来越重,ITL 可能上升。GQA/MQA、KV cache 量化、paged attention 内核、flash attention 变体、上下文窗口策略,都在不同程度上试图缓解容量或带宽压力。
因此排障时要避免一个误判:看到没有 OOM,就以为 KV cache 没问题。没有 OOM 只说明容量暂时够;如果 ITL 随上下文长度明显上升,或者 GPU utilization 高但 memory bandwidth 接近瓶颈,问题可能在 KV 读取路径。
知识点 9:Paged KV 如何降低碎片和浪费
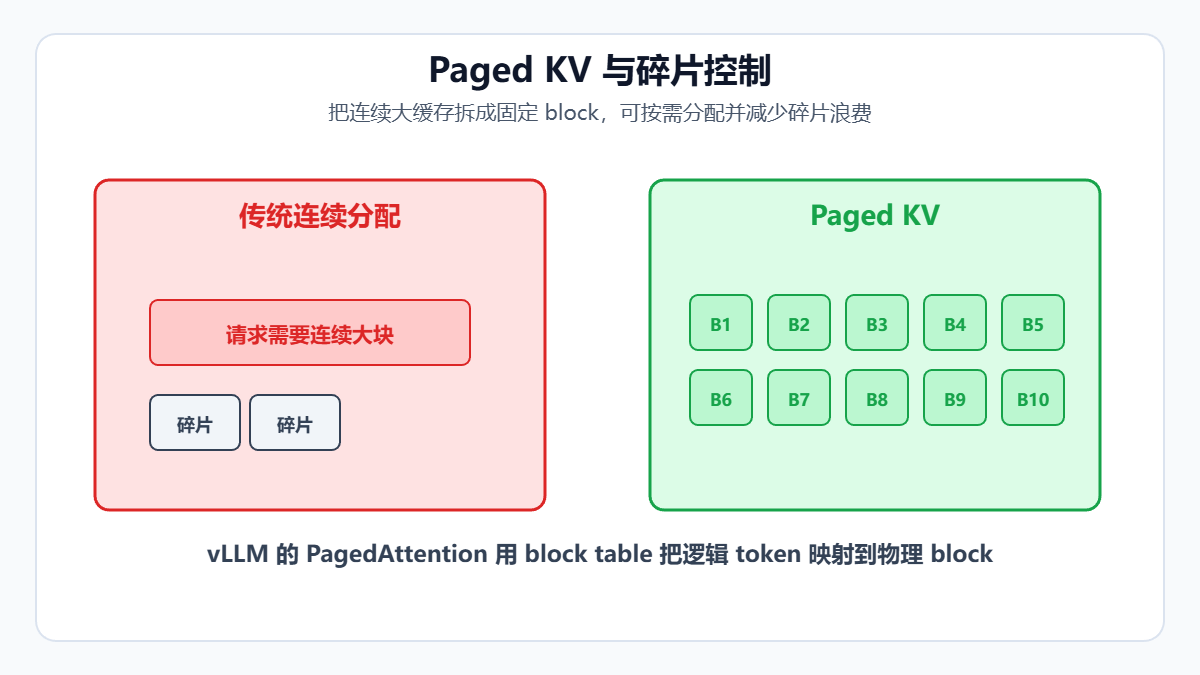
传统做法容易把每个请求的 KV cache 当成连续大块来管理。问题是请求长度动态变化,生成长度事先不完全可知,请求结束时间也不同,连续分配会造成内部浪费和外部碎片。结果是明明总显存看起来还有空间,却找不到合适的连续空间,或者为了上限预留了大量实际没用到的 KV。
PagedAttention 借鉴操作系统虚拟内存分页,把每个序列的 KV cache 切成固定 token 数的 block。逻辑上一个序列仍然有连续上下文,物理上这些 block 可以不连续。vLLM 文档也说明,KV cache data 被分成 block,每个 block 为固定数量 token 存储 key/value 数据。
这种设计带来三类收益:按需分配减少预留浪费;block table 降低碎片影响;相同前缀或多候选采样时可以共享部分 KV。代价是 attention 内核需要理解 block table,系统要维护更复杂的调度与内存映射。
知识点 10:复用、保留与淘汰会改变“使用率”的含义
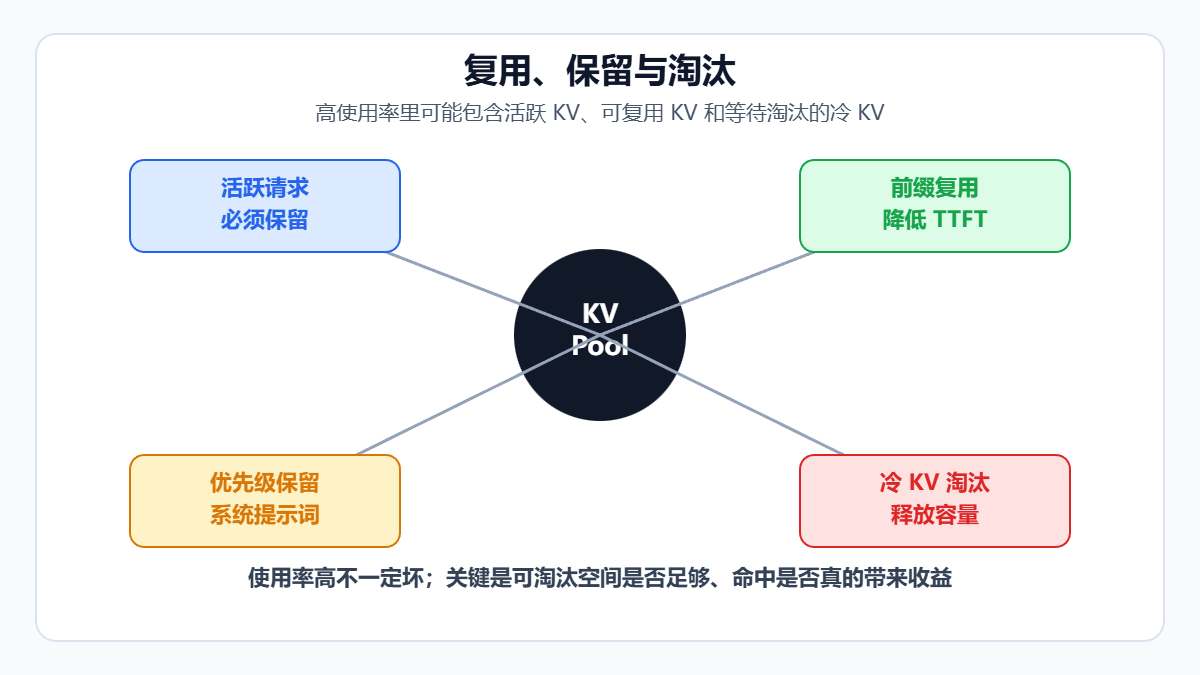
当系统支持 prefix caching 或 KV reuse 时,使用率高不一定意味着活跃请求很多。部分 KV 可能是为了加速后续请求而保留的可复用缓存。例如固定系统提示词、常见工具说明、多轮会话前缀、热门文档块,都可能值得保留。
复用的收益主要体现在 TTFT:命中前缀后,服务不必重新 prefill 已缓存部分,可以更快进入未命中部分或 decode。
但保留策略必须有淘汰边界。若可复用 KV 过度占用池子,活跃请求可能被挤压,导致排队、抢占或 OOM。更成熟的系统会使用 LRU、优先级、租户隔离、前缀长度收益、命中频率、过期时间或显式保留策略来决定哪些 KV 值得留下。
知识点 11:KV Cache 量化如何改变有效容量
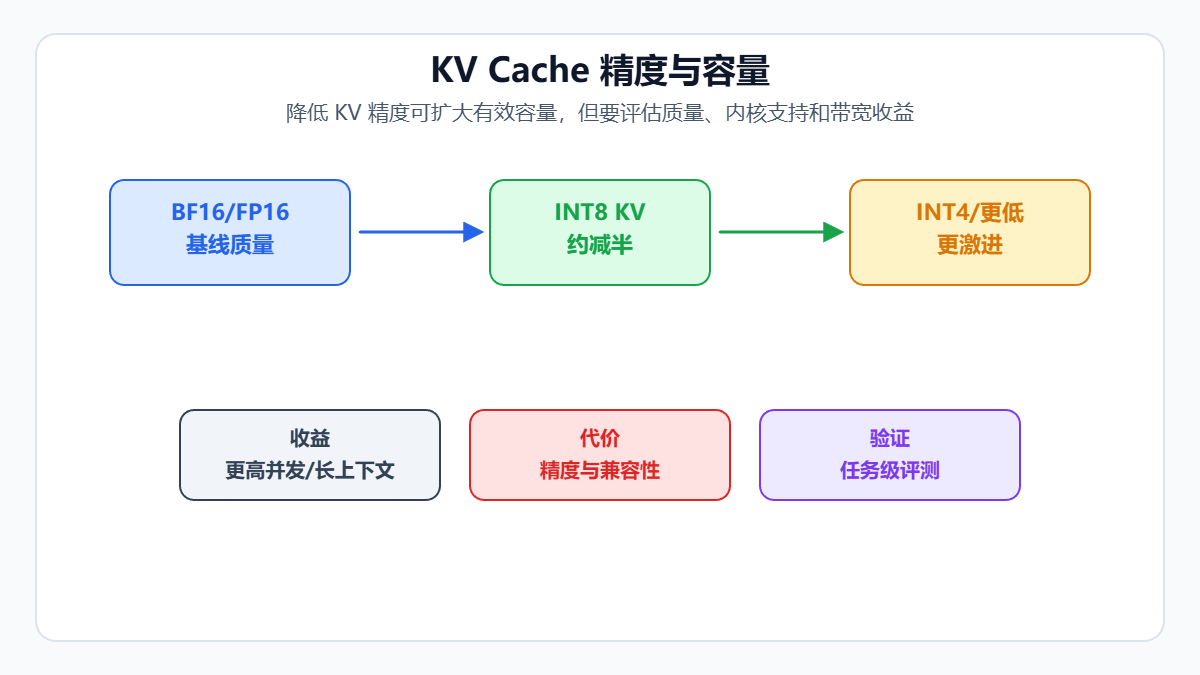
KV cache 量化是把 K/V 缓存用更低精度保存,例如从 BF16/FP16 降到 INT8,甚至更低。按公式看,bytes_per_element 降低后,每 token KV 字节数直接下降,有效容量提升,也可能降低显存带宽压力。
但它不是无代价优化。更低精度可能影响模型质量,尤其是长上下文、需要精细引用、代码、数学或多轮推理任务。它还依赖框架、模型、GPU 内核和 attention 后端支持。NVIDIA 的 TensorRT-LLM 资料提到 paged KV cache、quantized KV cache、circular buffer KV cache 和 KV cache reuse 等优化,但具体组合能力要以当前版本文档和实测为准。
建议把 KV 量化当成容量优化手段,而不是默认开关。上线前至少做三类评测:困惑度或离线质量指标、业务任务正确率、长上下文和多轮场景的人工抽检。性能收益必须和质量风险一起评估。
知识点 12:应该监控哪些 KV Cache 信号
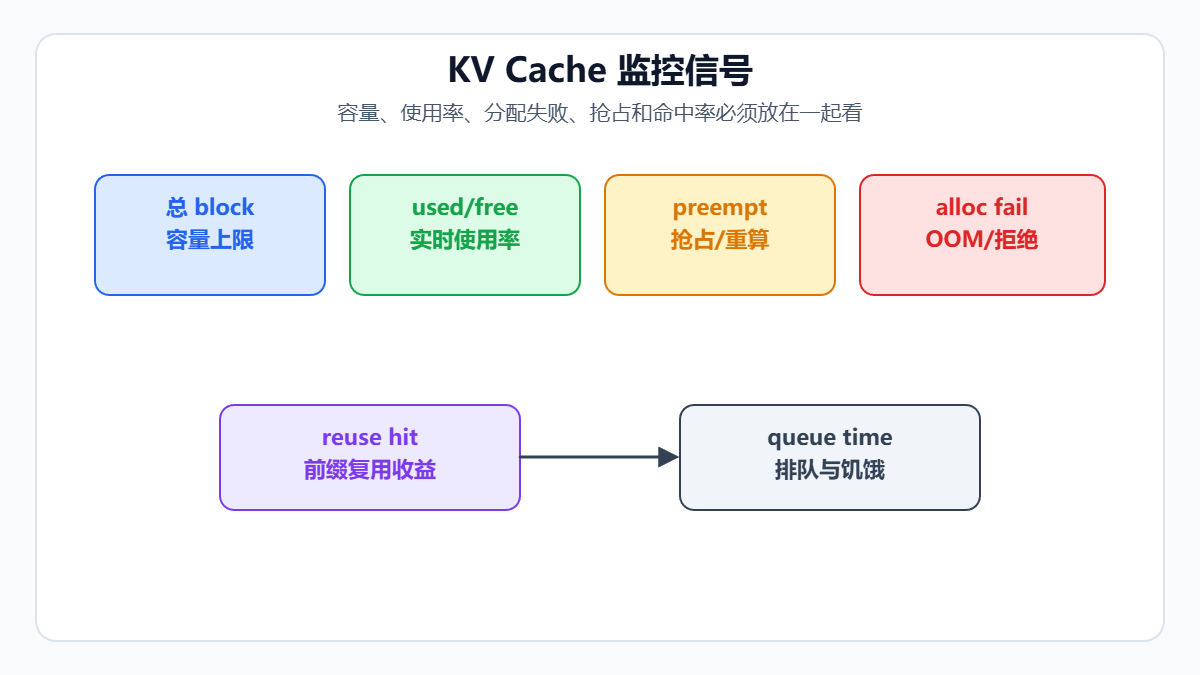
只监控 GPU memory used 不够。推理框架通常会有更贴近 KV cache 的指标,生产中至少要关注这些信号:
| 信号 | 解释 | 异常含义 |
|---|---|---|
| 总 KV block/token 容量 | 当前实例可用于 KV 的池子大小 | 配置过小会限制并发;过大可能挤占其他内存 |
| used/free KV blocks | 当前分配和剩余容量 | 长期逼近满载会增加排队和抢占 |
| KV cache utilization | 使用率比例 | 要结合活跃请求和可复用 KV 判断 |
| preemption/recompute 次数 | KV 不足时的抢占或重算 | 直接伤害 tail latency |
| allocation failure / OOM | 分配失败或显存错误 | 容量规划或准入控制失败 |
| prefix reuse hit rate | 前缀复用命中率 | 命中高可改善 TTFT;命中低则保留可能浪费 |
| prefill queue time | prefill 等待进入执行的时间 | 新请求可能被 decode 或容量限制饿住 |
| prompt/output 分布 | 输入和输出长度分布 | 解释为什么同配置在不同时段表现不同 |
| 监控面板应把 KV 指标和用户指标放在一起:TTFT、ITL、tokens/s、请求错误率、队列时间、GPU 利用率、显存带宽、KV 使用率和抢占次数。如果只看其中一个,很容易误判。 |
知识点 13:常见失败模式与定位顺序
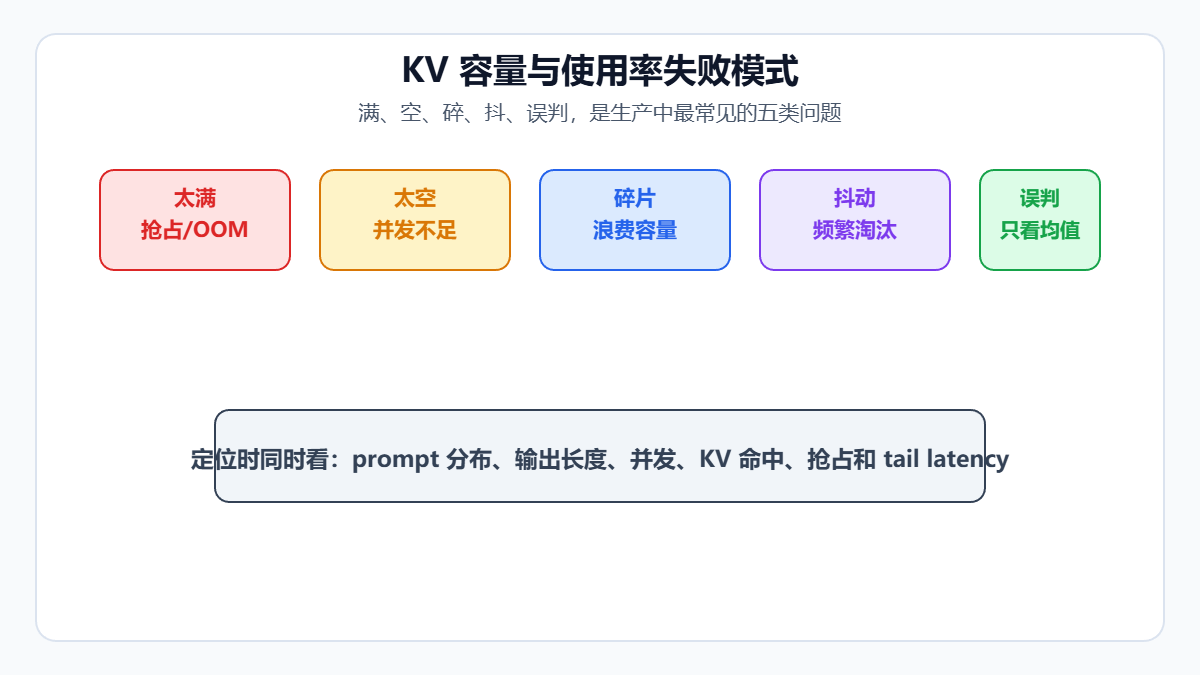
第一类是太满。表现为 TTFT p99 上升、请求排队、抢占/重算增加、OOM 或拒绝率升高。优先检查最大上下文、最大并发、最大输出长度和可复用 KV 是否挤占活跃请求。
第二类是太空。表现为 KV 使用率长期很低,但吞吐也上不去。此时瓶颈可能在计算、调度、网络、CPU tokenization、batch 参数或请求不足,而不是 KV 容量。
第三类是碎片或分配浪费。表现为理论剩余很多,实际却分配失败或 batch 上不去。Paged KV 可以显著缓解这类问题,但 block size、预留策略和实现细节仍会影响浪费比例。
第四类是抖动。表现为使用率、抢占、队列时间周期性波动,尾延迟像锯齿。常见原因是长输出请求集中结束、缓存淘汰策略激进、租户流量尖峰或复用池过度保留。
第五类是误判。只看平均 latency、平均 GPU utilization 或总显存使用,会漏掉 prompt 长度分桶、长输出分桶和租户间不公平。定位顺序应当是:先分桶看用户延迟,再看 KV 使用率和抢占,再看 batch 组成和带宽,最后调整容量、准入和缓存策略。
一个容量规划例子
假设你要部署一个 32 层、8 KV heads、head_dim 128、BF16 KV 的模型。按前面的公式,每 token 约 128 KiB。若业务允许最大输入 32K、最大输出 2K,单请求最坏 KV 约为:
(32768 + 2048) tokens × 128 KiB/token ≈ 4.25 GiB
如果你希望同一实例同时承载 8 个这种最坏请求,仅 KV 理论需求就约 34 GiB。再加上模型权重、运行时预留、激活、通信 buffer、碎片和安全余量,单卡很可能不现实。此时你有几条路:
| 方向 | 代价 |
|---|---|
| 降低最大上下文或最大输出 | 产品能力受限,但稳定性最好 |
| 使用 GQA/MQA 模型 | 需要模型结构支持 |
| KV cache 量化 | 需评估质量和内核兼容 |
| 分池路由长请求 | 运维复杂度上升,但隔离性更好 |
| CPU/offload 或分层缓存 | 延迟和带宽路径更复杂 |
| 提高 GPU 数量或使用张量/流水并行 | 成本和通信复杂度上升 |
| 容量规划要用真实流量分布,而不是只用最大值。最大值决定安全边界,p50/p95 决定资源利用率,p99 决定事故概率。 |
实践检查清单
| 检查项 | 通过标准 |
|---|---|
| 是否知道当前模型的每 token KV 字节数 | 能按 layers、KV heads、head_dim、精度算出数量级 |
| 是否区分容量和使用率 | 能解释 used blocks 里活跃、复用、保留分别占多少 |
| 是否按 prompt/output 分桶看延迟 | 至少有短、中、长 prompt 和短、长输出分桶 |
| 是否有准入策略 | 最大上下文、最大输出、最大并发和安全余量明确 |
| 是否监控抢占和分配失败 | 有 preemption/recompute、OOM、alloc fail 指标 |
| 是否评估复用收益 | prefix hit rate 能和 TTFT 改善对应起来 |
| 是否验证 KV 量化 | 有质量评测和长上下文回归测试 |
| 是否有回滚条件 | tail latency、错误率、抢占、队列时间退化可自动告警 |
FAQ
KV cache 使用率越高越好吗?
不是。高使用率如果伴随低排队、低抢占、稳定 tail latency,说明资源利用充分;如果伴随 TTFT p99 上升、OOM 或抢占,说明已经逼近危险区。使用率必须和延迟、队列、抢占一起看。
为什么模型权重只占几十 GB,但服务还是显存不够?
因为推理时显存不只有权重。还有 KV cache、激活、I/O tensor、运行时 workspace、通信 buffer 和碎片。长上下文和高并发时,KV cache 可能成为权重之外最大的动态显存项。
KV cache 会影响模型输出质量吗?
正常精度下,KV cache 是保存已计算结果,不应改变语义结果。可能影响质量的是 KV 量化、近似 attention、滑动窗口、压缩、截断或有 bug 的复用策略。
Prefix cache 命中率高就一定好吗?
不一定。命中率高但命中的是很短前缀,节省有限;为了保留这些前缀挤压活跃请求,反而可能伤害整体延迟。更好的指标是命中节省的 prefill token、TTFT 改善和占用容量之间的收益比。
KV cache 和 chunked prefill 的关系是什么?
Chunked prefill 把长 prompt 的 prefill 分成多个调度片段;每个片段处理后仍会写入 KV cache。它可以降低单轮 prefill 峰值和调度阻塞,但完整上下文最终仍需要对应 KV 容量。
术语表
| 术语 | 含义 |
|---|---|
| KV cache | Transformer attention 中保存历史 token key/value 的缓存 |
| Capacity | 可用于 KV 的总 block/token/bytes 容量 |
| Utilization | 当前已使用 KV 容量占总容量的比例 |
| Active KV | 活跃请求生成后续 token 必须保留的 KV |
| Prefix cache | 用于复用相同前缀的 KV 缓存 |
| Preemption | KV 资源不足时抢占请求,之后可能重算或恢复 |
| PagedAttention | 将 KV cache 分 block 管理的 attention 与内存管理方法 |
| GQA/MQA | 减少 KV heads 的 attention 结构,可降低 KV 容量需求 |
| TTFT | Time To First Token,首 token 延迟 |
| ITL | Inter-Token Latency,token 间延迟 |
总结
KV cache 容量回答“这台服务实例最多能承载多少历史 token”;KV cache 使用率回答“当前这些空间有多少已经被占用,以及还有多少调度余量”。它们共同影响推理服务的最大上下文、最大并发、batch 大小、TTFT、ITL、吞吐、OOM 风险和抢占概率。
真正有效的 KV 管理不是把使用率压低,也不是把显存占满,而是在业务 SLO 内把容量转化为稳定吞吐。工程上要先算清每 token KV 成本,再按真实 prompt/output 分布规划容量;上线后同时看使用率、抢占、队列、复用命中和 tail latency;遇到问题时区分容量瓶颈、带宽瓶颈、碎片浪费和准入失控。只有这样,KV cache 才会从“看不见的显存消耗”变成可管理的推理资源。
参考资料
- Hugging Face Transformers: Caching
- Hugging Face Transformers: Cache strategies
- vLLM Documentation: Paged Attention
- Efficient Memory Management for Large Language Model Serving with PagedAttention, arXiv:2309.06180
- vLLM Blog: Easy, Fast, and Cheap LLM Serving with PagedAttention
- TensorRT-LLM Documentation: Memory Usage
- TensorRT-LLM Documentation: KV cache reuse
- NVIDIA Developer Blog: KV Cache Reuse Optimizations in TensorRT-LLM
阅读导航



