01、LRU缓存淘汰算法
缓存容量有限时,不能一直保留所有数据。LRU 的取舍是:最近成功使用过的数据更值得留下,最久没有使用的数据优先淘汰。难点在于既要快速找到键,又要快速调整新旧顺序。
问题与目标
以 LeetCode 146:LRU 缓存为接口约定,get(key) 读取已有键并将其设为最近使用;put(key,value) 更新已有键或插入新键,容量满时淘汰最久未使用的键。
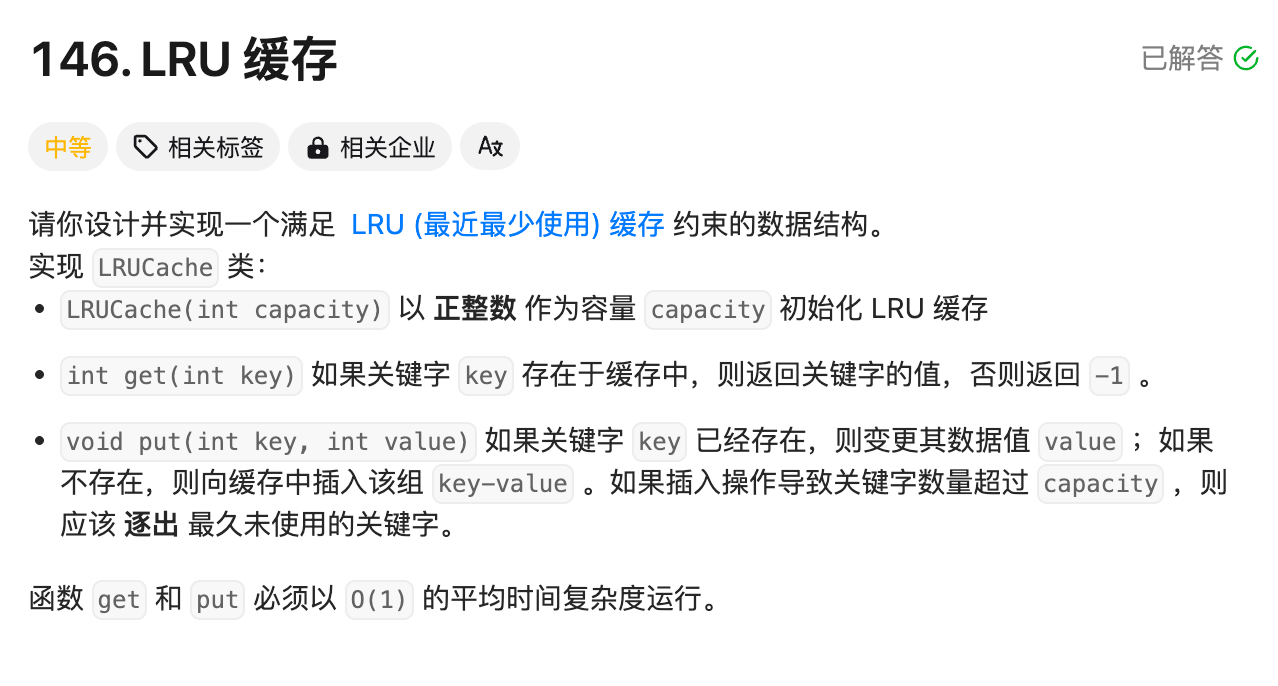
失败的读取返回 -1,不会凭空增加键,也不改变其他键的使用顺序。本文实现额外支持容量为 0 的情况。
为什么同时需要哈希表与双向链表
哈希表解决“键在哪里”:平均常数时间定位链表节点。双向链表解决“节点有多新”:表头最近,表尾最久,已知位置的节点可以常数时间移除或移动。
只有哈希表,没有新旧顺序;只有链表,则查找指定键要线性扫描。链表在这里不是负责搜索,而是负责重排已定位的节点。
一次访问怎样改变顺序
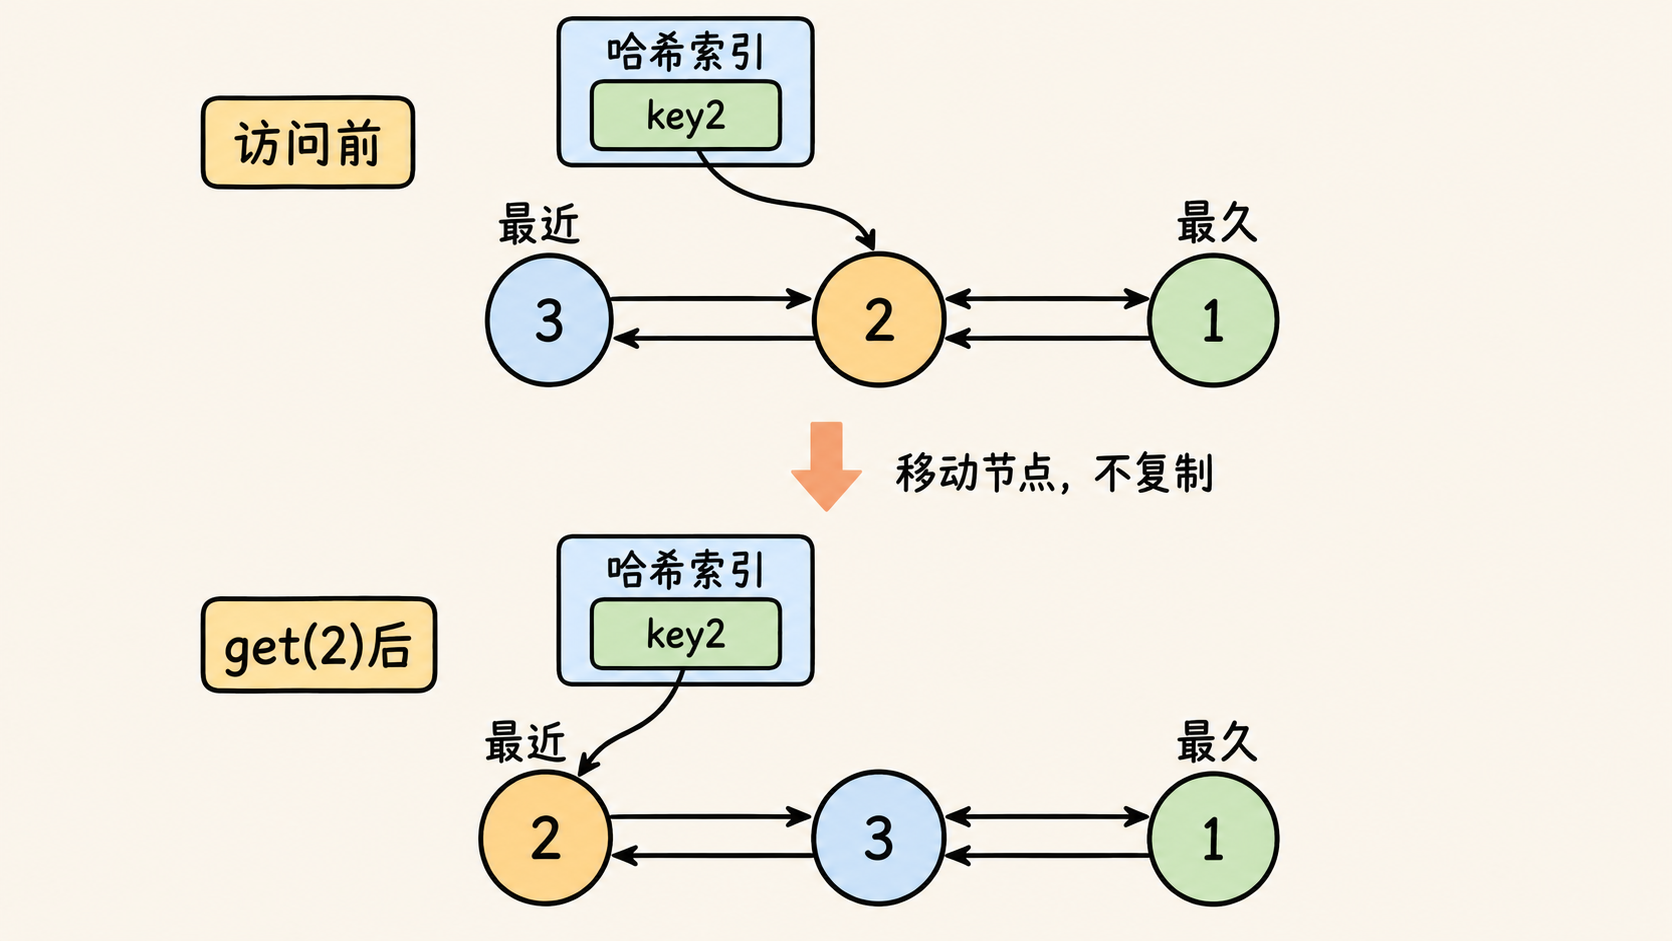
原顺序为最近 3 → 2 → 1 最久,成功读取 2 后变为 2 → 3 → 1。节点 2 本身被移动,不复制出第二个键 2;节点 1 仍然最久。
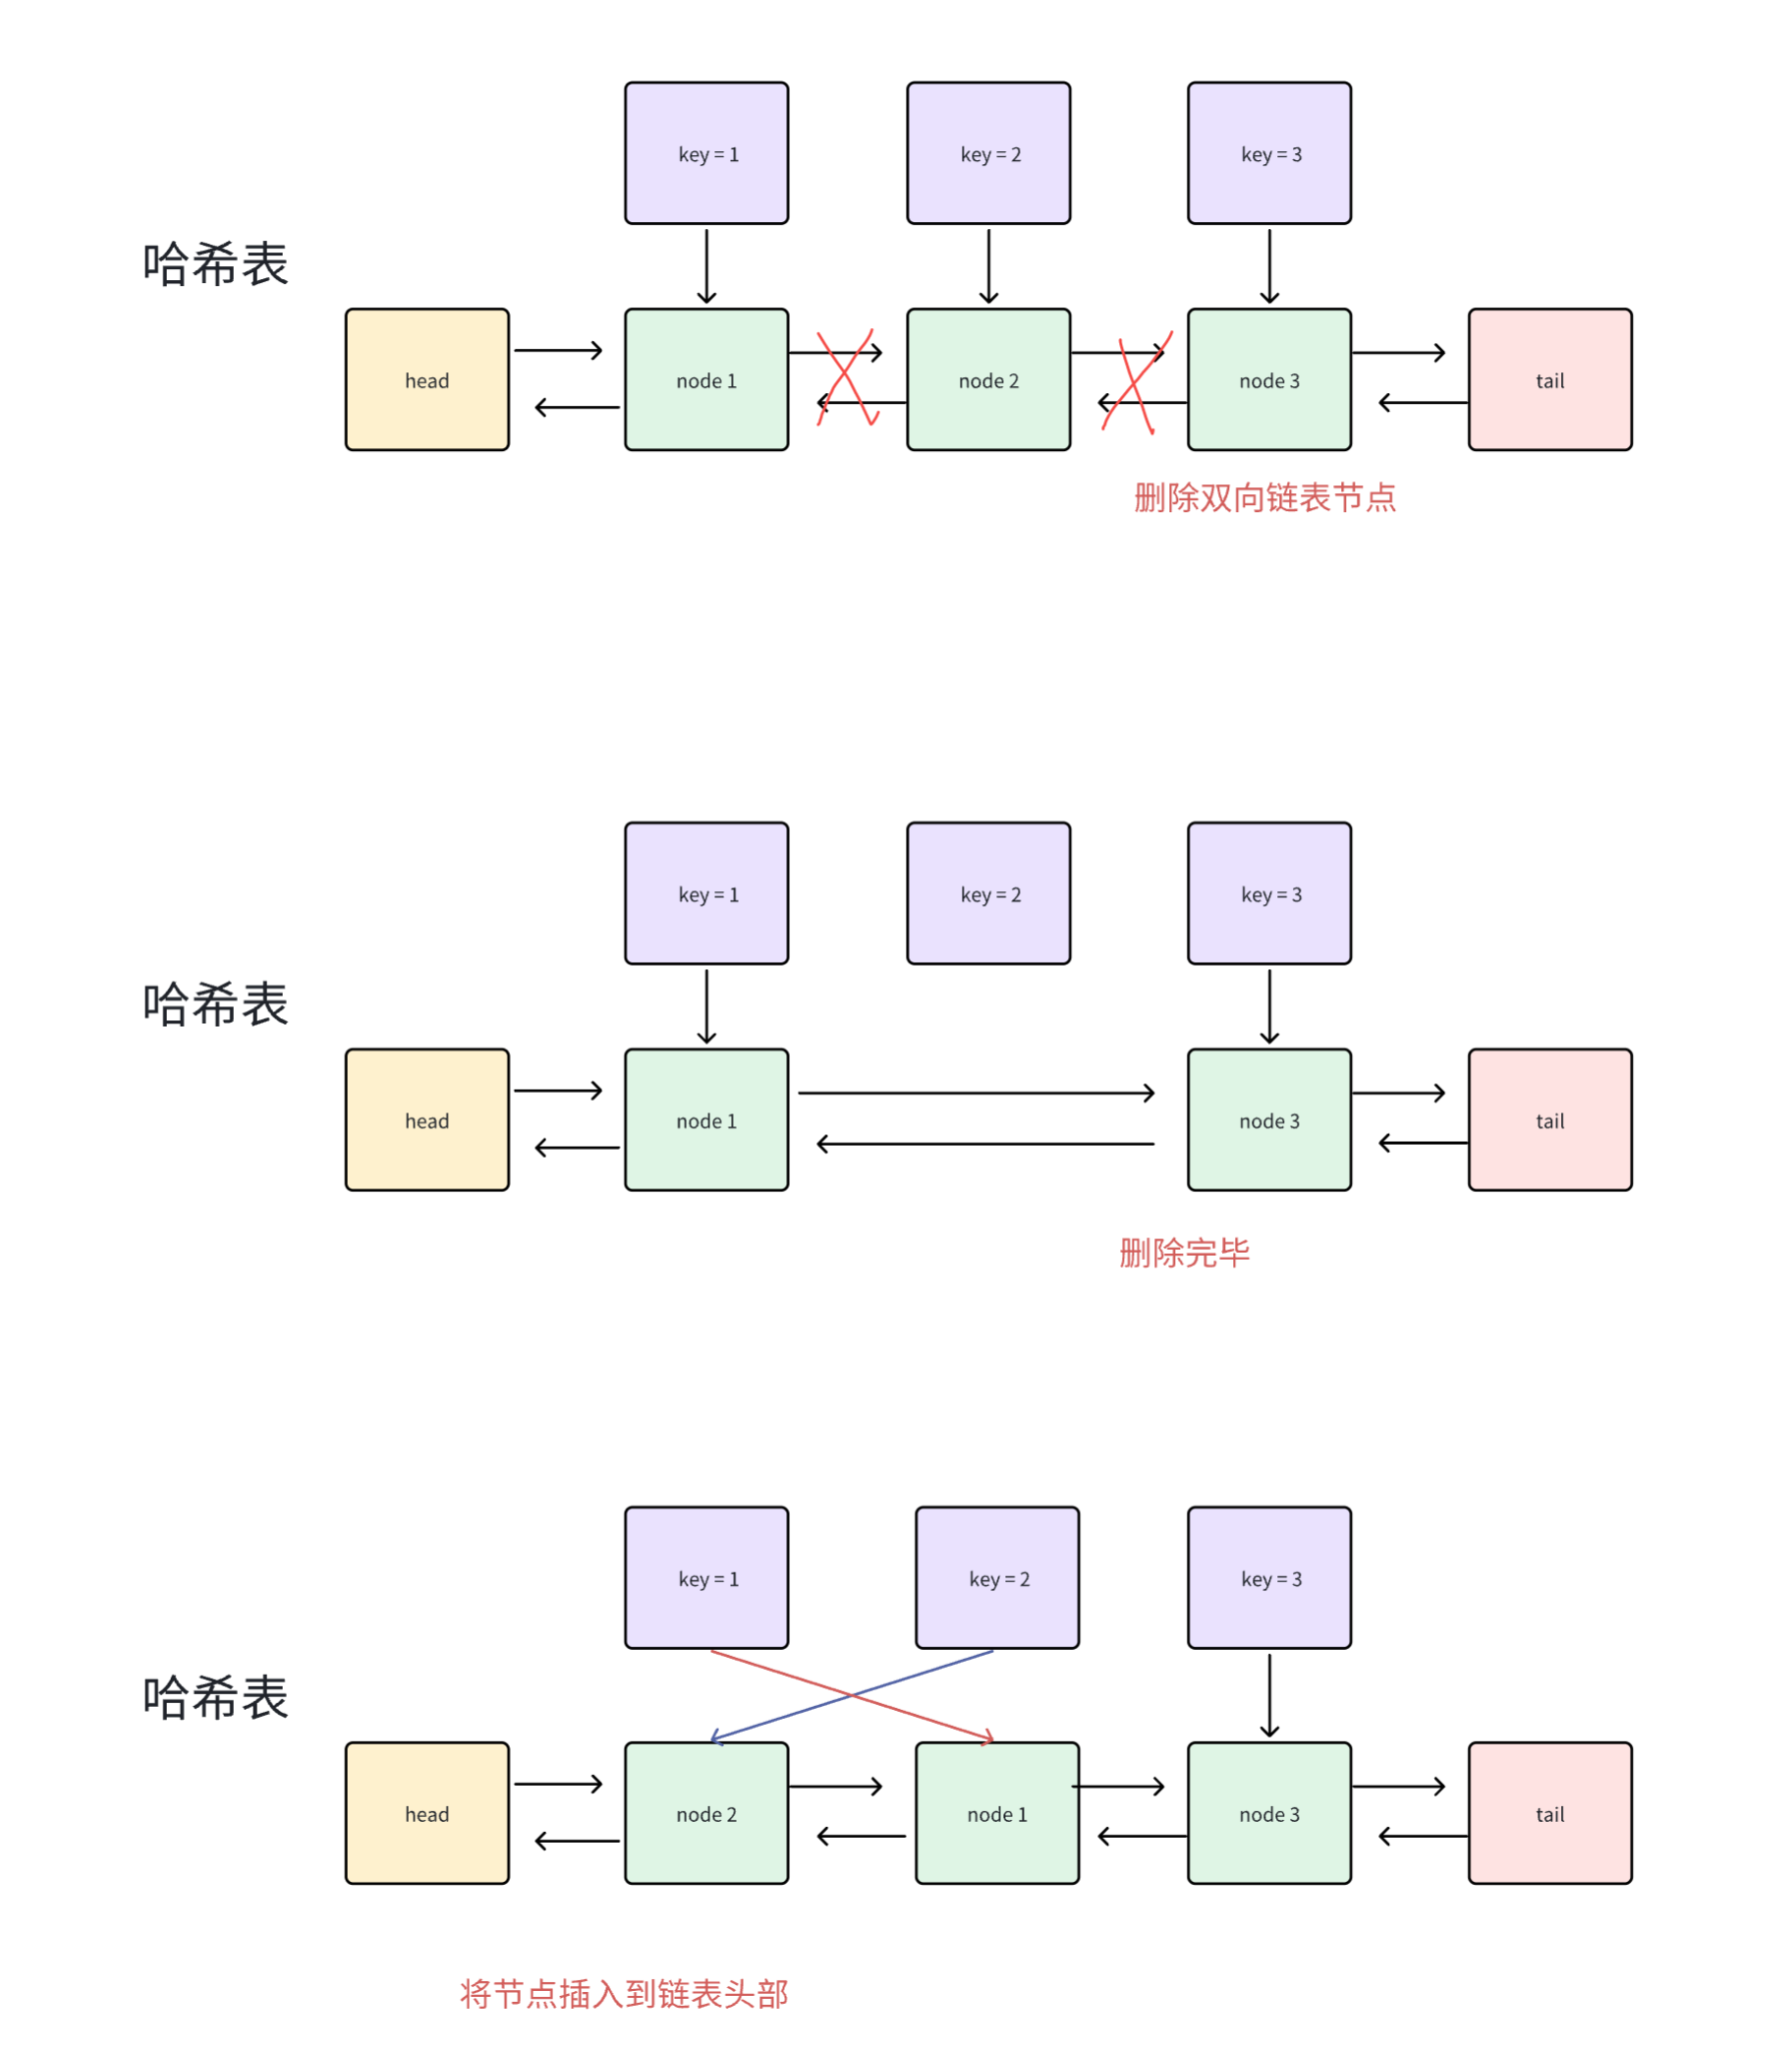
更新旧键也属于一次使用,所以要移动到表头。插入新键时,若容量已满,先删除表尾及其哈希映射,再在表头插入新项。两个结构必须同步更新,否则会留下悬空迭代器或不可达数据。
C++17 实现
#include <cstddef>
#include <list>
#include <unordered_map>
#include <utility>

class LRUCache {
 public:
  explicit LRUCache(int capacity)
      : capacity_(capacity > 0 ? static_cast<std::size_t>(capacity) : 0) {}
  LRUCache(const LRUCache&) = delete;
  LRUCache& operator=(const LRUCache&) = delete;

  int get(int key) {
    auto found = positions_.find(key);
    if (found == positions_.end()) return -1;
    items_.splice(items_.begin(), items_, found->second);
    return found->second->second;
  }

  void put(int key, int value) {
    if (capacity_ == 0) return;
    auto found = positions_.find(key);
    if (found != positions_.end()) {
      found->second->second = value;
      items_.splice(items_.begin(), items_, found->second);
      return;
    }
    if (items_.size() == capacity_) {
      positions_.erase(items_.back().first);
      items_.pop_back();
    }
    items_.emplace_front(key, value);
    positions_[key] = items_.begin();
  }

 private:
  std::size_t capacity_;
  std::list<std::pair<int, int>> items_;
  std::unordered_map<int, std::list<std::pair<int, int>>::iterator> positions_;
};
splice 在同一链表中移动单个节点,不使这个节点的迭代器失效,所以哈希表中的记录不必重新寻找。拷贝操作被删除,避免复制后迭代器还指向原链表。
复杂度与边界
链表操作为 O(1),哈希表查找平均 O(1),因此 get、put 平均 O(1),并非最坏常数界;容量为 C 时空间 O(C)。
这是单线程题目实现,没有锁,也没有提供内存分配失败后的强异常保证。生产缓存还需要按需求考虑过期时间、并发、容量计量和异常处理,不能仅凭“LRU”三个字就认为这些能力已经齐备。
常见误区
LRU 不等于按插入时间排序;成功读取会改变顺序,失败读取不会。也不能在链表节点已经删除后保留哈希迭代器。容量为1、重复更新同一键、读取后再淘汰,是比单纯插入两条数据更有效的验证用例。