01、时间空间复杂度分析
算法分析不是猜“这段代码跑几毫秒”,而是观察:输入规模增长时,需要做的工作和占用的空间怎样增长。它帮助我们解释为什么某个方案在小样本里可用,换成大输入就不可行。
先确定输入规模与统计口径
数组题的规模可能是元素个数 n,图算法可能同时需要顶点数 V 和边数 E,整数题也可能需要输入的二进制位数。不能所有问题都只写一个 n,却不说明它代表什么。
接着确定分析最坏、平均还是某次操作的摊还成本。一次快速运行不证明最坏复杂度,哈希表的平均常数查找也不等于每次都只做一次比较。
时间复杂度描述增长上界
若存在正常数 c 与 n₀,使所有 n >= n₀ 都满足 T(n) <= c·f(n),就能写 T(n) = O(f(n))。常见的“去掉常数项、保留最高阶项”是在已得到执行次数表达式后简化,而不是跳过循环边界的分析。
例如 3n² + 5n + 8 的常用紧上界是 O(n²)。严格说它也属于更宽松的 O(n³);需要强调同阶上下界时用 Θ,不要把大 O 当作精确运行次数。
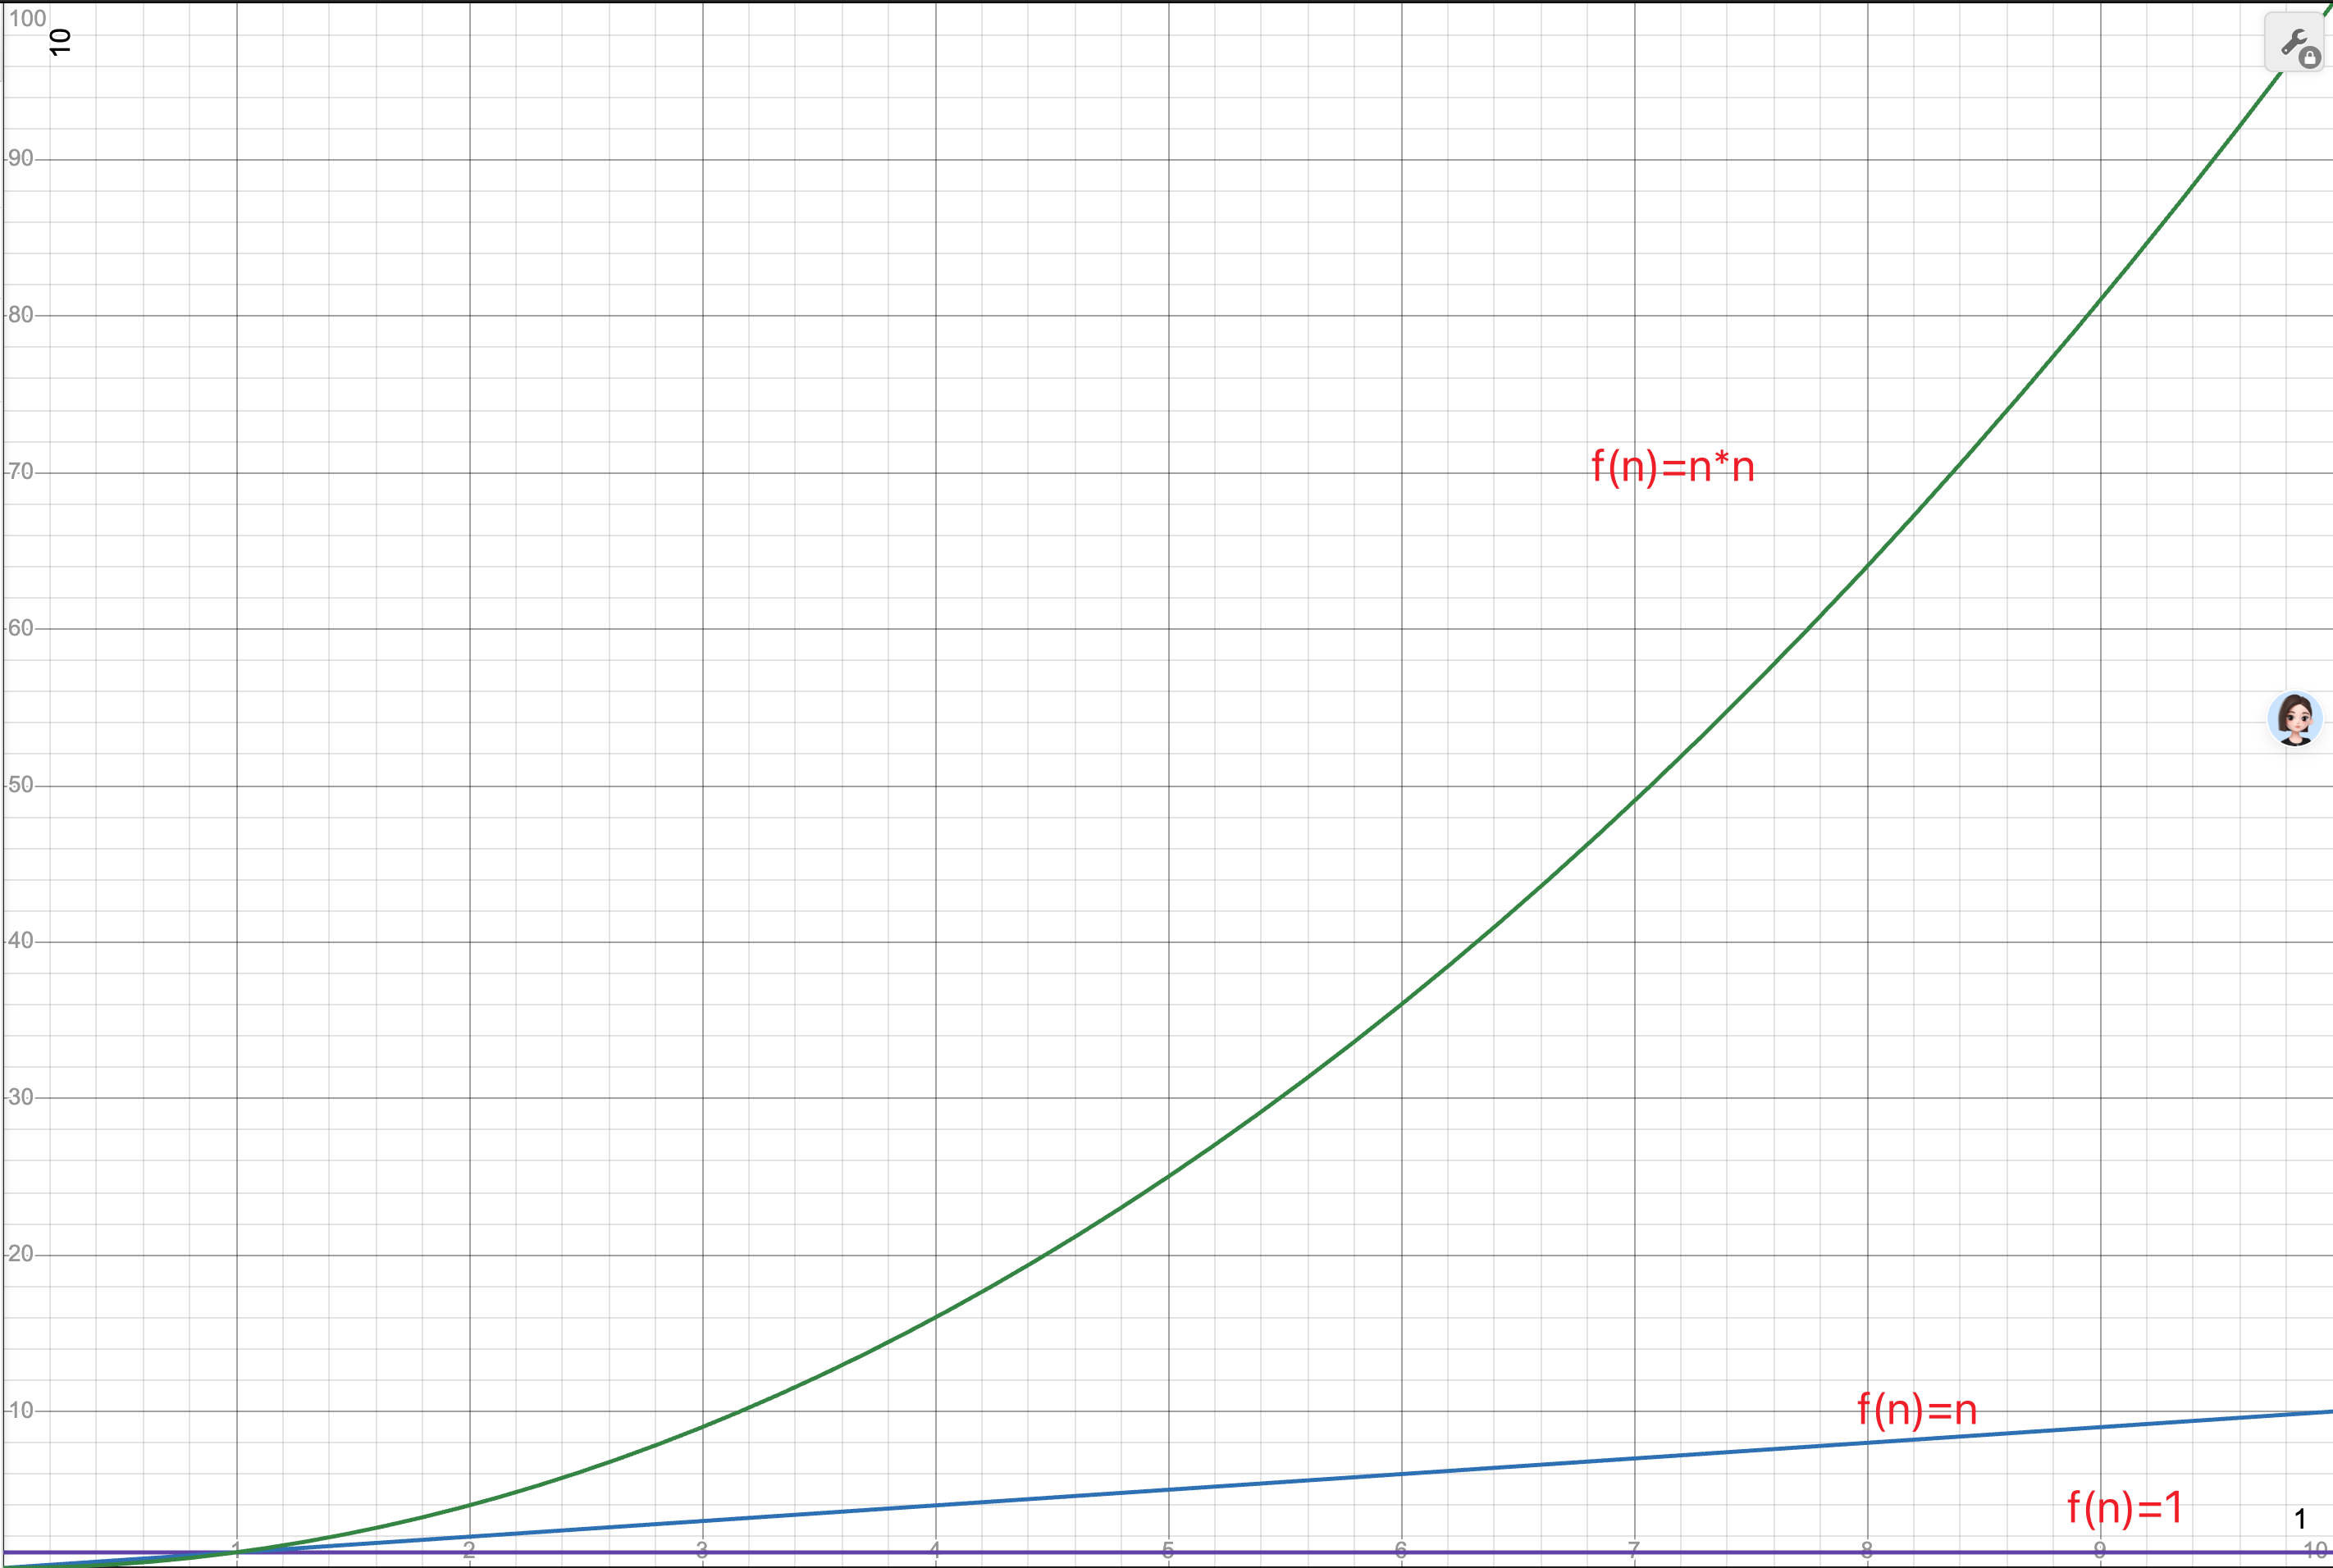
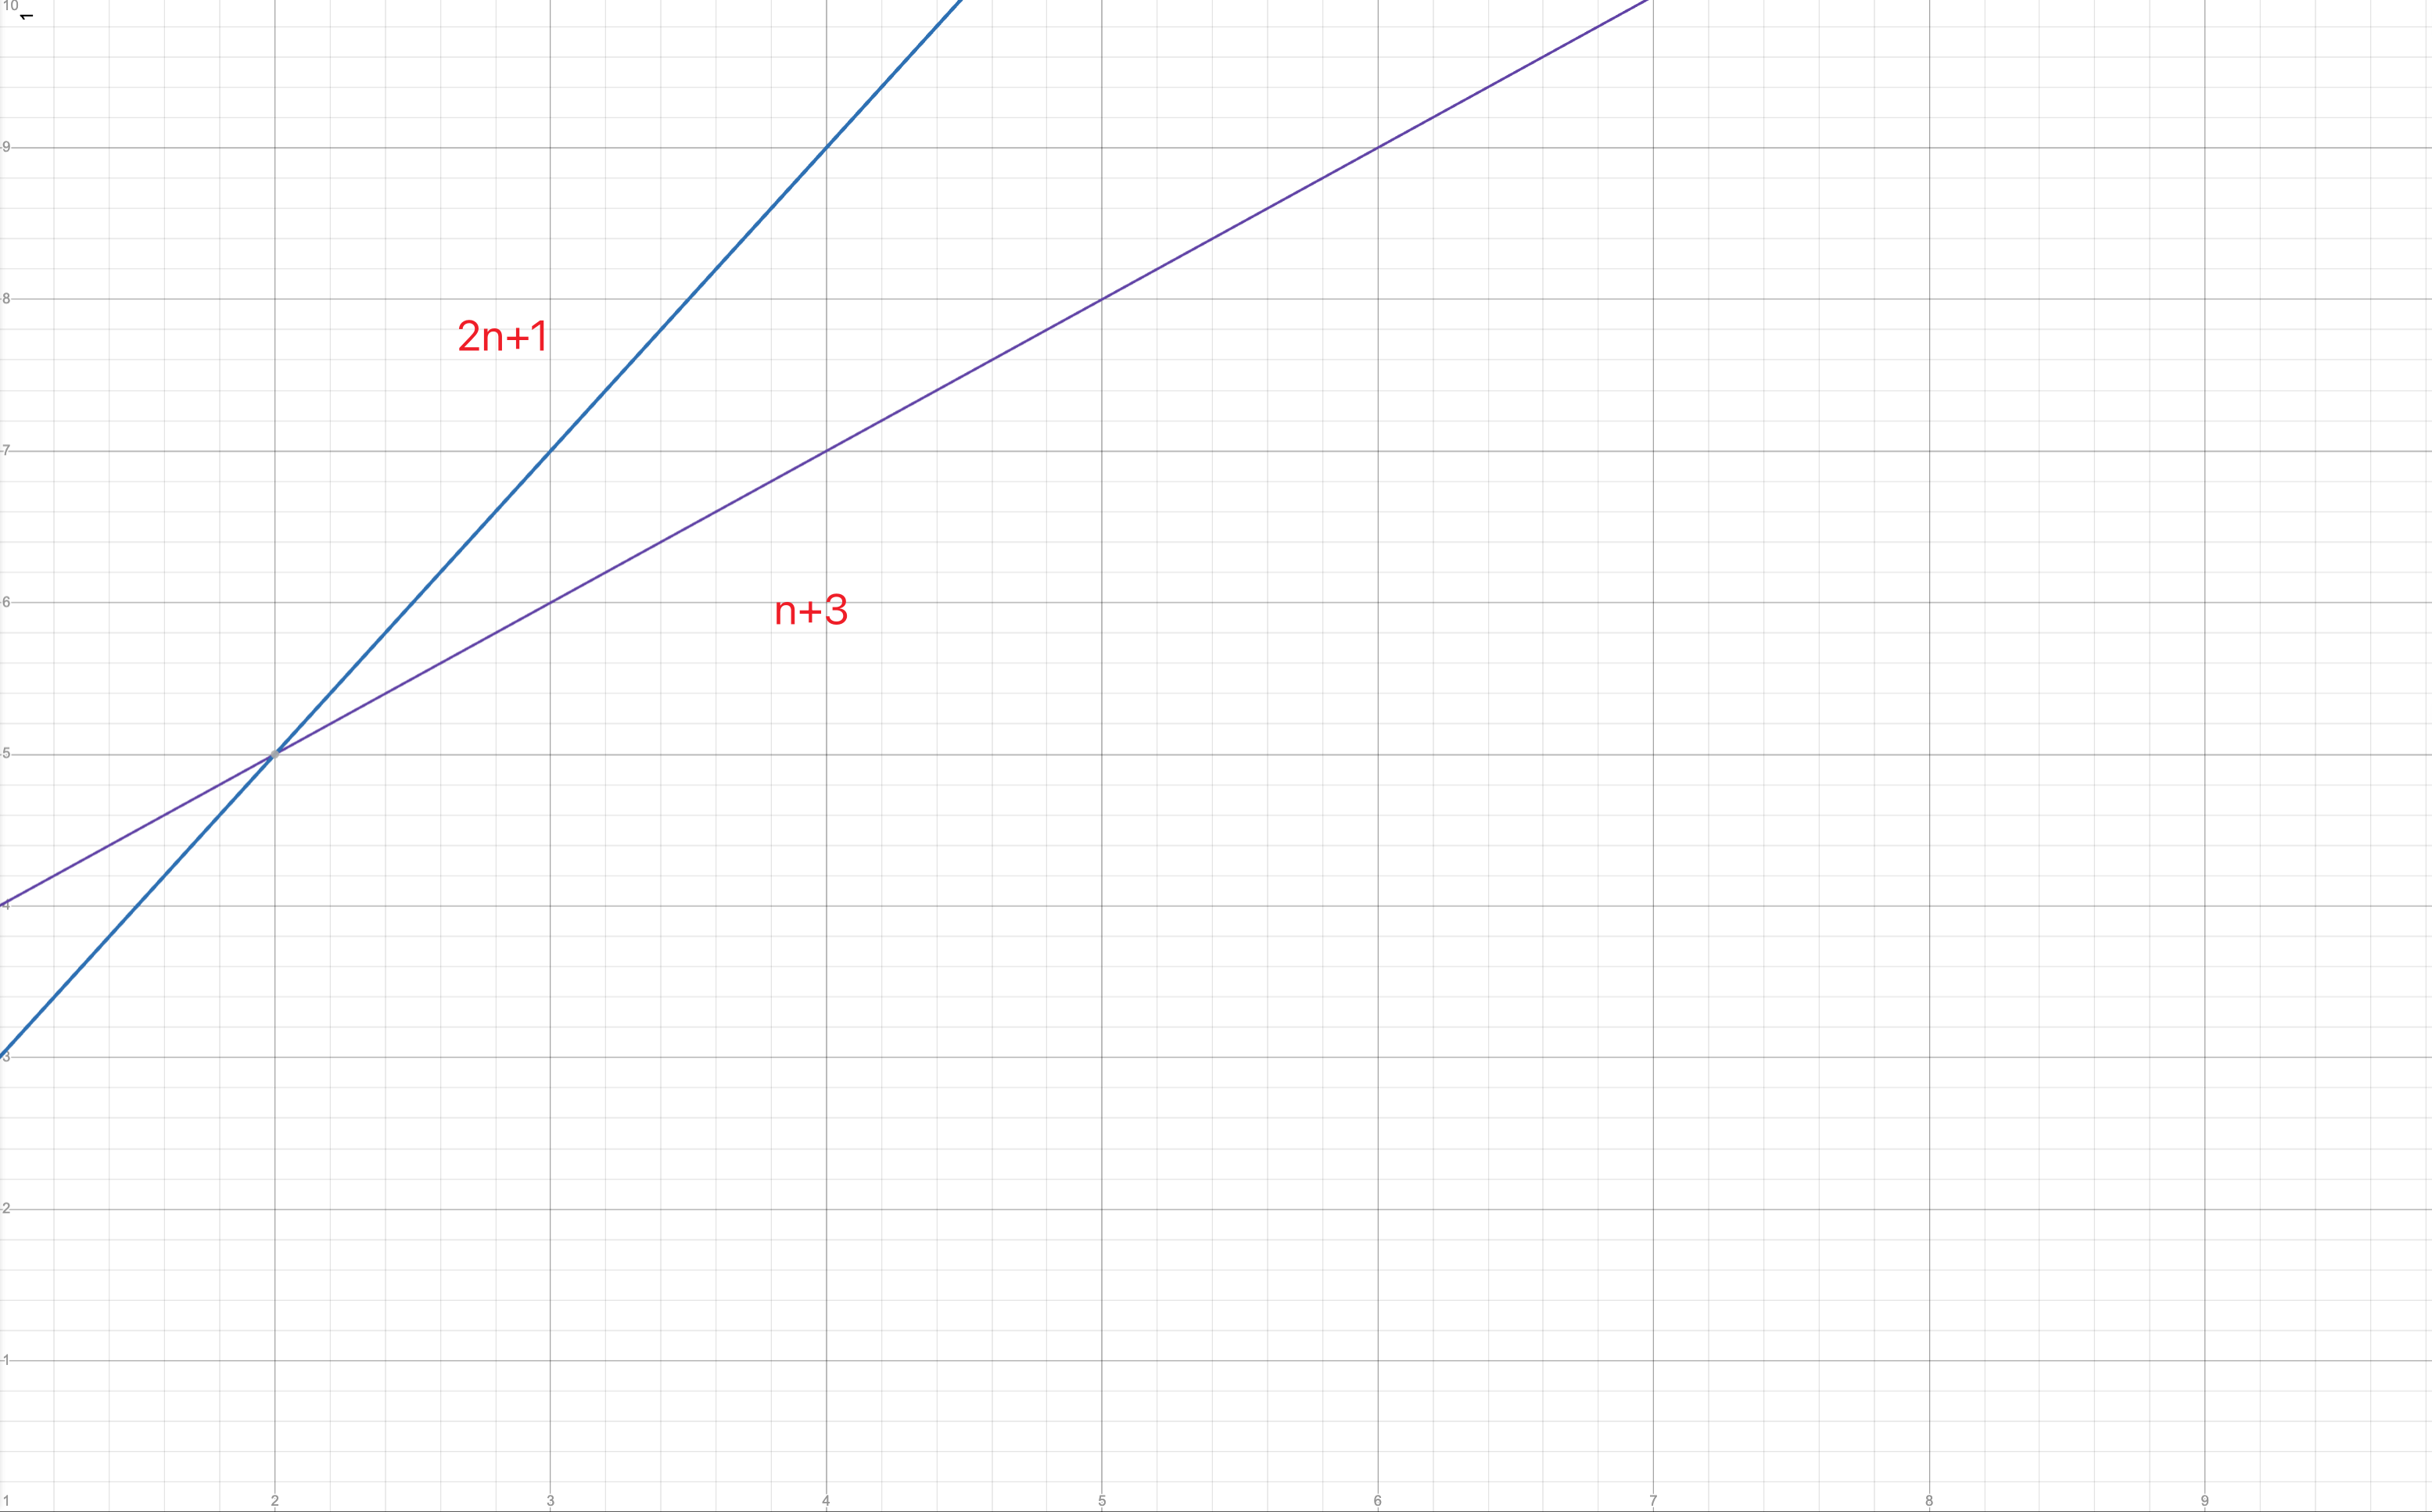
常数项在渐进记号中被忽略,不表示实际工程里不重要;小输入、缓存命中、分配次数与编译优化仍会影响真实时间。
常见代码模式怎样数
- 连续执行两个各扫 n 项的循环:总量
n+n,是O(n),不是相乘。 - 两层独立循环都执行 n 次:总量
n²,是O(n²)。 - 内层从 i 开始到 n:总量是等差数列,仍为
O(n²),不是因为内层变短就变成线性。 - 每次将搜索区间缩小一半:需要
O(log n)轮,前提是每轮其他工作为常数量级。 - 递归不能只数代码里出现几个调用:应结合子问题数量、规模和每层额外工作推导。
可运行的计数例子
这段 C++17 程序只计数,不用不稳定的计时结果替代复杂度推导。运行规模固定为 4,避免把演示写成耗时的大型基准。
#include <cstdint>
#include <iostream>

std::uint64_t linearCount(int n) {
  std::uint64_t count = 0;
  for (int i = 0; i < n; ++i) ++count;
  return count;
}

std::uint64_t squareCount(int n) {
  std::uint64_t count = 0;
  for (int i = 0; i < n; ++i) {
    for (int j = 0; j < n; ++j) ++count;
  }
  return count;
}

int main() {
  std::cout << linearCount(4) << ' ' << squareCount(4) << '\n';
}
输出 4 16。计数变量虽然存储了较大的数字,变量本身占用的存储没有随循环次数增加。
空间复杂度不要漏掉调用栈
辅助空间通常统计输入之外、算法为完成任务而额外占用的空间;是否排除输出必须说明。本文把结果空间单列,避免“返回一个大结果,却声称整体常量空间”。
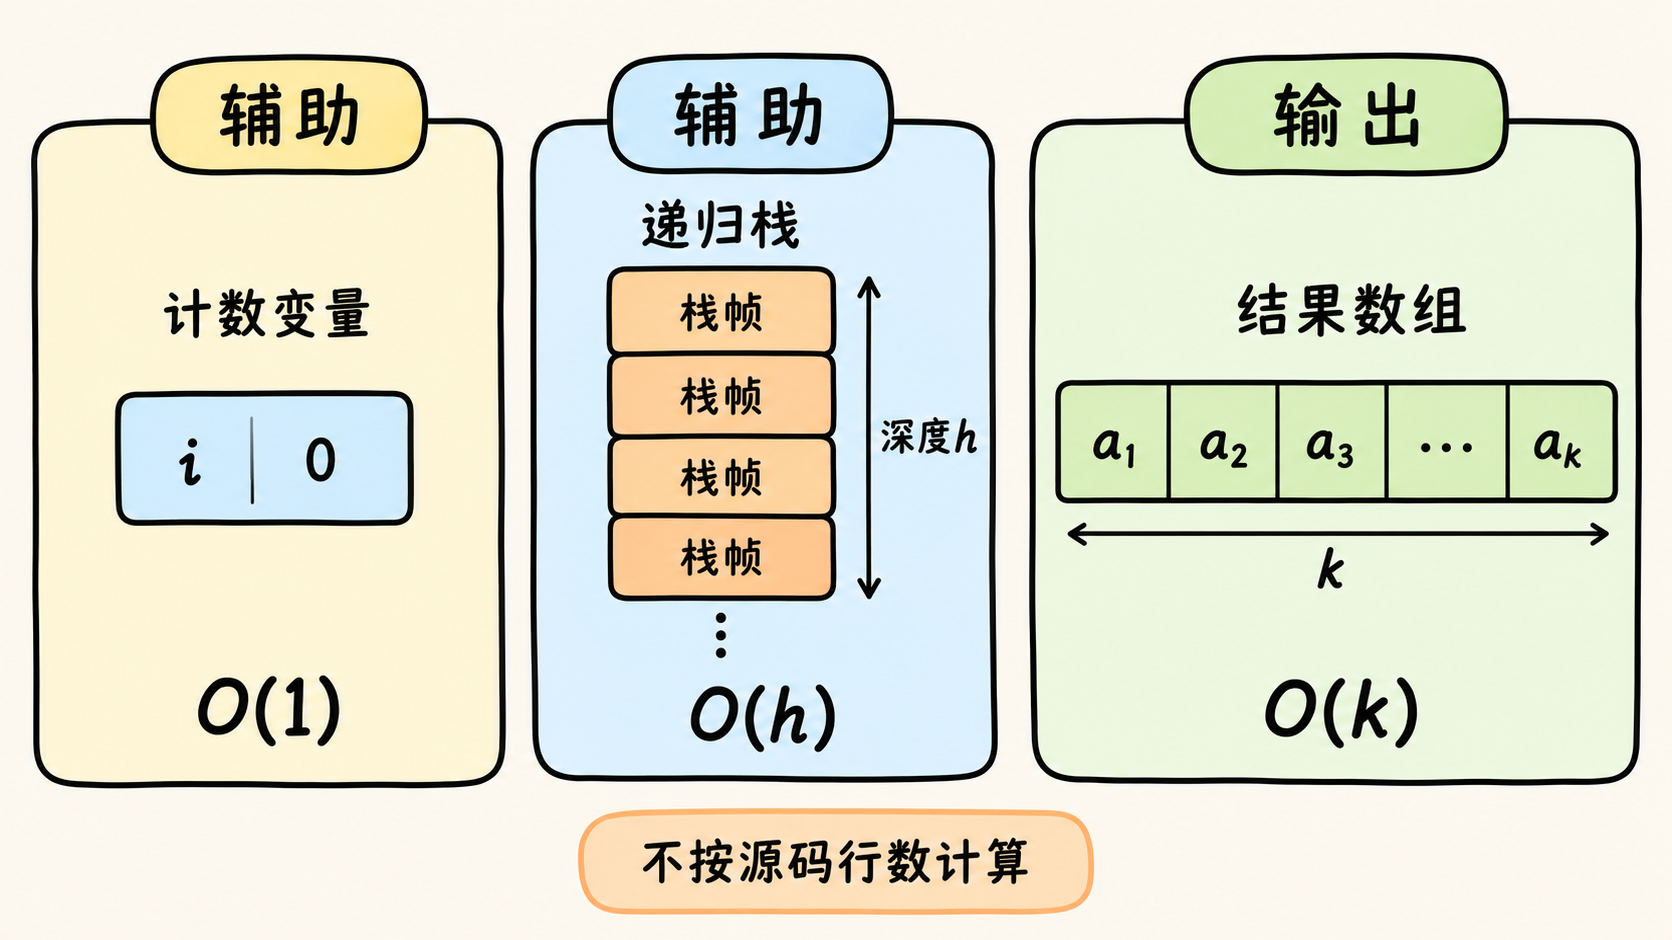
一个在循环中重复使用的计数器占常量辅助空间;创建 n 个元素的数组需要 O(n);深度 h 的递归链,即使每层只有几个变量,也需要 O(h) 调用栈。
递归树的总节点数决定总工作量,而同一时刻仍未返回的调用链决定栈占用,二者不是同一个数。遍历二叉树访问 n 个节点,栈空间可为树高 h;枚举所有子集则还要计入指数级输出。
平均、最坏与摊还不能混写
哈希容器在合理散列条件下平均查找为常数,但严重冲突时可能退化;动态数组某次扩容需要移动多个元素,却可以在特定增长策略下得到追加操作的摊还常数成本。“平均”与“摊还”依据不同,不能把两者当同义词。
面试分析时依次回答:规模是什么、每步做什么、操作总量多少、最大同时占用多少、是否包含输出。先把口径讲清,公式才有意义。