
C++ 继承与对象布局:基类子对象和构造链
05 继承会在派生对象里放进一个基类子对象
我们先看一段创建 Circle 对象的代码。你可能认为它只是把半径和圆心坐标组合在一起,但实际的构造过程会多出一些细节。
#include <iostream>#include <string>class Shape {
  std::string name_;
public:
  Shape(const std::string& n) : name_(n) {
    std::cout << "Shape ctor: " << name_ << '\n';
  }
  ~Shape() { std::cout << "Shape dtor: " << name_ << '\n'; }
  const std::string& name() const { return name_; }
};

class Circle : public Shape {
  double radius_;
public:
  Circle(const std::string& n, double r) : Shape(n), radius_(r) {
    std::cout << "Circle ctor: " << r << '\n';
  }
  ~Circle() { std::cout << "Circle dtor\n"; }
  double radius() const { return radius_; }
};

int main() {
  Circle c("red circle", 5.0);
  std::cout << "Name: " << c.name() << ", radius: " << c.radius() << '\n';
}
输出顺序是 Shape ctor → Circle ctor → (使用对象) → Circle dtor → Shape dtor。构造时基类在先,派生类在后;析构时则相反。这反映了一个底层事实:Circle 对象在内存中并不是两个独立部分的简单拼接,而是一个连续的整体。其中,前面的字节属于 Shape 的成员(即 name_),后面的字节属于 Circle 新增的成员(即 radius_)。我们所说的“基类子对象”(base class subobject),就是指嵌入在派生对象内部的基类部分。
派生对象里嵌着一个完整的基类
当一个类通过 public 继承自另一个类时,派生类的每个对象在物理内存中都包含一个完整的基类子对象。这不仅是概念上的设定,更是编译器安排对象布局的实际做法。基类的所有非静态数据成员都会进入派生对象的内存布局中。基类的成员函数可以在这个子对象上正常操作,而基类子对象的生命周期由基类的构造和析构函数来管理。
这种嵌入关系有几个重要推论。首先,派生对象不需要也不应该单独分配基类部分。基类和派生类的存储是连续的,因此 sizeof(Derived) >= sizeof(Base) + sizeof(派生新增成员)。其次,基类子对象有自己完整的生命周期。在派生类构造函数体执行前,基类构造函数就已经完成了基类子对象的初始化;而在派生类析构函数体执行完毕后,基类析构函数才会销毁该子对象。最后,通过基类的引用或指针可以操作派生对象中的基类子对象,这也是向上转换(upcast)能够成立的基础。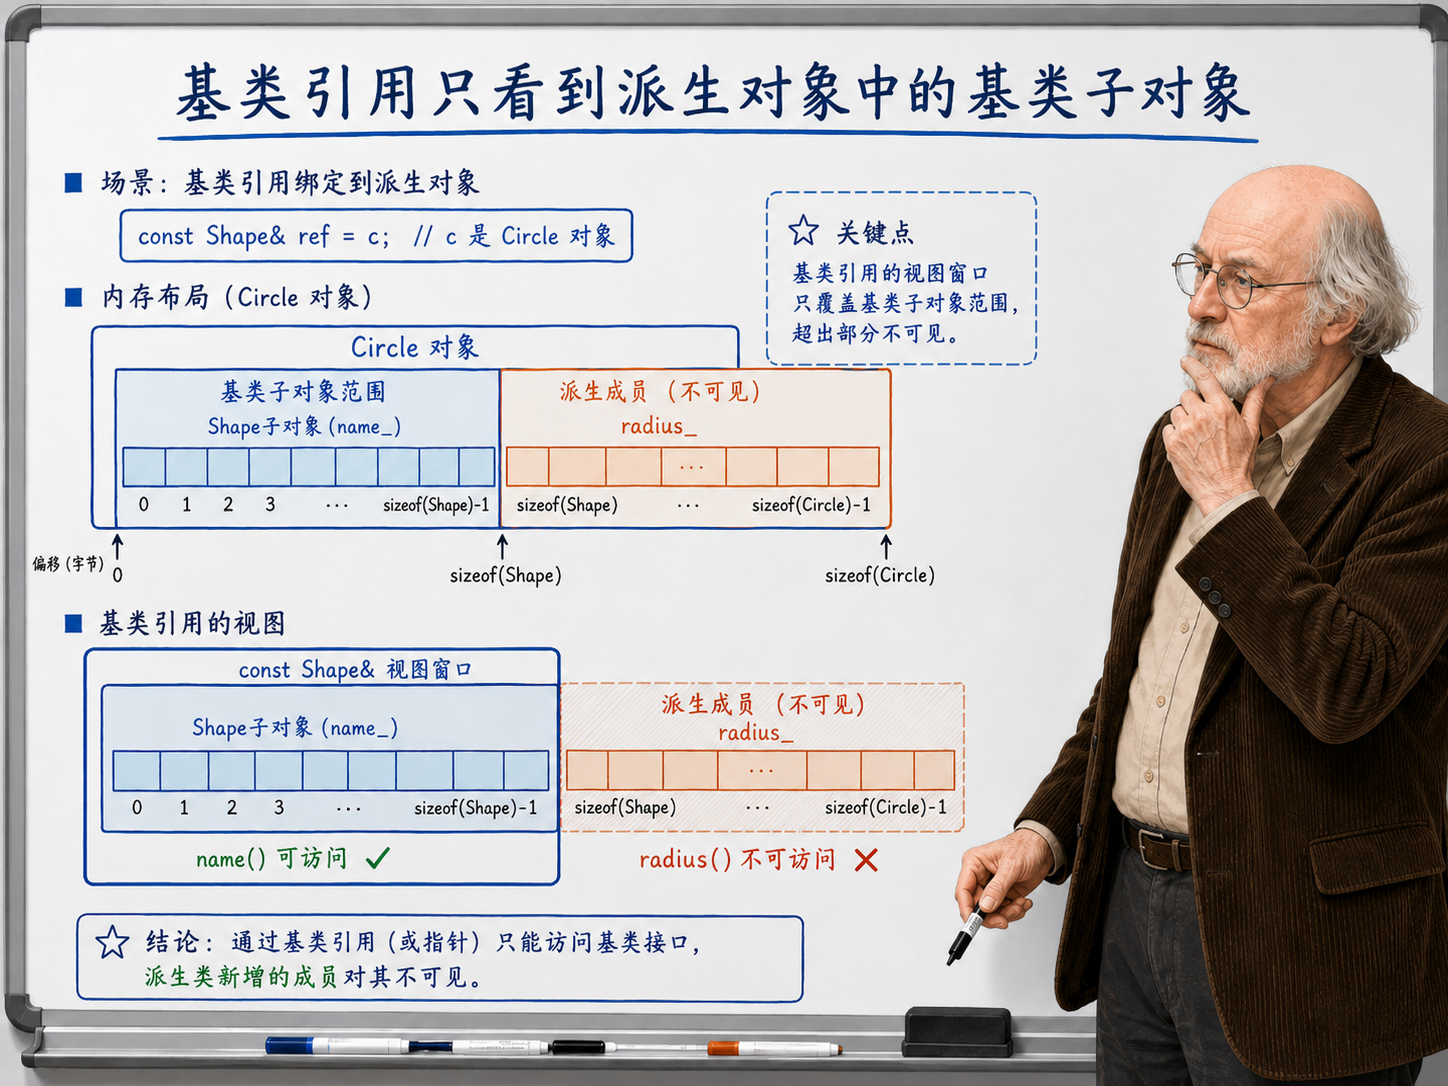
需要注意的是,sizeof 的实际结果可能大于“基类大小加上派生成员大小”。这是因为编译器可能会插入内存对齐填充,或者在涉及虚函数的类层次中加入虚表指针等辅助数据。但从根本上说,派生对象确实在内部包含了基类的完整状态,而不是持有一个指向独立基类对象的指针。嵌入式和指针式这两个模型在运行时行为和内存布局上存在本质区别,而 C++ 的继承采用的是嵌入式模型。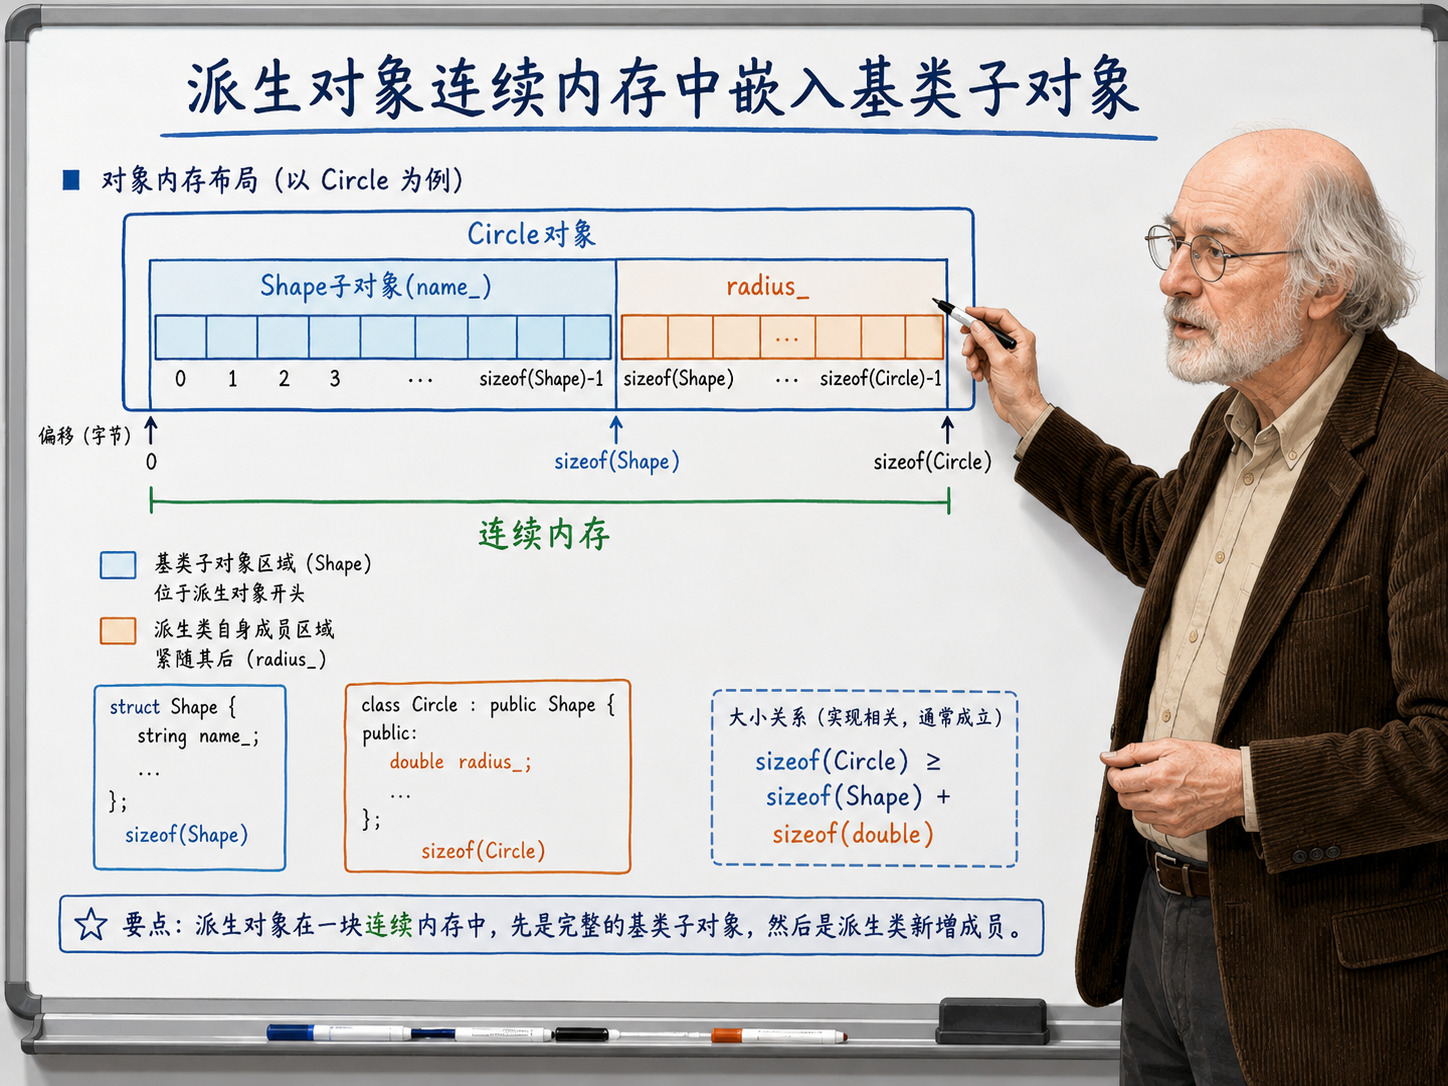
public 继承表达的是"是一个"关系
C++ 提供了 public、protected 和 private 三种继承访问权限。其中最常用的 public 继承确立了派生类与基类之间的 is-a(是一个)关系:Circle 是一个 Shape。这意味着在任何需要 Shape& 或 Shape* 的地方,都可以传入 Circle 对象,编译器会自动完成从派生类到基类的引用或指针转换。
void describe(const Shape& s) {
  std::cout << "Shape name: " << s.name() << '\n';
}

Circle c("blue circle", 3.0);
describe(c);  // Circle& 隐式转换为 const Shape&,指向基类子对象
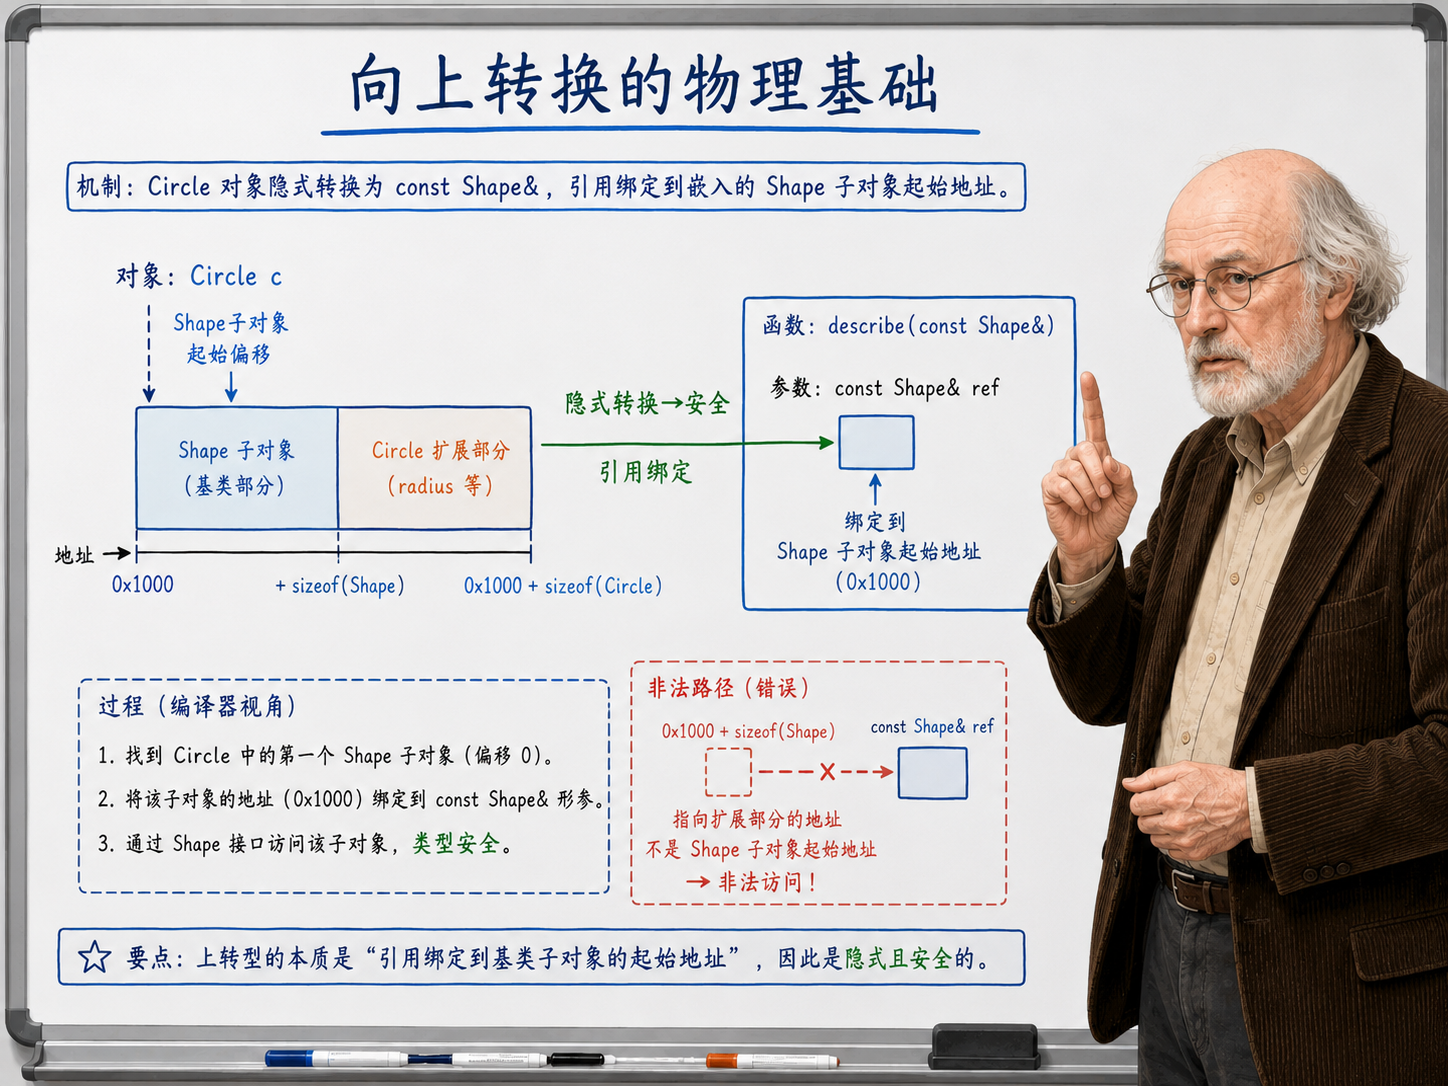
在上面的例子中,describe 接收的是 const Shape&。当传入 Circle 对象时,该引用绑定到了嵌入在 Circle 内部的 Shape 子对象上。这种转换之所以安全,正是由于基类子对象确实存在于派生对象之中。编译器只需要在指针或引用层面调整视角,无需在运行时插入代码去检查类型兼容性。从派生类指针到基类指针的转换,通常只是地址的简单偏移(如果是在单继承且基类位于对象起始位置,甚至不需要偏移)。具体如何偏移属于编译器的实现细节,而 C++ 标准保证的是这层语义:转换是有效且安全的。
is-a 关系同时也说明,基类的公开接口在派生类中自然可用。调用 c.name() 实际上执行的是 Shape::name(),编译器在派生类的作用域内找到了基类的该成员。调用方无需关心 name() 是定义在基类还是派生类,它直接作为类型的公开接口被使用。这就是继承带来的便利:派生类自动获得了基类的公共行为,从而可以把重心放在实现自身特有的逻辑上。
然而,这种关系不能反推。Shape 不一定是 Circle,因此不能将 Shape& 隐式转换为 Circle&。一个 Shape 对象可能是 Rectangle、Triangle,或者只是一个普通的 Shape 实例,内部并没有 radius_ 成员。如果确实需要进行向下转换(downcast),必须显式地使用 static_cast 或 dynamic_cast,而且只有当对象的实际动态类型确实是目标类型时,转换才是安全的。static_cast 不执行运行时检查,转换错误会导致未定义行为;dynamic_cast 会进行检查,但前提是基类中至少包含一个虚函数。关于向下转换的具体机制和风险,我们会在虚函数相关章节中详细讨论。
构造从基到派生,析构反向
C++ 对构造顺序有明确的规定:首先构造基类,然后按照声明顺序构造派生类的非静态数据成员,最后执行派生类构造函数体内的代码。如果派生类的构造函数没有在初始化列表中显式调用基类的构造函数,编译器会自动尝试调用基类的默认构造函数。如果基类没有默认构造函数,就会导致编译失败。
因此,除非基类提供了默认构造函数,否则必须在派生类构造函数的初始化列表中显式调用基类的构造函数。代码 Circle(const std::string& n, double r) : Shape(n), radius_(r) {} 中的 Shape(n) 就起到了这个作用。它在派生类构造函数体执行之前,将基类子对象初始化完毕。这是唯一正确的做法,不要试图在派生类的构造函数体内对基类成员进行赋值。因为在进入构造函数体之前,基类子对象已经构造完成,此时的赋值操作只是对已有对象状态的修改,而不是初始化。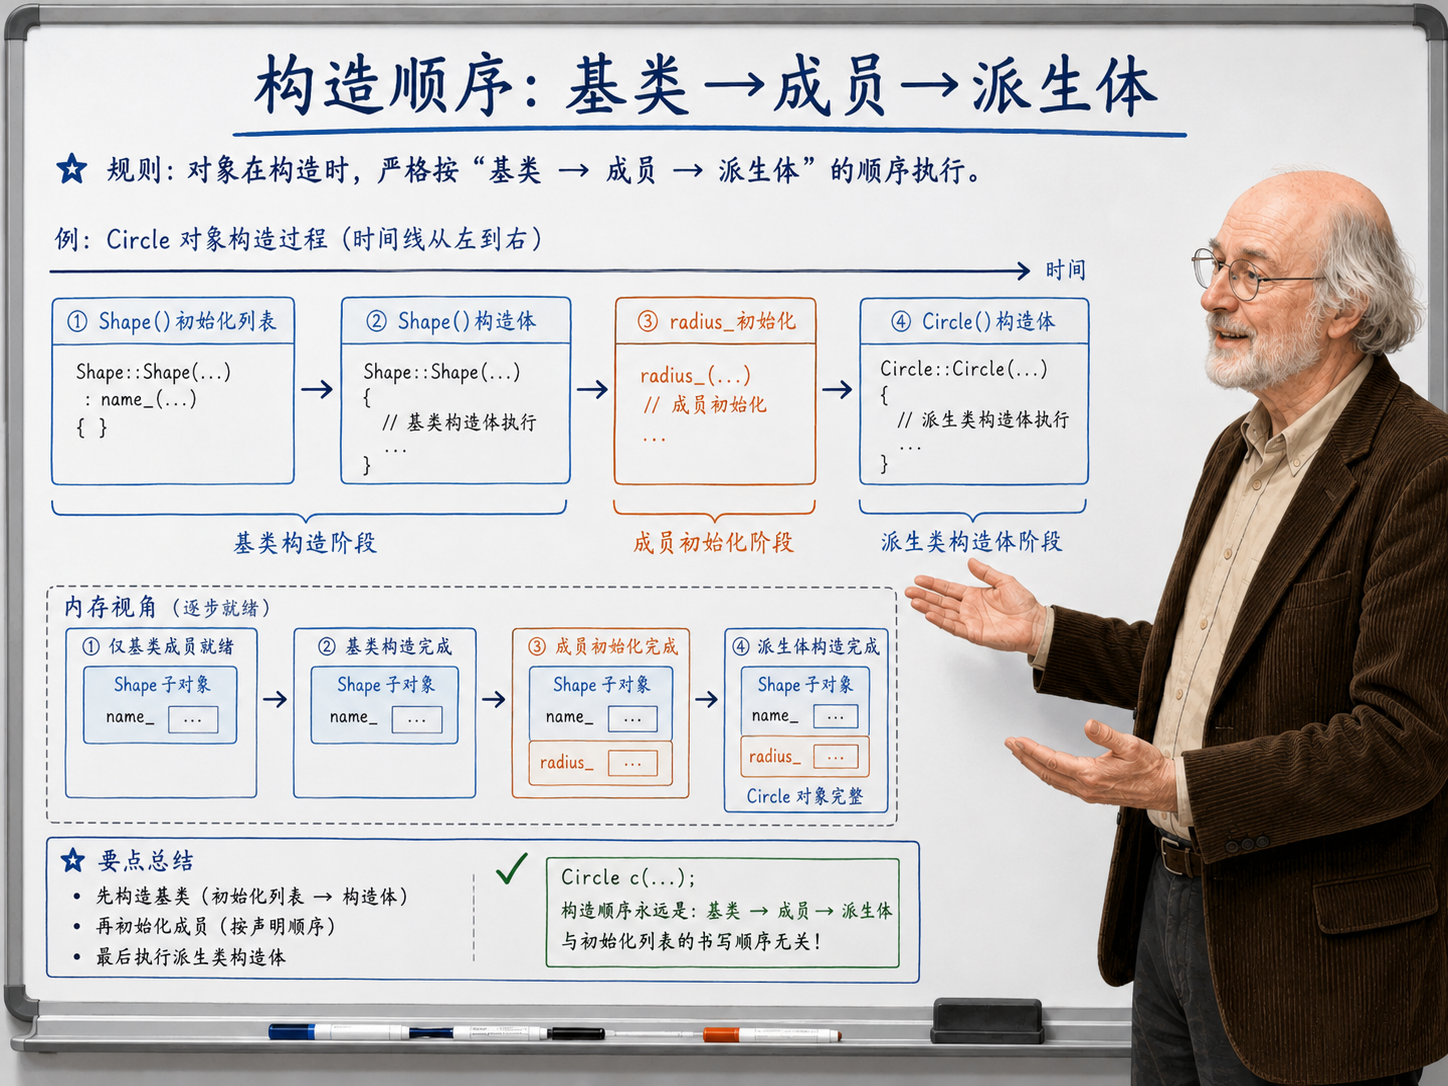
将构造顺序设定为“基类优先”并非随意规定。由于派生类的成员函数和构造函数体天然具备访问基类成员的权限,如果基类子对象尚未初始化,那么在派生类构造函数体中访问基类成员(例如读取一个 std::string),就相当于操作未初始化的内存,这将导致未定义行为。因此,必须先确保基类子对象处于合法状态,后续的操作才安全。这一规则也解释了为什么虚基类在构造时优先级最高:虚基类可能被多个派生类共享,必须保证在任何可能用到它的派生类构造之前,它已经完全初始化。
对象的析构顺序则完全相反:先执行派生类的析构函数体,然后按构造时的逆序销毁派生类成员,最后销毁基类子对象。这种逆序销毁是语言强制保证的,异常时的栈展开过程也遵循相同的顺序。如果在构造过程中发生异常,只有已经完全构造完毕的子对象(包括基类子对象和已初始化的成员)才会被析构,且同样遵循逆序原则,以此确保资源被正确释放。例如,如果 Circle 在初始化 radius_ 时抛出异常,由于 Shape 子对象已经构造完成,它的析构函数会自动执行,从而避免资源泄漏。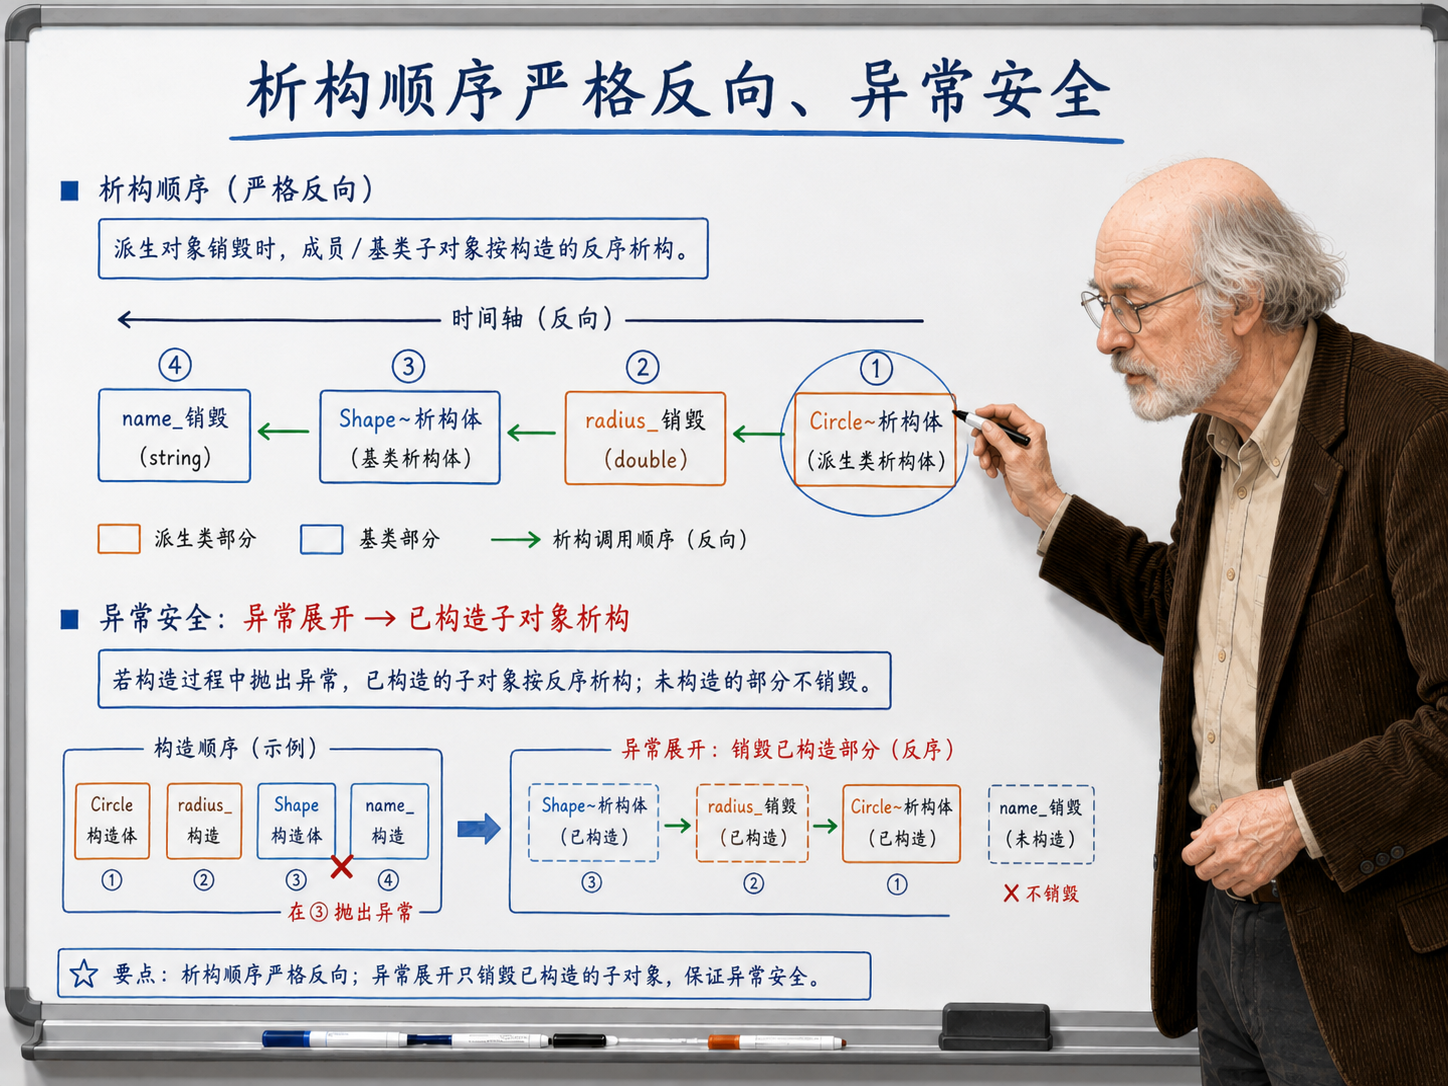
在多级继承链中,构造过程会顺着继承链逐级向上委托。直到最顶层的基类构造完成后,再逐级向下执行各层派生类的初始化列表和构造函数体。这种由内向外的构造顺序,保证了每一层构造函数体执行时,其底层的基类部分都已初始化并稳定可用。相对地,析构过程从最外层的派生类开始,逐层向内释放资源,最后销毁最底层的基类子对象。这就像拆除建筑,必须先拆除外墙和装饰,最后才能拆除承重结构,而不能直接从地基开始。
这一构造和析构顺序引出了一个重要结论:在基类的构造函数和析构函数执行期间,对象的动态类型被视为基类本身,而不是最终的派生类型。因为此时派生类部分要么尚未构造,要么已经销毁。如果在基类的构造函数中调用虚函数,实际执行的是基类的版本,而非派生类覆盖后的版本。这是 C++ 标准明确规定的行为,不依赖于编译器的具体实现,虚函数章节将对此进行深入讨论。
protected 和 private 继承:两种受限制的基类关系
如果说 public 继承表达的是“Circle 是一个 Shape,并且对外公开”,那么 protected 和 private 继承建立的就不是 is-a 关系,而是“根据某类来实现”(is-implemented-in-terms-of)。在这两种情况下,基类的接口不会暴露给派生类的外部使用者。
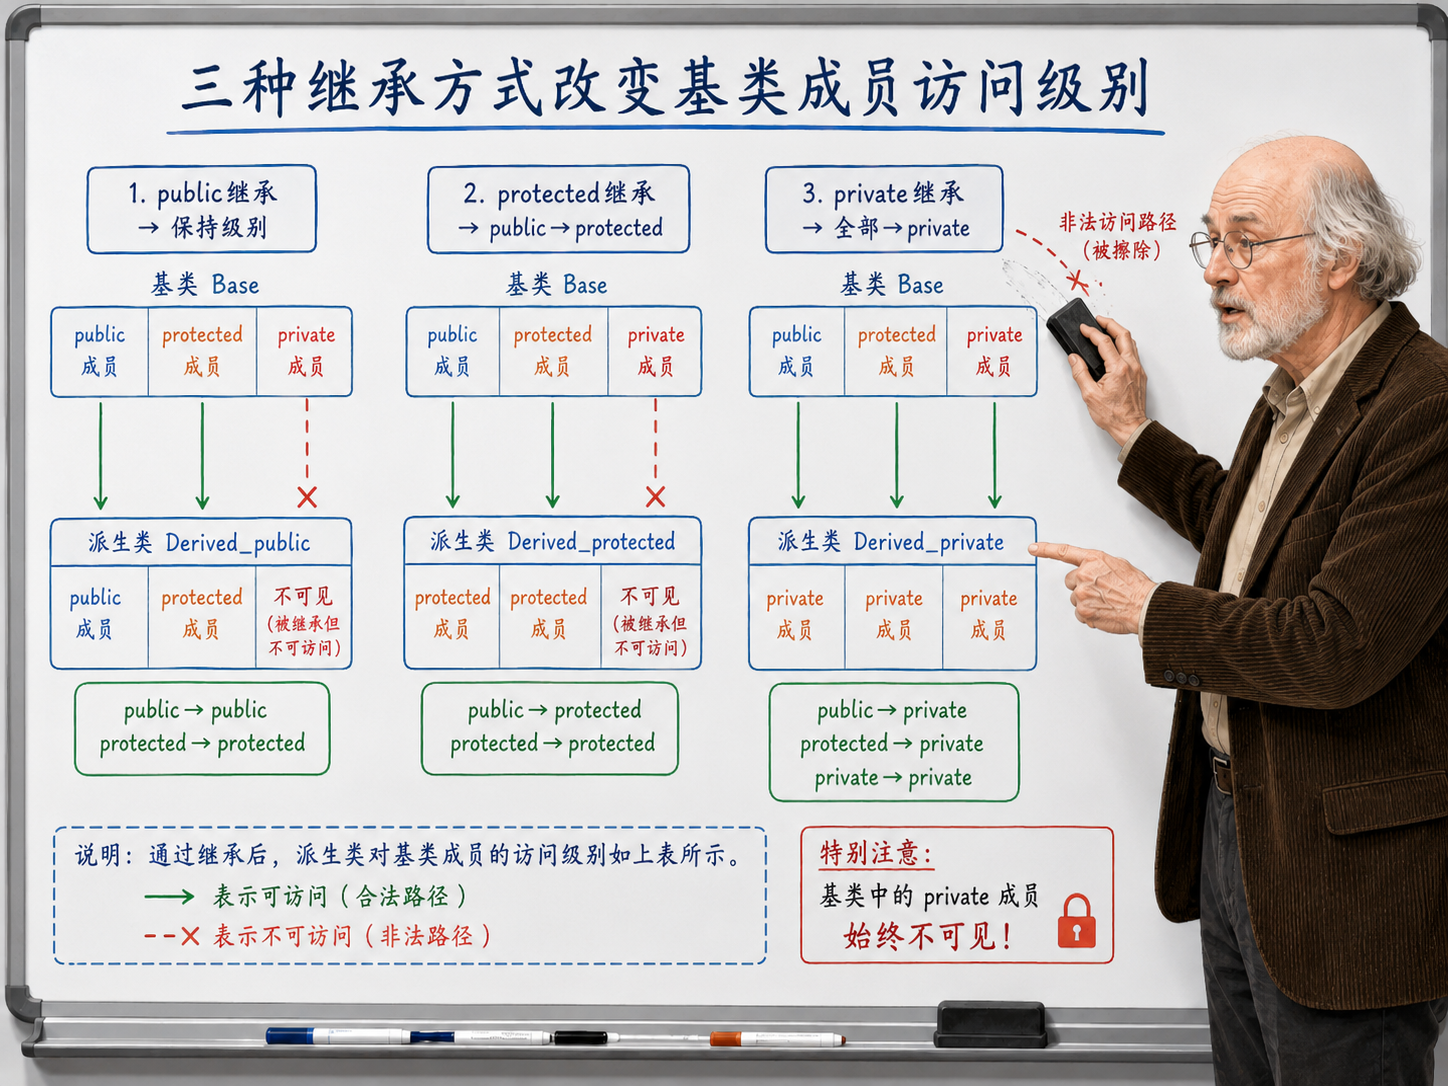
protected 继承会将基类的所有公开成员在派生类中降级为 protected 级别。这意味着派生类及其后续的派生类可以访问基类的公开和保护成员,但外部代码无法通过派生类对象访问这些接口。private 继承则更为严格,它将基类的公开和保护成员在派生类中全部降级为 private,使得连后续的派生类也无法看到基类的接口。
class Engine {
public:
  void start() {}
  void stop() {}
};

class Car : private Engine {  // Car 用 Engine 实现,但外界不能把 Car 当 Engine 用public:
  void drive() { start(); /* ... */ stop(); }  // 内部可以调用基类方法
};

Car car;
car.start();     // 错误:start 在 Car 中是 private
Engine& e = car;  // 错误:private 继承不允许向上转换
private 继承在语义上与组合(composition)非常相似,二者都表示“拥有一个”的关系,即被复用的功能仅在内部使用。在大多数情况下,组合比 private 继承更加直观和灵活。使用组合,你可以持有多个同类型的成员,可以通过指针或 std::optional 在运行时决定成员的存在与否,并且无需处理基类构造和析构的复杂顺序。private 继承不可替代的优势仅在于:它可以覆盖基类的虚函数,并能利用空基类优化(EBO)。这些通常属于较高级或边缘的使用场景。一般原则是:如果能用组合解决问题,就尽量避免使用 private 继承。
成员访问控制与继承访问控制是两套独立规则
初学者常常容易将两个概念混淆:类成员的访问控制符与继承方式的访问控制符。虽然它们使用了相同的关键字(public、protected、private),但作用对象和规则完全不同。类成员的访问控制解决的是“谁能访问该成员”的问题,这取决于成员在类中的定义。而继承的访问控制解决的则是“基类成员在派生类中呈现为何种访问级别”的问题,这由派生类声明时的继承方式决定。
这两套规则结合后的效果可以用一个原则来概括:基类成员在派生类中的最终可访问性,取决于成员原有的访问级别与继承方式中较严格的那一个。public 继承保持基类成员的访问级别不变;protected 继承将基类的 public 成员降级为 protected;private 继承则将所有可见的基类成员降级为 private。需要强调的是,无论采用哪种继承方式,基类的 private 成员对派生类始终是不可直接访问的——private 的设计初衷就是拒绝任何外部(包括派生类)的访问。
这带来了一个直接的影响:如果希望派生类可以直接访问基类的某个成员,同时不向外部公开该成员,应该在基类中将其声明为 protected,并采用 public 继承。protected 成员对外部不可见,但对派生类开放。正如前面章节提到的原则:只有在派生类确实需要直接操作基类内部状态时,才使用 protected 数据成员。一般情况下,通过 protected 成员函数提供受控的访问,是更为安全的接口设计方式。
名字隐藏:派生类的同名声明会遮蔽基类重载
在继承场景中,C++ 的名字查找规则有一个容易被忽视的细节:如果派生类声明了与基类同名的成员(无论是函数还是数据),基类中所有同名的重载版本都会被隐藏(hidden),而不仅仅是隐藏签名相同的那一个。这种名字隐藏机制与虚函数的覆盖(override)截然不同。覆盖专指虚函数,并且要求函数签名完全匹配,而隐藏仅仅是因为名字相同而触发。
class Base {
public:
  void print(int x) { std::cout << "int: " << x << '\n'; }
  void print(double x) { std::cout << "double: " << x << '\n'; }
};

class Derived : public Base {
public:
  void print(const std::string& s) { std::cout << "string: " << s << '\n'; }
};

Derived d;
d.print(42);       // 错误!Base::print(int) 被 Derived::print(string) 隐藏了
d.print("hello");  // OK,调用 Derived::print(string)
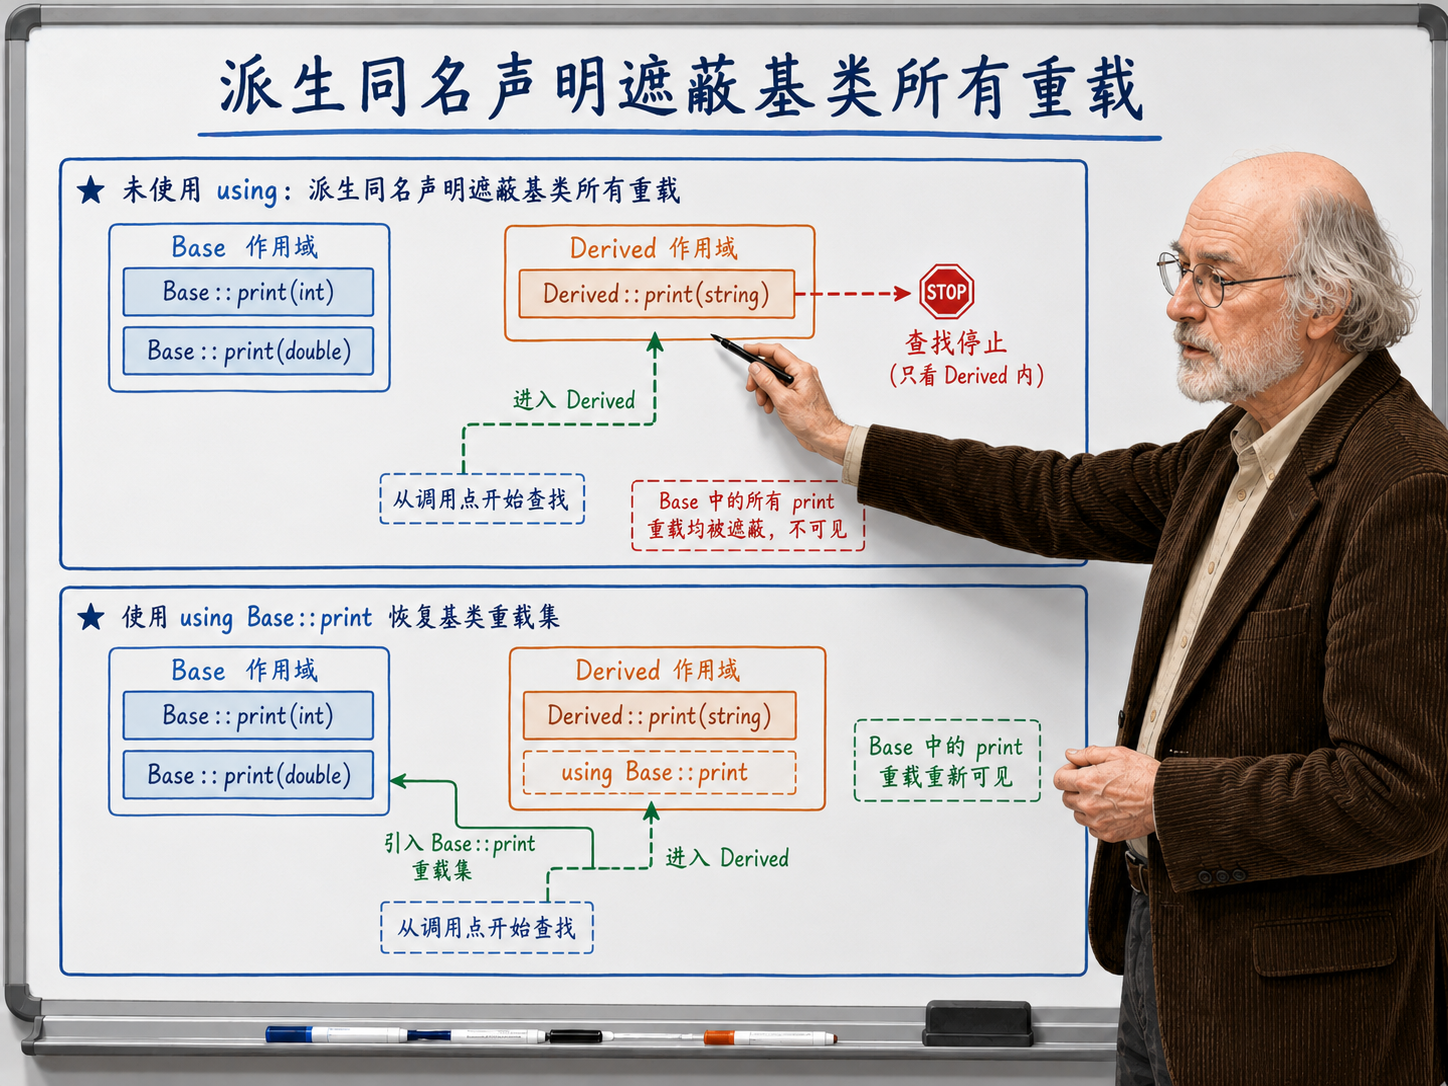
编译器在 Derived 的作用域内找到 print 这个名字后,就会停止向 Base 作用域的继续查找。即使 Base::print(int) 的参数与调用处的 42 完全匹配,编译器也不会去考虑它。这是因为名字查找的优先级高于重载决议。编译器只会在找到名字的那个作用域内进行重载决议,不会将不同作用域内的函数合并成一个重载集合。
要让基类的重载函数恢复可见,正确的做法是使用 using 声明:using Base::print;。这会将基类中所有同名的重载函数引入到派生类的作用域中,使它们与派生类自身的版本共同参与重载决议。这一规则的设计初衷,是为了防止派生类在无意中改变基类接口的预期行为。当在派生类中添加同名函数时,开发者必须明确意图:是隐藏基类的所有同名函数,还是将它们全部引入。编译器默认采取“隐藏”这种保守策略,强制要求开发者做出显式选择。
初学者很容易将名字隐藏和虚函数覆盖混淆,我们可以从三个方面来区分它们。首先,虚函数覆盖要求函数签名(包括名称、参数类型、const 限定符)完全相同,而名字隐藏只看名字是否相同。其次,虚函数覆盖属于运行时机制,通过基类指针或引用调用时,会根据对象的实际动态类型来选择对应的函数版本;名字隐藏则是编译时行为,编译器的名字查找在当前作用域找到目标后就会停止,与调用方式(对象、引用或指针)无关。最后,虚函数覆盖要求基类函数必须有 virtual 修饰,而名字隐藏无需任何特殊关键字。从语言设计的角度来看,名字隐藏是 C++ 作用域嵌套规则在继承中的自然体现,而虚函数覆盖是为了实现运行时多态,在名字查找机制上增加的特定语义。
什么时候用继承,什么时候用组合
public 继承具备很强的语义,不应该在两个类仅仅“有些关联”时就被滥用。它只适用于派生类能够无缝替换基类的场景,这正是里氏替换原则(Liskov Substitution Principle)的体现:在任何需要基类的地方,传入派生类对象都不应影响程序的正确性。如果派生类覆盖了基类的某个函数,导致通过基类接口调用时出现逻辑上的不合理,说明这个继承关系本身存在问题。错误的根源往往不是“重写得不对”,而是这两个类从一开始就不该是 is-a 的关系。
在继承和组合之间做选择时,可以问自己一个简单的问题:新类型“是一个”已有类型,还是“拥有一个”已有类型?Car 拥有 Engine,所以使用组合,将 Engine 作为 Car 的数据成员;Circle 是一个 Shape,所以使用 public 继承。这个简单的判断标准在大部分情况下都适用。遇到“既像是 is-a 关系,又想限制基类接口”这种模糊场景时,建议优先考虑使用组合配合转发函数来替代继承。组合提供了更强的控制力:你可以有选择地只暴露部分接口,可以在不影响外部调用的前提下修改内部实现,甚至可以包含多个同类型的成员对象。
在软件工程的历史上,继承曾被广泛滥用。许多教程为了演示语法,经常使用“Animal → Dog”或“Person → Employee”这样的例子。作为语法演示这没有问题,但并未说明继承在实际应用中的严苛条件。在真实的工程项目中,纯粹且稳定的 is-a 关系并不多见。随着需求的变化,曾经的 is-a 往往会演变成“有点像但又不完全是”。随之而来的,是继承体系中不断增加的特殊判断和变通处理,导致维护成本急剧上升。一个实用的经验是:当你需要频繁使用 if 或 dynamic_cast 来判断不同的派生类型并做特定处理时,这通常意味着组合或访问者模式可能比继承更适合当前的设计。
“优先使用组合而非继承”并非绝对的教条,而是一种默认的架构倾向。在难以抉择时,优先考虑组合。因为它不会将两个类型的接口强行绑定,不涉及复杂的构造和析构链,也不会将基类的内部细节暴露给派生类,因此试错成本更低。只有同时满足以下条件时,public 继承才是合理的选择:派生类完整遵守基类公开接口的语义约定(不存在“某个基类操作对派生类不适用”的情况);代码中自然而然地需要进行向上转换;且派生类替换基类后程序的正确性不受影响。如果继承体系符合这些条件,这就不是“为了继承而继承”,而是建立了一个能够经受时间考验的合理抽象。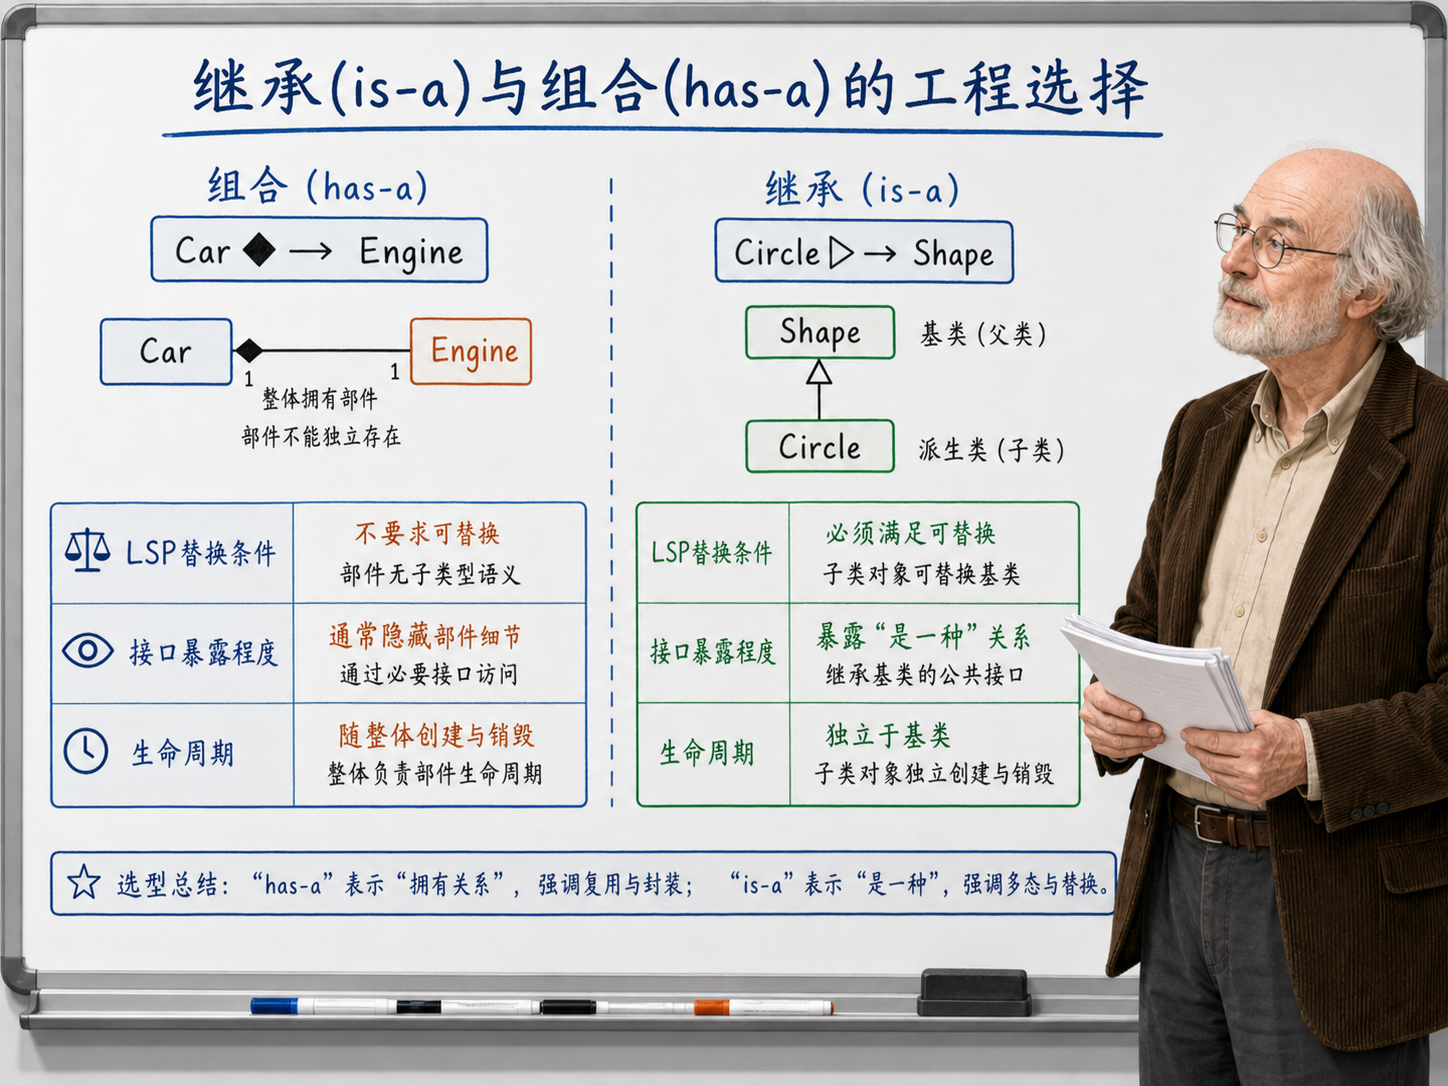
本章介绍的对象布局概念(即派生对象内部包含完整的基类子对象,向上转换本质是指向该内部子对象),是后续理解对象切片和虚函数调用机制的基础。在下一章我们将看到,当通过值传递基类参数时,编译器会创建一个全新且独立的基类对象,派生类的特有部分会被舍弃。这就是对象切片现象,它也是多态编程中常见的错误来源。
阅读导航



