
C++ 析构顺序:对象成员、基类与资源清理
03 析构函数为什么必须和构造顺序反着走
假如有一个 ConnectionManager 对象持有数据库连接、日志文件句柄和网络套接字三个资源成员。构造函数里先开数据库连接,再打开日志文件,最后建立网络套接字。这里的依赖方向很清晰:日志记录器在写审计日志时需要数据库连接,网络套接字在登记连接信息时依赖日志记录器已经就绪。这段代码正常运行了几个月没出问题,直到有一天日志文件句柄的析构函数抛出了异常(写最后一条日志时磁盘已满)。此时数据库连接和网络套接字的析构函数还没执行,两个资源都等待被释放。日志在它们之后声明,按逆序先行析构;如果它的析构失败以异常形式传播出去,后续成员的析构会受影响吗?这个问题引出了本章贯穿始终的事实:析构顺序绝非"语法纸面上规定的顺序",它本质上是对成员间真实依赖关系的反映。后构造的成员可以依赖先构造的成员,析构时必须让依赖方先退场,才能让被依赖方在它之后仍然可访问。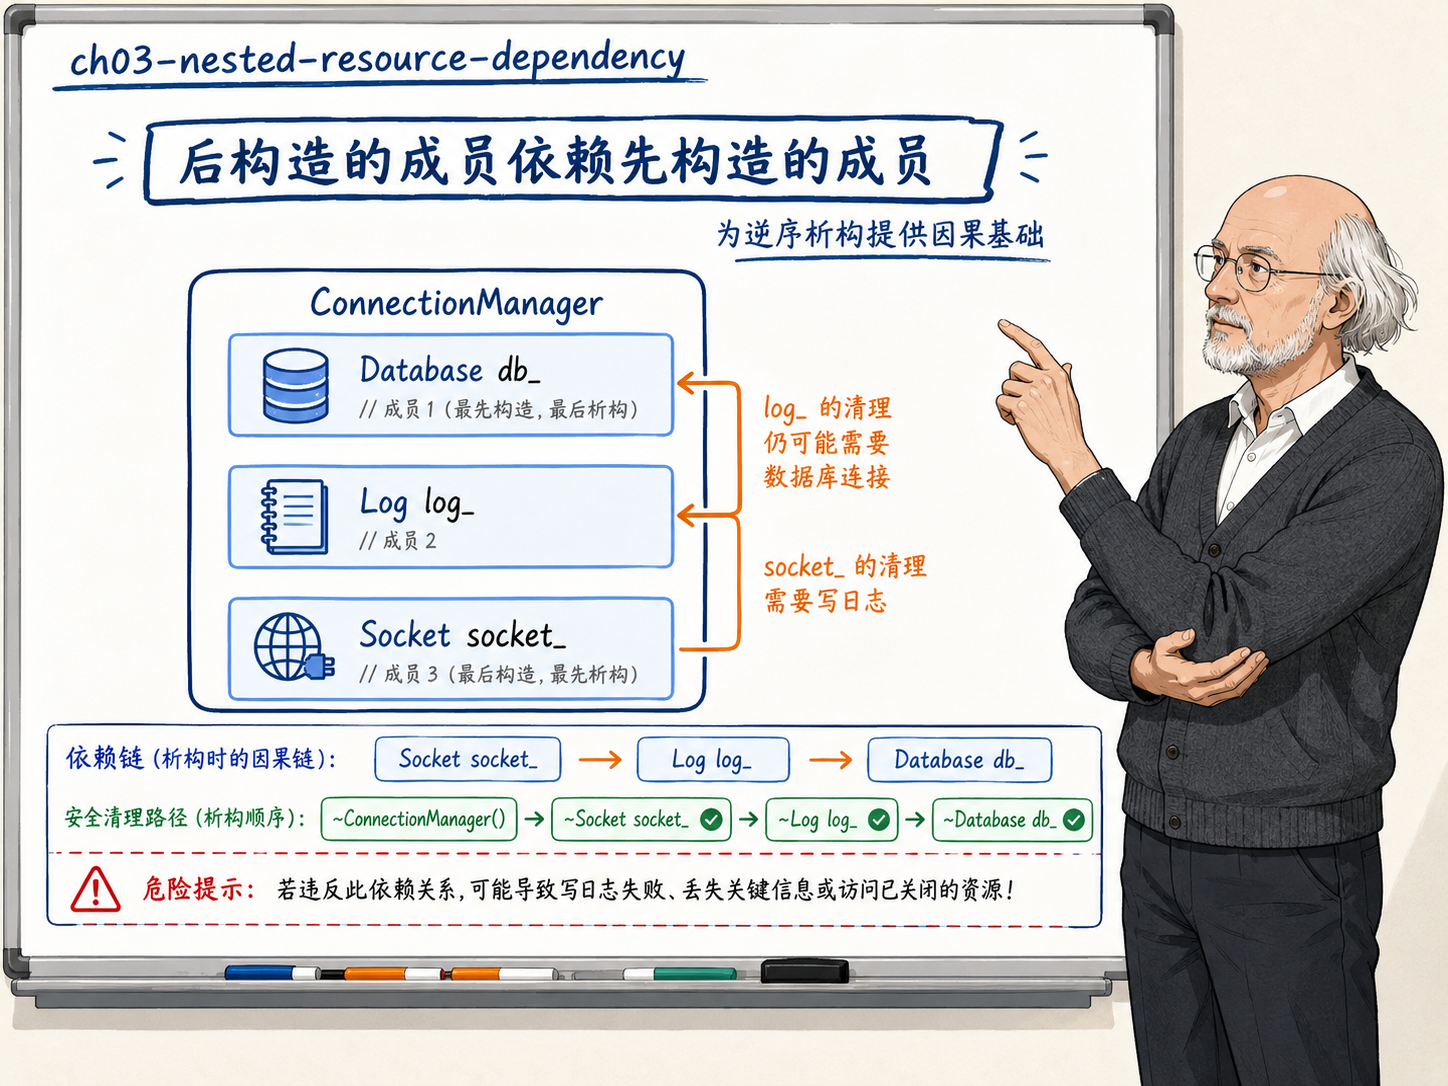
析构不等于释放内存
析构函数(destructor)的职责是结束对象作为其类型的语义生命。在析构函数执行完毕后,对象不再是"一个可用的 BankAccount"或"一个有效的网络连接",它退化为一块纯粹的存储空间。此时,类型层面的不变量不再被维护,成员函数不应再被调用,动态类型和虚函数的行为也不再被保证。这块存储随后可能被回收(如果是堆上的对象且后续执行了 operator delete)、可能被覆盖(如果内存被重新分配用作他途)、也可能永远留在进程地址空间直到程序退出。这些后续步骤和析构函数无关,析构函数只负责"类型语义的收尾",并不负责"存储空间的回收"。
一个非常普遍的误解是"析构函数负责释放对象的内存"。对于自动存储期的局部对象,析构之后栈帧弹出时回收存储。这是编译器生成的栈管理代码负责的工作,与析构函数体无关。对于通过 new 分配在堆上的对象,delete 表达式做两件事:先调用析构函数终止对象语义,再调用 operator delete 回收内存,其中只有后一步涉及存储回收。析构函数体可以包含任何清理逻辑(如关闭文件句柄、断开网络连接、释放互斥锁、归还外部资源),但它无权决定"这块内存接下来归谁"。
这个区分不只是概念上的澄清,在后续讨论虚析构和 placement new 时,它会直接决定程序正确性的边界。虚析构函数的关键价值在于保证 delete 通过基类指针时,"谁的析构函数被调用"与"该释放多少内存"这两条信息能够匹配。如果基类析构不是虚函数,delete 就只知道调用基类析构并释放基类大小的内存,而不知道对象实际上是派生类,导致派生部分的资源不会被清理。析构函数的职责范围和内存回收是两个独立机制,delete 表达式虽然把两者串在一起执行,但它们的正确性前提在于互不越界。
逆序为什么是必然的
成员之间的依赖关系决定了析构逆序是唯一安全的编排方式。回到 ConnectionManager:数据库连接在类中声明在日志文件之前,日志文件在构造时可以依赖已初始化的数据库连接(比如写一条"审计日志初始化完成"的记录)。销毁时日志文件先退出,它的析构函数可能会在退出前写最后一次审计日志"连接管理器关闭",这需要数据库连接还活着。如果销毁顺序是任意的或者正向的,数据库连接可能已经在日志之前析构,那日志的析构函数写日志时访问的就是一个已经不存在的连接对象。
这个推理推广到所有成员:在一个类中,后声明的成员在构造时可以依赖先声明的成员(因为先声明的成员构造完成时,后声明的成员还没开始构造,依赖方向成立)。销毁时,后声明的成员需要先退出(因为它可能在析构时访问先声明的成员)。唯一能同时满足这两个需求的顺序就是构造逆序。这并非"语言标准强行规定的次序",实际上是"物理上唯一不会产生悬空引用访问的次序"。语言标准只是用强制规则的形式确认了这一物理必然。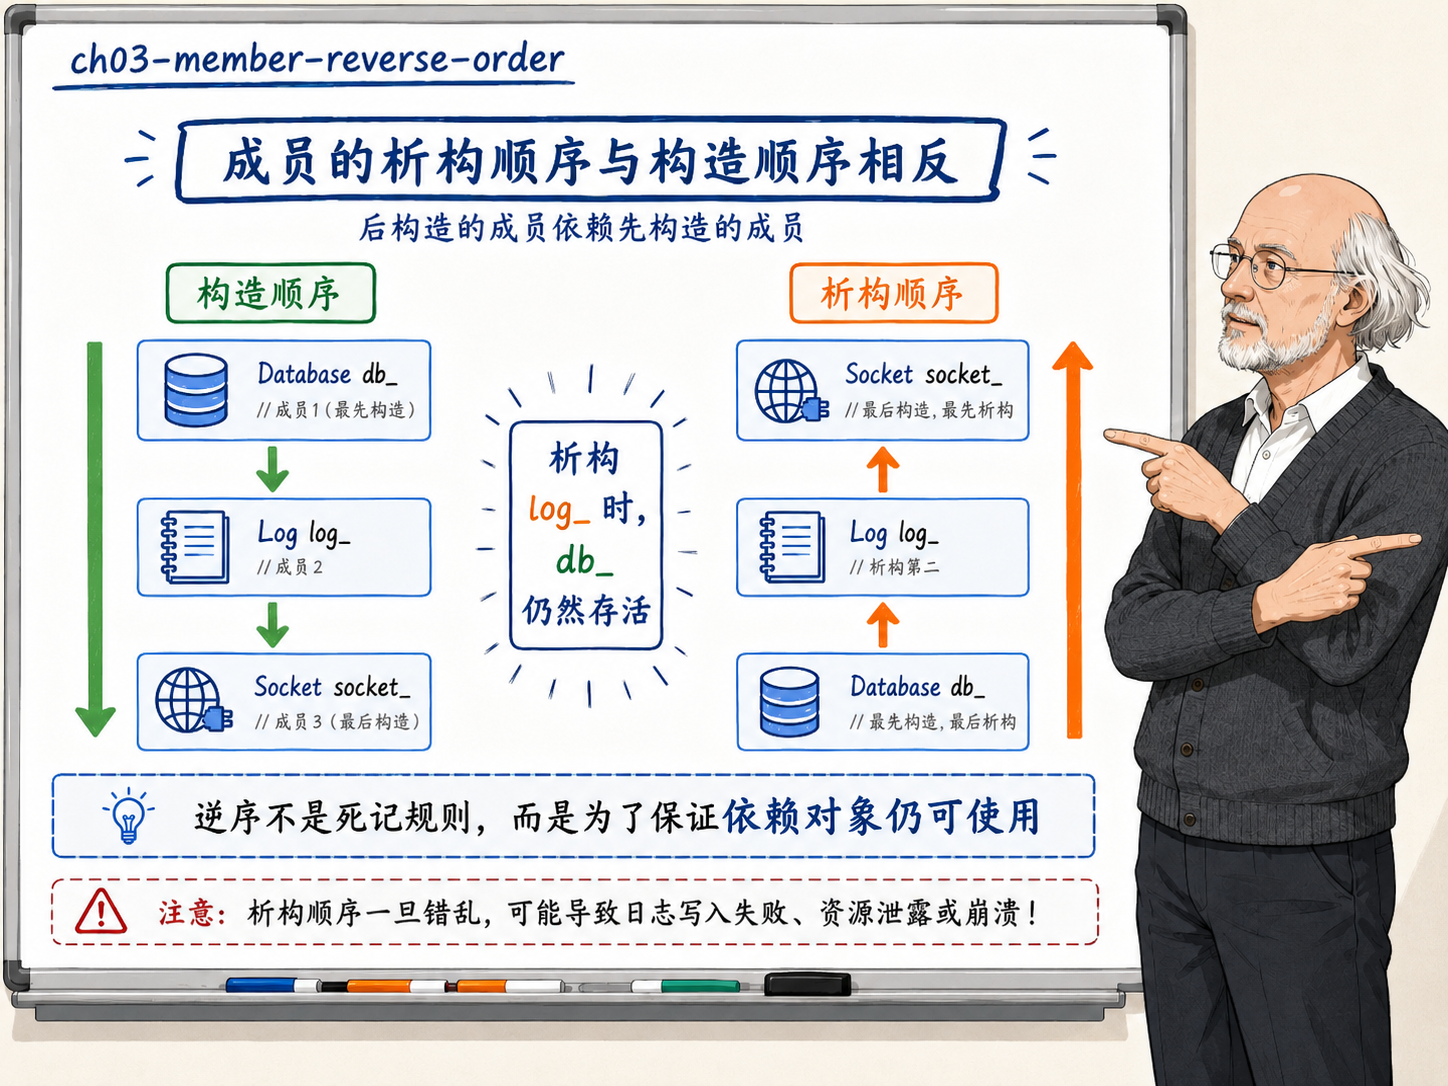
扩展到继承层次,逆序同样成立:派生类可以依赖基类提供的全部设施(数据成员、成员函数),而基类在构造时不依赖派生类(基类的构造函数在派生类的成员和构造函数体之前执行)。析构时,派生类的析构函数体和派生类的成员先退出,它们在退出过程中还可以访问基类的全部完整设施,最后基类析构时不需要任何派生设施(因为基类本来就不依赖派生类)。逆序再一次保证了任何时刻正在被析构的部分,其所依赖的其他部分一定仍然存活。
还需要澄清一个关于"逆序"可能产生的混淆:析构的逆序指的是成员声明顺序的逆序,与初始化列表书写顺序的逆序毫无关联。上一章已经明确,成员按类定义中声明的顺序从上到下初始化,初始化列表怎么排列都不能改变这一点。析构严格按声明的逆序发生,与构造函数体或初始化列表怎么写无关。如果你的初始化列表写得混乱(比如先写了后声明的成员再写先声明的),初始化仍然严格按声明顺序执行;析构会按声明的逆序执行。两者始终保持对称,但这种对称与你初始化列表中语法上的排列没有任何联系。
完整析构链:基类、成员、派生类体的执行节奏
单继承场景下,一个完整的派生对象析构过程按照精确的逆序展开。第一步:派生类的析构函数体执行。这里派生类可以释放自身独有资源,比如关闭派生类打开的临时文件、记录调试信息等。第二步:派生类的非静态数据成员按声明逆序依次析构。每个类类型成员的析构函数被自动调用,内置类型成员的存储进入不确定状态。第三步:直接基类的析构函数体执行,基类释放自己管理的资源。第四步:直接基类的成员按声明逆序析构。如此递归,直到最底层的基类完成析构。全程不需要程序员在任何一层的析构函数体中手动调用基类析构或成员析构,编译器已经把这整条析构链编译进了对象的析构代码。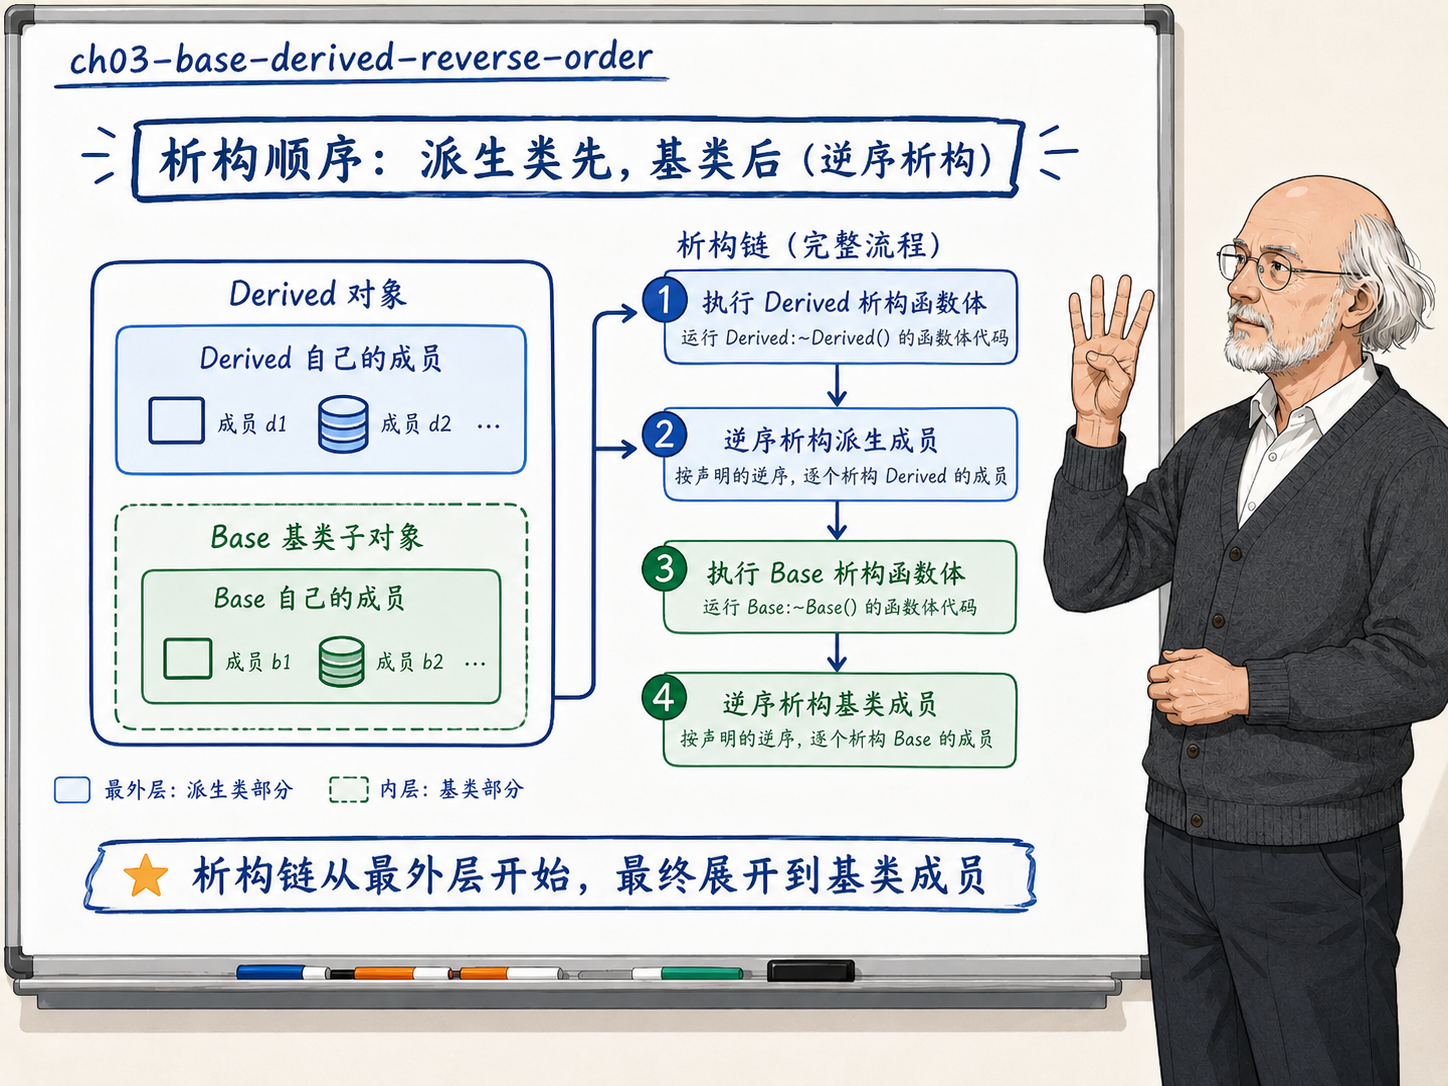
下面的代码用一个基类 Base、一个辅助 Member 类和派生类 Derived 完整展示这套顺序。Member 通过 tag_ 区分不同实例,在构造和析构时各打印一行日志;Derived 的两个 Member 成员声明顺序是 m1_ 在前、m2_ 在后,初始化列表的书写顺序故意写成 m2_{"m2"}, m1_{"m1"}。结果会证明初始化列表的书写顺序没有发言权,声明顺序才决定一切。
#include <iostream>struct Base {
    Base()  { std::cout << "Base 构造\n"; }
    ~Base() { std::cout << "Base 析构\n"; }
};

struct Member {
    Member(const char* tag) : tag_{tag}
        { std::cout << tag_ << " 构造\n"; }
    ~Member()
        { std::cout << tag_ << " 析构\n"; }
    const char* tag_;
};

struct Derived : Base {
    Derived()
        : m2_{"m2"}, m1_{"m1"}   // 列表书写顺序: m2 在前, m1 在后
    { std::cout << "Derived 构造体\n"; }

    ~Derived()
    { std::cout << "Derived 析构体\n"; }

    Member m1_{"m1-default"};     // 声明在前,先初始化
    Member m2_{"m2-default"};     // 声明在后,后初始化
};

int main() {
    Derived d;
}   // d 离开作用域,析构链自动触发
把这段代码编译运行,标准输出按顺序是:Base 构造 → m1-default 构造 → m2-default 构造 → Derived 构造体 → (main 作用域结束,析构开始) → Derived 析构体 → m2-default 析构 → m1-default 析构 → Base 析构。构造方向从上到下(基类 → 成员按声明 → 派生类构造体),析构方向从下到上(派生类析构体 → 成员按声明逆序 → 基类析构体)。初始化列表里虽然 m2_{"m2"} 写在 m1_{"m1"} 前面,但输出显示 m1-default 先于 m2-default 构造。声明顺序赢了。析构链则沿着 Derived 的成员 m2_ → m1_ 的顺序退出,再退出 Base,全程逆序,无一例外。
程序中没有任何一行手动调用了基类析构函数或成员析构函数,编译器在 main 的末尾自动插入了对 d 及其所有子对象的析构调用,且严格按逆序编排。把 Derived 换成任意深度的继承层次,规则依然不变:每一层析构体→成员逆序→上一层析构体,递归到底。
每个成员的析构分两个阶段:先执行该成员的析构函数体(如果有的话),再按声明逆序析构该成员所包含的子成员。这是一个递归过程,对于嵌套的类类型成员,整个析构链一直渗透到内置类型为止。内置类型没有析构函数,它们就只是"什么也不做":存储中的值变为未定义,但不会有任何代码被调用。
这个完整的析构链带来了一个极其重要的工程简化:你不需要在一堆相互嵌套的类之间手动编排销毁顺序。编译器知道所有成员的声明顺序,知道基类到派生类的层次关系,它生成的析构代码自动保证每个子对象在析构时,它所依赖的对象仍然存活。如果你的类里只用了 RAII 成员(每个资源都由一个专门的 RAII 类管理,如 std::unique_ptr、std::fstream、std::mutex 等),那么析构函数体就可以是空的,所有清理工作都通过成员各自的析构自动完成。这也是为什么 RAII 被称为"不需要析构函数的资源管理":如果你每份资源都由一个 RAII 成员持有,类的析构函数体本身就没有需要做的事。
反过来,如果你需要定义析构函数,那通常是因为某个资源没有被 RAII 成员覆盖(比如你持有一个原生 FILE*,而不是 std::fstream;或者通过 C API 获取了一个操作系统句柄;又或者你管理着一组通过裸指针关联的对象)。这些情况下,析构函数体需要显式调用释放函数,而这些释放逻辑不能被其他成员替代。但即使是这些场景,更好的策略通常也是把它包装成一个极小的 RAII 包装类,而不是在一个大型类中逐一手动释放。把资源释放的责任下放给对应的 RAII 成员,能让析构链自然覆盖。
异常路线上的析构:栈展开中的逆序
析构函数的逆序规则在异常发生时同样生效,甚至更加关键。当异常被抛出时,运行时沿调用链回溯寻找匹配的 catch 块,沿途经过的每个局部作用域中的自动对象都要被析构。这条"回溯路径"上对象的析构顺序同样是构造顺序的逆序(先构造的后析构,后构造的先析构),而且逆序规则递归地适用于每个对象内部的成员和基类。
这就是 RAII 对异常安全贡献最大的地方:手动释放代码可能在异常发生后被跳过(因为执行流已经离开了正常路径),但析构函数不会被跳过。编译器生成的栈展开代码确保沿途对象的析构函数被依次调用。无论异常从哪个函数抛出的、经过了哪些调用层,只要 RAII 成员存在,它们管理的资源就会被正确地释放。这就是为什么 C++ 没有 finally 块,析构函数充当了 finally 块的角色,而且是编译器保证不会忘记执行的 finally 块。
但这条路径上有一个致命的交互:如果栈展开过程中某个析构函数又抛出了异常,而第一个异常还没被捕获,那么两个异常同时活跃。此时程序直接调用 std::terminate,一切结束,没有任何 catch 块能拯救。这绝非单纯的"设计建议",而是 C++ 标准的硬规则(C++11 起明确规定,C++03 有类似的隐含行为)。结论不可妥协:任何析构函数必须保证不抛异常。
这个事实在工程上转化为两个具体纪律。第一,所有在析构期间可能失败的操作(如关闭文件因磁盘满失败、断开连接网络超时、释放外部锁通信失败)都必须被析构函数体内捕获并处理。常见的处理方式包括:忽略(对于非关键资源,失败也不影响程序继续运行)、记录(写日志但不重试)、或者用 std::terminate 替代(对于"失败的资源释放意味着逻辑已不可信"的极端场景)。无论选择哪种策略,异常都不能从析构函数体传播出去。第二,C++11 起析构函数隐式标注为 noexcept(true),编译器假定你的析构函数不会抛异常。如果你在析构函数中调用了一个可能抛异常且没有在内部捕获的操作,编译器理论上可以基于 noexcept 假设进行优化,实际结果则是抛出异常便触发 std::terminate。
有一个微妙的场景值得注意:析构函数内部调用了某个可能抛异常的函数,且析构函数自身没有捕获它。由于隐式的 noexcept,运行时在异常企图离开析构函数体边界时就会直接调用 std::terminate,而不是继续传播异常。许多代码在析构函数里调用日志库、统计上报等看起来无害的操作,实际上这些操作在异常发生、内存不足或 I/O 受限时也可能抛异常。真正的安全做法是:析构函数体内任何非平凡操作都用 try-catch(...) 包裹,或者在设计上保证那些操作自身不会传播异常。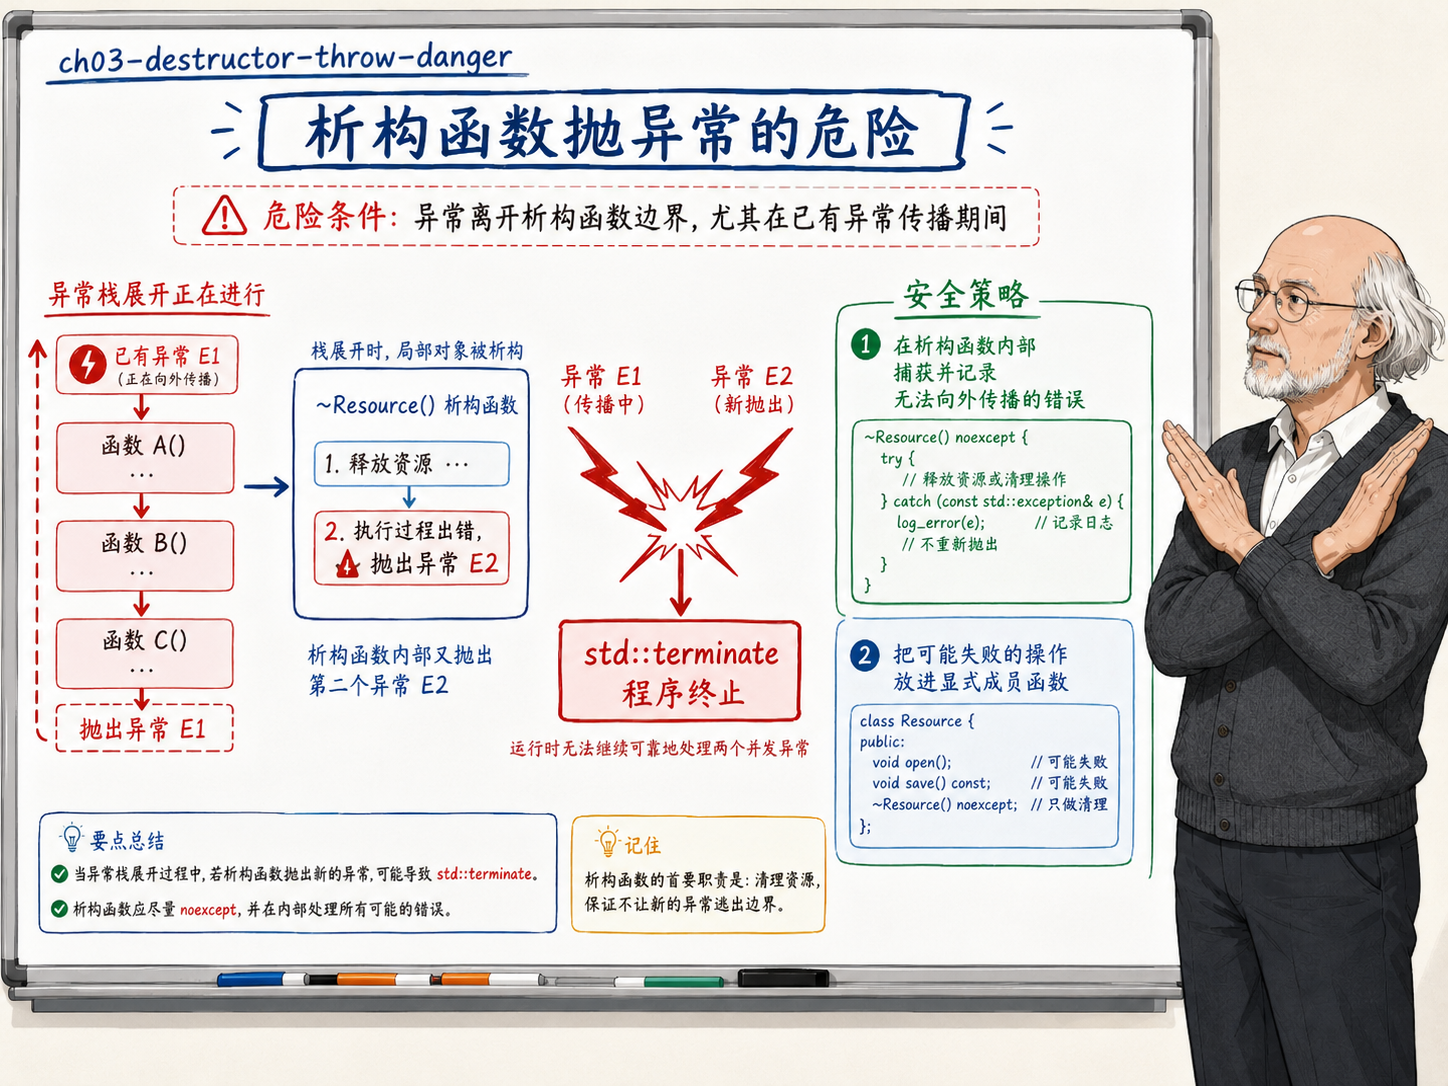
不要手工调用析构函数(除了一个场景)
C++ 语法允许显式调用析构函数:obj.~MyClass(); 完全合法。但在绝大多数代码中绝对不应该这样做。自动对象的析构函数在离开作用域时由编译器自动调用,你若再手动调用一次,对象就被销毁两次。第二次销毁操作将在已经释放的资源、已经不存在的成员和已经不再有效的虚表指针上执行,这会导致未定义行为。delete 表达式内部会自动调用析构函数,若在 delete 之后手动调用,同样会引发双重销毁。绝不要写这种代码。
唯一合理的显式析构调用场景是 placement new:你先在某块内存上手动构造了对象(placement new),对象使用完毕后手动调用析构函数结束其生命周期,而内存本身不释放,留给后续的 placement new 使用,或者统一归还给内存池。这是实现对象池、自定义分配器和小对象优化的标准技术,属于底层机制编程的范畴。本章提及它只为了划定边界:如果你不在写 placement new 代码,却发现自己需要手动调用析构函数,那就说明设计方向走错了。可能是在手动管理本应交给 RAII 的资源生命周期,也可能是在一个已经结束了生命周期的对象上企图访问成员。
同样的纪律适用于 delete。如果你有裸 new,就必然有裸 delete。但裸 new 和裸 delete 本身就应该被限制在极窄的范围内。大部分情况下,它们应当被替换为 std::make_unique、std::make_shared 或 RAII 工厂函数,让所有权管理自动化。本章不展开智能指针的讨论,但需要指出一个事实:手动管理 new/delete 的代码中,析构函数被跳过(忘记调用 delete)、被多重调用(重复 delete)或在不匹配的层次调用(派生对象通过基类指针删除且基类析构非虚)是最常见的三类资源错误。使用 RAII 并尊重析构链,可以一劳永逸地消除这三类错误。
构造失败时析构会被"跳过"
正常程序流程中,所有完整构造成功的对象都会在生命周期结束时被析构,这是 C++ 的确定性析构承诺。但构造函数抛异常是一个合法的例外:构造中途异常时,完整的对象从未完成构造,因此它的析构函数不被调用,毕竟一个"从未完整出生的对象"没有析构函数可以调用。但这不意味着什么都不发生。已经构造完成的基类子对象和已经完成初始化的成员(按照声明顺序至今为止的那些数据成员),会按各自构造的逆序依次析构。所以"跳过"的只是完整对象的析构函数体,而不是所有子对象的析构。
这个行为在堆分配场景下产生了一个很多人困惑的问题:new MyClass(args) 中如果构造函数抛出异常,new 表达式会自动释放之前分配的内存。你不需要,也不应该对构造失败的对象调用 delete。然而,构造成功的对象必须经过 delete 调用析构函数再回收内存。两条路径的义务不对称,且绝不能互换。对构造失败的对象调用 delete 会导致双重释放或访问无效对象,而对构造成功的对象不调用 delete 则会造成内存泄漏加资源泄漏。
更微妙的是异常发生后析构链上的成员可访问性。假设 ConnectionManager 构造函数中,数据库连接和日志文件成功构造,但网络套接字的构造抛了异常。此时已经完成构造的两个成员(数据库连接、日志文件)会逆序析构(先日志后数据库)。日志的析构函数执行时,它仍可以访问数据库连接(因为数据库还没析构),可以安全地写入"连接管理器初始化失败,回滚日志"。这个"回滚中的析构链仍然尊重依赖顺序"的保证,让异常场景下的清理逻辑和正常退出时一样安全。你不需要为异常路径单独写一套资源释放顺序,逆序规则已经完美覆盖了两条路径。
什么时候需要写析构函数
大多数类型不需要手写析构函数。Rule of Zero 的核心主张即是:"如果你的类所有成员都管理了自己的资源,编译器生成的析构函数会自动完成正确的行为"。需要手写析构函数的场景通常集中在以下三类:类直接持有了不被 RAII 成员包装的原生资源(如原生文件描述符、操作系统句柄、C 库资源);类需要执行一些与具体成员无关的清理操作(如在析构时通知外部系统、注销回调、记录审计日志);类作为多态基类,需要通过虚析构函数提供正确的销毁路径(在第 8 章会全面讨论)。
即便是面对这些场景,好的策略也是把原生资源包装成极小的 RAII 类,然后让持有它的类回归 Rule of Zero。比如写一个五行的 FileDescriptor 类包装 int fd,让它管理 close 调用。后续任何需要持有文件描述符的类都可以不使用裸 fd 成员,转而使用 FileDescriptor 成员。这样整个大型类的析构函数又回到了空的状态,资源的释放并未缺失,它只是被移交给了更深层的 RAII 成员。这种"层层包装"的策略不仅能消除手动析构逻辑,还能确保异常安全,毕竟每个小的 RAII 包装类的析构函数都隐式保证不抛异常。
析构逆序是 C++ 类型系统的安全基座
把前三章的内容串联起来看,C++ 的对象生命周期由构造和析构对称地包裹:构造函数保证对象出生就合法;初始化列表和声明顺序确保成员之间的依赖方向被物理布局所尊重;析构函数保证对象退出时干干净净;逆序机制确保每个子对象析构时它所依赖的对象仍然存活;构造失败回滚让异常路径同样覆盖了逆序析构规则。RAII 并非仅仅是"在构造函数里获取资源",它实际上是这三条规则合力形成的结果。资源和对象紧密绑定在一起,资源生命周期的起始、转移和终止完全由对象的构造、拷贝、移动、析构机械地决定,根本不需要手动介入。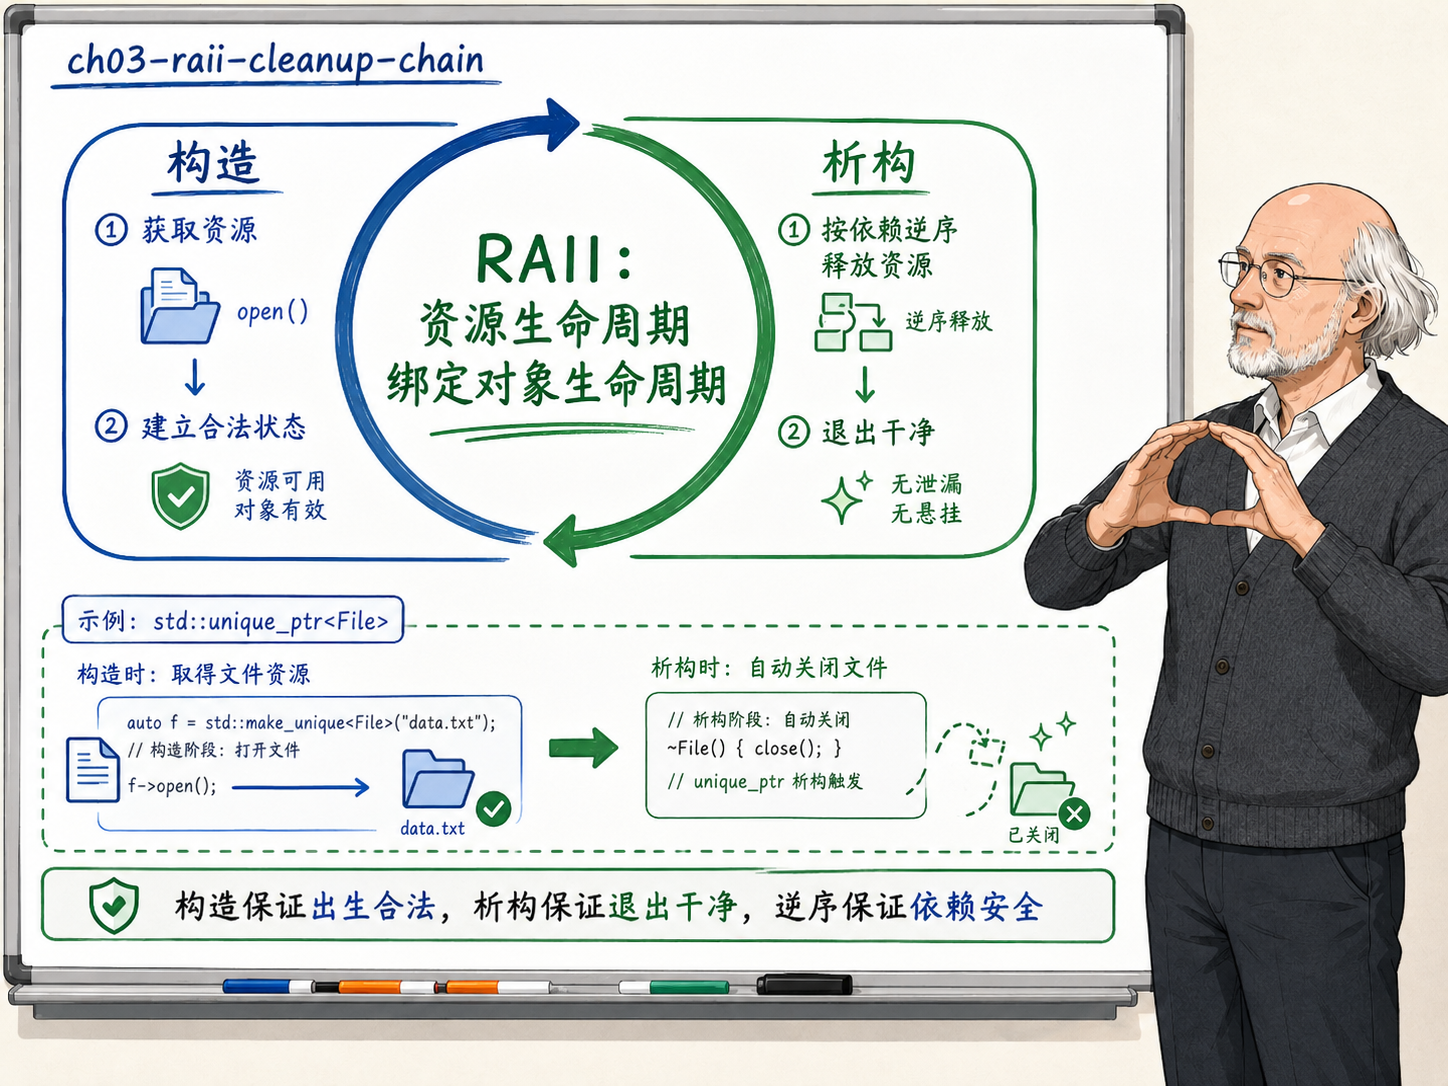
下一章要讨论的拷贝控制,正是在这个安全基座上增加了一层关键决策:两个对象之间发生复制时,它们各自的资源和状态是按值复制、共享所有权、转移所有权,还是根本禁止复制。这个决策直接构建在构造和析构之上。拷贝构造创建新对象,拷贝赋值修改已有对象,两个操作的行为一致性也时刻受到析构函数的约束。
阅读导航



