
C++ std::function:类型擦除与可调用对象统一
10 std::function 用类型擦除统一不同可调用对象
前面几章已经把可调用对象的几条常见写法都过了一遍:普通函数、lambda、函数对象,都可以写成 f(x) 交给 std::sort、std::count_if 这类算法。算法用模板参数接收规则,编译器在实例化时看到的就是具体类型,调用通常是直达的,开销也低,在规则种类编译期就能数清楚时,这套模型很顺手。
另一类需求会让这套模型不够用,因为规则集合本身要到运行期才能定下来:配置里写了几道工序、插件注册表要挂哪些回调、测试里想临时换掉某一环,都要求你把形态不同的可调用对象放进同一个容器,按同一套接口依次调用。订单金额处理就是典型场景,负金额先钳到零,再按配置打折,最后加固定手续费,三步可以分别写成普通函数、带状态的 Discount 类、捕获了常量的 lambda,单独使用时都没问题,可一旦想把它们排成一条流水线,编译器就开始报错:
#include <vector>

int KeepPositive(int amount) {
  return amount > 0 ? amount : 0;
}

class Discount {
 public:
  explicit Discount(int percent) : percent_(percent) {}
  int operator()(int amount) const {
    return amount * (100 - percent_) / 100;
  }

 private:
  int percent_ = 0;
};

int main() {
  using Stage = int (*)(int);
  std::vector<Stage> stages{KeepPositive, Discount(10),
                            [](int amount) { return amount + 5; }};
}
KeepPositive 可以退化成函数指针,放进 vector<Stage> 没问题;Discount(10) 和 lambda 都是带状态或捕获的类对象,和函数指针不是同一类型,vector 的元素类型只能选一个,三者没法共用一个声明。本章要回答的就是:接口怎样同时接收普通函数、lambda 和函数对象,并把它们放在同一个容器里统一调用。std::function 的做法是类型擦除,对外只保留一条调用签名,把具体类型藏进包装器内部,调用方只关心能不能按 int(int) 这样签名发起调用。前面章节交给算法的规则大多在编译期就定型,本章处理的是规则集合要到运行期才能组装的场景。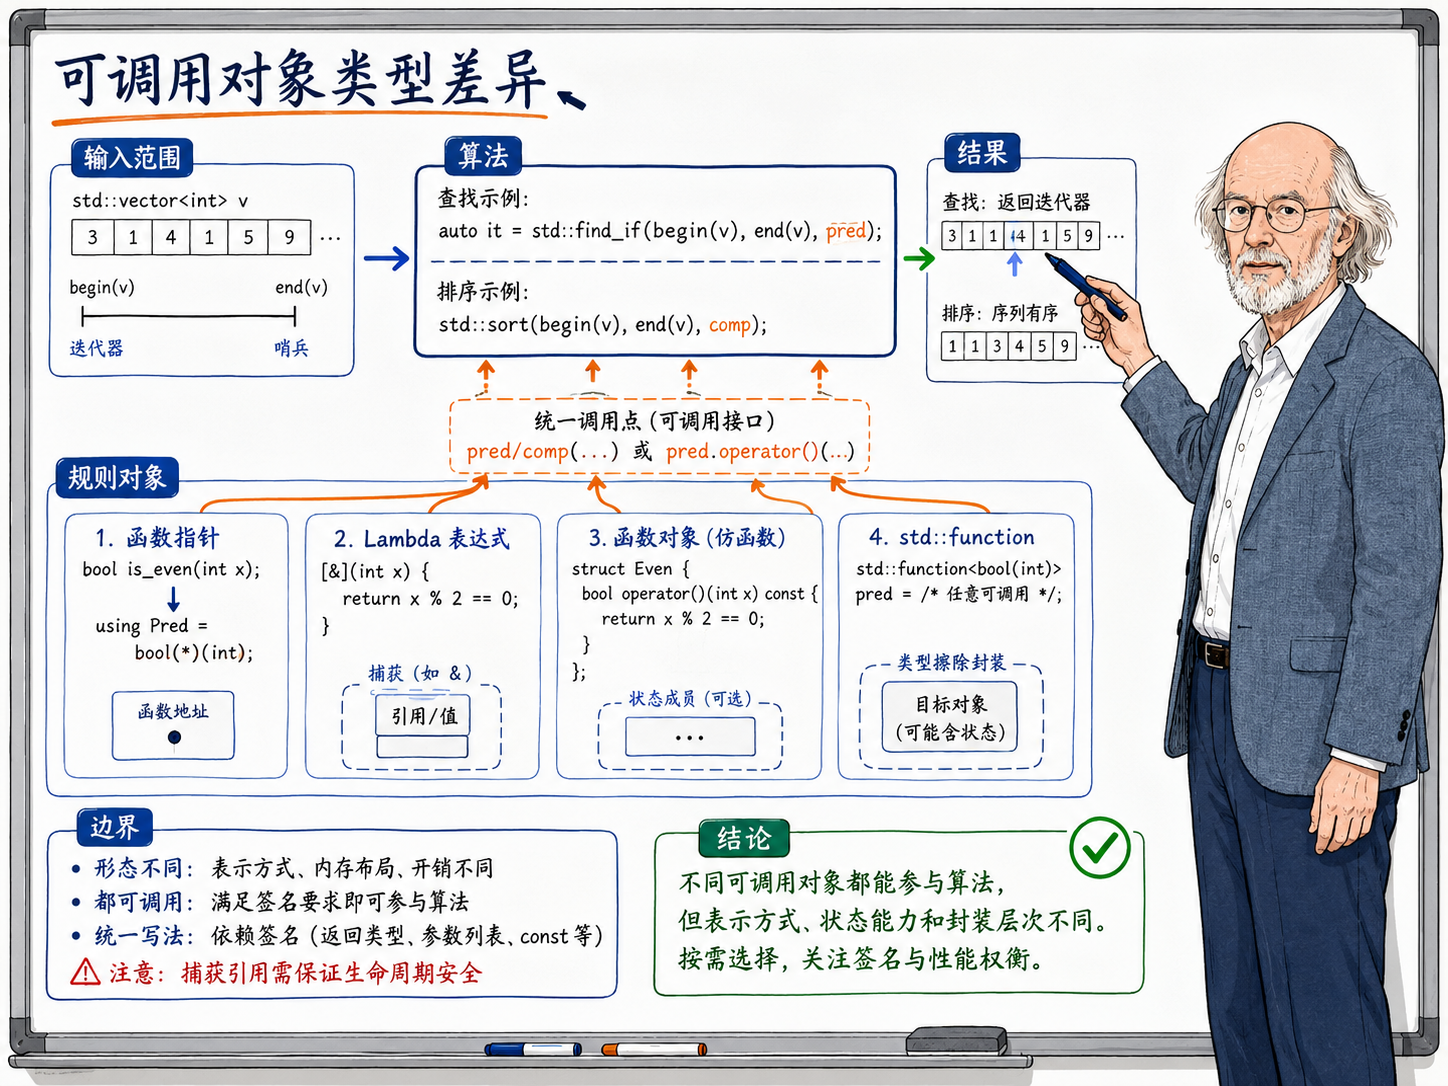
为什么三种可调用对象进不了同一个 vector
要理解上面的报错,得先看清三种写法在类型系统里各自占什么位置。普通函数在表达式里通常退化成函数指针,指针里只有一个入口地址,没有地方存折扣比例、匹配前缀这类额外数据,所以 vector 可以装函数指针,但装进去的目标必须都是无状态函数,带配置的业务规则很难只靠裸指针表达。lambda 会让编译器为每个表达式生成一个独立的闭包类,捕获列表里的变量变成成员,捕获三个 int 的 lambda 和空捕获 lambda 类型不同、对象大小也不一样;空捕获 lambda 可以隐式转成签名匹配的函数指针,一旦有了捕获,状态没处放在指针里,转换就不成立。函数对象是程序员显式定义的类,重载 operator(),成员里可以存配置、缓存、计数,它和函数指针、各种闭包类之间没有公共基类,谁也不能隐式转成谁,它们共享的事实只发生在调用表达式上,写 f(amount) 都能通过编译。
把开头三条规则对照这个模型看,KeepPositive 对应函数指针,Discount(10) 是类实例,lambda 背后是闭包对象。声明 vector<int (*)(int)> 时,只有第一种能进去,后两种在元素类型上对不上,因为带状态的规则需要一块存储跟着对象走,这正是函数指针给不了、类对象给得了的东西。
std::function 内部怎么存不同类型的目标
函数指针和同元素类型的容器解决不了异构可调用对象的存储,std::function 换了一条路。std::function<R(Args...)> 的模板参数只写调用签名,不出现任何目标类型,std::function<int(int)> 的含义就是接收一个 int、返回一个 int;普通函数、函数指针、各种 lambda、带状态的函数对象,甚至 std::bind 的结果,只要按这个签名能合法调用,都可以作为目标,构造包装器时编译器先检查调用是否成立,再把目标存进内部。
类型擦除就发生在这里:构造完成后,对外可见的类型只剩 std::function<int(int)>,里面原来是函数还是闭包,调用点不需要知道,具体类型的信息止步于构造函数,之后流通的只有签名。这和基类指针有点像,都是把实现藏到统一接口后面,差别在于 std::function 是值语义,可以拷贝、赋值、放进容器,拷贝包装器会拷贝里面的目标,不要求目标类型继承某个基类。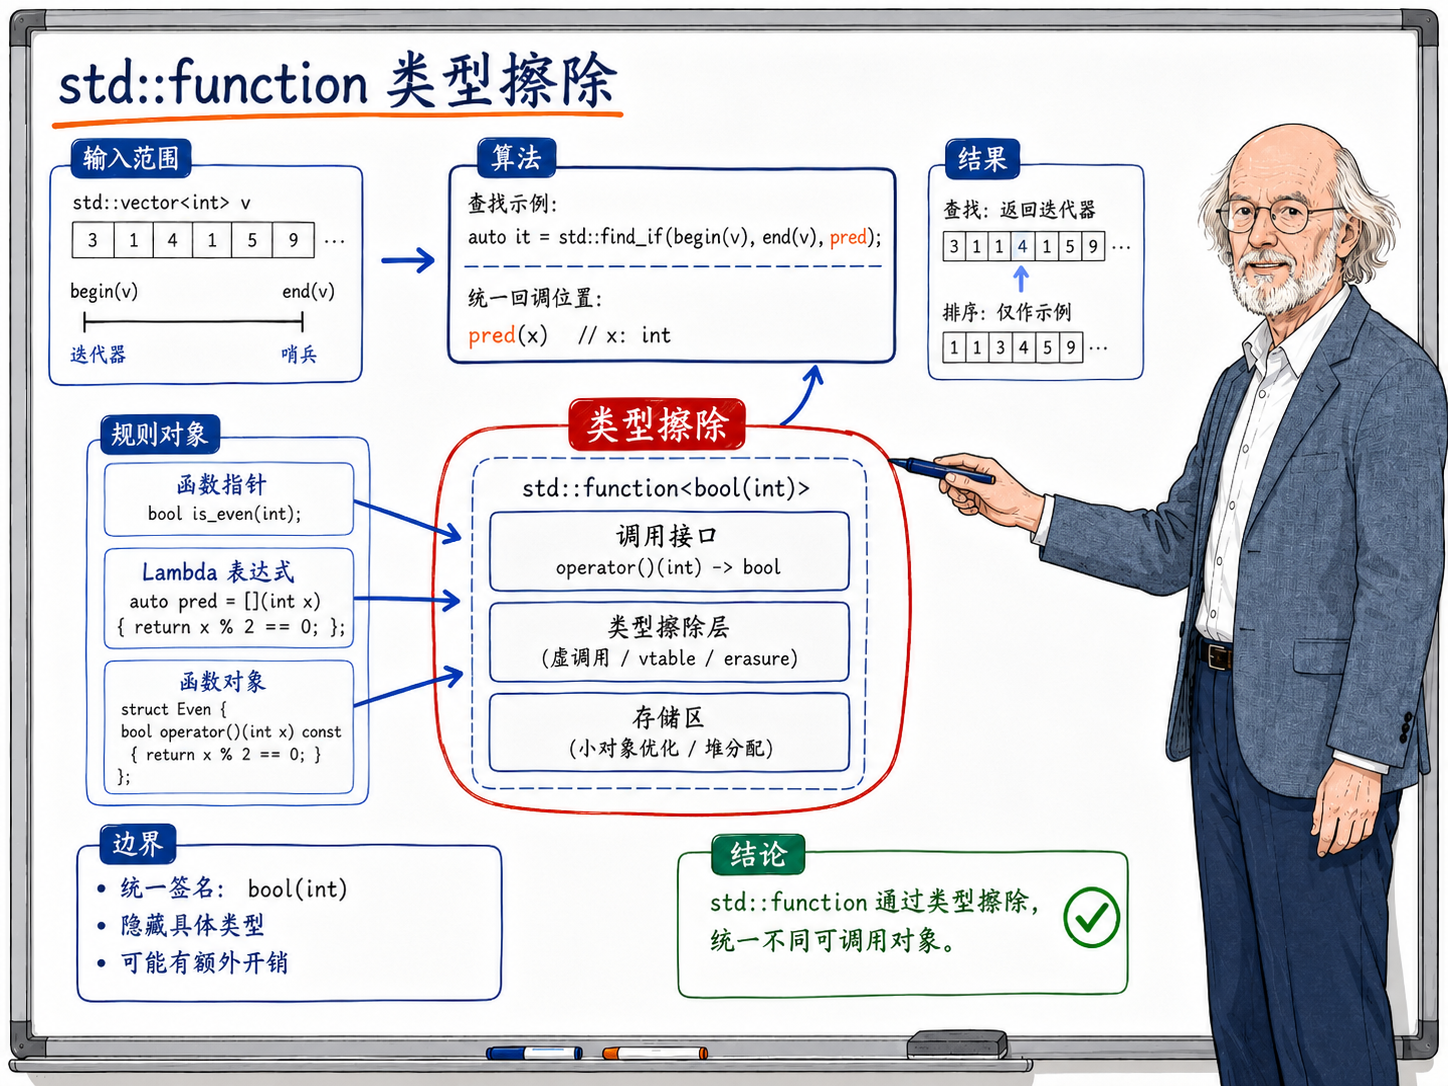
从使用上能观察到,sizeof(std::function<int(int)>) 不管装什么目标都是固定值,目标太大时包装器可能在内部缓冲或堆上另开空间,但包装器对象本身的大小不变;赋值会替换旧目标,移动构造会把目标搬走并留下空包装器,所以包装器手里始终只有两样东西,一条签名和一份目标的所有权。值语义同时带来一条硬约束,目标必须可拷贝,捕获了 std::unique_ptr 的 lambda 只能移动,装不进 std::function,构造时就会报错,C++23 的 std::move_only_function 专门处理只移目标,本章示例里的三种规则都可拷贝。默认构造的 std::function 还没有目标,可以用 explicit operator bool 判断是否为空,对空包装器调用会抛 std::bad_function_call;回调表先留空再按配置填充时,调用前必须确认每一项都已赋值,否则异常会打断整条链路。
什么样的目标能装进 std::function
编译器检查的是,用声明的参数类型调用目标是否合法,以及返回值能否转换成声明的返回类型,这比"参数类型逐字相同"宽松:接收 long 的 lambda 可以装进 std::function<int(int)>,因为实参 int 能隐式转成 long,std::function<void(int)> 也可以接收返回 int 的目标,返回值会被丢弃。匹配关心的是表达式 target(args...) 在语法和转换上是否成立,不关心目标内部用什么类型实现;返回值一侧同样允许转换,返回 long 的目标可以装进 std::function<int(int)>,窄化发生在每次调用返回时,范围检查责任在调用方。签名一旦定下来就是公共契约,回调表里注册的规则都要向它对齐,日后改签名会波及每个已注册目标,设计接口时宜把参数收敛到真正需要的信息。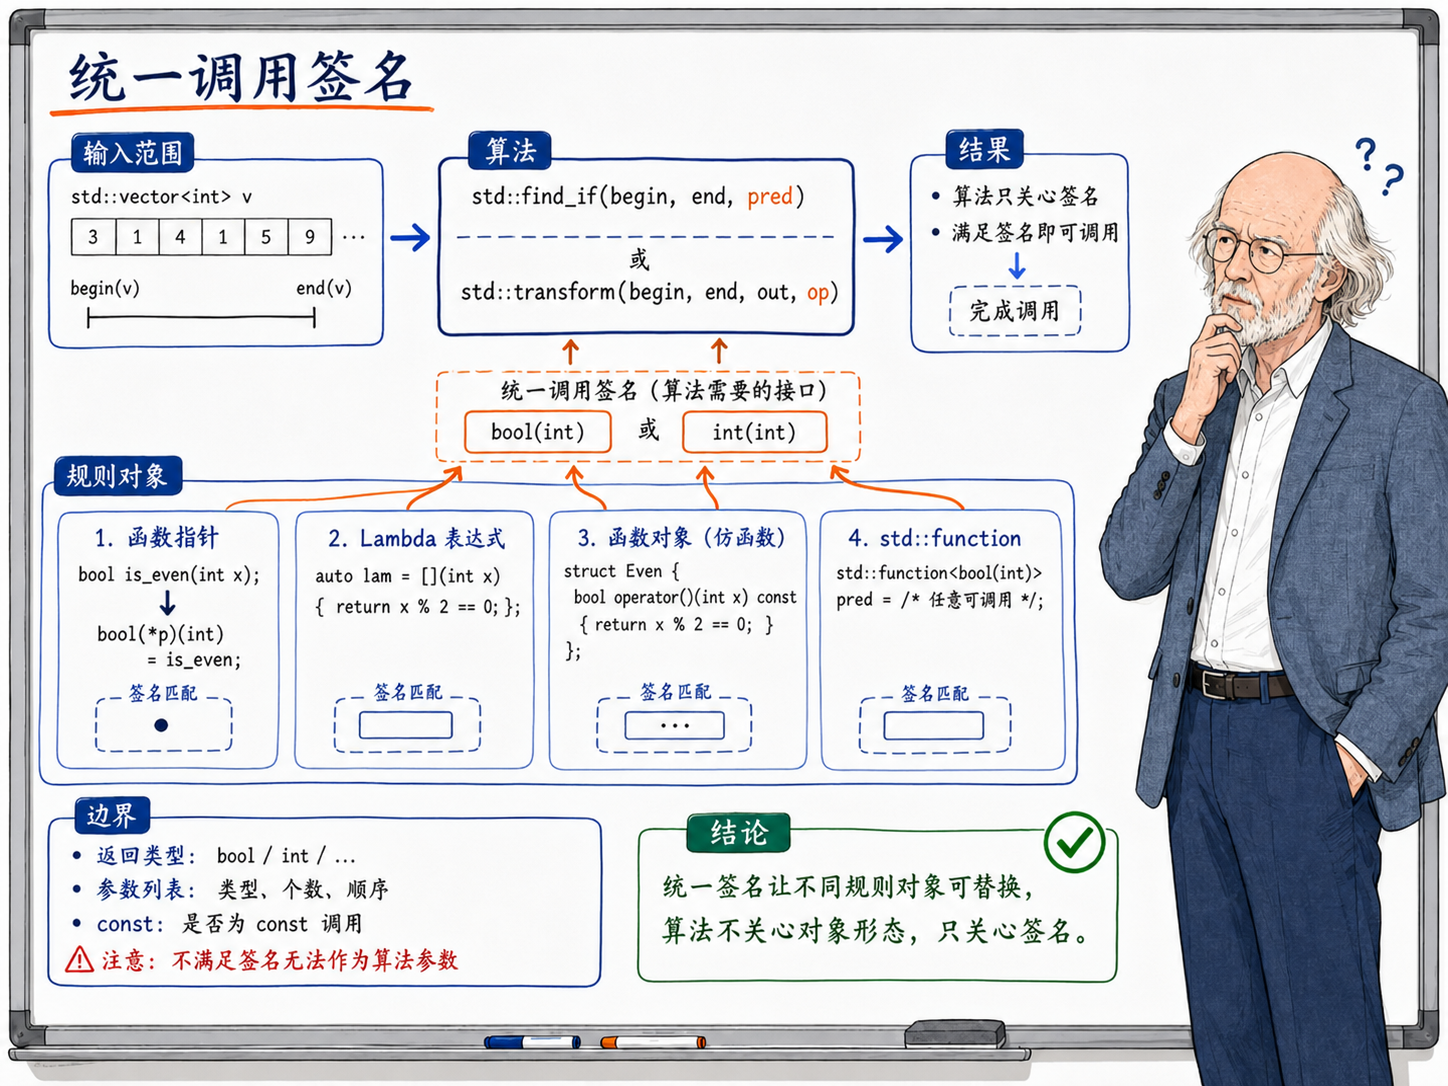
签名对不上会在构造包装器时直接编译失败,不会拖到运行期,接收 const Order& 的谓词装不进 std::function<int(int)>,因为一个 int 变不出 Order,这类报错往往嵌套很深,读的时候盯住第一条,看哪一步类型转换不成立。重载函数名直接赋给 std::function 时,编译器不知道选哪个重载,需要用 static_cast 指定函数指针类型,或包一层 lambda 写死调用;成员函数指针必须搭配对象才能调用,通常先用 lambda 或 std::bind 绑定对象,再装进包装器,裸成员函数指针会因签名不匹配失败。target_type() 和 target<T>() 可以在运行期查看内部目标类型,主要用于调试和框架代码,业务代码不宜靠它们做分发,类型既然在构造时被擦除,运行期再按类型分支,等于把包装器要解决的问题重新引回来。
代码示例
本章示例在 代码示例/10-function-pipeline/function_pipeline.cc,把普通函数、函数对象和 lambda 各写一种,再用统一接口串成订单处理流水线。
// Copyright (c) 2026 yus3nable
// SPDX-License-Identifier: MIT

#include <functional>
#include <iostream>
#include <string>
#include <vector>

struct Order {
  std::string id;
  int amount = 0;
};

class Discount {
 public:
  explicit Discount(int percent) : percent_(percent) {}

  int operator()(int amount) const {
    return amount * (100 - percent_) / 100;
  }

 private:
  int percent_ = 0;
};

int KeepPositive(int amount) {
  return amount > 0 ? amount : 0;
}

int main() {
  const std::vector<Order> orders{{"a", 120}, {"b", 80}, {"c", 300}};
  std::vector<std::function<int(int)>> stages;
  stages.emplace_back(KeepPositive);
  stages.emplace_back(Discount(10));
  stages.emplace_back([](int amount) { return amount + 5; });

  for (const Order& order : orders) {
    int amount = order.amount;
    for (const auto& stage : stages) {
      amount = stage(amount);
    }
    std::cout << order.id << '=' << amount << ' ';
  }
  std::cout << '\n';
}
示例里 Order 只有编号和金额,Discount 在构造时写入折扣百分比、调用时按配置计算折后价,换构造参数就能得到不同规则实例,KeepPositive 把非正金额钳到零,三者类型互不相关,对应开头三种写法。统一接口体现在 stages 的声明上,vector 元素类型是 std::function<int(int)>,三次 emplace_back 把函数指针、函数对象和 lambda 包装成同一类型,这一行里没有出现任何目标具体类型,容器只关心签名,这就是类型擦除在代码里的样子,加第四道工序时不必改类型声明,再 emplace_back 一次即可。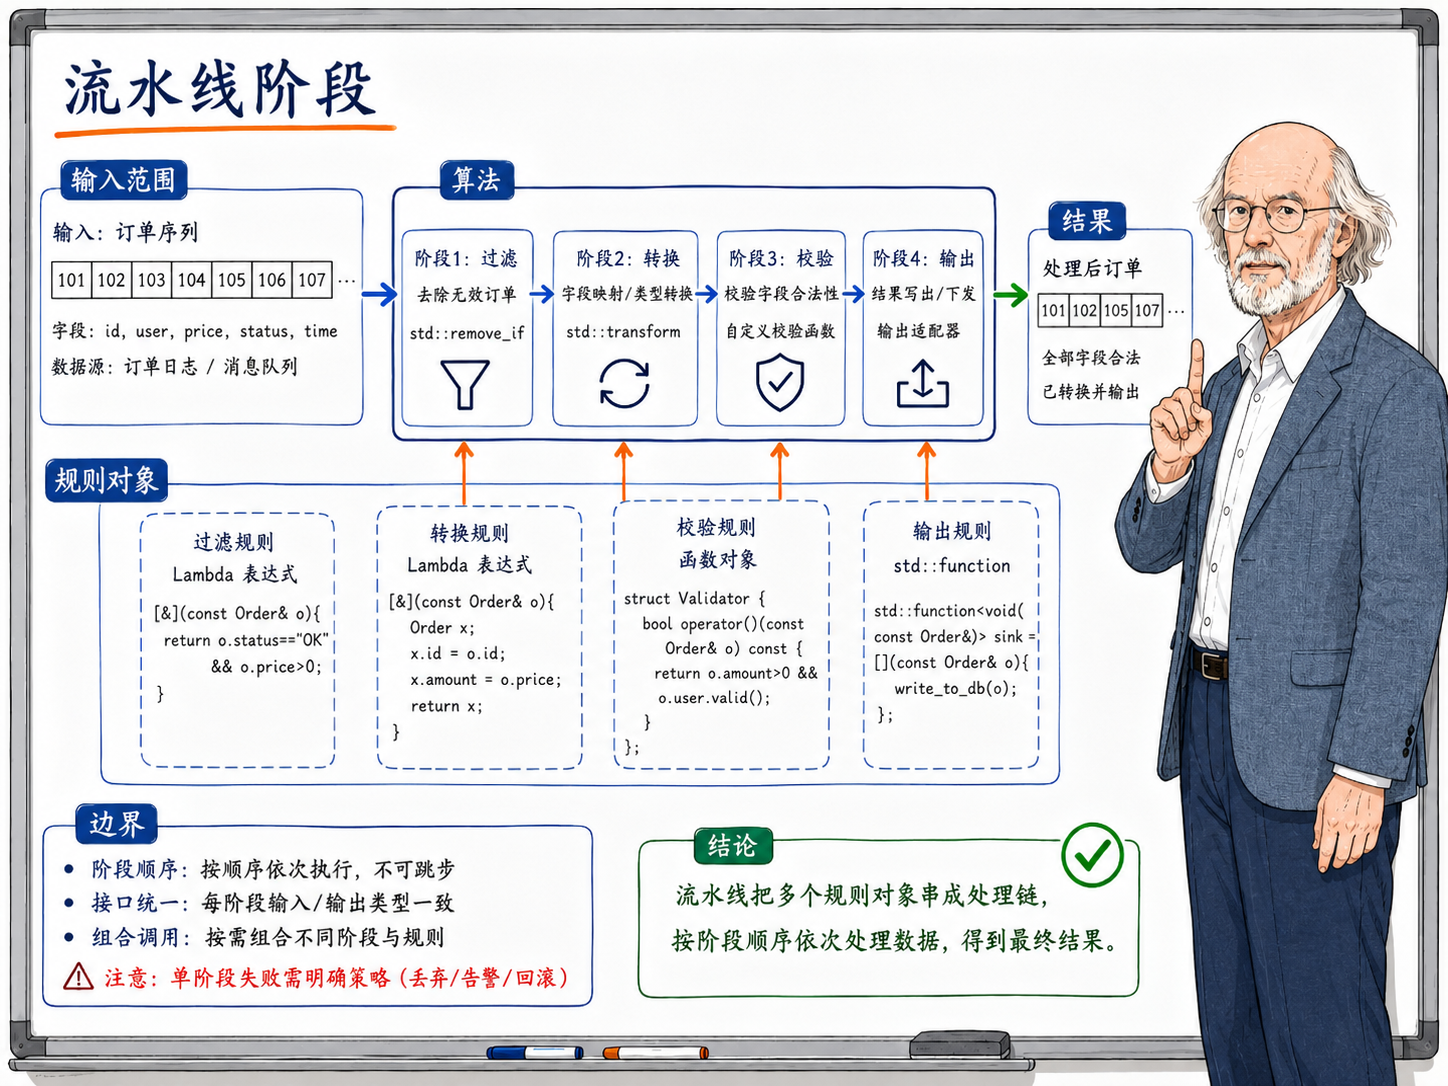
执行部分是两层循环,外层取订单并把金额拷到局部变量 amount,内层让金额依次经过每个 stage,输出作为下一阶段的输入。以 a 单为例,120 经 KeepPositive 仍为 120,经 Discount(10) 得 108,lambda 加 5 得 113;b 单 80 折后 72 加 5 得 77,c 单 300 折后 270 加 5 得 275,程序输出 a=113 b=77 c=275。内层循环可以写成 amount = stage(amount),前提是各阶段共享同一签名,阶段之间不需要知道彼此的具体类型,接口一致就能串联;阶段表放在 vector 里本身已是运行期数据,可以从配置读折扣构造 Discount,按用户等级增删阶段,流水线布局不必写死在编译期。
模板参数和 std::function 怎么选
模板参数同样能接收各种可调用对象,std::sort 的比较器走的就是这条路,编译器按具体类型生成代码,比较调用往往是静态的,还常常内联,规则在编译期确定、调用足够频繁时,这通常是开销最低的做法。模板的边界也在这里,实现多半得进头文件,每种新规则类型都会多一份实例化代码,它解决不了两件事,一是用一个容器装多种规则类型,因为实例化后元素类型已经固定,二是规则集合本身要到运行期才能确定,比如配置决定有几道工序,本章的阶段表同时落在这两条之外。模块边界上还有实际差别,模板接口要求调用方和实现共享同一份模板代码,新增规则类型时相关翻译单元都要重新实例化,而 std::function 接口可以编译成普通非模板函数,藏在 .cc 里,外部调用者只认签名,不必看到流水线实现,接口需要隐藏实现、需要二进制边界稳定时,这个差别会影响选型。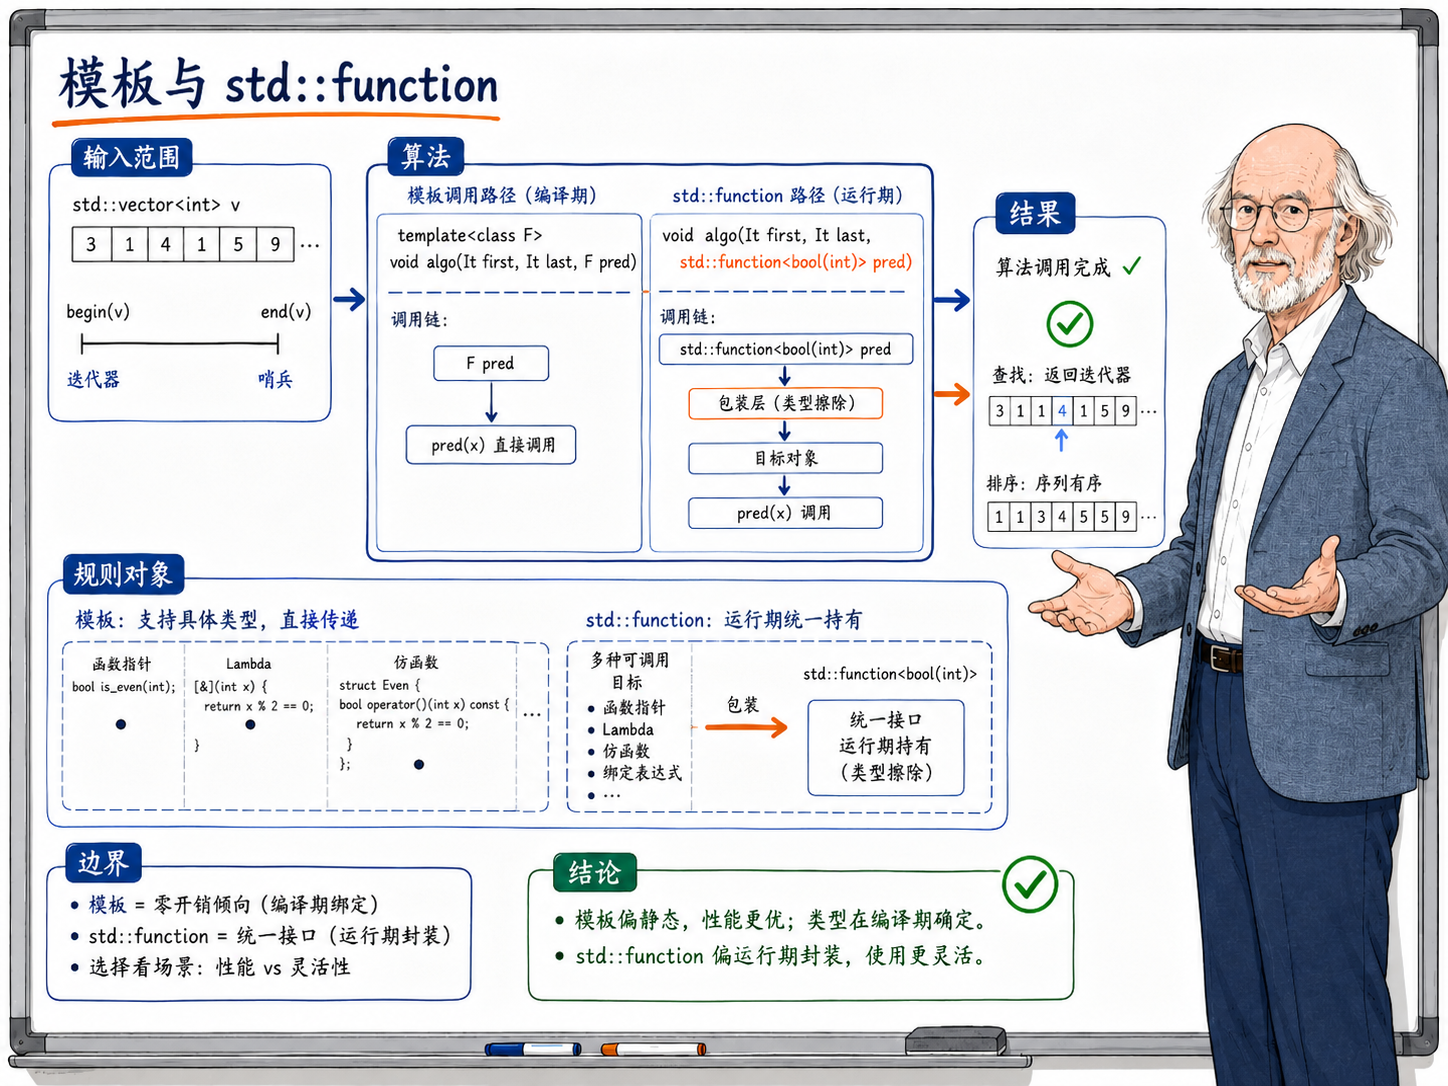
std::function 给出的是固定类型,规则可以存进普通成员变量,可以出现在非模板函数参数里,可以跨模块传递而不共享模板实现,代价是每次调用多一层间接跳转,构造时可能触发堆分配,下一节分开说。选型时可以按场景分,规则编译期就定、调用足够热,优先模板参数;规则要进容器、从配置或插件加载、运行期增删替换、接口不能被调用方具体类型渗透,用 std::function。本系列前面给算法传谓词、比较器用的是模板参数,本章流水线阶段表属于后一类,阶段集合本身就是运行期数据。
间接调用和内存分配要花多少
通过 std::function 调用时,编译器在调用点看不到目标具体类型,控制流要经过包装器内部保存的分发信息再跳到目标代码,这层跳转让内联通常做不到;回调偶尔触发一次,开销可以忽略,热循环里每个元素都走间接调用,就要把分支预测和内联失败算进账里。目标对象保存在包装器内部,动态分配一般发生在构造和赋值包装器时,单次调用本身不再分配,多数标准库实现为小目标准备内置缓冲区(大约两三个指针大小),超出才去堆上申请,这是实现细节,标准不保证,在意就在目标平台实测;流水线若初始化时建好、之后跑百万次,主要成本是百万次间接跳转,堆分配只在初始化时出现零到几次,排查性能时要分清在为哪笔开销优化。
拷贝包装器会完整拷贝内部目标,目标背着大状态时,比如缓存了几千条记录的函数对象,拷贝包装器等于复制整份状态,回调表按值传递、包装器在容器间移动时,要意识到这份成本。若不想拷贝目标,可以用 std::ref 把对象包成引用再装进 std::function,包装器里存的是对原对象的引用,拷贝包装器本身很轻,代价是生命周期,被引用对象必须活得比最后一次调用更久,否则调用会踩已销毁对象,回调表、策略注册里选引用语义还是值语义,取决于规则对象归谁所有。把这几笔账合在一起,std::function 的成本是确定的间接调用、视实现而定的可能分配,以及拷贝带来的目标复制,接口设计阶段就应想清楚,热路径优先模板参数或具体类型,需要稳定接口和运行期配置时再上包装器,若性能剖析里 std::function 排前面,应针对那条热路径替换,而不是全局一刀切。
运行期拼装规则时的常见陷阱
std::function 适合运行期配置,但也引入几个容易踩的坑。生命周期错配是最常见的一类,lambda 按引用捕获的变量,闭包拷进包装器后仍然只是引用,包装器拷贝的是闭包对象,不是被引用的外部变量;包装器进长寿回调表,而被引用局部变量随函数返回销毁,后续调用就在读悬空引用,这种 bug 往往不立刻崩溃,装进长寿包装器的 lambda 宜按值捕获,或能保证被引用对象活得比包装器久。有人误以为拷贝 std::function 就拷贝了所有相关数据,其实拷贝确实复制闭包对象,但闭包成员若是引用或指针,副本里仍指向同一外部对象,不会做引用链上的深拷贝,判断生命周期是否安全,要看闭包成员存的是值还是引用。
递归 lambda 的自我引用是另一类问题,常见写法是先声明 std::function,再在捕获列表里按引用捕获这个变量,能跑,但原包装器销毁或移走后捕获的引用悬空,拷贝包装器时副本里的引用仍指向原来那个变量;需要递归时,写成具名函数对象,在 operator() 里按名字调用自身,更稳。
配置驱动的规则表是 std::function 很典型的用法,阶段表可以从配置读折扣构造 Discount,事件回调、插件注册、命令分发表结构类似,规则集合在运行期可读、可改、可增删,这是模板参数给不了、包装器给得了的能力。测试时同样受益,流水线若硬编码 Discount 类型,测折扣环节得准备真实数据走全链路,元素类型改成 std::function<int(int)> 后,可以注入恒等 lambda [](int x) { return x; } 或记录调用次数的假规则,单独验证串联逻辑,接口统一后换实现不必改被测代码。std::function 方便,但模块内部、编译期能定型的热循环不必强行包一层,包装器的价值在接口边界,跨模块、跨编译单元、跨运行期配置;内部紧密循环里堆满包装器,付了间接调用成本却用不上灵活性,就不划算。
系列回顾
本章是《图解 STL 算法与函数对象》的最后一章,第 01 章定范围契约,算法只见 [first, last),第 02 章讲迭代器类别约束算法,第 03 章把判断抽象成谓词和比较器,第 04、05 章把查询和遍历写成算法名,第 06 章讲 remove_if 与 erase 的分工,第 07 章处理数值折叠,第 08、09 章分别讲 lambda 和函数对象,本章处理规则要在运行期统一接口的情况。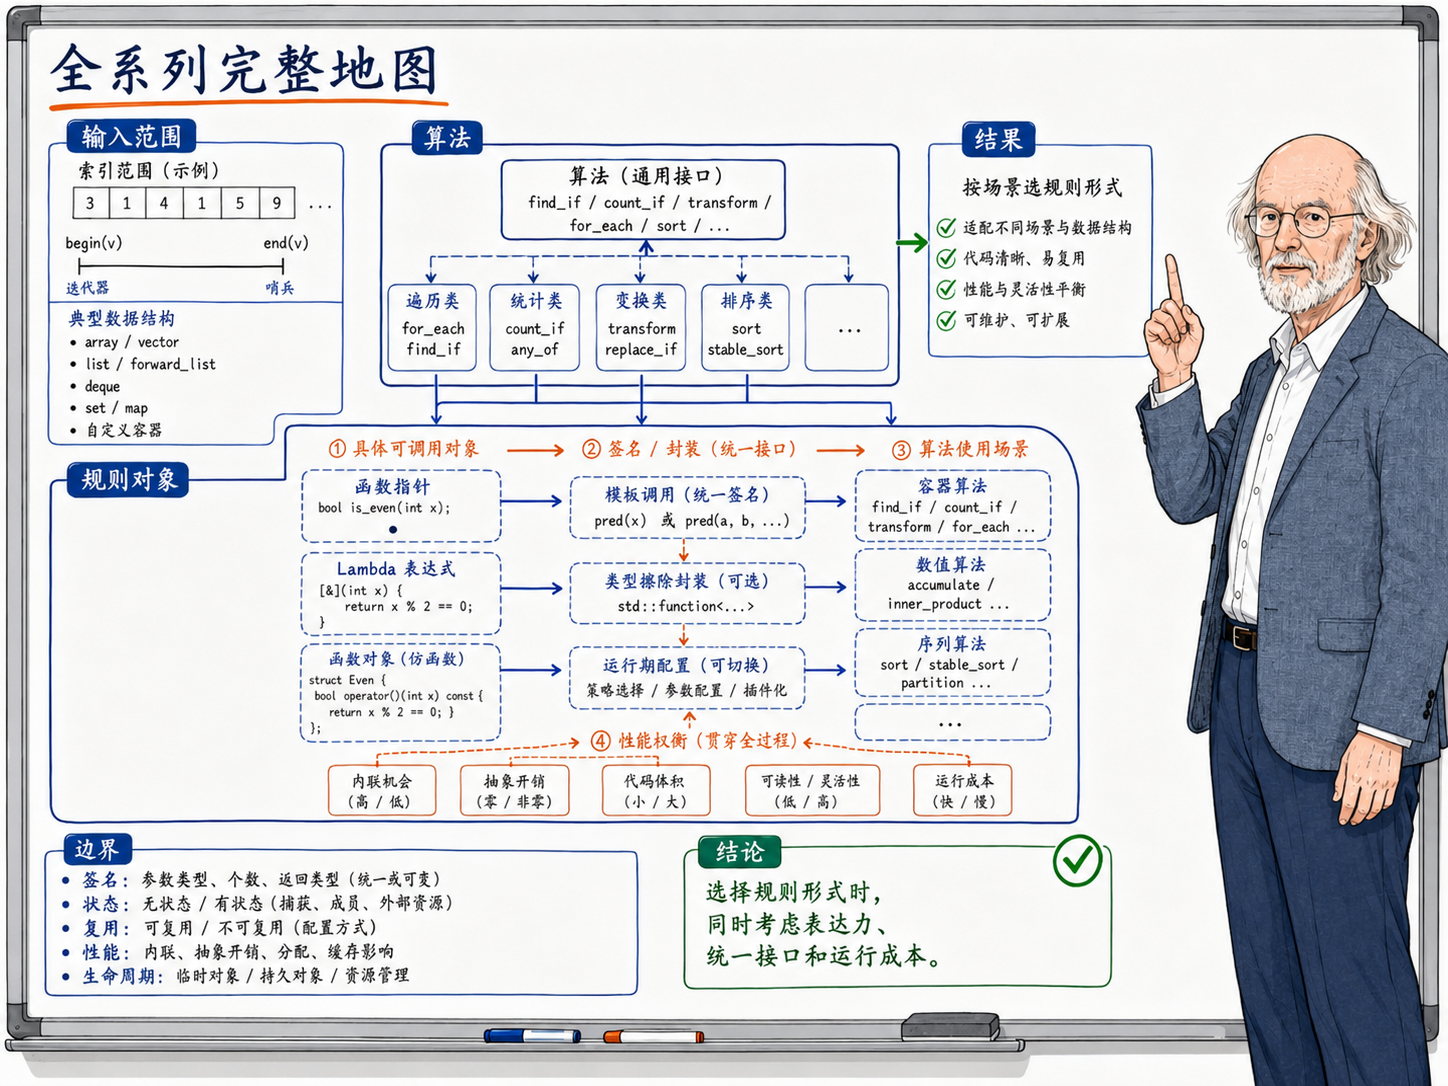
把整条线串起来,容器存数据,迭代器暴露范围,算法沿范围读写和重排,谓词和比较器把判断交给算法,lambda 写短规则,函数对象携带状态并复用,std::function 在运行期把不同形态的规则放进同一签名,容器、迭代器、算法、可调用对象四块构成 STL 数据处理的主干。从一批记录出发,筛选、转换、排序、去重、汇总各有算法落点,规则组织方式随场景变化,编译期定的走模板参数,运行期组的走 std::function,要带状态复用的用函数对象;C++20 ranges 会把范围契约做得更组合化,算法可以像本章流水线那样直接串联,那条线留到 Modern C++专题再写。
阅读导航



