
C++ remove_if 与 erase:重排、删除和遍历安全
06 remove_if 和 erase 配合完成真正删除
第一次用 std::remove_if 的人,通常会写出这样的代码(以下为片段):
std::vector<int> v{1, 2, 3, 4, 5};
std::remove_if(v.begin(), v.end(), [](int x) { return x % 2 == 0; });
std::cout << v.size(); // 输出 5,不是 3
调用之后检查 v.size(),发现容器大小没有变。偶数没有被"删掉",容器尾部还留着一些元素,值可能是原来的,也可能已经被覆盖成别的值。这个结果和函数名给出的暗示完全不一致——名字里写着 remove,为什么元素数量没有变?
答案在于算法和容器之间的职责划分。标准库算法只操作迭代器范围,不持有容器引用,也无法调用容器的成员函数;改变容器大小这件事,从头到尾都是容器自己的职责。remove_if 做的事情是在给定范围内重排元素,把需要保留的元素搬到前面,然后返回一个指向新逻辑尾的迭代器。真正缩短容器的是第二步:调用容器的 erase 把逻辑尾之后的部分删掉。这个两步配合被称为 erase-remove 惯用法,是 C++ 标准库中使用频率最高的组合模式之一。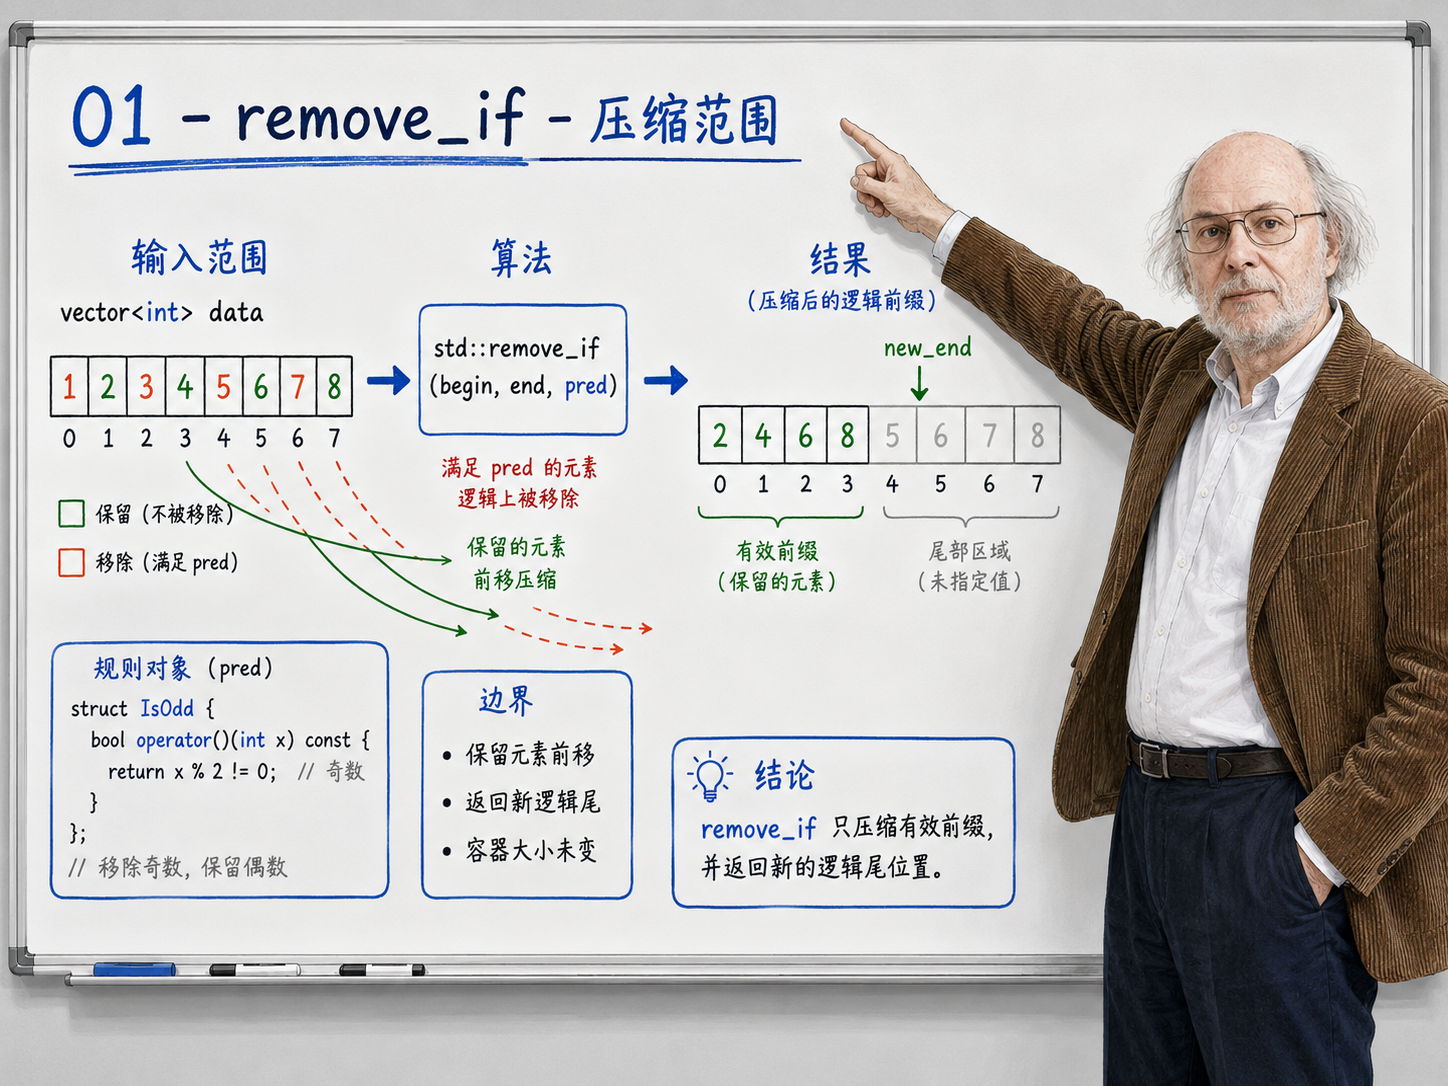
算法拿到的是迭代器范围,不是容器
标准库算法的参数通常是一对迭代器 [first, last),这个半开区间就是算法的全部工作台。算法通过迭代器读取、比较、写入或移动元素,但它看不到迭代器背后的容器对象。容器叫什么名字、容量多大、用的哪种分配器、内部是连续数组还是链表节点,对算法来说全部被迭代器接口挡在了外面。
这种隔离是有意设计的。同一个 std::find 可以用在 vector、deque、原生数组甚至输入流迭代器上,只要传入的迭代器满足算法所需的能力——能解引用取值、能递增到下一个位置、能判断是否到达终点。算法和容器各自独立变化,中间靠迭代器能力约束来对接,这是 STL 能把几十种算法和十几种容器自由组合的结构基础。
正因为算法看不见容器,它也就不可能改变容器的大小。push_back、erase、resize 这些能增减元素数量的操作,全都是容器的成员函数,算法没有途径调用它们。算法能做的最多是在已有范围内重排元素——把某些元素搬到前面或后面——然后通过返回值告诉调用方"有效区间到哪里为止"。理解了这一点,remove_if 的行为就不再反直觉了。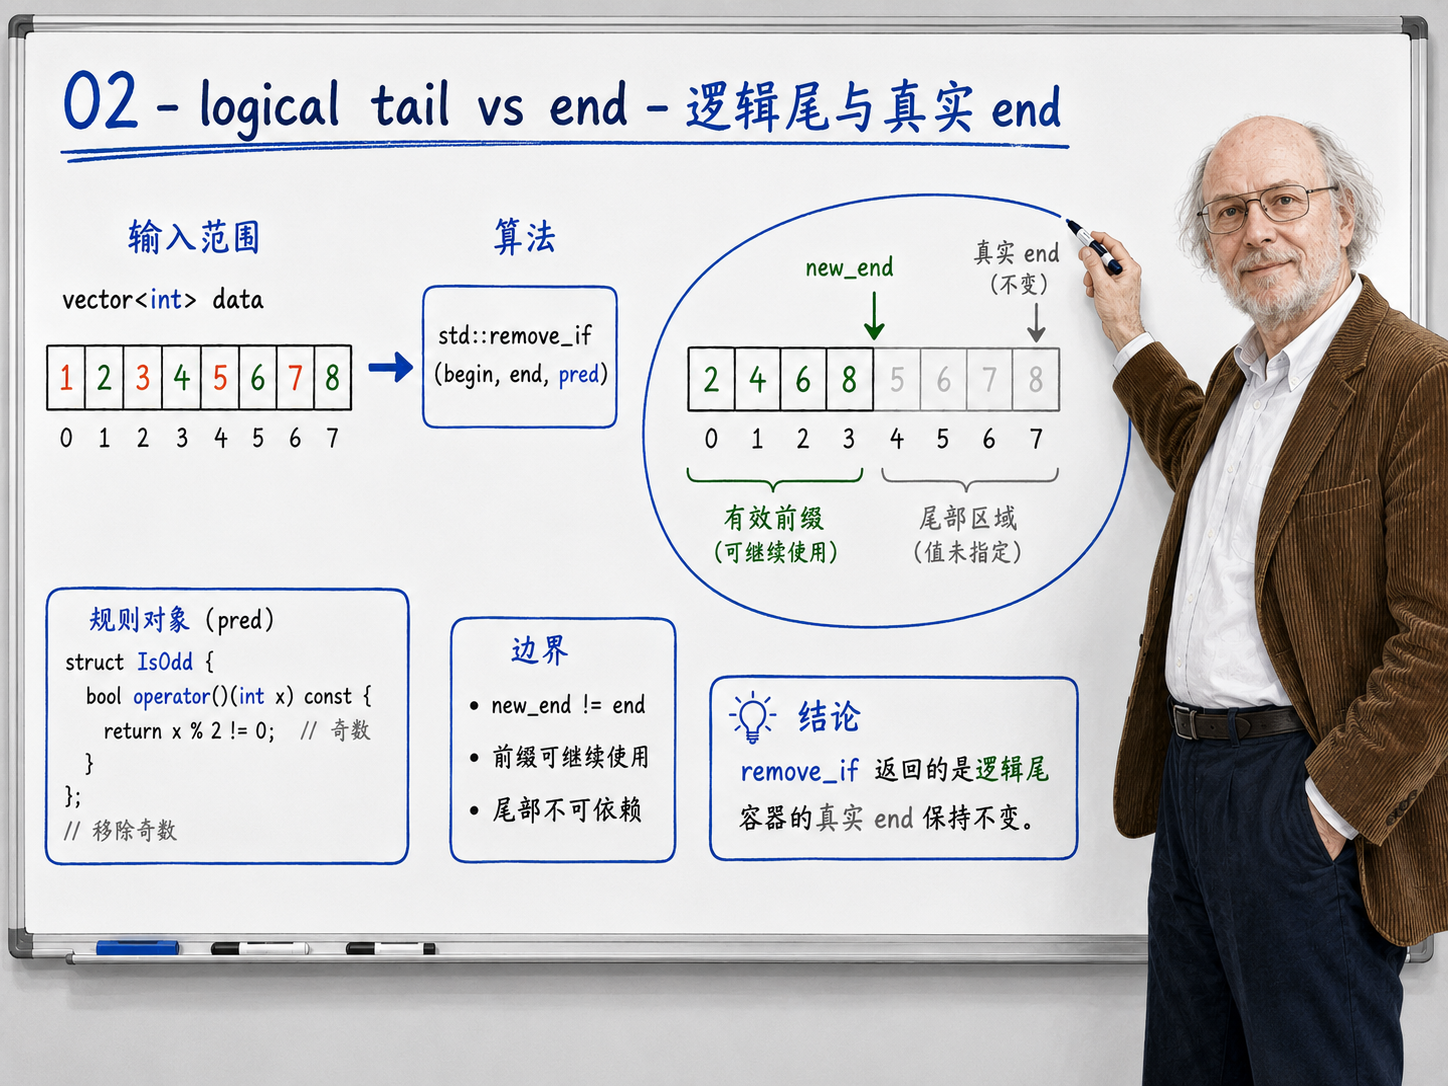
remove_if 做了什么:重排而非删除
remove_if 接收一对迭代器和一个谓词(Predicate),遍历范围内的每个元素。对于谓词返回 false 的元素,算法把它移动赋值到范围前部的下一个可用位置;对于谓词返回 true 的元素,算法跳过。遍历结束后,所有需要保留的元素被紧凑地排列在范围前段,算法返回一个迭代器,指向最后一个保留元素之后的位置,这就是新的逻辑尾。
如下图所示,逻辑尾把范围分成了两段。前段是所有保留元素,顺序与原来一致(标准规定 remove_if 保持未被移除元素的相对顺序,即它是稳定的)。后段——从逻辑尾到原来的 end() 之间——处于标准所说的"有效但未指定"(valid but unspecified)状态:这些位置上仍然是合法的对象实例,可以被赋值或销毁,但具体持有什么值没有保证。有些实现会在这些位置留下原值,有些会留下移动操作后的残留值,依赖这段区间的内容是不可靠的。
以开头的例子为例,对 {1, 2, 3, 4, 5} 调用 remove_if 移除偶数后,前三个位置会变成 {1, 3, 5},这是保留下来的元素;后两个位置的值不确定,可能是 {4, 5},也可能是 {3, 5} 或其他组合。remove_if 返回的迭代器指向第四个位置,告诉调用方"前三个才是你要的"。但容器的 size() 仍然返回 5,因为没有人调用过能改变容器大小的操作。
两步才能真正删除:erase-remove 惯用法
把 remove_if 和容器的 erase 组合起来,就得到了完整的条件删除流程:
auto new_end = std::remove_if(v.begin(), v.end(), pred);
v.erase(new_end, v.end());
第一步是算法的职责——在范围内重排元素,返回逻辑尾。第二步是容器的职责——销毁从逻辑尾到 end() 之间的元素,更新 size()。对 vector 来说,erase 之后 size() 会缩小,但 capacity() 通常不变,底层内存不会立即归还。两步的分工精确对应了算法和容器各自的能力边界,这也是为什么标准库没有把它们合并成一个调用——至少在 C++17 及之前没有。
C++20 引入了 std::erase_if 非成员函数,接收容器引用和谓词,内部同时完成重排和删除。对 vector 和 string 来说,std::erase_if(v, pred) 等价于上面两行代码。如果项目编译器支持 C++20,这个接口可以减少遗漏 erase 的机会,同时也为关联容器提供了统一的按条件删除入口。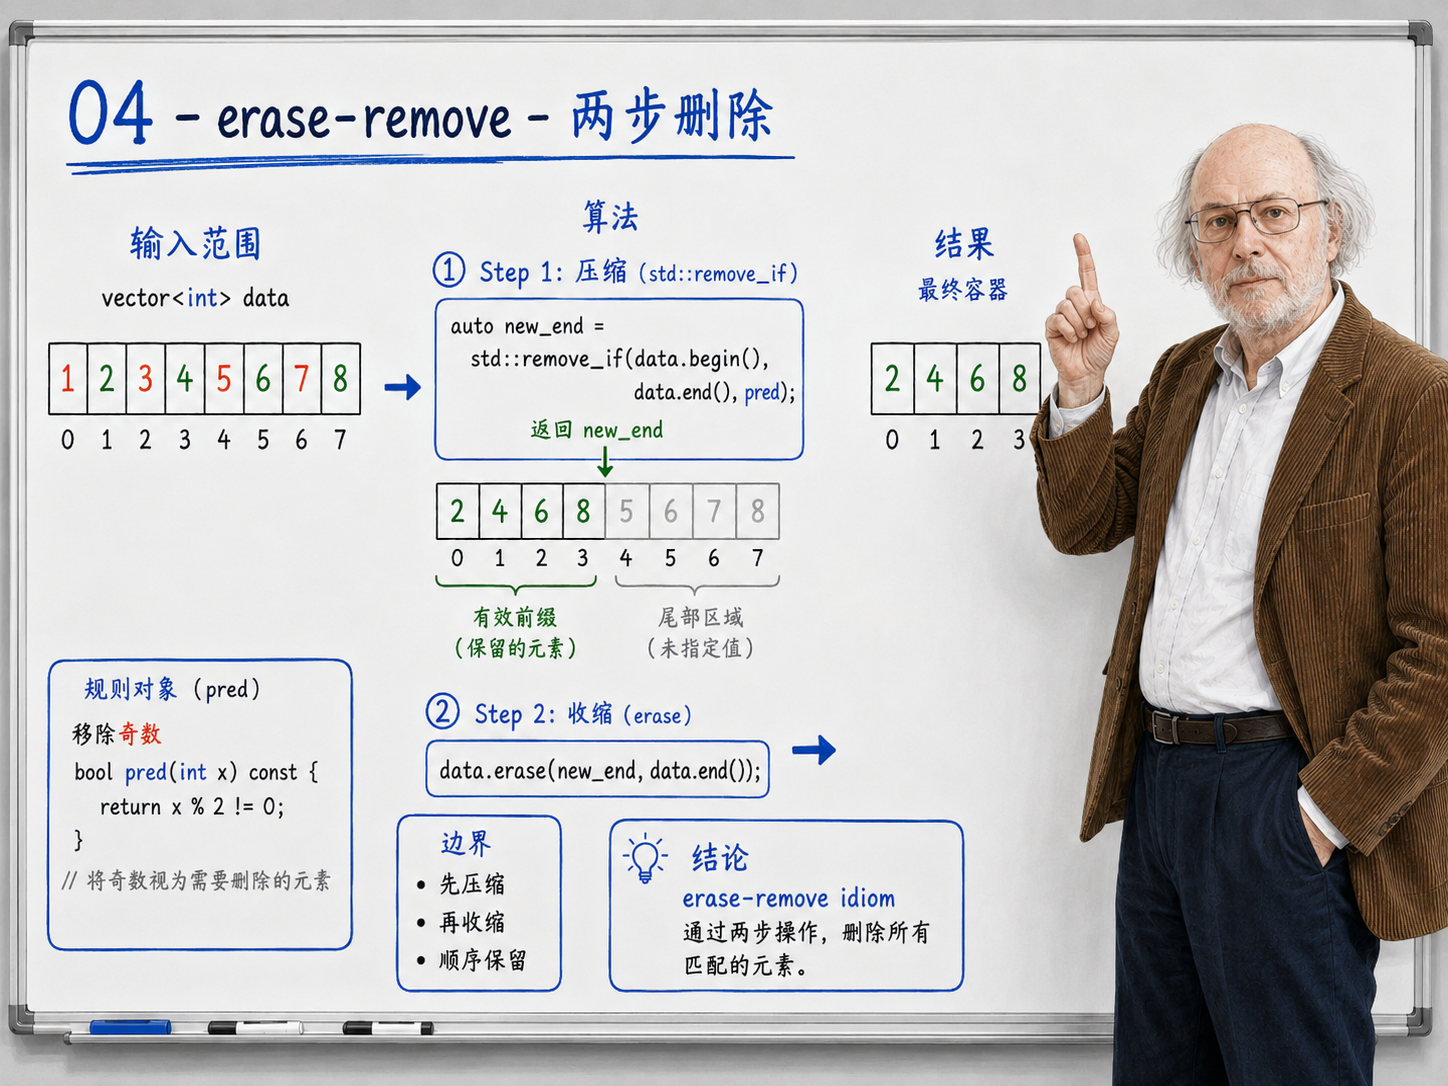
代码示例
本章示例文件是 代码示例/06-erase-remove/erase_remove.cc,演示 erase-remove 惯用法的完整过程。
// Copyright (c) 2026 yus3nable
// SPDX-License-Identifier: MIT

#include <algorithm>
#include <iostream>
#include <string>
#include <vector>

struct Task {
  std::string title;
  bool done = false;
};

int main() {
  std::vector<Task> tasks{
      {"parse input", true}, {"build index", false},
      {"write report", true}, {"verify output", false}};

  // 第一步:remove_if 把 done == false 的任务搬到前面,返回逻辑尾
  const auto logical_end = std::remove_if(
      tasks.begin(), tasks.end(),
      [](const Task& task) { return task.done; });

  // 此时 tasks.size() 仍然是 4,逻辑上只有前 2 个元素有效
  std::cout << "size after remove_if: " << tasks.size() << '\n';
  std::cout << "logical kept count:   "
            << std::distance(tasks.begin(), logical_end) << '\n';

  // 第二步:erase 真正缩短容器
  tasks.erase(logical_end, tasks.end());

  std::cout << "size after erase:     " << tasks.size() << '\n';
  std::cout << "remaining:";
  for (const Task& task : tasks) {
    std::cout << ' ' << task.title;
  }
  std::cout << '\n';
}
运行输出:
size after remove_if: 4
logical kept count:   2
size after erase:     2
remaining: build index verify output
前两行输出是这段代码最关键的观察点。remove_if 调用结束后,tasks.size() 仍然返回 4,容器没有缩短;但 std::distance(tasks.begin(), logical_end) 返回 2,说明 remove_if 通过返回值把有效区间的边界交给了调用方。第三行 erase 之后,size() 才变成 2,尾部两个位置的 Task 对象被真正销毁。如果把 erase 那一行注释掉,remaining 的输出会多出两个 title 值不可预测的条目。
谓词 [](const Task& task) { return task.done; } 表达的规则是"已完成的任务应当被移除"。remove_if 对谓词返回 true 的元素执行跳过,对返回 false 的元素保留并前移。这个谓词不修改元素,也不读写外部状态。保持谓词短小且无副作用是一项值得遵守的约束:标准没有规定谓词被调用的次数和顺序(只保证每个元素至多被调用一次谓词,但 remove_if 内部的移动操作可能导致同一个位置被多次写入),有副作用的谓词在不同标准库实现上可能产生不同结果。
常见误判:以为 remove_if 会缩短容器
这个误判的产生非常自然。函数名叫 remove_if,日常英语里 remove 就是"移除",调用之后容器元素理应变少。加上 Python 的 list.remove()、Java 的 ArrayList.removeIf() 都会真正改变集合大小,从其他语言转来的开发者几乎一定会带着这个预期。
误判之所以能存活很久,是因为在一类场景下它碰巧不引发可观测问题:如果 remove_if 之后函数就结束了,容器随即析构,缺少 erase 不会产生可见的 bug。问题出在容器继续被使用的时候——后续遍历会扫到尾部那些值不确定的元素,size() 返回偏大的计数会干扰边界检查,把容器序列化到磁盘或网络会写出多余的脏数据。这些 bug 不在 remove_if 那一行暴露,而是延迟到下游才显现,排查时容易把注意力放错位置。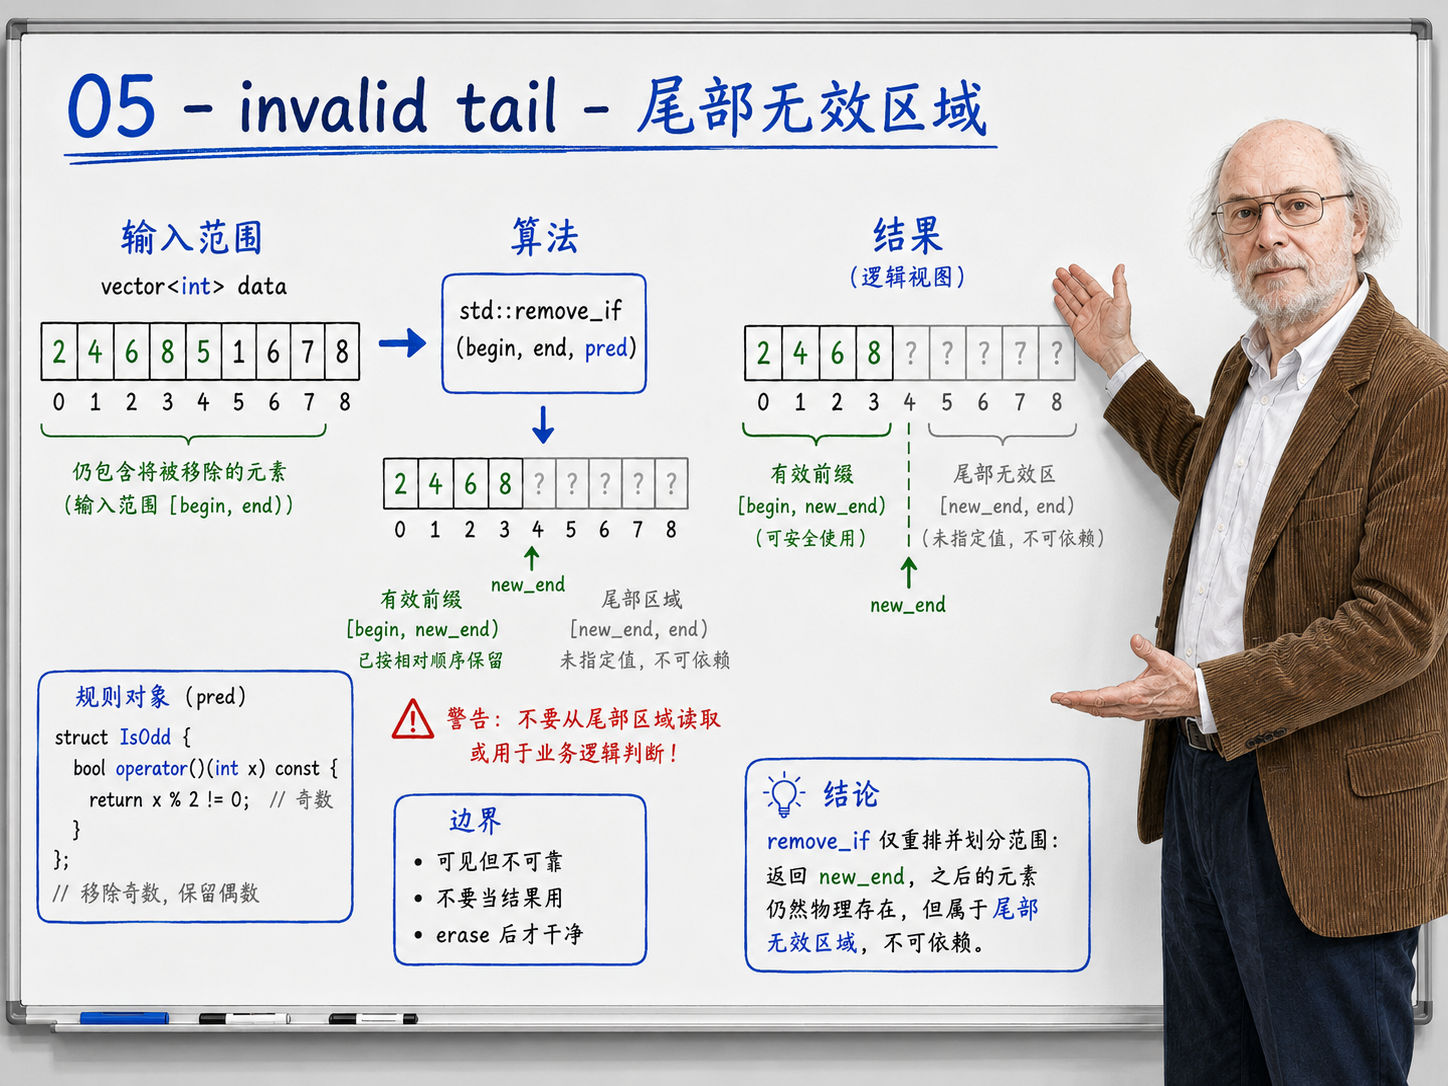
哪些容器适合 erase-remove
erase-remove 惯用法主要服务于顺序容器,尤其是 vector、deque 和 string。这些容器的元素在内存中连续或分段连续排列,remove_if 通过移动赋值把保留元素紧凑到前部,效率和手写循环接近,整体时间复杂度是 O(n)。
关联容器(map、set、unordered_map、unordered_set)的底层存储是树或哈希桶,元素之间没有线性的前后关系,对它们调用算法版本的 std::remove_if 没有意义。这些容器提供了成员函数 erase:按键删除用 container.erase(key),按迭代器删除用 container.erase(it),按条件批量删除在 C++20 之前需要自己写迭代器循环,C++20 之后可以直接使用 std::erase_if 的关联容器重载。
std::list 和 std::forward_list 虽然也是顺序容器,但它们各自有成员函数 remove_if,直接在链表节点上摘除目标元素,不需要配合算法版本的 std::remove_if。对链表使用算法版本并非不能编译,但它会做不必要的元素移动——链表的优势恰恰在于通过调整指针来增删节点,移动元素反而浪费了这个优势。
一条经验法则:遇到条件删除需求时,先看容器类型。vector 和 string 用 erase-remove 或 C++20 std::erase_if;list 用成员 remove_if;关联容器用成员 erase 或 C++20 std::erase_if 重载。选错路径不一定导致编译错误,但会损失效率或写出不符合惯例的代码,给后续维护留下困惑。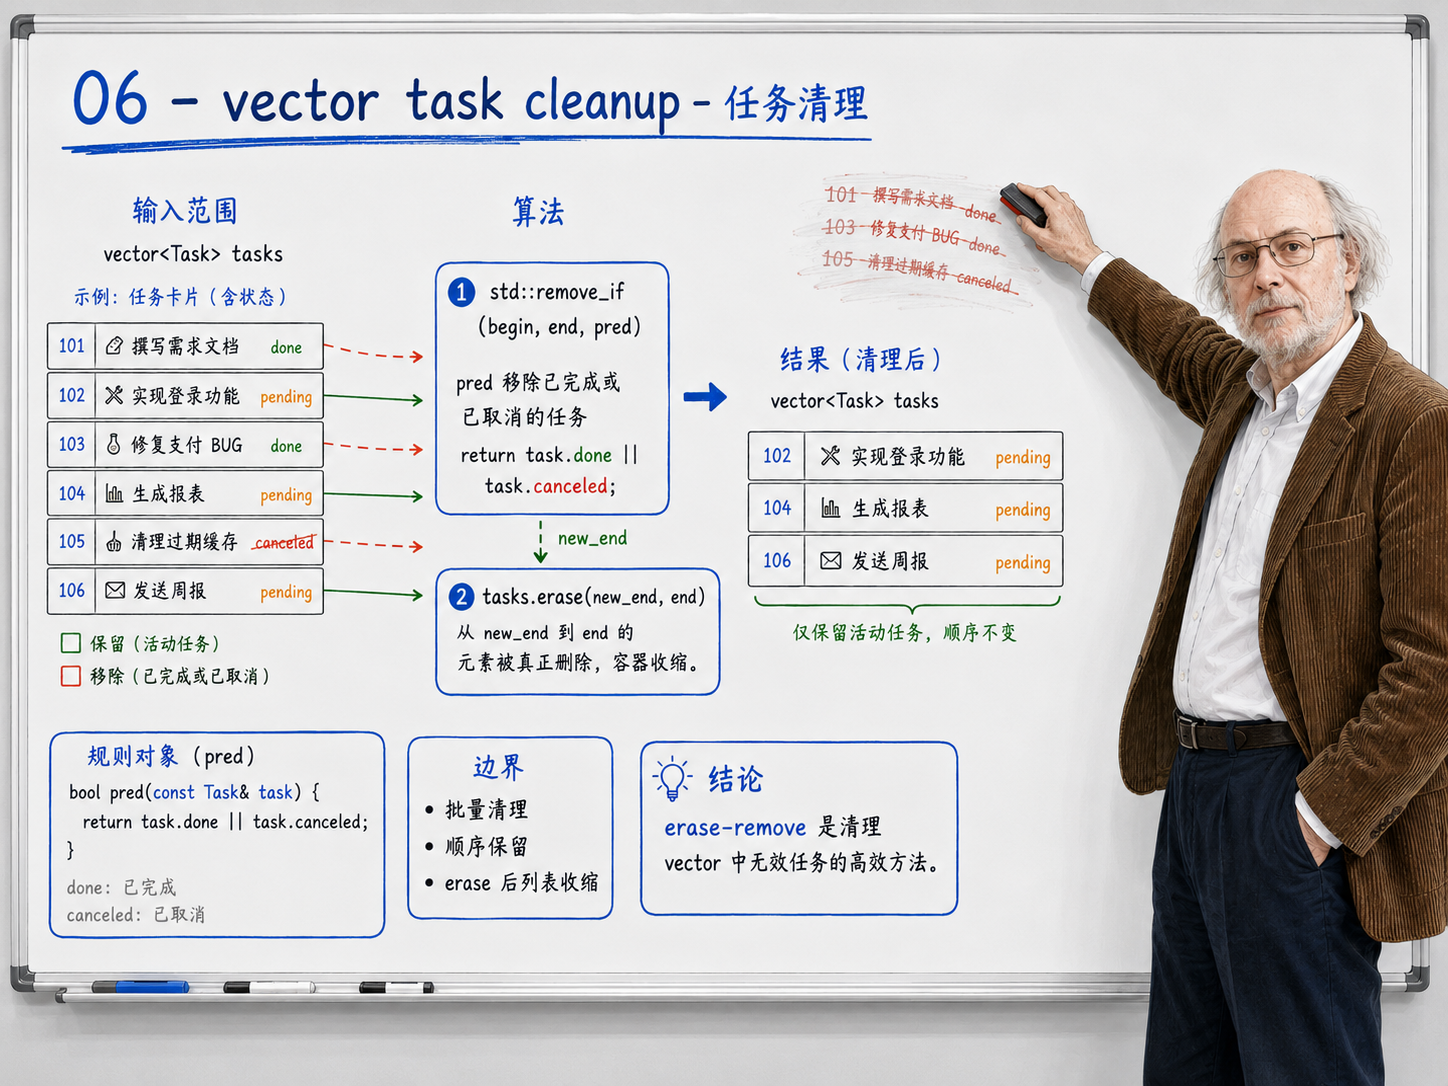
遍历中直接 erase 为什么危险
和 erase-remove 相关的另一个高频错误是在遍历 vector 时直接调用 erase(以下为片段):
for (auto it = v.begin(); it != v.end(); ++it) {
    if (should_remove(*it)) {
        v.erase(it); // it 在这一行之后失效
    }
}
vector::erase 会把被删除位置之后的所有元素向前搬移,然后使从删除位置到 end() 的所有迭代器失效。标准规定,对失效迭代器执行解引用或递增是未定义行为(Undefined Behavior)。上面的代码在 erase 返回之后继续对已失效的 it 执行 ++it,实际表现取决于实现:可能跳过紧邻的下一个元素,可能重复处理同一个元素,也可能直接崩溃。在开启调试迭代器的构建(如 MSVC 的 /D_ITERATOR_DEBUG_LEVEL=2)下,这类错误通常会在运行时被诊断工具捕获。
正确的迭代器循环写法是用 erase 的返回值接住下一个有效位置:
for (auto it = v.begin(); it != v.end(); ) {
    if (should_remove(*it)) {
        it = v.erase(it); // erase 返回指向下一个元素的迭代器
    } else {
        ++it;
    }
}
这种写法正确但效率不高:每次 erase 都会触发后续元素的搬移,如果需要删除的元素分布在整个容器中,最坏情况下时间复杂度是 O(n²)。erase-remove 惯用法把所有保留元素一次性搬到前部,最后一次性 erase 尾部,整体只做一趟遍历加一次尾部销毁,是 O(n)。在大容器上批量删除时,两种写法的性能差距会很明显。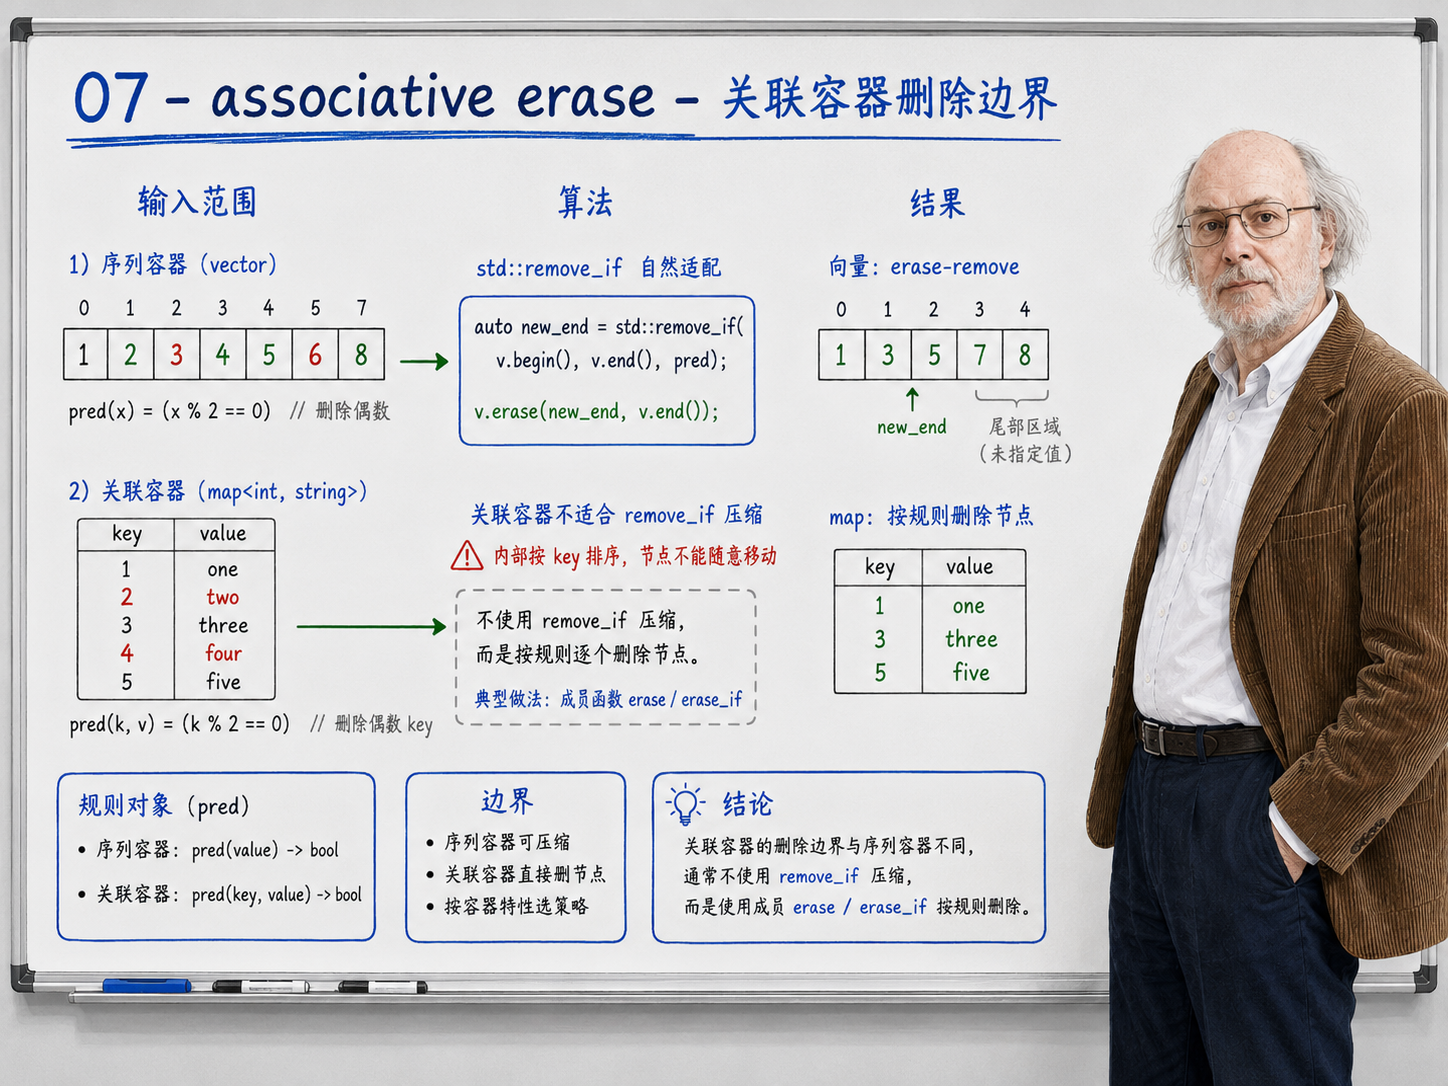
工程判断:算法调用还是手写循环
erase-remove 适合表达"按条件批量删除"这一个明确意图。当删除逻辑能被一个谓词完整表达、不需要在删除过程中执行其他副作用时,erase-remove 比手写循环更短、更安全,在 code review 中也更容易被快速理解——审查者看到 remove_if 配 erase,注意力会自然落到谓词是否正确、是否遗漏了 erase 这两个检查点上。
手写循环更合适的场景是:删除过程中需要对每个被删除的元素执行副作用(记录日志、更新统计指标、通知观察者),或者删除条件依赖于前一个元素的处理结果,无法用一个无状态谓词表达。这类情况下强行把逻辑塞进谓词会让代码更难读,不如直接写循环并用 erase 返回值维护迭代器。迁移旧代码时也要注意盘点原循环中附带的副作用:原循环如果在某个分支里打印日志、跳过异常数据或更新外部计数器,改成 erase-remove 之后这些观察点需要显式安排到别处,否则重构后行为会悄悄丢失。
判断标准不是"算法比循环高级",而是代码的意图能不能被算法名字准确传达。如果一段循环同时承担过滤、转换和状态更新三件事,拆成 remove_if + transform + 显式语句之后每段各自表达一个意图,可读性和可审查性都会提升。但如果拆完之后反而需要更多中间容器和临时变量、整体反而更难跟踪数据流,那就不如保留循环。留在代码库里的手写循环也因此更有信号价值:读者看到它,会知道这里确实有标准算法不好表达的业务结构。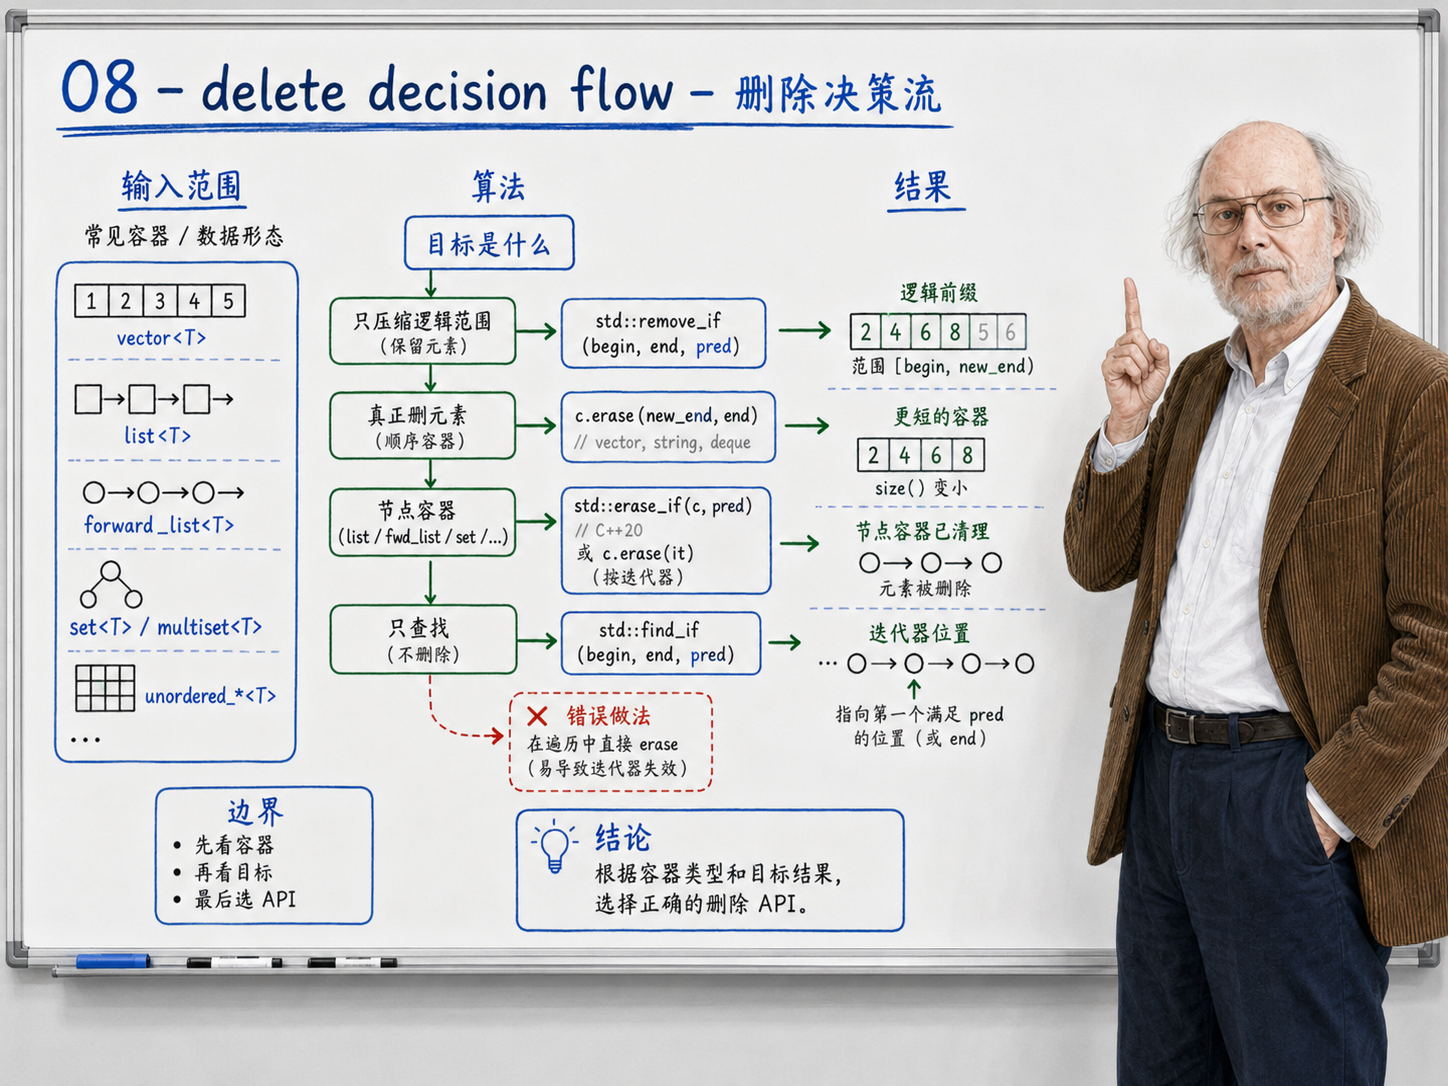
和前后章节的关系
前面的章节讲了容器怎样存放元素、迭代器怎样把容器暴露成范围。本章在这个基础上引入了第一个需要两步配合才能完成的标准算法模式,它展示了贯穿整个 STL 的一条分工线:算法在迭代器范围上操作元素,容器负责管理自身的存储和生命周期。这条分工线在后续的 sort、find_if、transform、accumulate 中完全一致——算法处理范围,规则交给调用方传入的可调用对象,容器的结构性变更由容器自己完成。
本章的谓词也为后面的可调用对象模型做了铺垫。谓词是最简单的一种可调用对象:接收一个元素,返回布尔值,不携带状态。当规则变得复杂、需要捕获外部变量或者跨多个调用点复用时,lambda 捕获、函数对象和 std::function 就会依次进入视野。下一章会从数值处理的角度继续展开算法的使用方式,把"遍历范围并将结果折叠成一个累计值"这个模式讲清楚。
阅读导航



