
SGLang DP 调度源码:Controller 与负载均衡策略
SGLang 引擎内 DP 负载均衡调度细节
一句话:当
dp_size > 1时,SGLang 用DataParallelController把每条已 tokenize 的请求钉死到某一个 DP Scheduler;本文讲清「为什么要钉、在哪钉、按什么规则钉、负载信息怎么传」。
大规模推理很少只用「一张卡跑一个完整模型副本」。常见做法是:
- 多卡并行切模型(TP / EP / PP …)
- 多份请求并行(Data Parallel,DP):不同请求(或其 Attention/KV)落在不同
dp_rank上
一旦有多个 DP,就出现一个必答题:
下一条 HTTP 请求,应该交给哪一个 DP?
答错的代价很具体:
| 现象 | 可能原因 |
|-|-|
| 某个 DP 队列爆满、其它空闲 | 选 rank 策略不合适,或负载反馈没跟上突发 |
| Prefill/Decode 对不上(PD) | Prefill 侧没有稳定的 room 映射 |
| 前缀缓存命中差 | 本该亲和的请求被打散到不同 rank / 不同机器 |
SGLang 把这件事拆成两层:
- 引擎内:同一进程树里的多个 Scheduler 之间 →
DataParallelController(本文重点) - 网关外:多台独立 worker / PD 实例之间 →
sgl-model-gateway等(本文只划边界,不展开实现)
读者
| 适合谁 | 不适合单独指望本文解决什么 |
|---|---|
要读 / 改 data_parallel_controller.py 的人 | 如何配置 DeepEP / EPLB 专家均衡 |
调 --dp-size / --load-balance-method 的人 | 完整 PD KV 传输协议细节 |
| 排查「请求总打到一个 DP」的人 | DPA 公式与显存估算的完整推导 |
本文概要
范围内
dp_size > 1时引擎内如何选dp_rank--load-balance-method四种策略与auto默认LoadSnapshot/ SHM / 谁读负载- 与 PD Prefill(
follow_bootstrap_room)、DPA、外部routed_dp_rank的衔接点
范围外(只点到为止) - Gateway 的
cache_aware/prefix_hash等跨实例策略 - MoE 专家负载均衡(EPLB)
- Scheduler 内部如何组 batch(那是「钉死之后」的本地事)
源码基准路径(相对 SGLang 仓库): python/sglang/srt/managers/data_parallel_controller.pypython/sglang/srt/managers/load_snapshot.pypython/sglang/srt/managers/scheduler_components/load_inquirer.pypython/sglang/srt/server_args.py(_handle_load_balance_method)
CLI 参数:--dp-size、--enable-dp-attention、--load-balance-method、--disaggregation-mode。
1. 背景:进程模型、DP、DPA
1.1 SGLang 服务进程(极简)
一次典型 sglang serve / launch_server 大致是:
客户端 HTTP
    |
    v
TokenizerManager (主进程侧)     # tokenize、请求状态
    |  ZMQ
    v
[DataParallelController]        # 仅 dp_size > 1 时存在;选 dp_rank
    |  ZMQ
    v
Scheduler x N (GPU 子进程)      # 组 batch、跑模型;每 DP 至少一路
    |
    v
Detokenizer -> 回 TokenizerManager -> HTTP 响应
要点:
- 选 DP 发生在 tokenize 之后、进 Scheduler 之前。
- 回包不经过 Controller。
dp_size == 1时没有 Controller,TM 直连唯一 Scheduler。
1.2 什么是「传统 DP」与「DP Attention(DPA)」
两者都会出现多个 dp_rank,且选 rank 的代码路径相同;差别在「卡上怎么切模型」:
| 传统 Data Parallel | DP Attention(--enable-dp-attention) | |
|---|---|---|
| 直观理解 | 多份更「完整」的副本,各吃一部分请求 | Attention/KV 按请求分到各 DP;常与大 EP 一起用于 DeepSeek 类 MLA+MoE |
| 启动 | launch_dp_schedulers | launch_dp_attention_schedulers |
| 和本文关系 | Controller 仍按策略把请求钉到某一 DP | 同上;KV 跟请求走,钉错 rank 等于钉错显存归属 |
DPA 常见口诀(部署细节可另查文档):开启后 CLI 的 --tp-size 往往表示 world size,真正的 Attention TP 约为 tp_size / dp_size / attn_cp_size。 |
1.3 为什么必须「钉死」某一个 DP
请求一旦进入某 DP:
- 该 DP 上的 KV cache / 队列状态 归属该请求;
- Scheduler 不会再跨 DP 挪这个请求;
- 后续 decode step 都在同一
ps.dp_rank上。
因此「选 rank」是一次性决策,错了只能靠上层重试/取消,引擎内没有自动迁移。
1.4 最小启动心智(示例)
# 一体机:8 卡宽 DPA,引擎内默认 round_robin
sglang serve --model-path <MODEL> \
  --tp-size 8 --dp-size 8 --enable-dp-attention \
  --load-balance-method auto   # -> round_robin

# PD Prefill:auto -> follow_bootstrap_room(需 Router 注入 bootstrap_room)
# PD Decode:auto -> round_robin
2. 先分清三层「均衡」
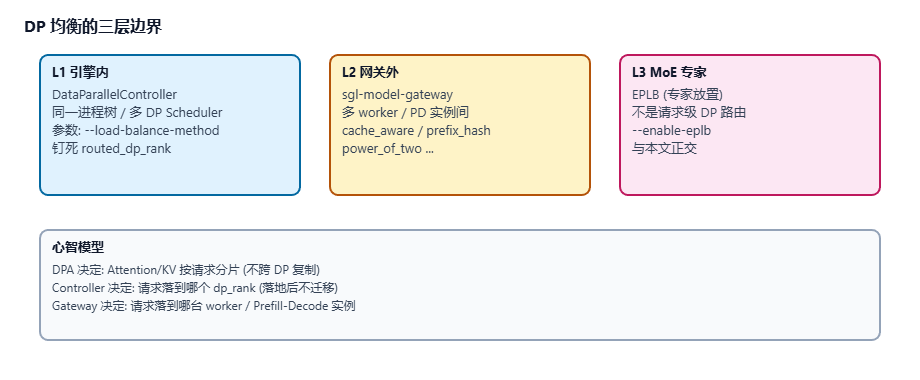
| 层级 | 组件 | 均衡对象 | 本文是否展开 |
|---|---|---|---|
| L1 引擎内 | DataParallelController | 同一进程树里的多个 DP Scheduler | 是 |
| L2 网关外 | sgl-model-gateway | 多个独立 worker / PD 实例 | 仅边界 |
| L3 MoE | EPLB | 专家放置(不是请求级 DP 路由) | 仅点名 |
| 心智模型: |
DPA 决定 Attention/KV 按请求分片(不跨 DP 复制);Controller 决定请求落到哪个
dp_rank(落地后不迁移);Gateway 决定落到哪台 worker。
参数:--load-balance-method(auto/round_robin/follow_bootstrap_room/total_requests/total_tokens)。
常见混淆:
| 说法 | 澄清 |
|---|---|
| 「开了 DPA 就不需要负载均衡」 | 错。DPA 只解决切分方式;多 DP 仍要选 rank。 |
| 「Gateway 的 cache_aware 就是引擎内 RR」 | 错。那是 L2;引擎内是另一道闸。 |
| 「EPLB 会把请求挪到别的 DP」 | 错。EPLB 动专家放置,不动请求的 dp_rank。 |
3. 引擎内请求路径
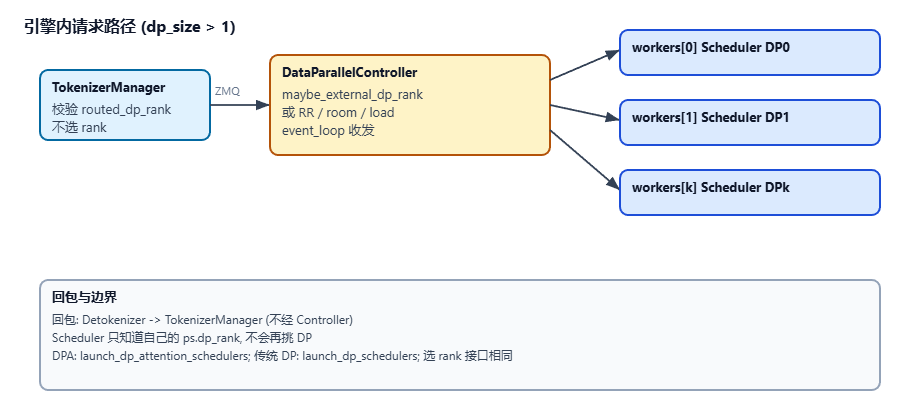
HTTP -> TokenizerManager
          | ZMQ (scheduler_input)
          v
    DataParallelController   <- 在这里选 dp_rank(见下一节)
          | ZMQ PUSH -> workers[k]
          v
    Scheduler(dp_rank=k)     <- 只服务本 rank 队列
          |
          v Detokenizer -> TM   (回包不经 Controller)
要点:
- TM 只校验
routed_dp_rank合法,不选 rank。 dp_size > 1才起 Controller;dp_size == 1时 TM 直连唯一 Scheduler。- 开
--enable-dp-attention:launch_dp_attention_schedulers;否则:launch_dp_schedulers。选 rank 的接口同一套。 - Scheduler 只知道自己的
ps.dp_rank,不会跨 DP 挪请求。
4. Controller 如何选 dp_rank(核心)
源码:python/sglang/srt/managers/data_parallel_controller.py。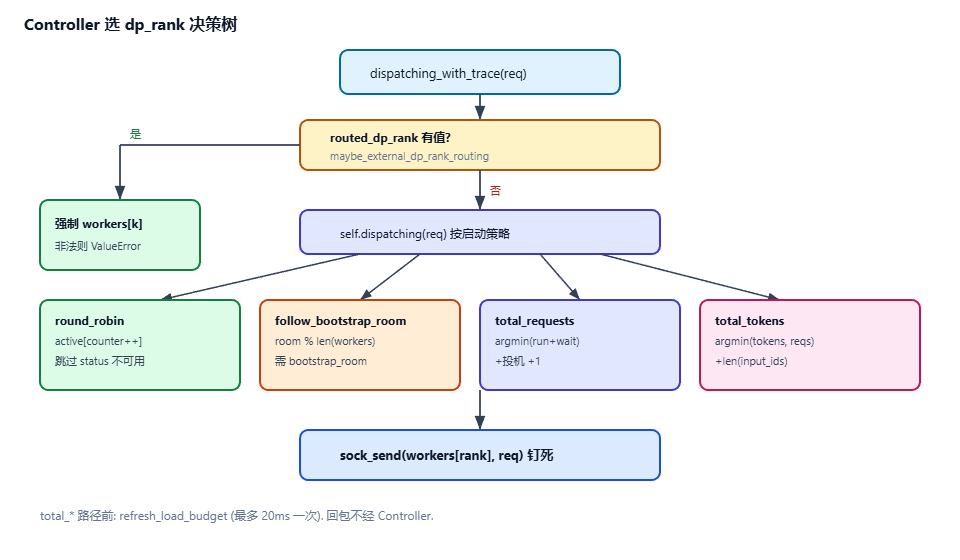
4.1 总决策树
TokenizerManager  --ZMQ-->  DataParallelController.event_loop
                              |
                              v
                    dispatching_with_trace(req)
                              |
              (仅 total_* ) refresh_load_budget()  # 最多 20ms 一次
                              |
                              v
                    self.dispatching(req)   # 启动时按 --load-balance-method 绑死
                              |
              +---------------+---------------+
              |                               |
   routed_dp_rank 有值?                  无 -> 走策略
              |                               |
              v                               v
     强制 workers[rank]          RR / room%N / min(load)
              |
              v
        sock_send(workers[k], req)   # 钉死,之后不再换 DP
四种策略函数在构造时绑定到 self.dispatching:
ROUND_ROBIN           -> round_robin_scheduler
FOLLOW_BOOTSTRAP_ROOM -> follow_bootstrap_room_scheduler
TOTAL_REQUESTS        -> total_requests_scheduler
TOTAL_TOKENS          -> total_tokens_scheduler
auto 在进 Controller 之前已由 server_args._handle_load_balance_method 解析:
非 PD          -> round_robin
PD prefill     -> follow_bootstrap_room
PD decode      -> round_robin
(PD = Prefill/Decode 分离:--disaggregation-mode prefill|decode。一体机为 null。)
4.2 优先级 0:外部钉死 routed_dp_rank
四种 *_scheduler 一进来都先调 maybe_external_dp_rank_routing:
| 条件 | 行为 |
|---|---|
req.routed_dp_rank is not None | 直接 sock_send(workers[rank], req),不再看 RR/负载 |
rank 非法 / 不在 _active_workers / socket 为 None | ValueError |
| 未设置 | 返回 False,继续走当前策略 |
| 用途:Gateway 前缀亲和、客户端指定 DP。TM 只做范围校验;真正选/强制在 Controller。 |
4.3 策略 round_robin(默认一体机 / PD Decode)
RR = Round Robin(轮询)。
active = _active_workers          # 弹性 EP 可扩缩
slot = active[round_robin_counter % len(active)]
counter = (counter + 1) % len(active)
若 status[slot] 可用 -> 发往 workers[slot]
否则再试下一格;一圈全挂 -> RuntimeError
- 不看队列长度、不看 token 数,只按到达顺序摊开。
- 候选集是 active,不是全部
workers槽位。 status[slot]可因故障 / 弹性标为不可用。
4.4 策略 follow_bootstrap_room(PD Prefill 默认)
assert bootstrap_room is not None
target_rank = bootstrap_room % len(self.workers)
sock_send(workers[target_rank], req)
- 同一
bootstrap_room→ 永远同一 Prefill DP(与 Decode / Bootstrap 会合)。 - 不看负载;当前实现也 不检查
status(比 RR「更死」)。 - 取模用的是
len(self.workers)(含--max-ep-size预留槽),不是len(_active_workers)。 - 无
bootstrap_room直接 assert(要求走 Router 注入,勿直连 Prefill)。
背景简述:PD 模式下 Prefill 与 Decode 是两套服务;请求带bootstrap_host/port/room三元组对齐会话。Prefill 侧必须用 稳定、可复现 的映射,才能让 Decode 找到对的 Prefill DP。详见第 8 节。
4.5 策略 total_requests / total_tokens(负载感知)
仅这两种会在 dispatching_with_trace 里调用 refresh_load_budget()
预算来自各 Scheduler 的 LoadSnapshot:
| 预算字段 | 快照来源 |
|---|---|
total_requests[r] | num_running_reqs + num_waiting_reqs |
total_tokens[r] | num_total_tokens |
DPBudget.dispatch 选 rank: | |
| 方法 | 选谁 |
| - | - |
total_requests | argmin(total_requests);并列取更小下标(list.index(min)) |
total_tokens | argmin(tokens, requests) |
投机更新 = Controller 先在本地预算里假装「这个请求已经算进该 DP 的负载了」,不必等 Scheduler 真正跑起来、再经 SHM 回报。
Batch 请求:整批只refresh一次,批内每条refresh_load_budget=False,靠连续投机+1/+tokens散开。
4.6 对照一览
| 条件 | 选中的 rank |
|---|---|
routed_dp_rank=k | k(最高优先) |
round_robin | active[counter++],且 status 可用 |
follow_bootstrap_room | bootstrap_room % len(workers) |
total_requests | argmin(running+waiting) + 投机 +1 |
total_tokens | argmin(tokens, reqs) + 投机 +len(input_ids) |
选完只做一件事:sock_send(self.workers[rank], req)。Scheduler 侧不再改 DP。 |
5. 四种策略速查图
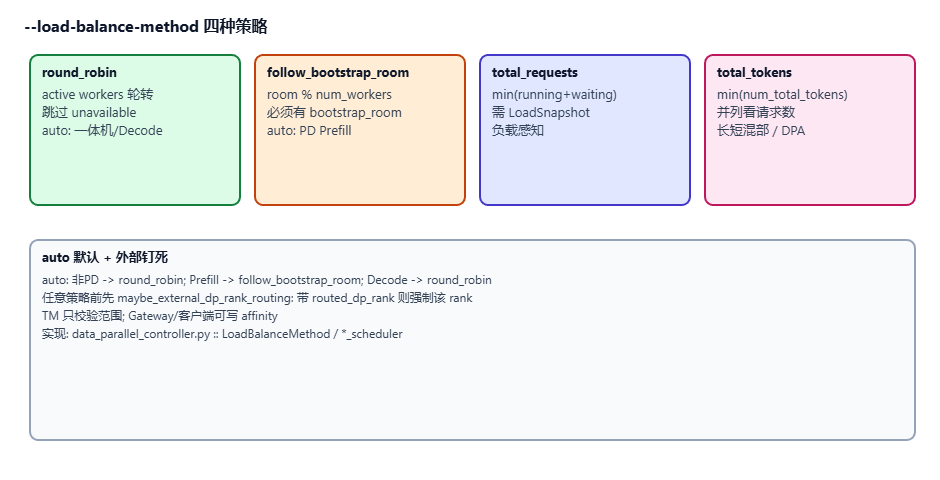
| 策略 | 怎么选 | auto 何时用到 |
|---|---|---|
round_robin | 在 _active_workers 上轮转,跳过 unavailable | 一体机;PD Decode |
follow_bootstrap_room | bootstrap_room % len(workers) | PD Prefill |
total_requests | argmin(running + waiting) | 需显式打开 |
total_tokens | argmin(tokens, requests);estimated = len(input_ids) | 需显式打开(长短混部 / DPA) |
6. 负载感知:LoadSnapshot 闭环
仅 total_requests / total_tokens 走这条路。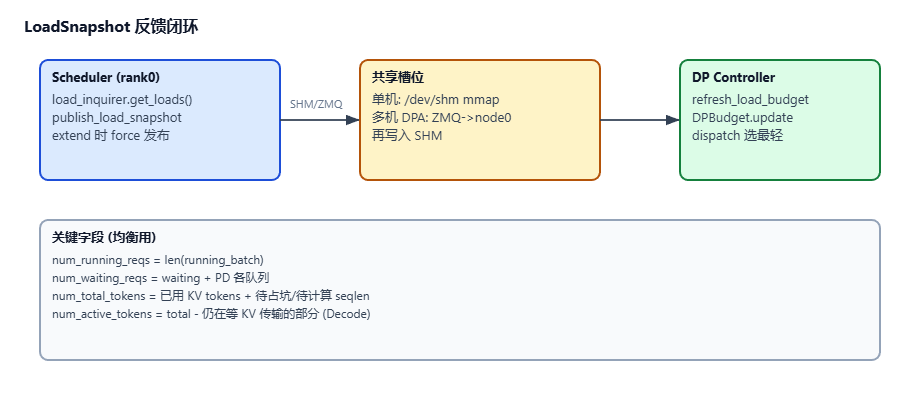
Scheduler (attn_tp_rank==0 等 rank0 条件)
  -> load_inquirer.get_loads()
  -> publish_load_snapshot()          # extend 时常 force
  -> Writer: 单机 SHM;多机 DPA 则 ZMQ -> node0 -> SHM
       |
       v
DataParallelController.refresh_load_budget()
  -> DPBudget.update_budget(loads)
  -> dispatch() 选最轻 rank
均衡用到的字段
| 字段 | 来源(load_inquirer.get_loads) |
|---|---|
num_running_reqs | len(running_batch.reqs) |
num_waiting_reqs | waiting + PD bootstrap/prealloc/transfer/retracted 等 |
num_total_tokens | 已用 KV tokens + 待占坑/待计算的 seqlen |
num_active_tokens | total - 仍在等 KV 传输的部分(Decode) |
| PD 时 waiting 统计会并入 Prefill bootstrap / Decode prealloc·transfer 等队列,避免「队列里已有大量未进 running 的请求」却被当成空闲。 |
观测接口:引擎提供 /v1/loads(具体挂载以当前版本 HTTP 路由为准),可读各 DP 的快照,便于对照 Controller 是否「看见」倾斜。
SHM / RR / 谁读负载(名词与边界)
| 名词 | 含义 |
|---|---|
| SHM | Shared Memory(共享内存)。node0 上的 mmap「公告板」:各 DP Scheduler 把本 rank 的 LoadSnapshot 写进去,需要负载的进程再读出来。 |
| RR | Round Robin(轮询),即 --load-balance-method round_robin(auto 在一体机 / PD Decode 下默认)。只靠计数器轮转选 rank,不看各 DP 忙不忙。 |
| 负载写入路径: |
Scheduler DP0/1/...  --写-->  SHM 槽位(公告板)
单机: 直接写 SHM
多机 DPA: 非 node0 先 ZMQ 推到 node0,再写入本地 SHM
谁消费这块公告板(load_snapshot.zmq_reader_owner:ZMQ PULL 只能有一个 owner,不能乱抢):
| 场景 | 谁关心负载 | 行为 |
|---|---|---|
负载感知(total_requests / total_tokens) | DataParallelController | 每次(节流后)dispatch 前读 SHM,用来选最轻的 DP |
纯 RR(以及 follow_bootstrap_room) | Controller 不需要负载 | Controller 不读;若有人调 /v1/loads 看负载,由 TokenizerManager(多 tokenizer 时是 MultiTokenizerRouter)拥有 ZMQ PULL / 读 SHM |
| 一句话:SHM 是负载公告板;RR 不看公告板选 DP;负载感知时 Controller 看公告板选 DP;ZMQ PULL 的主人随策略切换。 |
7. 突发:投机计数 + 20ms 节流
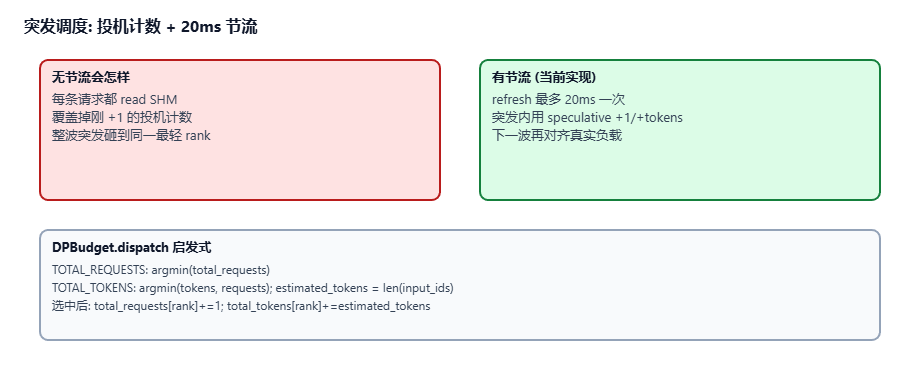
问题:若每条请求都 read_all() 覆盖预算,会把刚 +1 的投机计数清掉,整波突发砸到「SHM 里仍显示最轻」的同一个 rank。
做法:
DPBudget.dispatch选中后立刻:total_requests[rank]+=1,total_tokens[rank]+=estimated_tokens。refresh_load_budget最多 20ms 一次,突发内靠投机计数摊开。- 下一窗口再对齐 Scheduler 真实负载。
total_tokens的estimated_tokens = len(req.input_ids)(dispatch 时刻的启发式,不是最终 KV 占用)。
8. PD 与 follow_bootstrap_room
即使你不部署 PD,读懂本节也有助于理解:auto 为何在 Prefill 上不是 RR。
8.1 PD 最小背景
Prefill/Decode 分离时:
- Prefill 集群:算 prompt、写 KV,再把 KV 传给 Decode;
- Decode 集群:先预留本机 KV,收远端页,再连续生成;
- 请求靠
bootstrap_host/bootstrap_port/bootstrap_room会合;bootstrap_room通常由 Router 注入,每请求唯一。
两套服务各自可以有自己的dp_size与 Controller。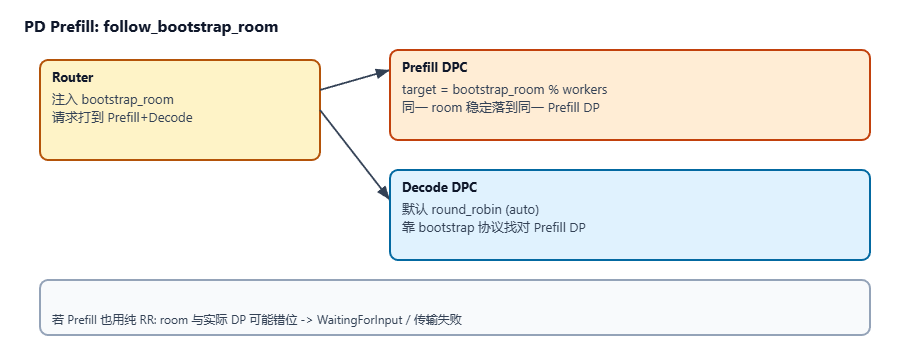
8.2 Prefill 为何用 room 取模
Prefill 侧:
target_rank = bootstrap_room % len(workers)
保证 同一 bootstrap_room 稳定落到同一 Prefill DP,Decode / Bootstrap 才能按 room 找到对的人。
Decode 侧 auto 仍是 RR:Decode 靠 bootstrap 协议查 Prefill 拓扑与 room,不要求「和 Prefill 用同一取模公式选 Decode DP」。
若 Prefill 误改成纯 RR:room 与实际 Prefill DP 错位,典型现象包括 Decode 长时间停在等待会合/传输(日志里常出现 WaitingForInput、Abort、transfer_duration=0 等),应先核对 Prefill 的 load_balance_method 与 room 是否一致。
9. 与 DPA / 本地调度的边界
| 话题 | 说明 |
|---|---|
| DPA | 请求仍钉在某一个 attn_dp_rank;各 DP 可处于不同 forward 相位 |
| 本地 batching | get_next_batch_to_run / chunked / retract 只在本 rank;不跨 DP 迁移 |
| 传统 DP vs DPA | 启动路径不同,Controller 选 rank 逻辑相同 |
| 弹性 EP | max_ep_size 预留 slots;ActiveRanksOutput / add_elastic_workers 更新 active 集合,RR 只在 active 上转 |
| DPA 相位不齐(一 rank prefill、另一 rank decode)会伤尾延迟,这是 PD 拆分的动机之一,不是 Controller 能单独解决的。 |
10. 源码地图
| 路径 | 职责 |
|---|---|
managers/data_parallel_controller.py | LoadBalanceMethod、DPBudget、四种 *_scheduler、event_loop |
managers/load_snapshot.py | LoadSnapshot、SHM/ZMQ、reader owner |
managers/scheduler_components/load_inquirer.py | get_loads() 字段计算 |
managers/scheduler.py | publish_load_snapshot |
server_args._handle_load_balance_method | auto 默认 |
Gateway policies/*(若使用 sgl-model-gateway) | L2:cache_aware / prefix_hash / power_of_two… |
| 建议读代码顺序: |
LoadBalanceMethod+dispatching_with_trace+ 四个 scheduler(对第 4 节)DPBudget+refresh_load_budget(含 20ms 注释)load_inquirer.get_loadsload_snapshot传输与 owner- (可选)Gateway policy
11. 实践对照与排查清单
| 场景 | 建议 |
|---|---|
| 普通多 DP / DPA 一体机 | auto -> RR;长短差大可试 total_tokens |
| PD Prefill | 保持 follow_bootstrap_room(或显式指定) |
| 前缀亲和 / 多机副本 | 网关策略 + 必要时写 routed_dp_rank |
| 专家不均 | --enable-eplb(与本文正交) |
| 排查「全打到一个 DP」 | 是否负载感知却突发刷新过频/无节流;看 /v1/loads;是否几乎都带了同一个 routed_dp_rank |
| 排查 PD 会合失败 | Prefill 是否误改 RR;bootstrap_room 是否缺失/不一致 |
| 快速自检: |
dp_size是否真的> 1?(否则根本没有 Controller)- 实际生效的
load_balance_method是什么?(看启动日志 /server_info) - 请求是否带了
routed_dp_rank/bootstrap_room? /v1/loads各 rank 的num_total_tokens/ waiting 是否一边倒?
12. 读完应能回答
- TM 和 Controller 谁负责选
dp_rank?外部routed_dp_rank优先级如何? auto在 Prefill / Decode / 非 PD 下分别是什么?- RR 的候选集是
workers还是_active_workers?room 取模用的是哪个长度? num_total_tokens包含哪些部分?为何 PD Decode 要扣「仍在等 KV 传输」的 tokens?- 为什么需要 20ms 节流和投机
+1?SHM 在其中扮演什么角色? - Prefill 为何不能随意改成
round_robin?
附录:术语表
| 术语 | 含义 |
|---|---|
DP / dp_rank | Data Parallel 维度;每个请求钉在某一个 rank |
| DPA | DP Attention;Attention/KV 按请求分片的并行方式 |
| TP / EP / PP | 张量 / 专家 / 流水线并行(切模型权重或层),与「选哪个 DP 接请求」不同层 |
| Controller | DataParallelController,引擎内选 dp_rank 的进程 |
| TM | TokenizerManager |
| RR | Round Robin,round_robin 策略 |
| SHM | Shared Memory,负载快照公告板 |
| LoadSnapshot | 单 DP 的负载结构化快照 |
| PD | Prefill/Decode 分离部署 |
bootstrap_room | PD 会合用的每请求房间号 |
routed_dp_rank | 外部指定的目标 DP(最高优先) |
| EPLB | Expert Parallelism Load Balancer,专家放置,不是请求 DP 路由 |
| ZMQ | 进程间消息通道(TM↔Controller↔Scheduler;多机负载也可用) |
阅读导航



