
SGLang 源码分析:Chat Completions 请求全链路
sglang源码分析:一次Chat Completions 经历了什么
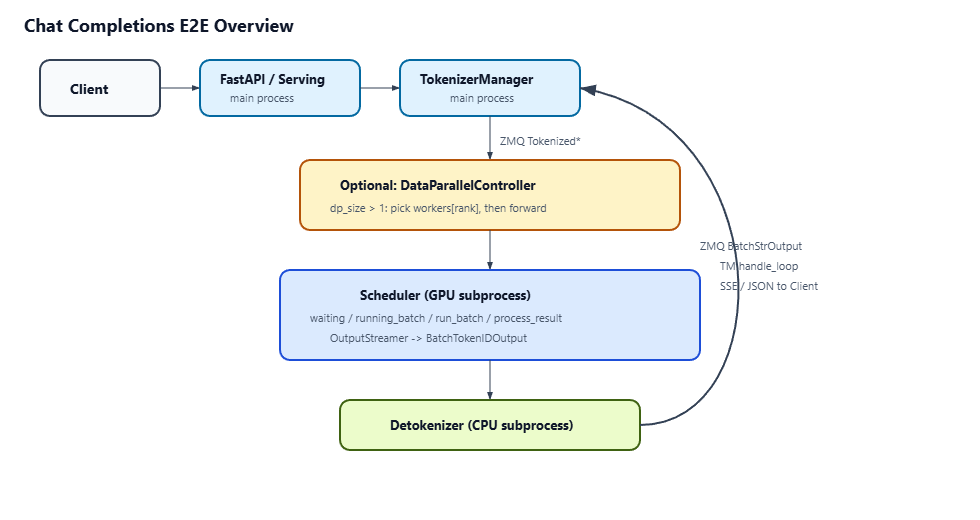
本文目标:把一次 POST /v1/chat/completions 从 HTTP 入站到 SSE/JSON 出站的完整链路梳理清楚——跨进程拓扑、类型变换、TM 异步收发、可选 DP 路由、Scheduler 热路径、run_batch、Detokenizer 回程与流式差异。
0. 总览:一次请求经过哪些进程
一次 chat completions:
- 主进程 Serving:OpenAI 协议 →
GenerateReqInput - 主进程 TokenizerManager:tokenize → ZMQ 发出;后台
handle_loop收结果并按rid唤醒 - (可选)DP Controller 子进程:只选
workers[rank]并转发 - Scheduler GPU 子进程:入队 → 组 batch →
run_batch→ 结果 stream - Detokenizer CPU 子进程:token ids → 文本 → 回 TM
- Serving:组装 SSE 或 JSON
| 组件 | 进程 | 源码入口(GitHub) |
|---|---|---|
| HTTP 路由 | 主 | openai_v1_chat_completions |
| Serving | 主 | OpenAIServingBase.handle_request / OpenAIServingChat |
| TM | 主 | TokenizerManager |
| DP(可选) | 子 | DataParallelController |
| Scheduler | GPU 子 | run_scheduler_process / Scheduler |
| Detokenizer | CPU 子 | run_detokenizer_process |
IPC 端口名定义:PortArgs(scheduler_input_ipc_name / detokenizer_ipc_name / tokenizer_ipc_name)。 |
1. 类型沿途变换(务必背下)
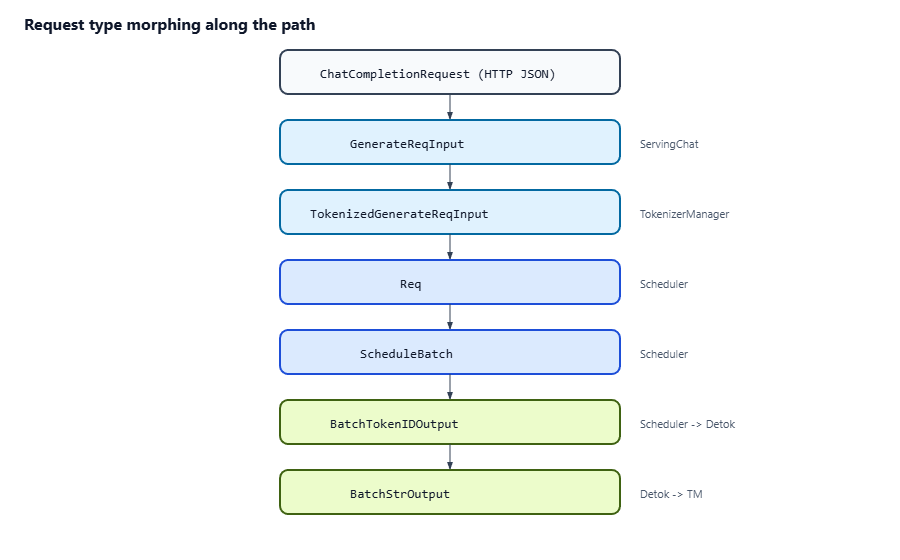
| # | 类型 | GitHub 定义 | 谁产出 |
|---|---|---|---|
| 1 | ChatCompletionRequest | protocol.py#L654 | HTTP JSON |
| 2 | GenerateReqInput | io_struct.py#L155 | ServingChat |
| 3 | TokenizedGenerateReqInput | io_struct.py#L780 | TM tokenize |
| 4 | Req | schedule_batch.py#L666 | Scheduler |
| 5 | ScheduleBatch | schedule_batch.py#L1674 | Scheduler |
| 6 | GenerationBatchResult | managers/utils.py | run_batch |
| 7 | BatchTokenIDOutput | io_struct.py#L1199 | OutputStreamer |
| 8 | BatchStrOutput | io_struct.py#L1281 | Detokenizer |
| 9 | SSE / ChatCompletionResponse | protocol.py#L993 | ServingChat |
引擎主键是 rid。 |
DP 字段:routed_dp_rank(推荐),外部router可直接指定dp,可通过header或者注入body的方式指定。
2. 阶段 A:HTTP → ServingChat(主进程)
2.1 FastAPI 路由
async def openai_v1_chat_completions(request, raw_request):
    return await raw_request.app.state.openai_serving_chat.handle_request(
        request, raw_request
    )
openai_serving_chat在lifespan挂到app.state。validate_json_request做基础 JSON 校验(同文件 dependency)。raw_request:断连检测、header 覆盖、自定义 metrics labels。
2.2 handle_request 通用骨架
OpenAIServingBase.handle_request:
received_time = monotonic_time()
→ _validate_request
→ _convert_to_internal_request(request, raw_request)   # Chat 子类实现
→ if stream: _handle_streaming_request
  else:     _handle_non_streaming_request
2.3 Chat 特化:转成 GenerateReqInput
OpenAIServingChat._convert_to_internal_request 大致步骤:
- 处理 messages / tools / multimodal content
- 套用 chat template →
text或input_ids - 构造
sampling_params(temperature、max_tokens、stop…) extract_routed_dp_rank_from_header(header 优先于 body)- 组装
GenerateReqInput(...):rid、stream、lora_path、bootstrap_*、disagg_prefill_dp_rank等
2.4 流式 / 非流式分支
| 模式 | 函数 | GitHub |
|---|---|---|
| stream | _handle_streaming_request | #L994 |
| 非 stream | _handle_non_streaming_request | #L1261 |
流式要点(_handle_streaming_request): |
- 先
await generator.__anext__():在 HTTP 200 之前做校验(如超长 context),失败可返回 400,而不是把错误塞进 SSE。 StreamingResponse(..., media_type="text/event-stream")background=create_abort_task:客户端断开时可 abort 引擎侧请求
内部真正拉引擎:- 流式:
generate_requestasync for content in ... - 非流式:#L1269
await ...generate_request(...).__anext__()一类用法
3. 阶段 B:TokenizerManager——发、等、后台收
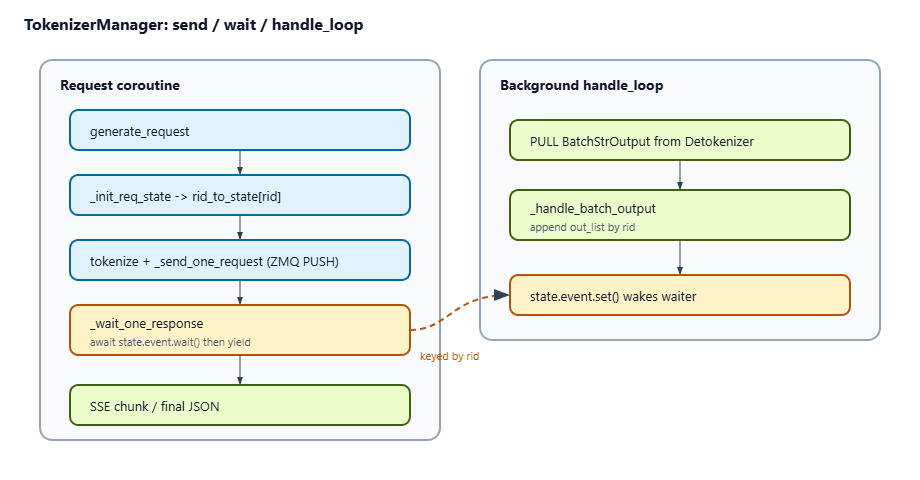
核心文件:tokenizer_manager.py
3.1 ZMQ 两腿
| Socket | 类型 | 对端 |
|---|---|---|
send_to_scheduler | PUSH → scheduler_input_ipc_name | Scheduler 或 DP Controller |
recv_from_detokenizer | PULL ← tokenizer_ipc_name | Detokenizer |
dp_size==1:直连 Scheduler。 |
dp_size>1:同一地址绑的是 DP Controller 的 PULL(见阶段 C)。
3.2 generate_request(请求协程)
1. normalize_batch_and_arguments / priority
2. 若有 routed_dp_rank:校验 ∈ [0, dp_size);dp_size<=1 且为 0 则忽略
3. _init_req_state → rid_to_state[rid] = ReqState(event, out_list, ...)
4. pause / LoRA 校验
5. is_single:
     tokenized = await _tokenize_one_request(obj)     # #L793
     _send_one_request(tokenized)                    # #L1331
     async for response in _wait_one_response(...):  # #L1446
         yield response
6. 异常:_discard_pending_req_states 防泄漏
_init_req_state(约 #L2868+):为每个 rid 建 ReqState,含 asyncio.Event、out_list、time_stats;禁止重复 rid。
3.3 _send_one_request:发出即返回
time_stats.set_api_server_dispatch_time()
wrap_shm_features / wrap_pickle_fields
_dispatch_to_scheduler → sock_send(send_to_scheduler, tokenized_obj)
不在这里等 GPU。 tokenize 时会把 routed_dp_rank / disagg_prefill_dp_rank 拷进 TokenizedGenerateReqInput。
3.4 _wait_one_response:挂起等结果
loop:
  await state.event.wait()   # 被 handle_loop 唤醒
  取出 out_list;clear event
  if finished: yield 最终;break
  if stream: yield 增量 chunk
  else: 继续等(非流式一般只在 finish 时 yield)
  可选:客户端 disconnect → abort_request
3.5 handle_loop:后台收 Detokenizer
handle_loop → _handle_batch_output:
while True:
  recv_obj = await async_sock_recv(recv_from_detokenizer)
  if BatchStrOutput / BatchTokenIDOutput / BatchEmbeddingOutput:
      for each rid in batch:
          拼 meta_info(finish_reason, prompt/completion/cached tokens, ...)
          追加文本到 state / out_list
          if finished: del rid_to_state[rid]
          state.event.set()   # 唤醒 waiter
  else:
      _result_dispatcher  # AbortReq 等
双协程模型:请求协程负责发+等;handle_loop 负责收+按 rid 投递。中间不是同步 RPC。
4. 阶段 C:可选 DP 路由(dp_size > 1)
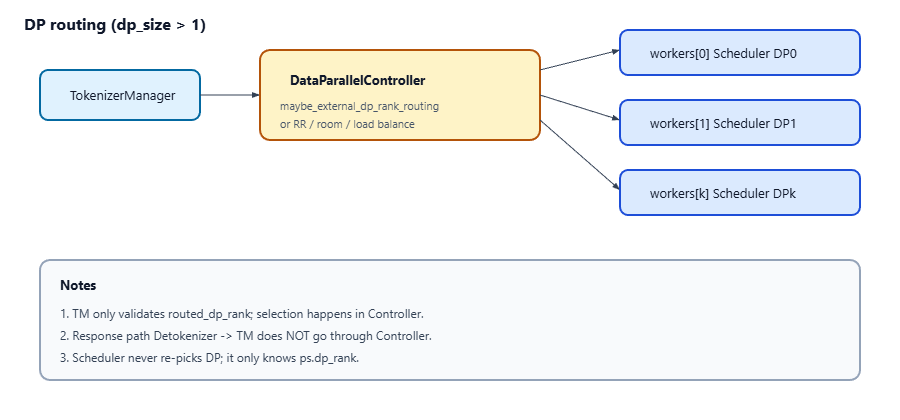
文件:data_parallel_controller.py
4.1 进程位置
Engine 在 dp_size>1 时起的是 DP Controller 子进程(而非直接起多个 Scheduler 给 TM)。Controller 再拉起各 DP 的 Scheduler,并用 workers[rank] PUSH 到各 DP 的 scheduler_input_ipc_name。
4.2 收包与分发
| 符号 | 链接 |
|---|---|
event_loop | #L654 |
dispatching_with_trace | #L239 |
maybe_external_dp_rank_routing | #L605 |
round_robin_scheduler | #L612 |
follow_bootstrap_room_scheduler | #L628 |
recv TokenizedGenerateReqInput
→ dispatching_with_trace
    → self.dispatching(req)   # 由 load_balance_method 选定
        → 先 maybe_external_dp_rank_routing:
             if routed_dp_rank is not None:
                 sock_send(workers[rank], req); return True
        → 否则 RR / bootstrap_room % n / DPBudget
| 策略 | 行为 |
|---|---|
round_robin | 轮转,跳过 status[i]==False |
follow_bootstrap_room | bootstrap_room % dp_size(PD 常用) |
total_requests / total_tokens | 负载;refresh_load_budget 有 20ms 节流 |
| Controller 只转发,不 forward、不参与回程。 |
真正处理 = 目标 DP 上的 run_scheduler_process。
5. 阶段 D:Scheduler——入队与组 batch
5.1 进程入口与循环选型
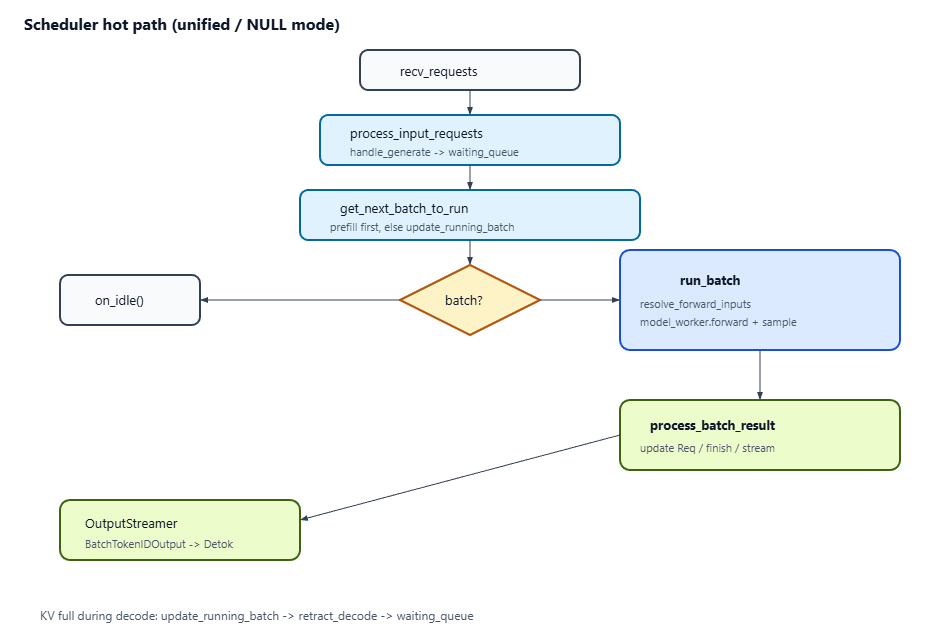
run_scheduler_process:load_plugins→Scheduler(...)→pipe_writer.send(get_init_info())→run_event_loopdispatch_event_loop:按 PD / PP / overlap 选循环- 常见:
event_loop_normal或event_loop_overlapevent_loop_normal骨架:
while True:
  recv_reqs = request_receiver.recv_requests()
  process_input_requests(recv_reqs)
  batch = get_next_batch_to_run()
  if batch:
      result = run_batch(batch)
      process_batch_result(batch, result)
  else:
      on_idle()
  last_batch = batch
5.2 收包 → Req → 队列
| 步骤 | 链接 |
|---|---|
process_input_requests | #L1662 |
handle_generate_request | #L2032 |
_add_request_to_queue | #L2298 |
TokenizedGenerateReqInput
→ Req(rid, input_ids, sampling_params, bootstrap_*, routed_dp_rank, ...)
→ _add_request_to_queue:
     NULL    → waiting_queue
     PREFILL → disagg_prefill_bootstrap_queue
     DECODE  → disagg_decode_prealloc_queue
进 waiting_queue,尚不占 decode running 槽;radix 匹配在后续 PrefillAdder / init_next_round_input。
5.3 get_next_batch_to_run:Prefill 优先
- Prefill 准入:
SchedulePolicy+PrefillAdder(token/KV/max_running_requests预算)。 - Decode:
update_running_batch。 - KV 不够:
retract_decode—— 踢部分 running(优先踢已生成长的),release_kv_cache(is_insert=False),回 waiting(is_retracted=True)。
| 结构 | 含义 |
|-|-|
|waiting_queue| 等 prefill |
|running_batch| 正在 decode |
|chunked_req| 未完成的大 prefill 切片 |
|cur_batch/last_batch| 本轮 / 上轮上 GPU |
6. 阶段 E:run_batch——真正上 GPU
职责:ScheduleBatch → forward(+sample) → GenerationBatchResult。不组 batch、不 HTTP。
6.1 分支树
run_batch
  ├─ PREBUILT → PD Decode 占位
  ├─ PD Prefill → maybe_send_cached_prefix_chunk
  └─ generation
        ├─ overlap:多 stream + FutureMap + 延迟 process/sample
        ├─ spec:draft_worker.forward_batch_generation
        └─ 普通同步:见下
6.2 普通同步路径
1. resolve_forward_inputs(batch, future_map)     # overlap_utils.py#L69
     Prefill: prefill_input_ids_cpu → GPU
     Decode:  FutureMap[req_pool_indices] → 上轮 token
2. model_worker.forward_batch_generation(batch)
     → TpModelWorker #L489
        ForwardBatch.init_new
        model_runner.forward      # 写 KV,出 logits(可 CUDA graph)
        model_runner.sample       # next_token_ids
3. _relay_forward_payload         # 存进 FutureMap,供下轮 Decode
4. return GenerationBatchResult
| 步骤 | GitHub |
|---|---|
resolve_forward_inputs | overlap_utils.py#L69 |
TpModelWorker.forward_batch_generation | tp_worker.py#L489 |
run_batch 同步分支 | scheduler.py ~3331+ |
model_worker:无 spec → tp_worker;有 spec → draft_worker(init 时赋值)。 |
6.3 Overlap vs 同步(event loop + run_batch)
event_loop_normal | event_loop_overlap | |
|---|---|---|
| process | run_batch 后立刻 process 本轮 | process 上一轮(result_queue) |
| GPU/CPU | 串行 | GPU 算 N ∥ CPU 处理 N-1 |
| sample | 当场 | grammar 时可 delay_sample_func + launch_batch_sample_if_needed |
| D2H | 跟 forward 节奏 | 常在 copy_stream |
同步:   |--GPU N--|CPU N|--GPU N+1--|CPU N+1|
Overlap:|--GPU N--|--GPU N+1--|--GPU N+2--|
              |CPU N|   |CPU N+1|
6.4 Spec
--speculative-algorithm 非空:draft_worker.forward_batch_generation(draft → verify → accept)。
7. 阶段 F:结果处理 → Detokenizer → TM
7.1 process_batch_result
DECODE → process_batch_result_decode
  append output_ids;grammar;stop / max_new_tokens
  finished → release_kv_cache + stream
  未完成 → 留在 running_batch
EXTEND → process_batch_result_prefill(PD 则 process_batch_result_disagg_prefill)
7.2 OutputStreamer
SchedulerOutputStreamer.stream_output
打包 BatchTokenIDOutput → ZMQ → Detokenizer。
7.3 Detokenizer
DetokenizerManager.event_loop:
recv from Scheduler
→ TypeBasedDispatcher
     BatchTokenIDOutput → handle_batch_token_id_out  # #L406
         decode token ids → text(增量)
         处理 stop trim 等
         return BatchStrOutput
→ sock_send(send_to_tokenizer, BatchStrOutput)
然后回到 TM handle_loop(阶段 3.5)→ 唤醒 _wait_one_response。
8. 阶段 G:Serving 组装 OpenAI 响应
| 流式 | 非流式 | |
|---|---|---|
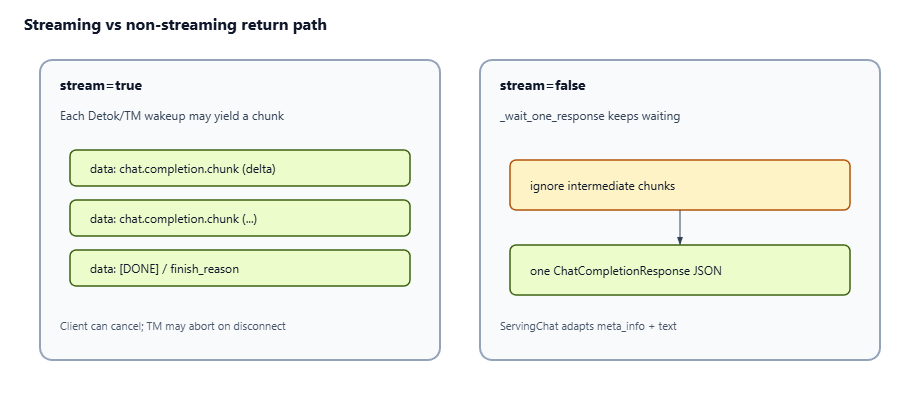
| Serving | _generate_chat_stream 把引擎 dict 编成 data: {...}\n\n | 等最终 dict → ChatCompletionResponse |
| TM | 每步可 yield | 常只在 finished yield |
| HTTP | text/event-stream | JSON |
| 结束 | finish_reason + [DONE] 一类 | 单次 response |
| Serving 层还会做:reasoning / tool_calls 增量解析、usage(prompt/completion/cached tokens)、logprobs 样式转换等。 |
9. 完整时序
Prefill 一次(或 chunk 多次)后,decode 循环直到 stop / max_new_tokens。
10. 变体一览
| 变体 | 差异要点 | 入口链接 |
|---|---|---|
| DP | TM→Controller→某 DP Scheduler | maybe_external_dp_rank_routing |
| PD Prefill | bootstrap→waiting→KV transfer→inflight | prefill.py |
| PD Decode | prealloc + PREBUILT→decode | decode.py |
| Overlap | result_queue 延迟一拍 | event_loop_overlap |
| Spec | draft_worker | speculative/ |
| 多 tokenizer | 并行 tokenize worker | tokenizer_worker_num |
11. GitHub 源码速查表
12. 自检清单
13. 建议跟读顺序(按 GitHub 点开)
- http_server L1615 → serving_base L73 → serving_chat L536
- TM generate_request L589 → _send L1331 → _wait L1446 → handle_loop L1847
- (可选)DP L605 / L654
- handle_generate L2032 → get_next_batch L2596 → run_batch L3189 → process_batch_result L3447
- Detokenizer L161 / L406
阅读导航



