
第十一章 并发补充、编译链接与操作系统
第十一章 并发补充、编译链接与操作系统
1. shared_ptr 是线程安全的吗?
问题分析
这道题考查能否用并发边界、编译链接与系统资源解释题目中的语义,而不是停留在定义记忆。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:多个
shared_ptr实例若共享同一控制块,可以在不同线程分别复制、销毁和赋值,引用计数不会因此损坏。 - 再讲机制:围绕“三个层次”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合并发边界、编译链接与系统资源说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯 C++ 后端二面
问题讲解
一、三个层次
多个 shared_ptr 实例若共享同一控制块,可以在不同线程分别复制、销毁和赋值,引用计数不会因此损坏。但同一个 shared_ptr 变量被一个线程写、另一个线程读写仍会数据竞争;被指向对象的成员也不会因为外面套了 shared_ptr 自动安全。
C++17 可用 atomic_load/atomic_store 针对 shared_ptr 的自由函数原子地发布句柄;C++20 提供 atomic<shared_ptr<T>> 特化。引用计数安全只保证生命周期管理,不保证业务状态一致。
二、完整可执行示例(C++17)
这里原子操作的是“共享句柄的发布”,读线程获得自己的 shared_ptr 副本后,对象至少存活到该副本析构。示例中的 const int 不需要额外同步;若对象可变,成员仍需自己的并发协议。
#include <iostream>
#include <memory>
#include <thread>

int main() {
    std::shared_ptr<const int> published;
    std::atomic_store(&published, std::make_shared<const int>(42));

    std::thread reader([&published] {
        const auto local = std::atomic_load(&published);
        if (local) std::cout << *local << '\n';
    });

    reader.join();
}
三、常见错误
- 多线程修改同一个 shared_ptr 变量而不加锁。
- 认为
use_count()==1后可无锁修改对象。 - 用 shared_ptr 替代对象内部 mutex。
- 将引用计数原子性等同于整个操作 lock-free。
回答自检
- 控制块、句柄变量、业务对象的三层安全边界。
- 为什么不同副本可并发销毁。
- 句柄发布为何仍需原子或锁。
- 生命周期安全不等于数据线程安全。
面试官可能追问的问题
- 不同副本指向同一对象可同时 reset 吗? 可以,各自修改自己的句柄并安全更新共享控制块。
- weak_ptr::lock 并发安全吗? 对同一控制块获取临时强引用具备规定的原子语义。
- 引用计数一定无锁吗? 不保证。
2. jthread 和 stop_token(C++20)解决了什么问题?
问题分析
这道题考查能否用并发边界、编译链接与系统资源解释题目中的语义,而不是停留在定义记忆。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
std::jthread是 C++20 的线程 RAII 类型,析构时若仍 joinable,会请求停止并 join,减少遗漏 join 导致 terminate 的风险。 - 再讲机制:围绕“边界”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合并发边界、编译链接与系统资源说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯基础架构二面
问题讲解
一、解决两个常见错误
std::jthread 是 C++20 的线程 RAII 类型,析构时若仍 joinable,会请求停止并 join,减少遗漏 join 导致 terminate 的风险。stop_source 发出停止请求,stop_token 让任务查询请求或注册回调;它是协作取消,不会强制杀死线程。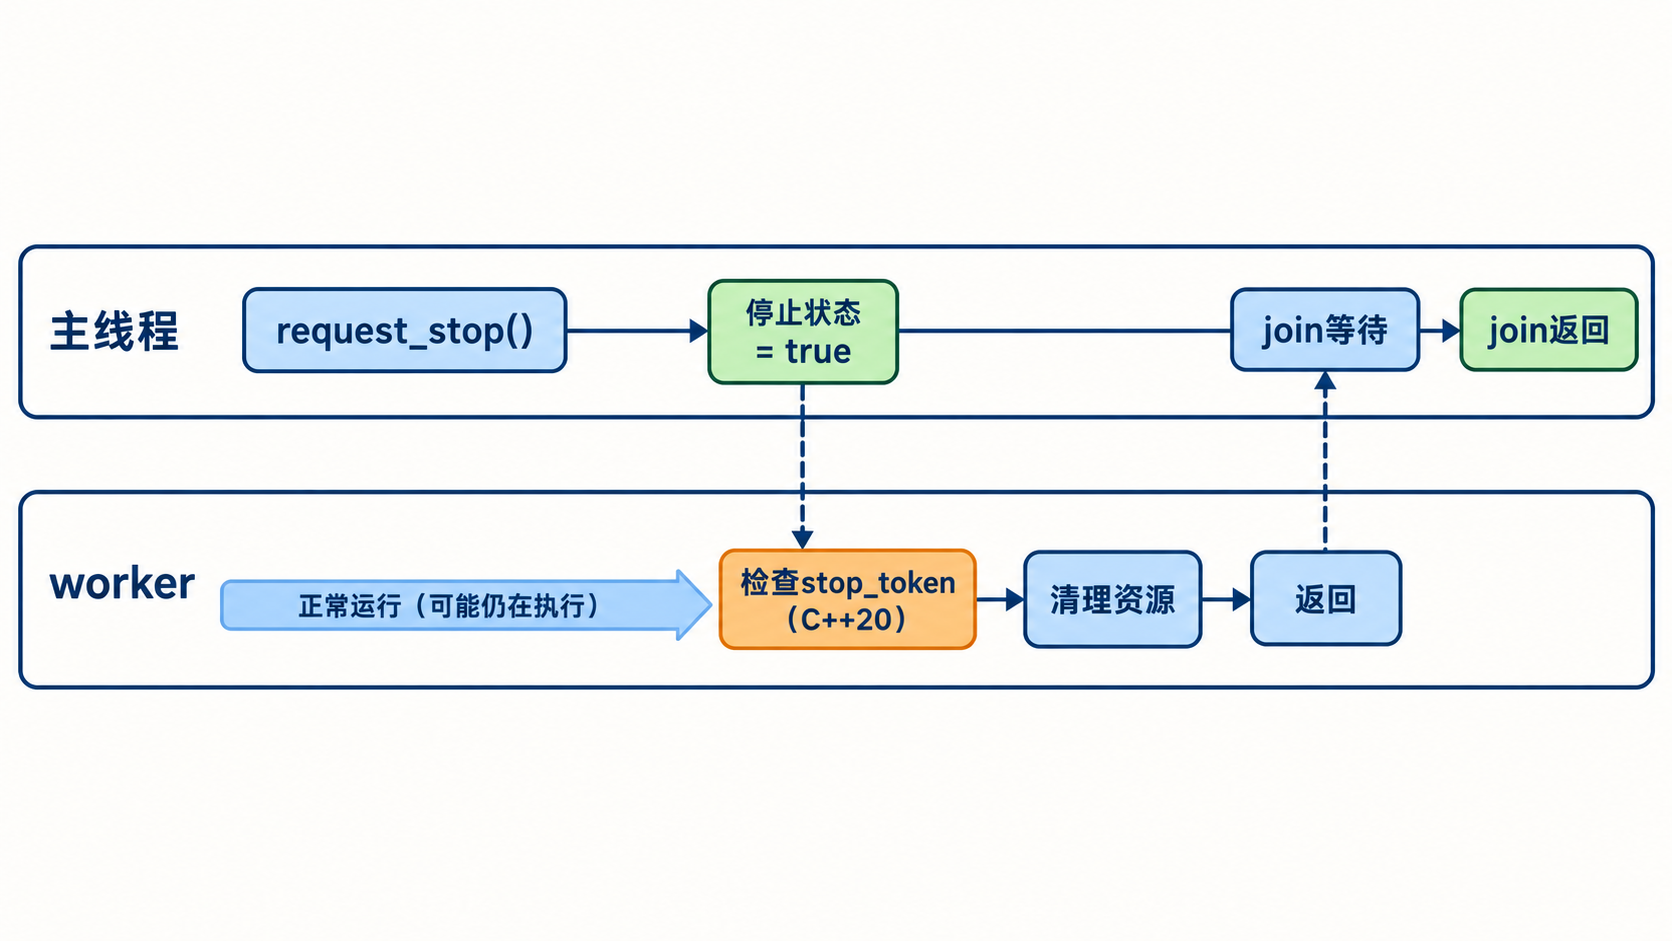
二、边界
任务若永久阻塞在不支持取消的系统调用中,检查 token 也无法及时退出;需要可中断等待、超时或关闭句柄。停止只是请求,任务仍负责保持不变式、释放资源并决定取消点。C++17 可自行实现原子停止标志加 thread guard,但语义要完整。
三、常见错误
- 认为 request_stop 会强制终止线程。
- 工作循环从不检查 token。
- 析构 join 放在持有工作线程所需锁的作用域内,造成死锁。
- 在 C++17 代码中直接使用 jthread 而不标注标准版本。
回答自检
- jthread 的析构行为。
- stop_source、token 和 callback 的角色。
- 协作取消为什么需要取消点。
- 阻塞操作和锁顺序对关闭的影响。
面试官可能追问的问题
- jthread 能否 detach? 可以,但这样失去析构 join 的主要收益。
- 停止请求能撤回吗? 一旦请求,关联状态保持停止。
- 如何唤醒条件变量等待? 使用支持 stop_token 的 C++20 等待设施或在请求时同步通知。
3. 头文件、翻译单元、包含保护和 ODR 有什么关系?
问题分析
这道题不只是让你罗列名词,而是考查能否从并发边界、编译链接与系统资源做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:传统
#include是文本包含。 - 再讲机制:围绕“编译模型 → 头文件规则”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合并发边界、编译链接与系统资源说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:百度 C++ 后端一面
问题讲解
一、编译模型
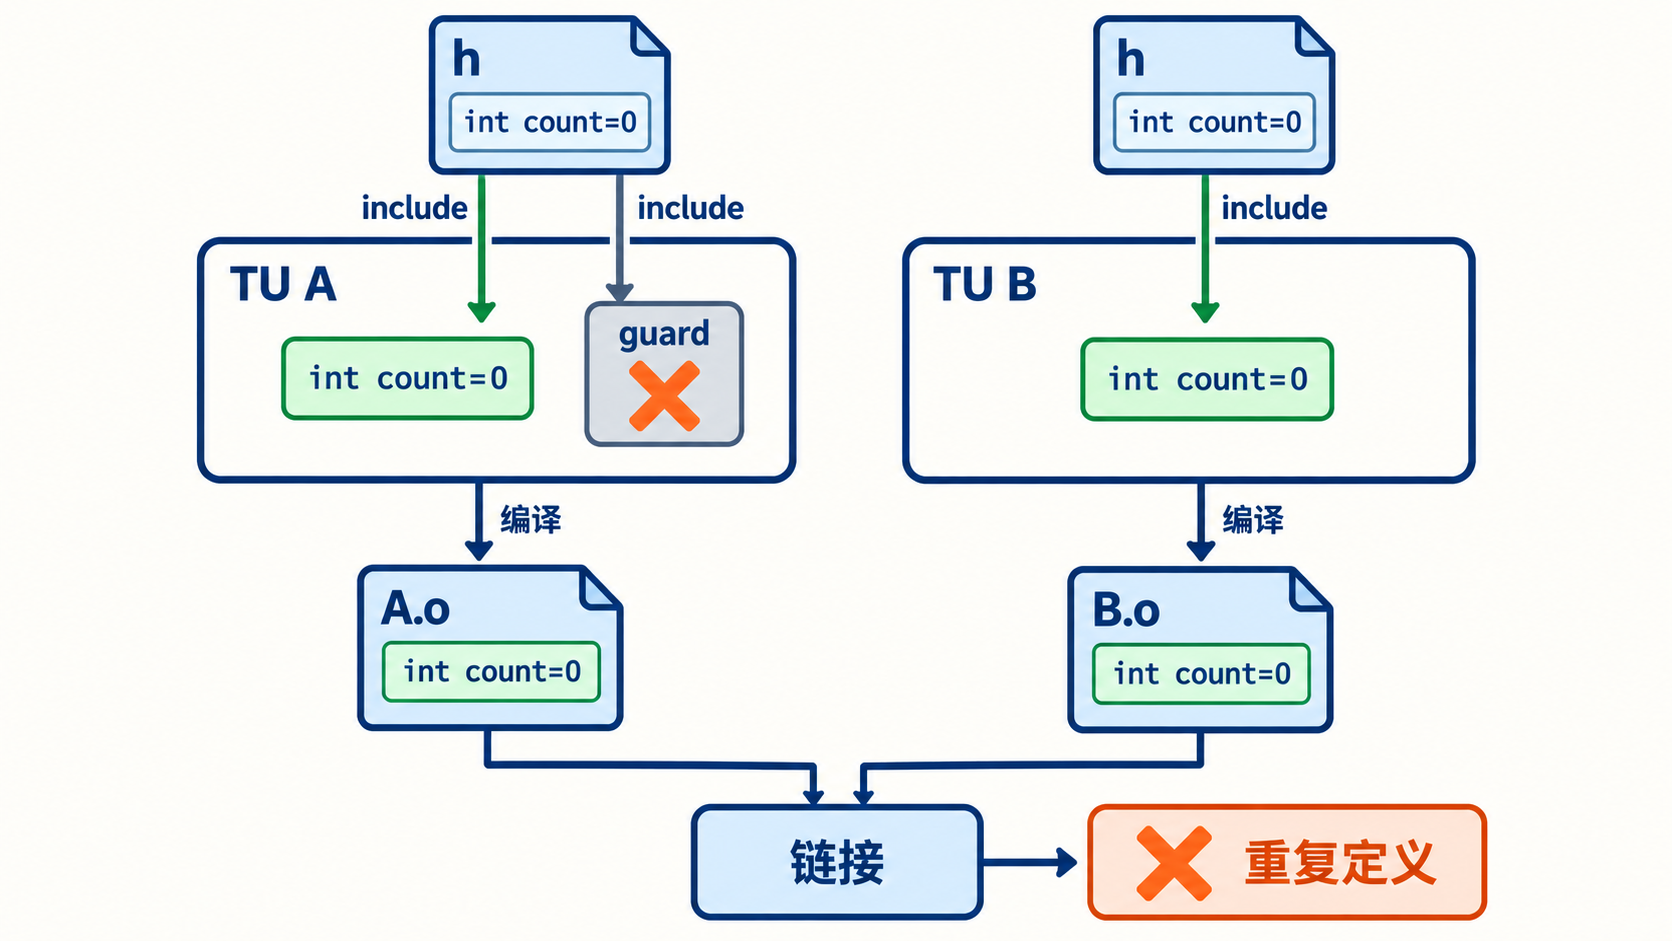
传统 #include 是文本包含。一个源文件经过预处理形成翻译单元,独立编译。包含保护或 #pragma once 防止同一头文件在一个翻译单元重复展开,但不等于解决整个程序的多重定义。ODR 要求某些实体在程序中只能有一个定义,并允许 inline 函数、模板等在多个翻译单元有等价定义。
二、头文件规则
头文件可放声明、类定义、模板定义和 inline/constexpr 实体;普通非 inline 函数或变量定义放头文件会在多个翻译单元产生重定义。C++17 inline 变量允许头文件定义共享实体。宏配置若让不同翻译单元看到不同类定义,会形成隐蔽 ODR 违规。
三、常见错误
- 认为 include guard 让头文件全程序只处理一次。
- 在头文件定义普通全局变量。
- 不同编译宏改变类布局后链接到一起。
- 把声明重复与定义重复混为一谈。
回答自检
- 文本包含如何形成翻译单元。
- 包含保护的作用边界。
- 声明、定义与 ODR 的关系。
- inline 在链接模型中的意义。
面试官可能追问的问题
#pragma once是标准吗? 广泛支持但不是 C++ 标准指令。- 类定义为何可出现在多个翻译单元? ODR 允许满足条件的等价类定义。
- inline 只表示建议内联吗? 更重要的是允许跨翻译单元等价定义。
4. 编译错误、链接错误和运行时错误如何区分?
问题分析
这道题考查能否把并发边界、编译链接与系统资源转化为可执行的判断步骤,而不是只报出 API 名称或最终结论。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:编译错误发生在单个翻译单元分析/生成阶段,如语法错误、类型不匹配、模板实例化失败。
- 再讲机制:围绕“三阶段 → 定位方法”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合并发边界、编译链接与系统资源说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团后端一面
问题讲解
一、三阶段
编译错误发生在单个翻译单元分析/生成阶段,如语法错误、类型不匹配、模板实例化失败。链接错误发生在合并目标文件时,如未定义符号、重复定义、缺库或 ABI 名称不匹配。运行时错误发生在程序成功生成并执行后,如越界、死锁、协议失败。
二、定位方法
先读第一条有意义诊断和符号名。undefined symbol 要检查函数签名、定义是否参与目标、库架构和链接顺序;运行崩溃用调试器、ASan/UBSan/TSan 和最小复现。编译器通过不代表程序没有未定义行为。
三、常见错误
- 遇到 undefined symbol 只加 include。
- 模板长错误只看最后一行。
- 把运行时动态库找不到称为编译错误。
- 依赖“能编译”证明线程安全。
回答自检
- 三类错误的发生阶段。
- undefined symbol 的排查方向。
- 诊断工具各自覆盖的错误。
- 编译成功与行为正确的差距。
面试官可能追问的问题
- 声明了但未定义是什么错误? 若被 ODR-use,通常链接时报未定义符号。
- 动态库缺失何时出现? 可在装载阶段,属于运行/部署问题。
- 未定义行为一定崩溃吗? 不一定,可能静默产生任意结果。
5. C++ 名字改编和 extern "C" 分别解决什么问题?
问题分析
这道题考查能否用并发边界、编译链接与系统资源解释题目中的语义,而不是停留在定义记忆。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:C++ 支持函数重载、命名空间和类成员,链接器符号需编码函数名、参数等信息,常称名字改编。
- 再讲机制:围绕“名字改编”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合并发边界、编译链接与系统资源说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯基础架构一面
问题讲解
一、名字改编
C++ 支持函数重载、命名空间和类成员,链接器符号需编码函数名、参数等信息,常称名字改编。具体编码由编译器 ABI 决定。extern "C" 指定 C 语言链接,通常抑制 C++ 名字改编,使 C/C++ 能以约定符号互调。
extern "C" 不让函数体变成 C,也不保证类、异常、STL 类型可安全跨边界。通常导出简单 C 函数、固定宽度字段和不透明句柄,并在同一模块分配和释放。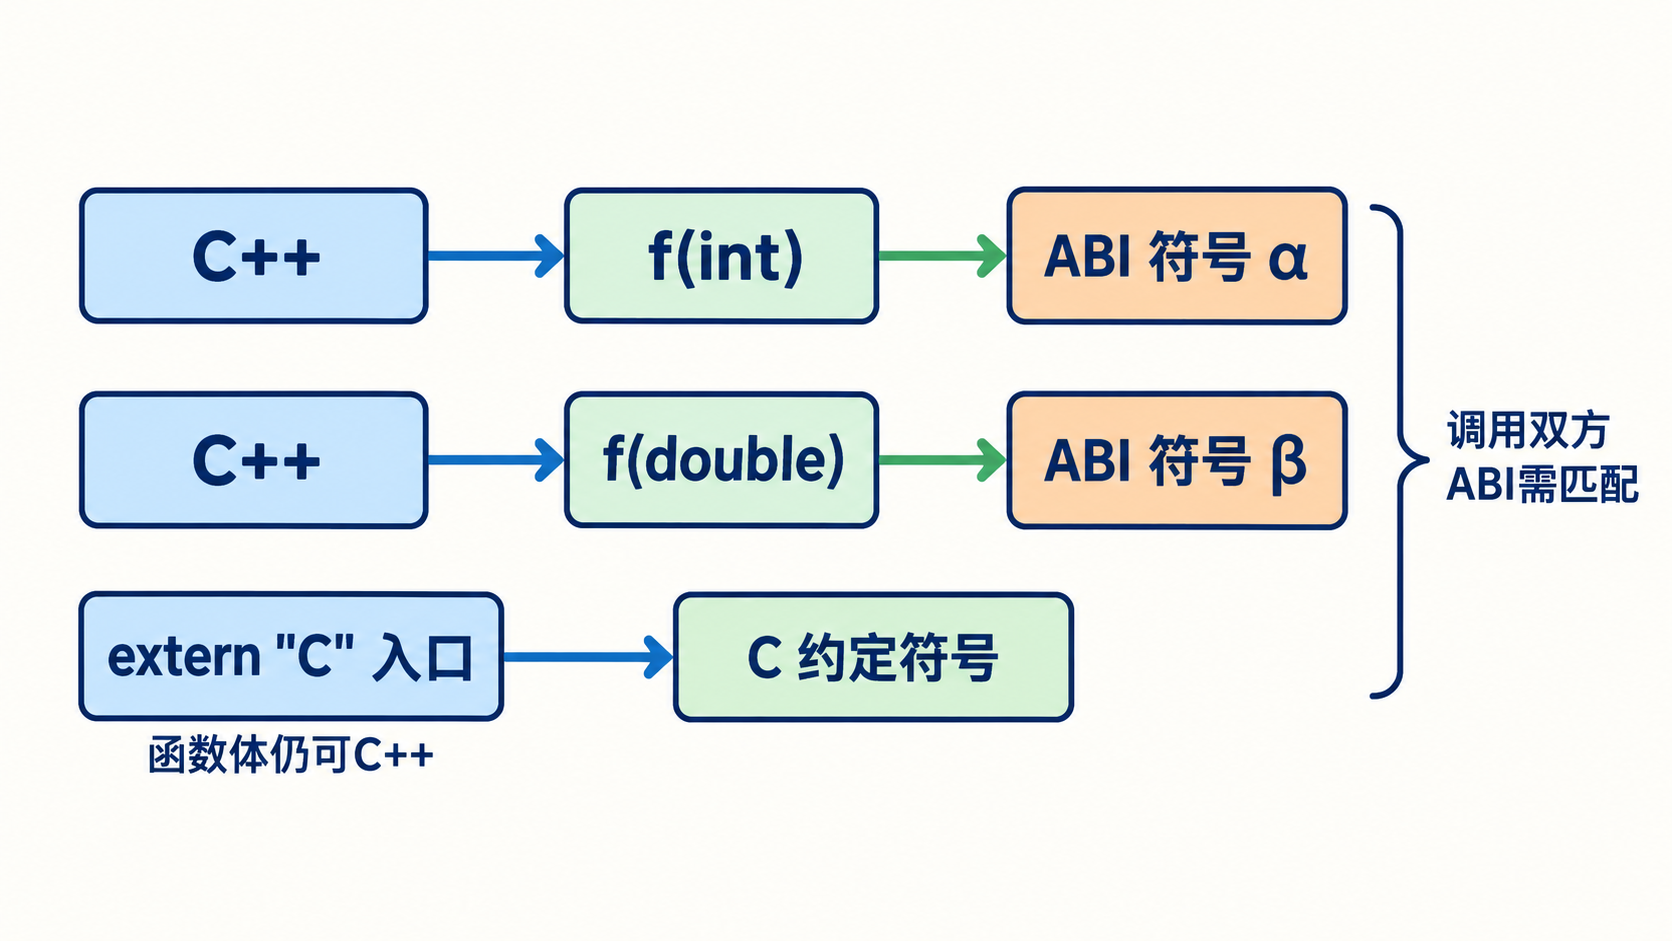
二、常见错误
- 认为 extern C 可以导出重载函数。
- 跨 C 边界传 C++ 异常或
std::string。 - 以为名字未改编就自动 ABI 兼容。
- 在 C 编译器可见头文件中不使用
#ifdef __cplusplus包装。
回答自检
- 名字改编为何存在。
- extern C 改变的是语言链接。
- 符号名兼容与完整 ABI 兼容的差别。
- 稳定 C 接口的设计边界。
面试官可能追问的问题
- 为何 C 链接通常不能重载? 外部符号缺少 C++ 重载编码。
- 如何写双语头文件? C++ 下开启
extern "C" {},C 下只看到普通声明。 - 成员函数能直接导出 C ABI 吗? 通常用自由函数加 opaque handle 包装。
6. 符号可见性和 C++ 名字改编为什么影响插件 ABI?
问题分析
这道题考查能否从可观察现象追溯到并发边界、编译链接与系统资源中的具体机制,并说明规则被破坏后的后果。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:动态装载器只能解析被导出的符号;
- 再讲机制:围绕“插件边界的风险 → 稳健设计”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合并发边界、编译链接与系统资源说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯基础架构三面
问题讲解
一、插件边界的风险
动态装载器只能解析被导出的符号;默认隐藏或错误导出宏会让入口不可见。C++ 名字改编随 ABI、编译器和签名变化,类布局、虚表、RTTI、异常、STL 实现、编译选项和分配器也可能不兼容,因此直接导出复杂 C++ 类会把内部实现暴露成 ABI 合同。
二、稳健设计
导出少量版本化 C 入口和函数表,使用不透明句柄;缓冲区明确长度、编码和所有权;谁分配谁释放;异常在模块内部捕获并转错误码。升级时增加结构大小、版本字段和能力协商,而不是随意改变既有函数布局。
三、常见错误
- 只加 extern C 就认为 ABI 永久稳定。
- 宿主 delete 插件 new 的对象。
- 跨模块抛异常或传 STL 容器。
- 发布后改变结构体字段顺序或对齐。
回答自检
- 符号可见性与名字解析。
- C++ ABI 不仅是函数名。
- opaque handle 和配对释放的价值。
- 插件版本演进策略。
面试官可能追问的问题
- 为什么要 destroy 函数? 保证对象由创建它的模块和分配器释放。
- 可见性如何控制? 编译器属性/导出宏配合默认隐藏策略。
- 函数表有何优势? 单一入口可协商版本并减少全局符号。
7. 进程和线程的资源边界有什么区别?
问题分析
这道题不只是让你罗列名词,而是考查能否从并发边界、编译链接与系统资源做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:进程通常拥有独立虚拟地址空间、进程级句柄表和安全边界;
- 再讲机制:围绕“共享与独有”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合并发边界、编译链接与系统资源说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团后台一面
问题讲解
一、共享与独有
进程通常拥有独立虚拟地址空间、进程级句柄表和安全边界;同一进程的线程共享代码、堆、全局数据和打开资源,但每个线程有独立调用栈、寄存器、程序计数器和线程局部存储。线程常是调度单位,进程是资源与隔离单位。
线程通信快但共享内存错误会破坏整个进程;进程隔离强但需要 IPC、序列化和上下文切换。实际成本取决于操作系统和工作负载,不能只背固定数字。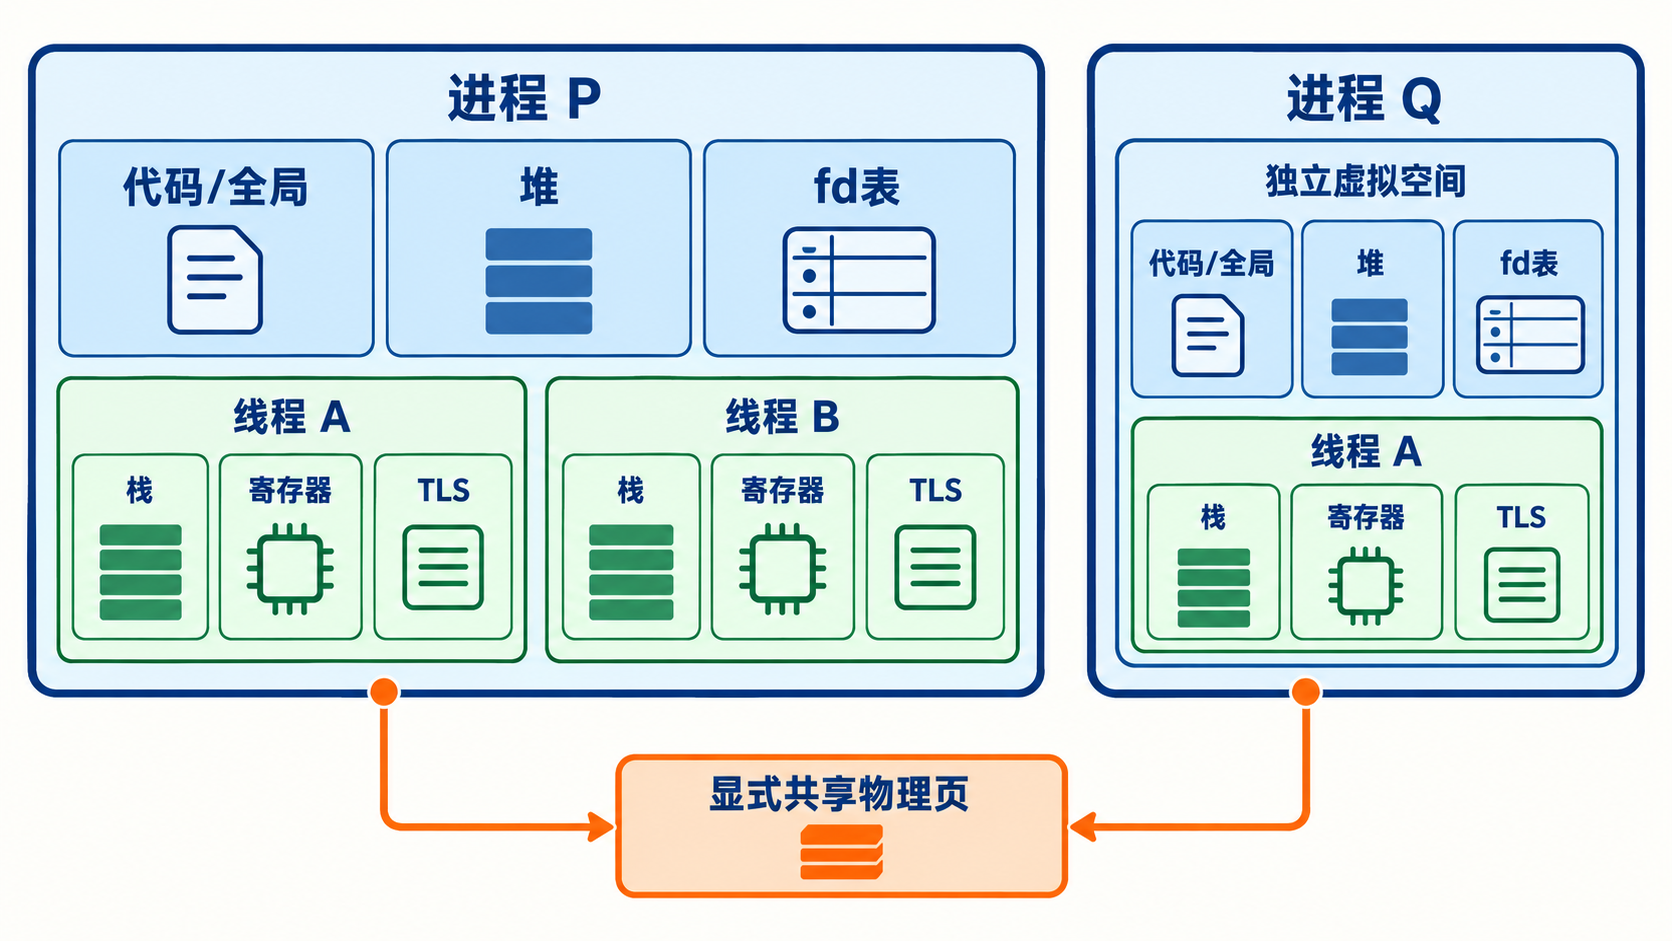
二、常见错误
- 认为线程有独立堆。
- 认为进程之间绝不共享物理页;共享库和共享映射可共享。
- 把线程崩溃视为只影响该线程。
- 用全局变量在进程间通信。
回答自检
- 进程与线程各自拥有的资源。
- 共享地址空间的效率与风险。
- IPC 与线程同步的区别。
- 隔离、故障域和开销的权衡。
面试官可能追问的问题
- 切换线程一定比进程便宜吗? 通常地址空间切换影响更多,但真实成本依缓存、TLB 和内核实现。
- 文件描述符在线程间共享吗? 同进程线程共享进程文件描述符表。
- TLS 是什么? 每个线程拥有独立实例的存储。
8. 虚拟内存、页表和 TLB 如何协作?
问题分析
这道题考查能否从可观察现象追溯到并发边界、编译链接与系统资源中的具体机制,并说明规则被破坏后的后果。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:CPU 发出虚拟地址,内存管理单元把虚拟页号转换为物理页框并保留页内偏移。
- 再讲机制:围绕“地址翻译路径 → 收益与成本”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合并发边界、编译链接与系统资源说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:百度基础架构二面
问题讲解
一、地址翻译路径
CPU 发出虚拟地址,内存管理单元把虚拟页号转换为物理页框并保留页内偏移。页表存映射与权限,TLB 缓存近期转换。TLB 命中可快速得到物理地址;未命中通常进行页表遍历;页表项无有效映射会触发缺页异常,由内核分配、装入或拒绝访问。
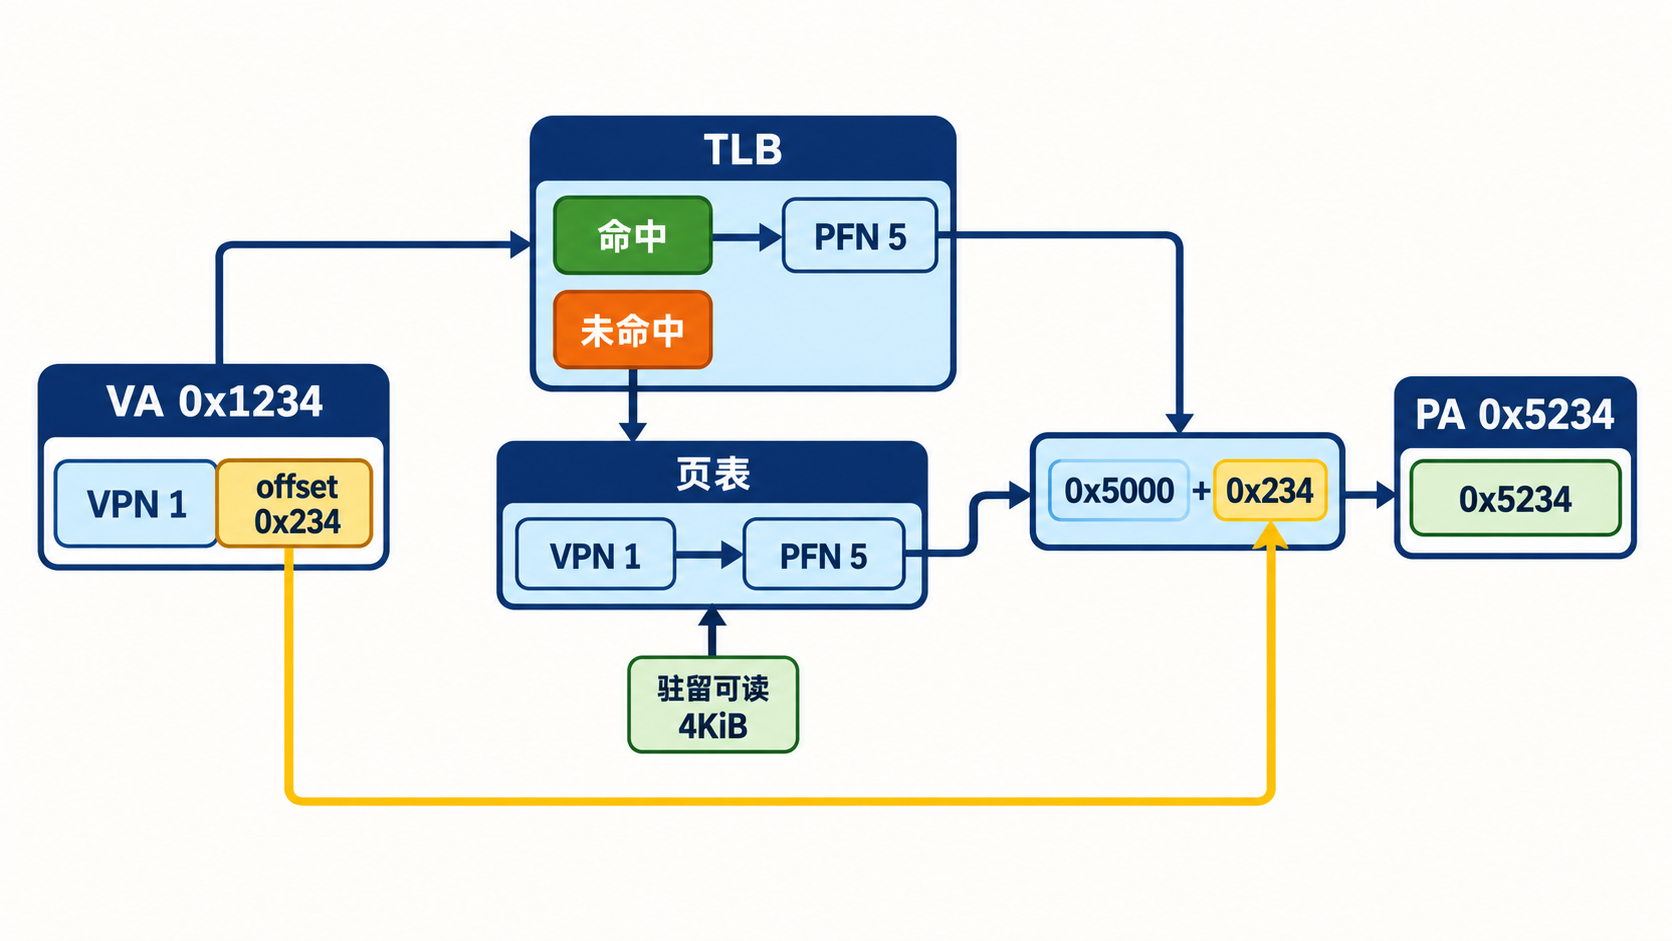
图中采用4KiB页与硬件遍历教学模型:虚拟页1映射帧5,偏移0x234保持不变。
二、收益与成本
虚拟内存提供隔离、统一地址视图、按需分配和文件映射。大页可降低 TLB 压力但增加内存粒度和管理成本。缺页不一定意味着磁盘 I/O,首次匿名页分配也会缺页;TLB miss 也不等于 page fault。
独立算例:读取合法只读映射的页2,将其准备到空闲帧6;0x2340随后映射为0x6340。
三、常见错误
- 把 TLB miss 和缺页混为一谈。
- 认为虚拟地址等于磁盘交换地址。
- 认为申请大块虚拟内存立即占用等量物理内存。
- 忽略 NUMA 和访问局部性。
回答自检
- VA 到 PA 的路径。
- TLB、页表和缺页各自职责。
- 按需分配为何触发轻微缺页。
- 大页与局部性的权衡。
面试官可能追问的问题
- 页内偏移需要转换吗? 不需要,映射改变页框,偏移保留。
- 多级页表为何存在? 稀疏地址空间可按需分配页表层级。
- 上下文切换影响 TLB 吗? 可能,需要标签或刷新,依硬件与内核。
9. fork 的写时复制是如何工作的?
问题分析
这道题考查能否从可观察现象追溯到并发边界、编译链接与系统资源中的具体机制,并说明规则被破坏后的后果。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
fork创建子进程,逻辑上复制父进程地址空间。 - 再讲机制:围绕“写时复制流程 → 边界”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合并发边界、编译链接与系统资源说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:字节 Linux 后端一面
问题讲解
一、写时复制流程
fork 创建子进程,逻辑上复制父进程地址空间。对于需要保持私有语义的可写映射,内核通常先共享物理页并以写保护支持 COW。写入触发保护异常后,若页仍被共享就复制该页并改映射;已独占时可能只恢复写权限。不把只读页或 MAP_SHARED 映射统一说成写时复制。
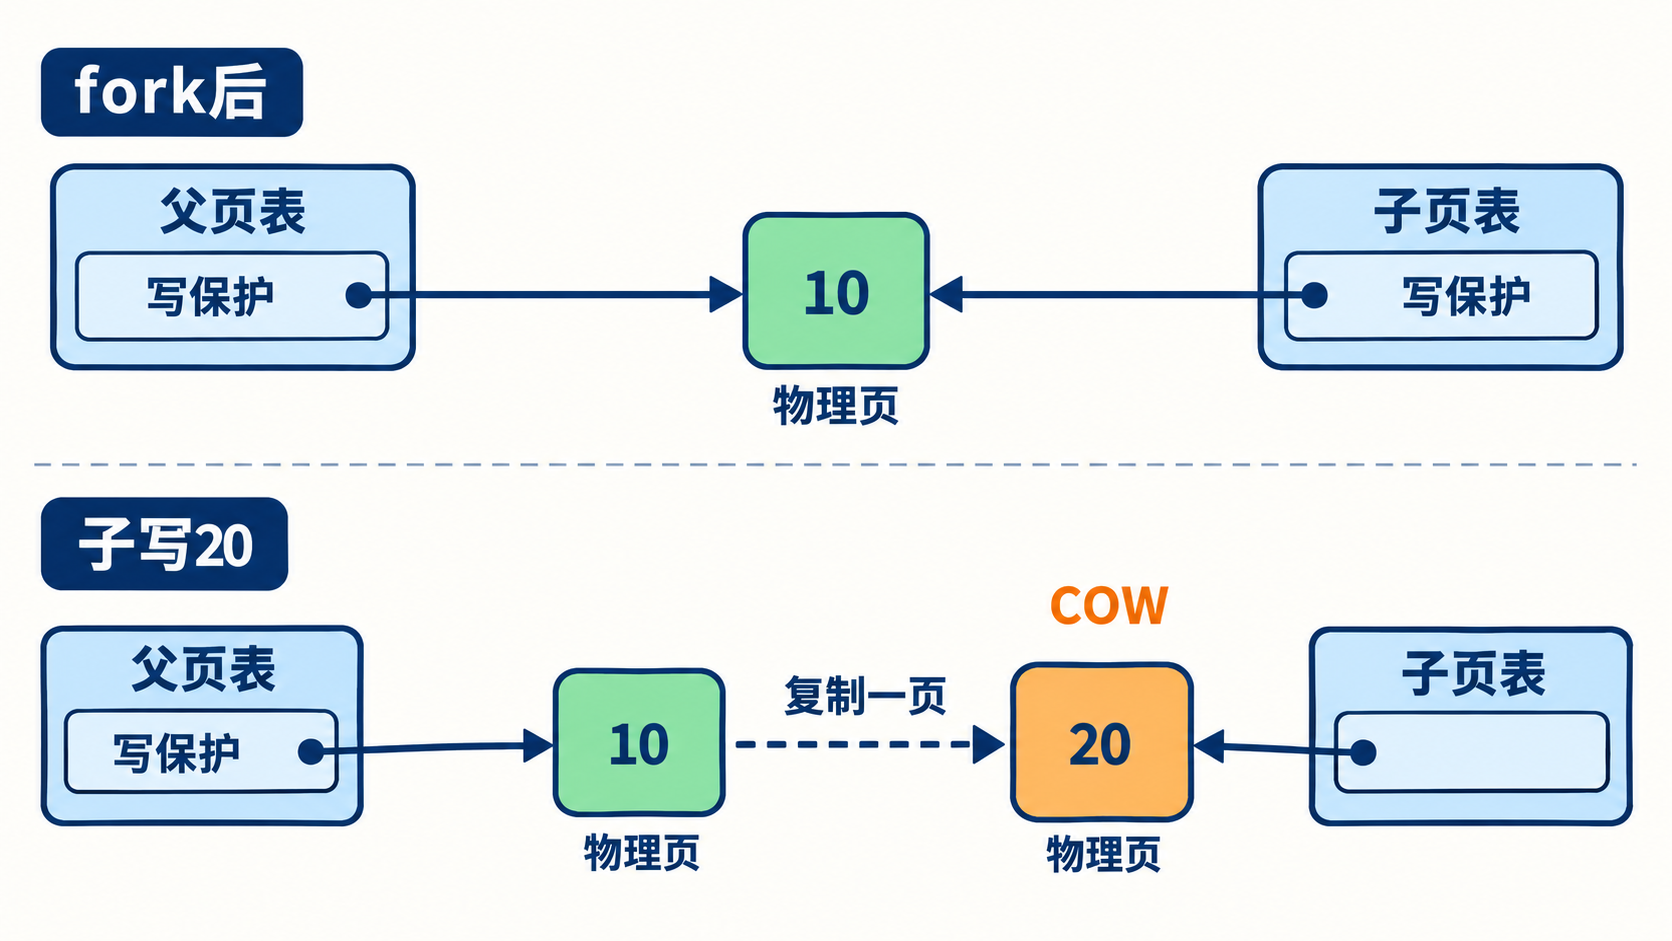
二、边界
fork 后父子普通内存修改互不直接可见;真正共享需 MAP_SHARED 等 IPC。多线程进程中 fork 后子进程只保留调用 fork 的线程,其他线程持有的锁状态可能被复制为无人可解,子进程在成功 exec 之前只能调用 async-signal-safe 的函数,并妥善处理 exec 失败,不能随意调用可能再次取得旧锁的库函数。参见fork 手册。
三、常见错误
- 认为 fork 会立即复制全部物理内存。
- 认为 COW 页面永远共享。
- 在多线程子进程中随意调用复杂库函数。
- 忘记父子关闭不需要的文件描述符。
回答自检
- 页表复制与物理页共享。
- 首次写入的保护异常和页复制。
- 普通内存与共享映射的可见性差异。
- 多线程 fork 的锁风险。
面试官可能追问的问题
- 为什么 fork+exec 仍有价值? COW 减少执行新程序前的复制成本。
- 父子文件描述符怎样? 表项被复制,但通常引用同一内核打开文件描述。
- COW 复制粒度? 通常按页,而非整个地址空间。
10. mmap 的私有映射和共享映射有什么区别?
问题分析
这道题不只是让你罗列名词,而是考查能否从并发边界、编译链接与系统资源做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
MAP_PRIVATE建立写时复制映射,进程修改不会写回底层文件,也不会作为共享修改传播给其他映射者; - 再讲机制:围绕“两种映射 → 使用与边界”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合并发边界、编译链接与系统资源说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团存储二面
问题讲解
一、两种映射
MAP_PRIVATE 建立写时复制映射,进程修改不会写回底层文件,也不会作为共享修改传播给其他映射者;MAP_SHARED 的修改对映射同一区域的进程可见,并可由内核最终写回文件。msync 可请求同步,但持久化语义还受文件系统和硬件影响。

二、使用与边界
mmap 适合随机访问大文件、共享内存和零拷贝式数据路径的一部分,但缺页成本、地址空间、截断文件导致的访问错误都要处理。并发读写共享映射仍需进程间同步;可见性不等于复合操作原子性。
三、常见错误
- 认为 MAP_SHARED 自动提供锁。
- 认为修改 shared 映射立即持久落盘。
- 文件被截短后继续访问旧映射范围。
- 忽略映射偏移需满足页对齐要求。
回答自检
- private 的 COW 与 shared 的传播语义。
- 可见性、同步和持久化三者不同。
- mmap 的缺页访问模型。
- 文件截断与并发访问风险。
面试官可能追问的问题
- 匿名映射有什么用? 获取不绑定文件的页,可用于分配器或 fork 后共享配置。
- mmap 一定比 read 快吗? 不一定,取决于访问模式、缺页和拷贝成本。
- 如何做进程间同步? 使用进程共享 mutex、信号量、futex 协议或其他 IPC。
11. C++ 性能优化应该从哪些方面入手?
问题分析
这道题考查能否把并发边界、编译链接与系统资源转化为可执行的判断步骤,而不是只报出 API 名称或最终结论。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:性能优化的第一步不是换容器或手写汇编,而是确定目标:吞吐、平均延迟、尾延迟、内存还是启动时间。
- 再讲机制:围绕“先定位,再优化 → 常见优化层次”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合并发边界、编译链接与系统资源说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团基础架构二面(编辑化整理)
问题讲解
一、先定位,再优化
性能优化的第一步不是换容器或手写汇编,而是确定目标:吞吐、平均延迟、尾延迟、内存还是启动时间。先建立可重复基准,用采样剖析、硬件计数器、堆分析或链路追踪找到热点,再修改最主要的瓶颈。
二、常见优化层次
| 层次 | 典型手段 | 先检查什么 |
|---|---|---|
| 算法 | 降低复杂度、批处理 | 数据规模和热点路径 |
| 数据布局 | 连续存储、减少指针跳转 | 缓存未命中和对象大小 |
| 分配 | 复用缓冲、reserve、内存池 | 分配频率和峰值内存 |
| 并发 | 减少锁竞争、分片、背压 | 等待时间和任务粒度 |
| I/O | 批量、异步、零拷贝条件 | 系统调用和复制成本 |
| 编译 | 优化级别、LTO、PGO | 构建模式和可观测回归 |
| 内存对齐优化要看实际访问模式。为了对齐盲目增加 padding 可能扩大工作集;把高频字段集中、降低对象尺寸,有时比让每个成员获得更大对齐更重要。伪共享需要通过缓存行写入竞争证据确认。 |
三、常见错误
- 在 Debug 构建或不真实输入上比较纳秒级差异。
- 根据“通常更快”替换容器,却不测量缓存和内存成本。
- 只看平均值,忽略 P99 延迟和最坏路径。
- 通过移除检查获得速度,却破坏正确性和可维护性。
回答自检
- 性能目标、基线、剖析和复测的完整闭环。
- 算法、布局、分配、并发和 I/O 的优化顺序。
- 为什么对齐、内联和无锁都需要证据。
面试官可能追问的问题
vector为什么常比list快? 连续布局具有更好的缓存局部性,不能只看插入复杂度。- 内联越多越好吗? 不一定,过度内联会增加代码体积并损害指令缓存。
- 如何避免基准测试被优化掉? 使用可观察结果、固定环境,并检查生成代码或基准框架方法。
12. C++ 日志框架应该如何选型和设计?
问题分析
这道题考查能否把并发边界、编译链接与系统资源转化为可执行的判断步骤,而不是只报出 API 名称或最终结论。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:日志不是一次
printf。 - 再讲机制:围绕“日志链路包含什么? → 选型维度”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合并发边界、编译链接与系统资源说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:阿里云 C++ 后端二面(编辑化整理)
问题讲解
一、日志链路包含什么?
日志不是一次 printf。完整链路包括事件构造、级别过滤、格式化、排队、写入目标、滚动和失败处理。同步日志在调用线程完成写入,行为直观但可能拉高尾延迟;异步日志把事件放入有界队列,由后台线程批量写出。

二、选型维度
| 维度 | 需要确认的问题 |
|---|---|
| 性能 | 同步还是异步,格式化发生在哪个线程 |
| 可靠性 | 崩溃前是否需要 flush,队列满如何处理 |
| 并发 | 多线程写入是否保持单条日志完整 |
| 运维 | 按大小或时间滚动,保留多久,如何压缩 |
| 接口 | 结构化字段、源码位置、上下文和采样 |
| 故障 | 磁盘满、权限错误、写线程退出时怎样降级 |
| 异步队列必须有界。无界队列在磁盘变慢时会把 I/O 问题变成内存问题;有界队列则要明确阻塞、覆盖旧日志、丢弃低级别日志或回退同步写入的策略。关键审计日志和调试日志通常不能使用同一丢弃规则。 |
三、常见错误
- 热路径先拼接完整字符串,再做日志级别判断。
- 异步队列没有容量限制或退出时不 drain。
- 多线程共享非线程安全格式化缓冲区。
- 只比较每秒日志条数,不检查业务线程尾延迟和丢失率。
回答自检
- 日志从业务线程到输出目标的完整路径。
- 同步与异步日志的延迟和可靠性取舍。
- 有界队列、滚动、flush 和故障降级策略。
面试官可能追问的问题
- 异步日志一定更快吗? 它通常降低调用线程等待,但会引入排队、后台线程和丢失策略成本。
- 队列满怎么办? 必须按日志等级和业务要求明确阻塞、丢弃、采样或降级策略。
- 程序崩溃时如何尽量保留日志? 关键路径可同步刷出或使用专门崩溃记录机制,但信号处理环境能调用的 API 很有限。



