
第八章 STL 容器与字符串
第八章 STL 容器与字符串
1. STL 常见容器有哪些?应该根据什么选择?
问题分析
这道题考查能否把存储结构、复杂度与迭代器失效规则转化为可执行的判断步骤,而不是只报出 API 名称或最终结论。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:序列容器包括
array、vector、deque、list、forward_list; - 再讲机制:围绕“容器家族”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合存储结构、复杂度与迭代器失效规则说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯 C++ 后端一面
问题讲解
一、容器家族
序列容器包括 array、vector、deque、list、forward_list;有序关联容器包括 set/map 家族;无序关联容器包括 unordered_set/map 家族;stack、queue、priority_queue 是容器适配器。
默认优先 vector:连续布局有良好缓存局部性、随机访问 O(1),尾部追加均摊 O(1)。只有需求明确时再选择其他容器,不能只看某个操作的渐进复杂度,还要看元素数量、分配次数和迭代访问。
二、常见错误
- 频繁中间插入就机械选 list,忽略定位成本和缓存缺失。
- 需要有序范围查询却用 unordered_map。
- 认为所有 O(1) 操作实际成本相同。
- 不检查迭代器失效规则。
回答自检
- 三类容器的核心用途。
- vector 默认优先的硬件原因。
- 复杂度、局部性和失效规则的共同作用。
- 有序与哈希查找的选择条件。
面试官可能追问的问题
- deque 是否连续? 整体不保证连续,通常由分段缓冲区组成。
- list 的优势? 已知位置的插删稳定且迭代器通常不失效,适合节点重排。
- 容器适配器是什么? 在底层容器上限制接口形成特定抽象。
2. vector 的 size、capacity、reserve 和 resize 有什么区别?
问题分析
这道题不只是让你罗列名词,而是考查能否从存储结构、复杂度与迭代器失效规则做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
size()是当前已构造元素数; - 再讲机制:围绕“四个概念”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合存储结构、复杂度与迭代器失效规则说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团后端一面
问题讲解
一、四个概念
size() 是当前已构造元素数;capacity() 是无需重新分配即可容纳的元素数。reserve(n) 只保证容量至少为 n,不改变 size;resize(n) 改变元素数,增大时构造新元素,减小时析构尾部元素。
clear() 销毁全部元素,size 变为 0,capacity 保持不变;shrink_to_fit() 只是非强制请求。预知元素量时 reserve 可减少扩容和失效,但过度预留会浪费内存。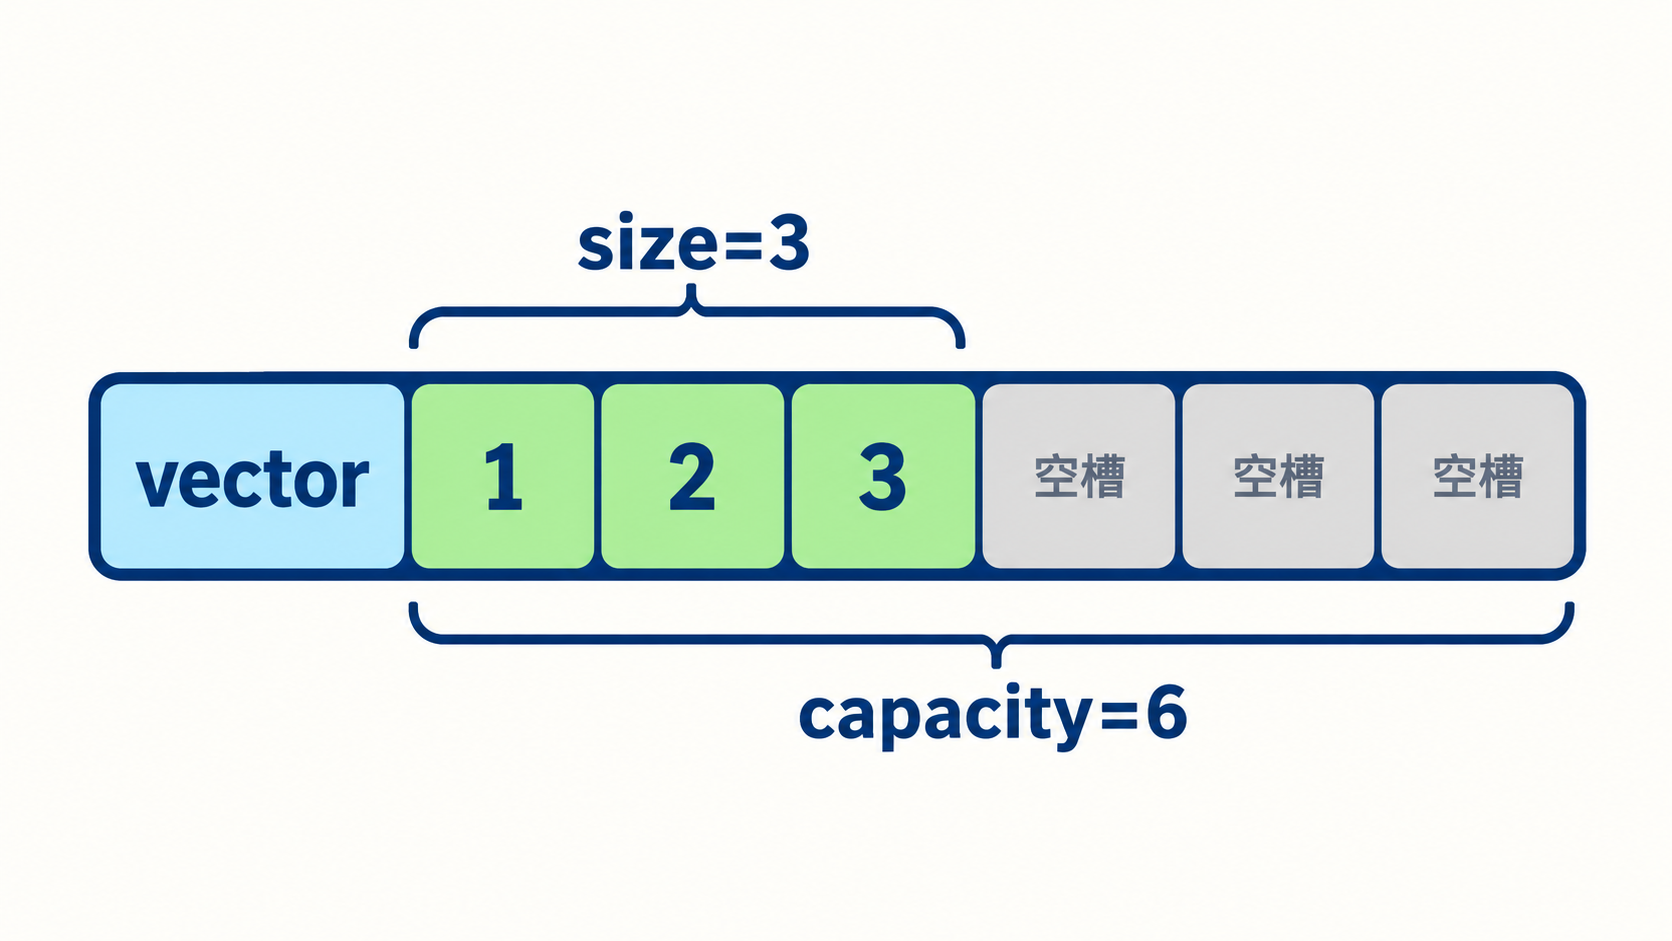
二、完整可执行示例
#include <iostream>
#include <vector>

void print_state(const char* operation, const std::vector<int>& values) {
    std::cout << operation << ": size=" << values.size()
              << ", capacity=" << values.capacity() << '\n';
}

int main() {
    std::vector<int> values{1, 2, 3};
    print_state("initial", values);

    values.reserve(10);
    print_state("reserve(10)", values); // size 仍为 3

    values.resize(6, 9);
    print_state("resize(6)", values);   // 新增三个值为 9 的元素

    values.clear();
    print_state("clear", values);       // Capacity remains unchanged.
}
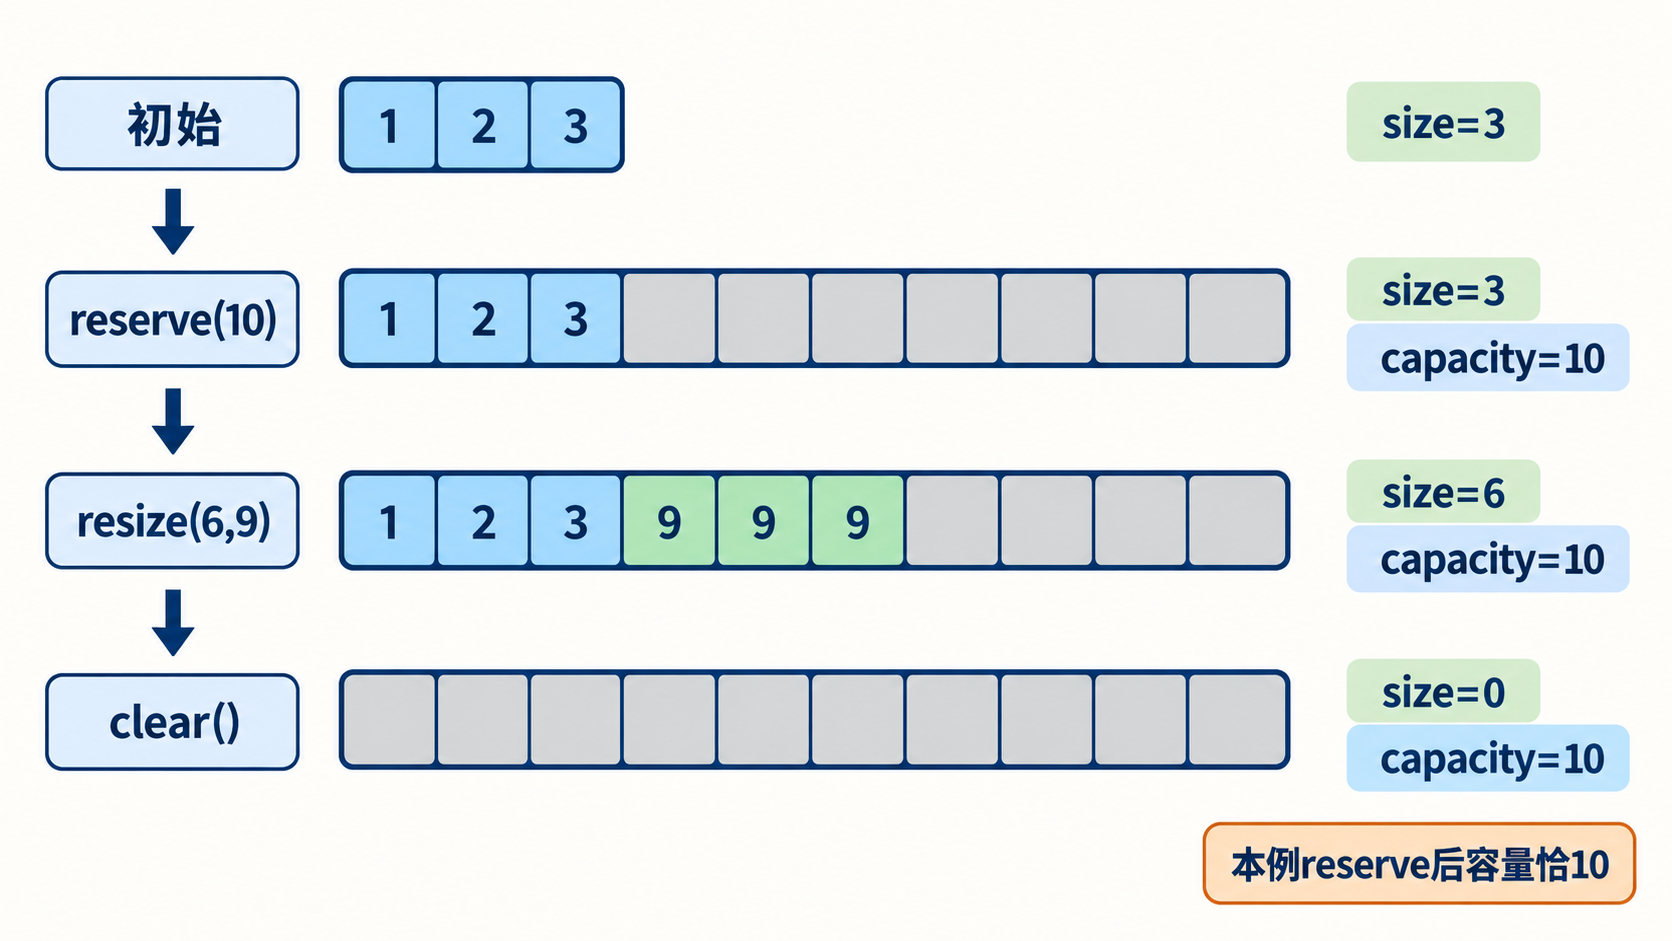
图示假设本次reserve(10)后容量恰为10;标准只保证至少10。
三、常见错误
- reserve 后用
operator[]写入尚未构造的元素。 - 认为 resize 只分配空间不构造对象。
- 认为 clear 会释放底层容量。
- 依赖 shrink_to_fit 一定归还内存。
回答自检
- 有效对象区和预留存储区的区别。
- reserve 与 resize 的不同副作用。
- clear 和 shrink_to_fit 的边界。
- 几何增长与均摊 O(1) 的关系。
面试官可能追问的问题
- capacity 增长倍率是多少? 标准不规定,实现通常几何增长以满足均摊复杂度。
- reserve 变小会收缩吗? 不会。
- resize 缩小时哪些引用失效? 被移除元素失效;具体操作还需结合实现和标准规则。
3. vector::push_back 和 emplace_back 有什么区别?
问题分析
这道题不只是让你罗列名词,而是考查能否从存储结构、复杂度与迭代器失效规则做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
push_back接收一个已经形成的元素对象,再复制或移动到容器末尾; - 再讲机制:围绕“语义区别 → 边界”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合存储结构、复杂度与迭代器失效规则说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯客户端一面
问题讲解
一、语义区别
push_back 接收一个已经形成的元素对象,再复制或移动到容器末尾;emplace_back 接收构造参数并在末尾直接构造元素。若调用处本来已有同类型对象,两者通常都移动/复制;只有从构造参数创建元素时 emplace 才可能避免临时对象。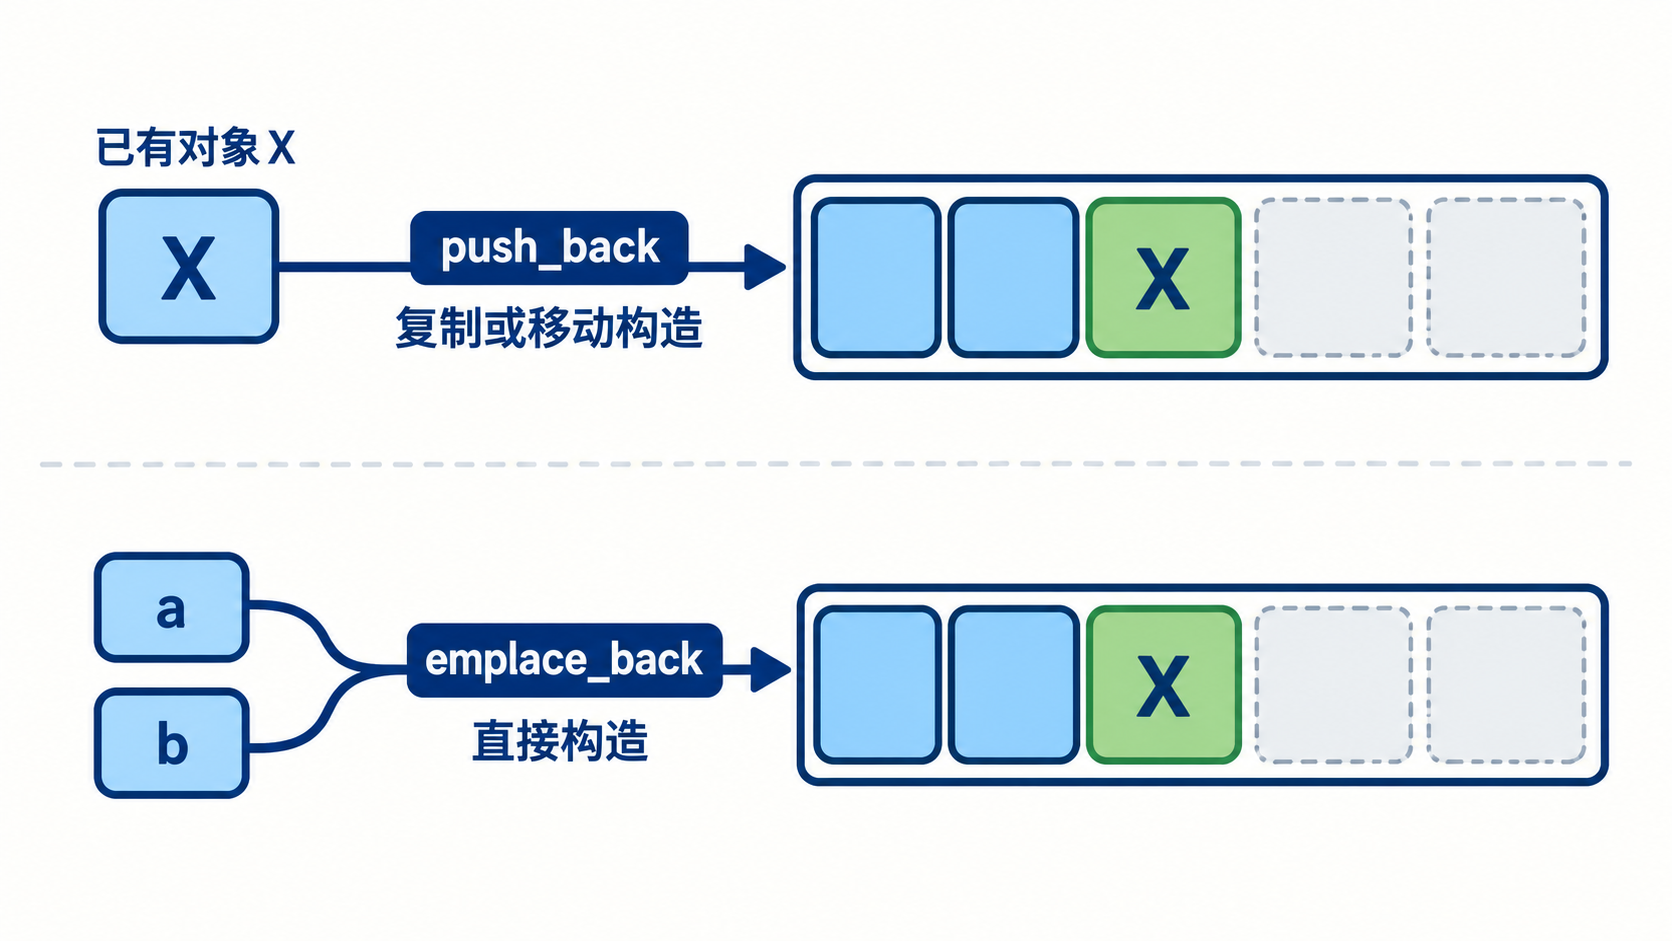
二、边界
emplace 会直接参与构造函数重载,可能调用 explicit 构造或产生意外窄化;可读性不一定更好。C++17 中 emplace_back 返回新元素引用。扩容时已有元素的搬迁成本与选择哪个追加接口无关。
三、常见错误
- 宣称 emplace_back 永远比 push_back 快且零拷贝。
- 已有对象仍写
emplace_back(std::move(obj))并认为多一层优化。 - 忽略构造函数重载带来的语义变化。
- 把末尾原位构造误解为整个 vector 不扩容。
回答自检
- 对象参数与构造参数的区别。
- emplace 避免临时对象的条件。
- 扩容成本与追加接口无关。
- 可读性和构造重载风险。
面试官可能追问的问题
- 添加同类型右值如何选?
push_back(std::move(x))清晰且通常等价有效。 - 为什么 emplace 可能更危险? 它把任意参数直接转发给构造函数,隐式意图更难看出。
- 扩容会怎样? 分配新存储并移动或复制已有元素。
4. vector 扩容后哪些指针、引用和迭代器会失效?
问题分析
这道题考查能否用存储结构、复杂度与迭代器失效规则解释题目中的语义,而不是停留在定义记忆。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:一旦操作导致重新分配,所有指向元素的指针、引用和迭代器以及旧
end()都失效,因为元素迁移到新存储。 - 再讲机制:围绕“失效规则”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合存储结构、复杂度与迭代器失效规则说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:百度 C++ 后端一面
问题讲解
一、失效规则
一旦操作导致重新分配,所有指向元素的指针、引用和迭代器以及旧 end() 都失效,因为元素迁移到新存储。未重分配时,尾部插入通常只使旧 end() 失效;中间插入/删除会使操作位置及之后的迭代器和引用失效。
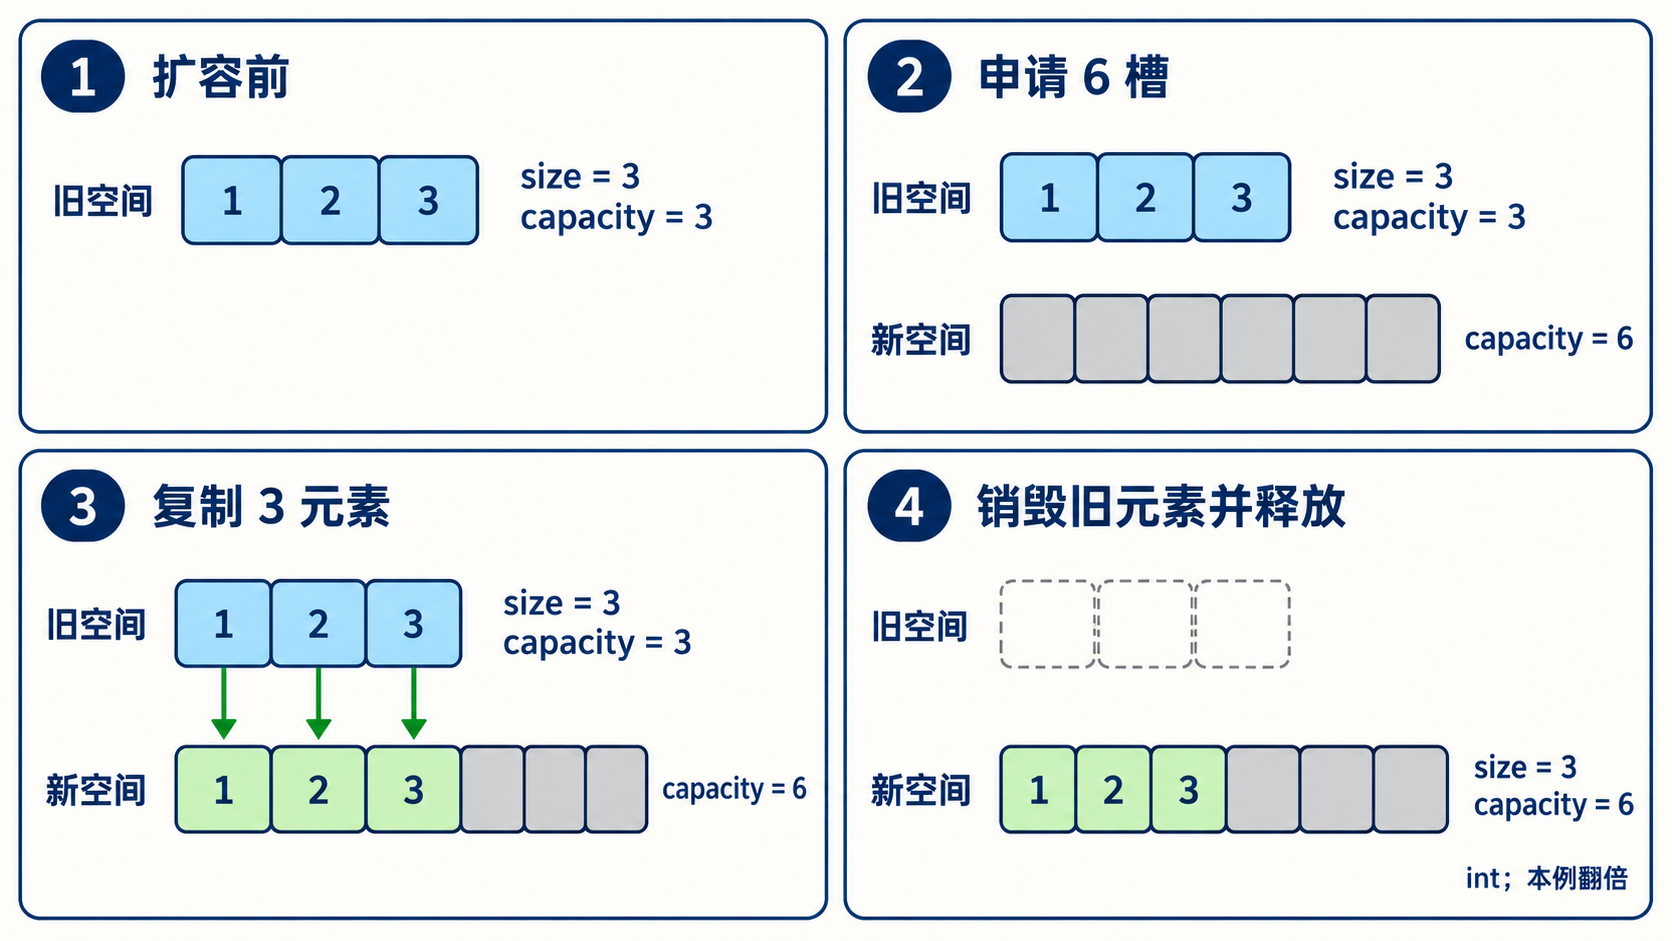
int教学模型:本次容量从3翻倍到6,size仍为3;标准不规定固定增长倍率。
reserve 可提前稳定一段容量,但一旦超过仍会失效。需要长期稳定地址时可改用间接所有权,如 vector<unique_ptr<T>>,或选择满足地址稳定需求的结构。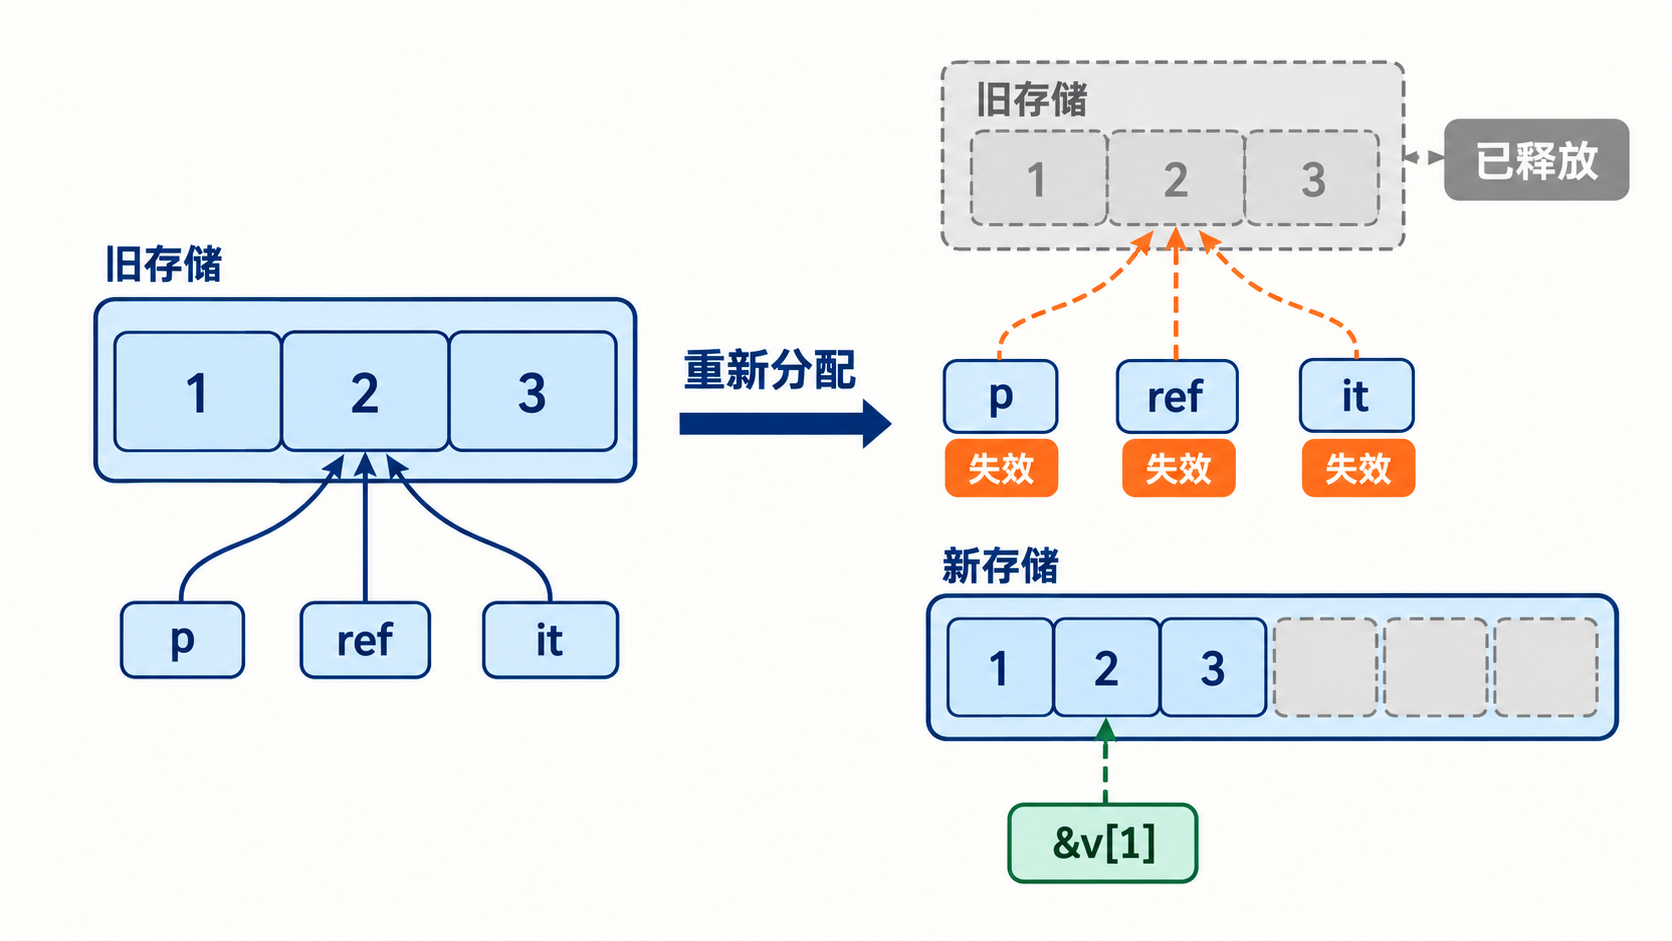
二、常见错误
- 保存
&v[0]后继续 push_back。 - 循环中 erase 后继续递增旧迭代器。
- 认为只要元素值没变,引用就有效。
- 依赖特定实现没有扩容的偶然行为。
回答自检
- 重分配时为何全部失效。
- 未重分配插入删除的失效范围。
- reserve 能提供多长的稳定窗口。
- 地址稳定需求的替代设计。
面试官可能追问的问题
- erase 应如何继续遍历? 使用其返回的下一个有效迭代器。
- reserve 后引用永远稳定吗? reserve 仅避免容量范围内追加导致的重分配;中间插入、erase、resize 缩小或 clear 仍有自己的失效规则。即使没超过 capacity,也不能保证任意操作后所有引用稳定。参见vector 容量规则。
- vector<unique_ptr<T>> 扩容会影响 T 地址吗? unique_ptr 本身搬迁,但其堆上对象地址通常不变。
5. vector、list 和 deque 应该如何选择?
问题分析
这道题不只是让你罗列名词,而是考查能否从存储结构、复杂度与迭代器失效规则做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:list 的 O(1) 插入不含寻找位置,节点分配和缓存缺失常使它输给 vector。
- 再讲机制:围绕“对比”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合存储结构、复杂度与迭代器失效规则说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:字节 C++ 一面
问题讲解
一、对比
| 特性 | vector | deque | list |
|---|---|---|---|
| 存储 | 连续 | 分段连续 | 独立节点 |
| 随机访问 | O(1),局部性好 | O(1) | O(n) |
| 两端插入 | 尾部均摊 O(1) | 两端 O(1) | 已知位置 O(1) |
| 中间插删 | O(n) 搬移 | O(n) | 已知位置 O(1) |
| 地址稳定 | 扩容会失效 | 规则较复杂 | 非删除元素通常稳定 |
list 的 O(1) 插入不含寻找位置,节点分配和缓存缺失常使它输给 vector。deque 适合队列、双端增长,但不能向需要连续内存的 C API 传整体数据。
二、常见错误
- 看到中间插入就选 list。
- 认为 deque 所有元素连续。
- 忽略 list 每节点指针和分配开销。
- 只用大 O,不测量真实工作负载。
回答自检
- 三者的布局与访问特征。
- O(1) 插入为何不等于整体更快。
- deque 的分段连续边界。
- 选型必须结合真实操作比例。
面试官可能追问的问题
- queue 默认底层为何常是 deque? 两端操作高效且无需连续重分配。
- list 何时真正有价值? splice 节点、必须稳定迭代器且已知位置时。
- 小数据集怎么选? 通常 vector 的局部性更重要。
6. std::string 的小字符串优化(SSO)能否依赖?
问题分析
这道题考查能否用存储结构、复杂度与迭代器失效规则解释题目中的语义,而不是停留在定义记忆。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:主流
std::string实现常在 string 对象内部留一小段缓冲区,短字符串直接存于对象内,避免堆分配; - 再讲机制:围绕“SSO 是什么 → 使用边界”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合存储结构、复杂度与迭代器失效规则说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯客户端二面
问题讲解
一、SSO 是什么
主流 std::string 实现常在 string 对象内部留一小段缓冲区,短字符串直接存于对象内,避免堆分配;超过阈值后切换到动态存储。C++ 标准不要求 SSO,也不规定阈值、布局或切换方式。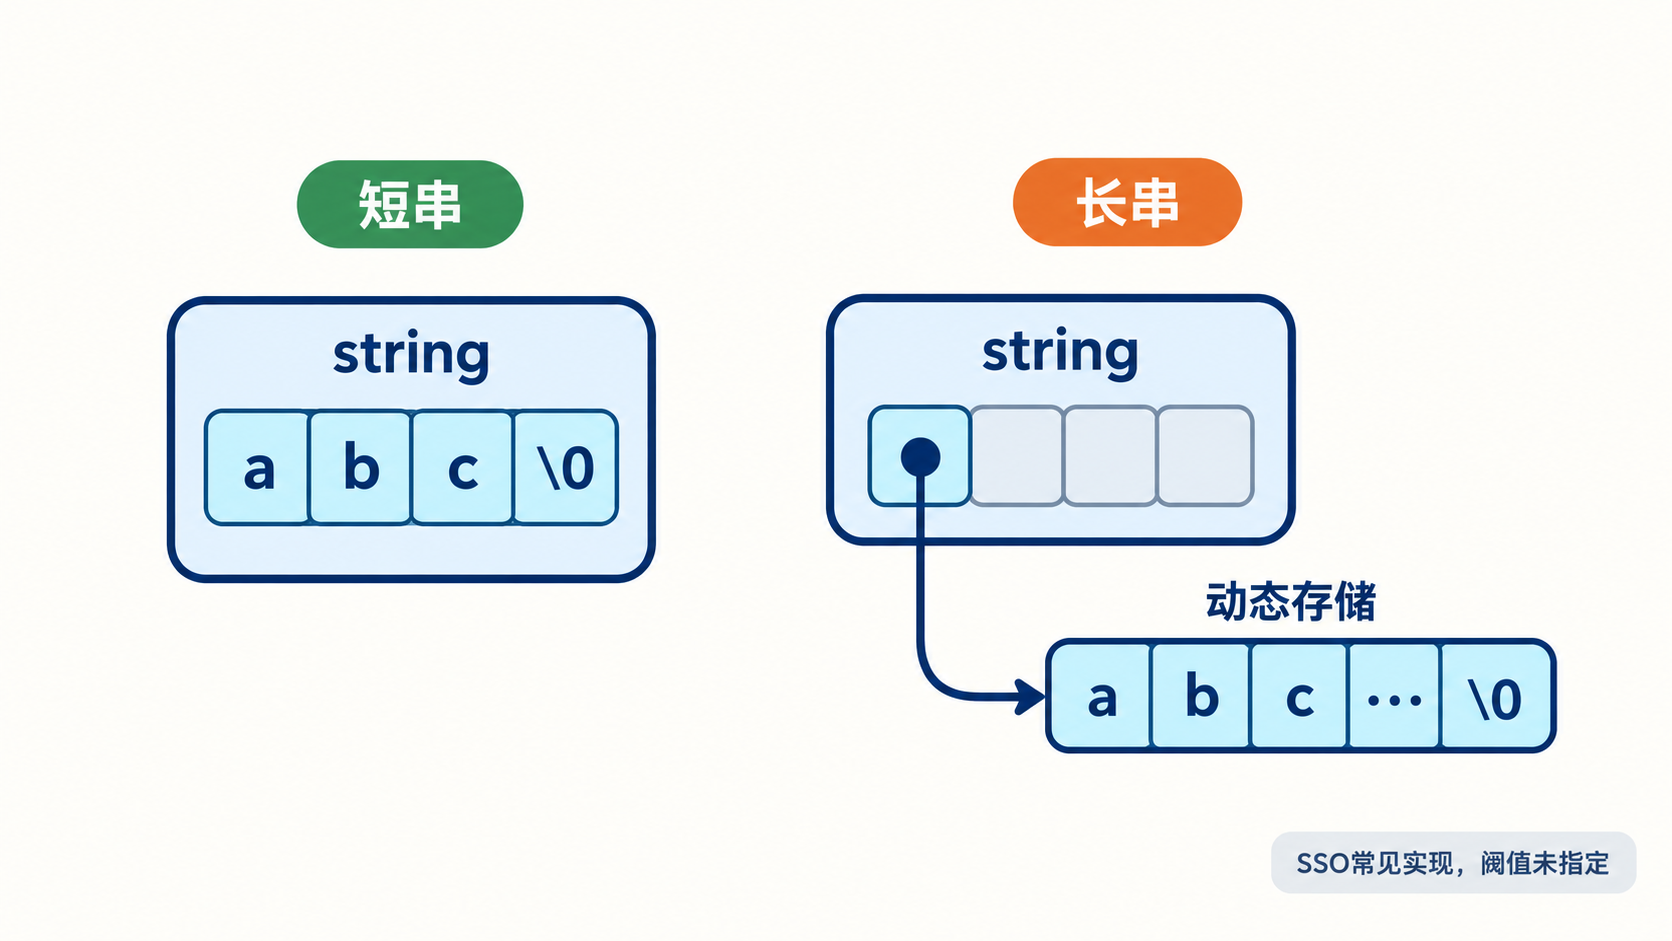
二、使用边界
可把 SSO 视为常见优化背景,但不能在协议、序列化、对象大小断言或容量策略中依赖具体阈值。字符串修改、移动、交换后,先前的 data() 指针可能失效,应遵守接口规则而非推测当前是否 SSO。
三、常见错误
- 写死“15 个字符一定不分配”。
- 通过 memcpy 复制 string 对象内部表示。
- 根据 SSO 假设移动后源字符串一定为空。
- 长期保存
c_str()后继续修改字符串。
回答自检
- SSO 解决的分配成本。
- 它为何属于实现细节。
- 阈值变化对移动和地址稳定的影响。
data/c_str指针失效风险。
面试官可能追问的问题
- 如何确认某实现阈值? 可测量,但结果只适用于该标准库版本和 ABI。
- SSO 对移动有何影响? 内联字符可能需要复制,移动未必只是交换指针。
- 能否依赖 data 以 null 结尾? C++17 非 const
data()可写且字符串存储有终止字符保证,但只能在合法范围操作。
7. std::string、std::string_view 和 C 字符串如何安全互操作?
问题分析
这道题考查能否把存储结构、复杂度与迭代器失效规则转化为可执行的判断步骤,而不是只报出 API 名称或最终结论。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
string拥有并管理字符序列; - 再讲机制:围绕“三种表示 → 生命周期规则”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合存储结构、复杂度与迭代器失效规则说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团后端一面
问题讲解
一、三种表示
string 拥有并管理字符序列;string_view 只借用“指针 + 长度”,不保证零终止;C 字符串以空字符结束,接口常只接收 const char*,长度需扫描或另传。把 view 传给只接受 C 字符串的函数不能直接使用 data(),因为其范围可能是子串且后面没有终止符。
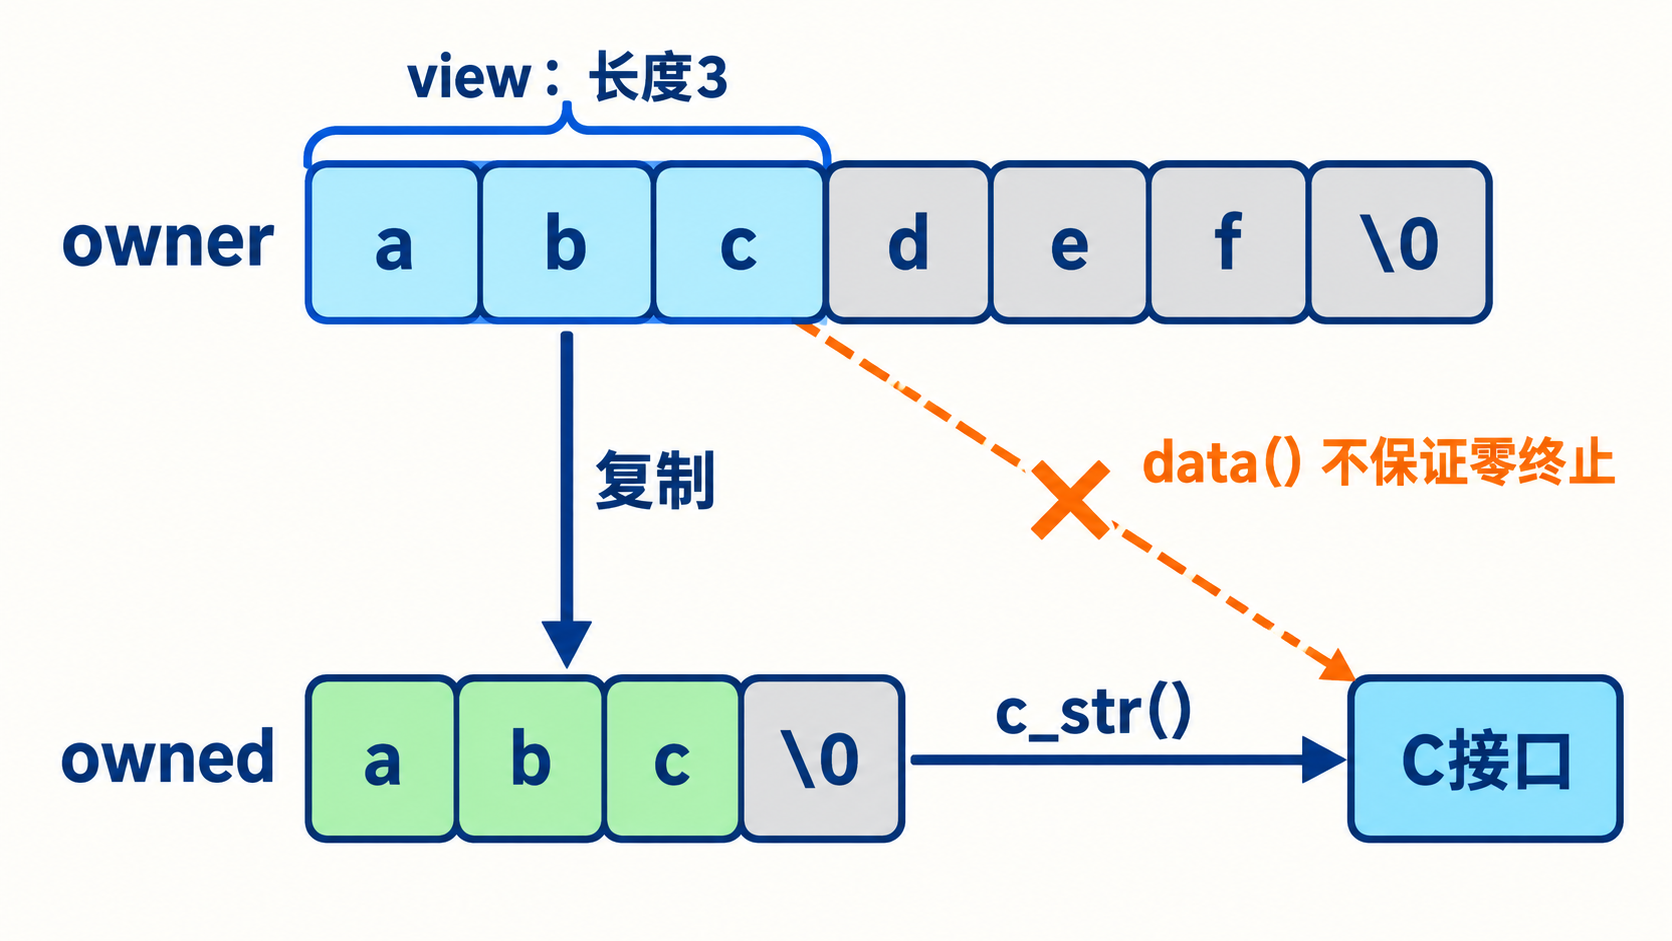
二、生命周期规则
view 不能比底层字符活得更久;返回局部 string 的 view、保存临时拼接结果的 view 都会悬空。string 修改导致重分配后,旧 view 和 C 指针也可能失效。二进制数据可能包含 \0,必须使用显式长度接口。
三、常见错误
- 假设
string_view::data()一定零终止。 - view 绑定临时 string 并长期保存。
- 用
strlen处理可含零字节的缓冲区。 - 修改 string 后继续使用旧
c_str()。
回答自检
- 所有权、长度和终止符三条维度。
- view 与临时对象的悬空风险。
- 子串传 C API 的正确做法。
- 二进制缓冲区为何必须带长度。
面试官可能追问的问题
- 函数参数何时用 string_view? 只读、同步使用且不保存时。
- 需要保存输入怎么办? 复制到拥有型 string。
- C API 返回 char 谁释放?* 由 API 合同决定,必须明确分配器和释放函数。
8. map 和 unordered_map 有什么区别?如何选择?
问题分析
这道题不只是让你罗列名词,而是考查能否从存储结构、复杂度与迭代器失效规则做出有依据的比较和选择。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
map通常以平衡搜索树实现,按键有序,查找/插入/删除 O(log n),支持范围查询和lower_bound。 - 再讲机制:围绕“核心对比”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合存储结构、复杂度与迭代器失效规则说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:百度 C++ 后端一面
问题讲解
一、核心对比
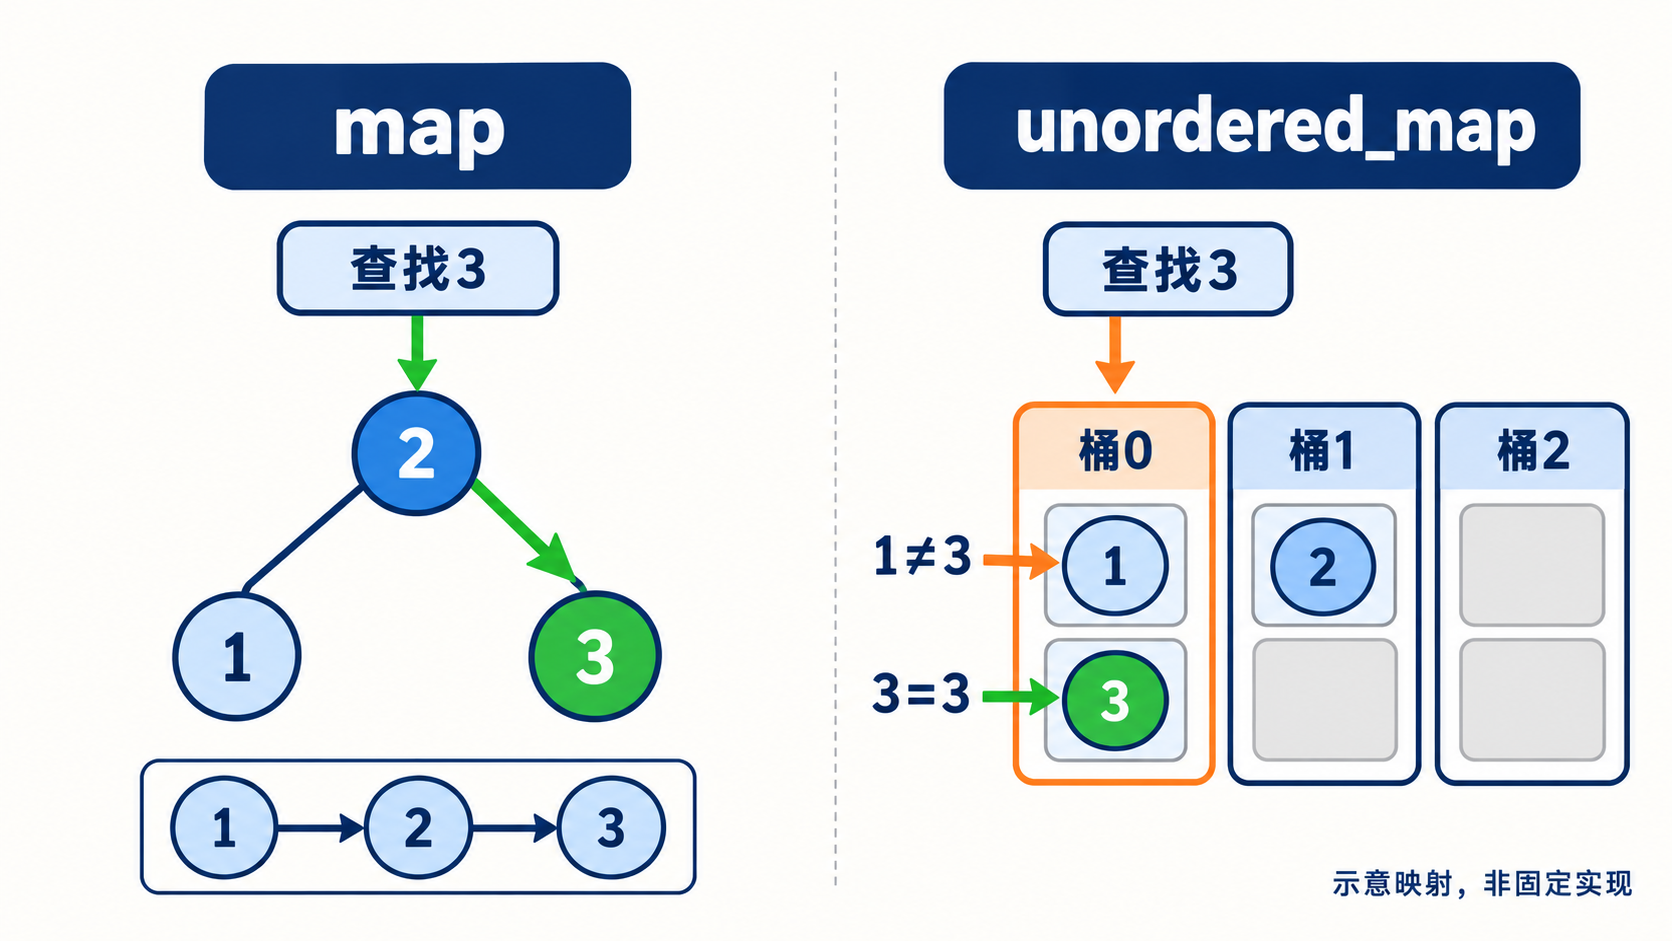
map 通常以平衡搜索树实现,按键有序,查找/插入/删除 O(log n),支持范围查询和 lower_bound。unordered_map 是哈希容器,平均查找 O(1)、最坏 O(n),不提供排序顺序,性能依赖哈希、负载因子和冲突。
| 需求 | map | unordered_map |
|---|---|---|
| 有序遍历/范围查询 | 适合 | 不支持 |
| 平均点查找 | O(log n) | O(1) |
| 最坏复杂度 | O(log n) | O(n) |
| 内存形态 | 树节点 | 桶数组 + 节点 |
| 迭代器失效 | 插入通常稳定 | rehash 会使迭代器失效 |
二、常见错误
- 断言 unordered_map 永远更快。
- 自定义 key 的 hash 与 equality 不一致。
- 依赖 unordered_map 遍历顺序。
- 忽略对抗输入导致严重冲突。
回答自检
- 有序树和哈希表的主要差异。
- 平均复杂度与最坏复杂度。
- 范围查询和遍历顺序的影响。
- 哈希质量与负载因子的作用。
面试官可能追问的问题
- map 的实现标准规定是红黑树吗? 不规定,只规定可观察复杂度和顺序语义。
- 何时 rehash? 元素数超过桶数与最大负载因子允许范围时可能发生。
- 键能否修改? 容器内键视为 const,修改会破坏组织不变式。
9. std::set、multiset、map、multimap 如何区分?
问题分析
这道题考查能否把存储结构、复杂度与迭代器失效规则转化为可执行的判断步骤,而不是只报出 API 名称或最终结论。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:
set只保存唯一键; - 再讲机制:围绕“二维分类 → 边界”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合存储结构、复杂度与迭代器失效规则说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:腾讯 C++ 后端一面
问题讲解
一、二维分类
set 只保存唯一键;multiset 只保存键但允许等价键重复;map 保存唯一键到值的映射;multimap 保存可重复键到多个值。四者都有序,顺序由比较器定义的等价关系决定,而不一定是 operator==。
| 容器 | 有映射值 | 允许等价键重复 |
|---|---|---|
| set | 否 | 否 |
| multiset | 否 | 是 |
| map | 是 | 否 |
| multimap | 是 | 是 |
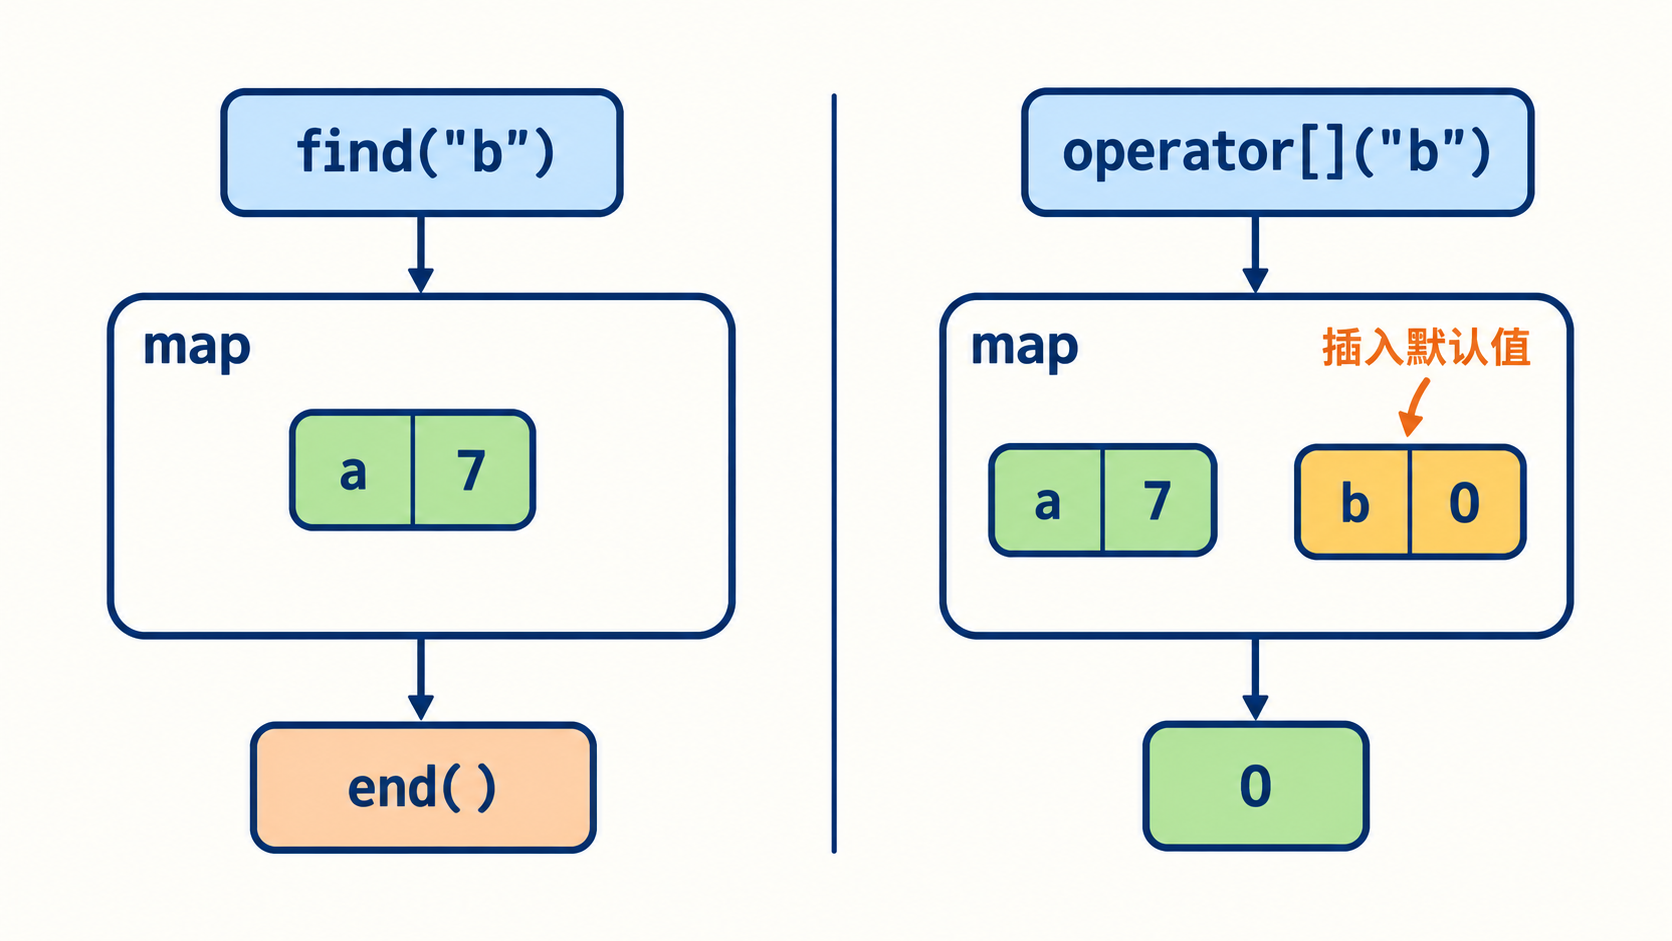
二、边界
访问 map 的 operator[] 在键不存在时会插入默认值;只查询应使用 find、contains(C++20)或 at。处理重复键范围使用 equal_range。比较器必须满足严格弱序。
三、常见错误
- 查询时用
map[key],意外修改容器。 - 认为 multimap 的同键值可用 operator[]。
- 用
==判断容器所说的键等价。 - 修改 set 元素或 map 键破坏顺序。
回答自检
- 四个容器的二维分类。
- 唯一性基于比较等价。
- 查询接口的插入副作用。
- 重复键范围的处理方式。
面试官可能追问的问题
- 如何取得所有重复键? 使用
equal_range得到半开区间。 - map::at 不存在时怎样? 抛
std::out_of_range。 - 为什么键是 const? 组织结构依赖键顺序,原地修改会破坏不变式。
10. unordered_map 的哈希、桶、冲突和 rehash 如何工作?
问题分析
这道题考查能否从可观察现象追溯到存储结构、复杂度与迭代器失效规则中的具体机制,并说明规则被破坏后的后果。
建议按“结论 → 机制 → 边界”组织回答:
- 先给结论:哈希函数把键映射为哈希值,再映射到某个桶;
- 再讲机制:围绕“查找流程 → 哈希契约与安全”说明规则如何生效,把关键对象、时机或状态变化串起来。
- 最后讲边界:结合存储结构、复杂度与迭代器失效规则说明适用条件、常见误用,以及如何通过代码、编译结果或运行现象验证判断。
- 来源:美团基础架构二面
问题讲解
一、查找流程
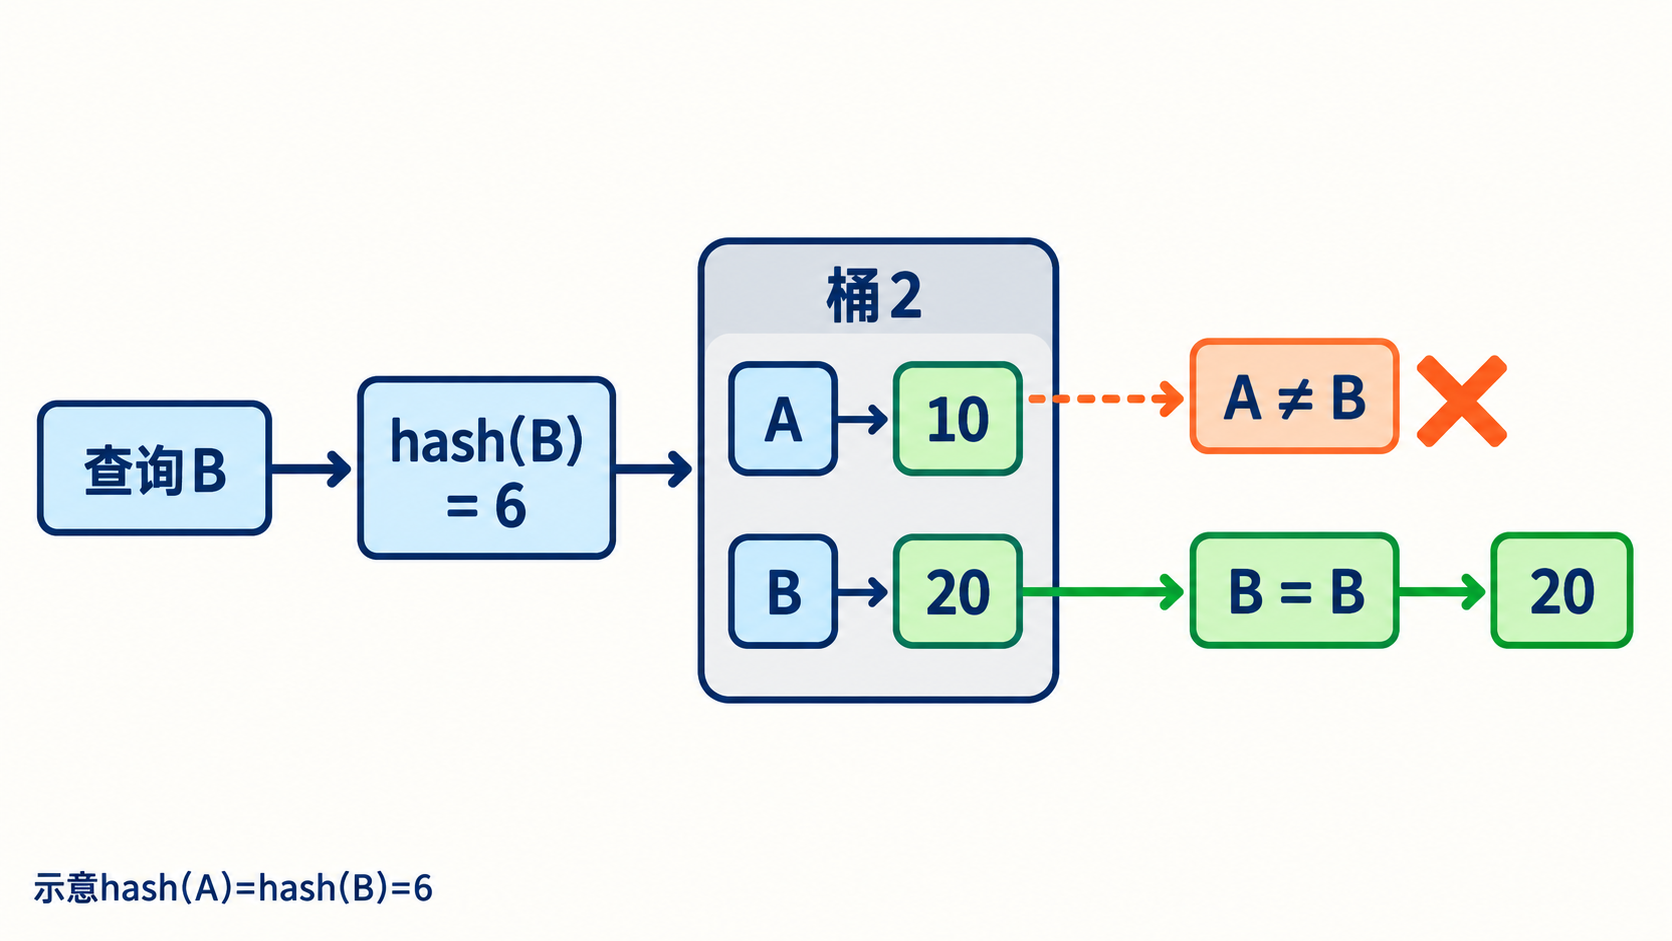
哈希函数把键映射为哈希值,再映射到某个桶;桶内可能存在多个冲突元素,容器使用相等比较器确认真实键。元素数与桶数的比值是负载因子,超过 max_load_factor 相关阈值时可能 rehash,重新建立桶数组并分配元素所属桶。
rehash 使迭代器失效,但不会使指向元素的指针或引用失效;后续删除对应元素才会使这些借用失效。这是容器契约,不是“通常如此”的实现猜测。参见无序容器要求。reserve(n) 可为预计元素数提前准备桶,减少重复 rehash。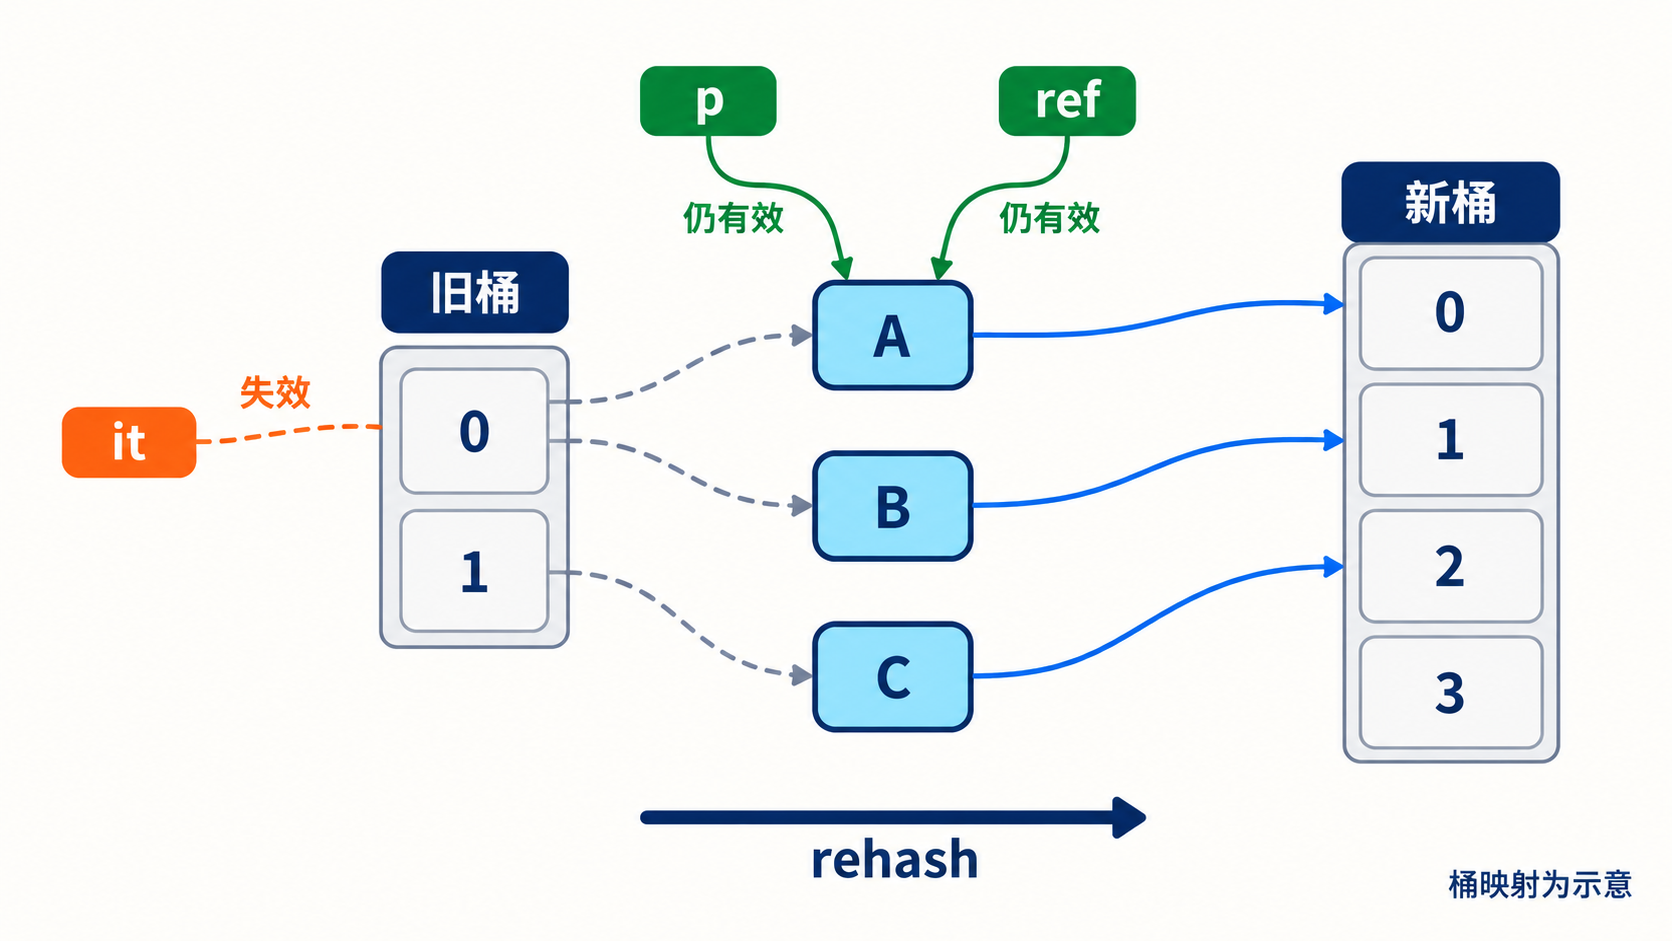
二、哈希契约与安全
若 key_equal(a,b) 为真,两者哈希必须相同;反向不要求。差哈希会形成长冲突链,使平均 O(1) 退化。外部不可信键还要考虑哈希碰撞攻击和内存上限。
三、常见错误
- 只实现 hash,不让 equality 与其一致。
- 把哈希相同当成键相等。
- 保存迭代器跨越 rehash。
- 通过极低负载因子无上限换速度,造成内存浪费。
回答自检
- 哈希到桶再比较的完整流程。
- 冲突不是错误而是必须处理的情况。
- 负载因子如何触发 rehash。
- rehash 的迭代器失效影响。
- 自定义哈希与相等的契约。
面试官可能追问的问题
- reserve 与 rehash 区别? reserve 按预计元素数计算所需桶,rehash 直接请求至少某桶数。
- 平均 O(1) 的条件? 哈希分布合理、负载受控、比较成本可接受。
- 为什么遍历无序? 桶布局与 rehash 由实现及运行状态决定。



