
文件系统与磁盘校招面试题|操作系统
文件系统与磁盘校招面试题|操作系统
本章沿着“找到文件→读取内容→减少等待→组织存储”的顺序展开。文件结构使用类Unix教学模型,读取使用Linux本地普通文件缓冲I/O的典型路径;磁盘调度单独采用HDD磁头模型,不把它直接推广到SSD。
贯穿文件
路径为/home/alice/note.txt:根目录inode 2中home→40,目录inode 40中alice→50,目录inode 50中note.txt→120。文件inode 120大小6144字节,即6 KiB。块大小4 KiB,逻辑块0对应B100,逻辑块1对应B180;B100的4096字节全部属于文件,B180仅前2048字节属于文件。编号和布局均为假设,各题独立使用初始状态。
1. 文件系统是如何组织和管理文件的?
文件系统将设备上的存储组织成应用可使用的文件和目录,既管理名字与内容之间的关系,也管理空间分配、权限和元数据一致性。它不是把路径字符串直接当成物理存储地址。
先用名字找对象,再找到内容
在类Unix模型中,目录项记录“名字对应哪个inode编号”;inode描述文件对象的类型、大小、权限以及数据位置等;数据块存放实际内容。这三者不能混成一个结构。
查找/home/alice/note.txt时,从根目录inode 2的内容里找到home→40;进入inode 40的目录找到alice→50;再在inode 50的目录找到note.txt→120。最后得到文件inode 120,才能依据其块映射定位内容。目录本身也是一种文件系统对象,有存放目录条目的内容。
文件名通常在目录项中,而不是统一存于inode。一个对象可以有多个硬链接名称,名称改变也不意味着内容对象必须改变。inode编号在所属文件系统内标识对象,不能当作全系统永久唯一的身份。文件名与对象关系见OSTEP:文件与目录。
文件大小决定哪些字节属于文件
本例逻辑块0→B100,保存偏移0~4095;逻辑块1→B180,只有前2048字节保存偏移4096~6143。尽管为文件内容提供了两个块,读取不能把第二块剩余区域也算作文件数据。文件有效大小是6144,而不是8192字节。
块映射可以通过块指针、间接结构或连续区间等方式表达,不能把本例两项表当成所有实现。文件扩大时,文件系统需要为新内容分配空间、更新大小和映射;删除与释放也必须根据引用、打开状态等规则进行,而不是简单擦掉目录里的字符串。
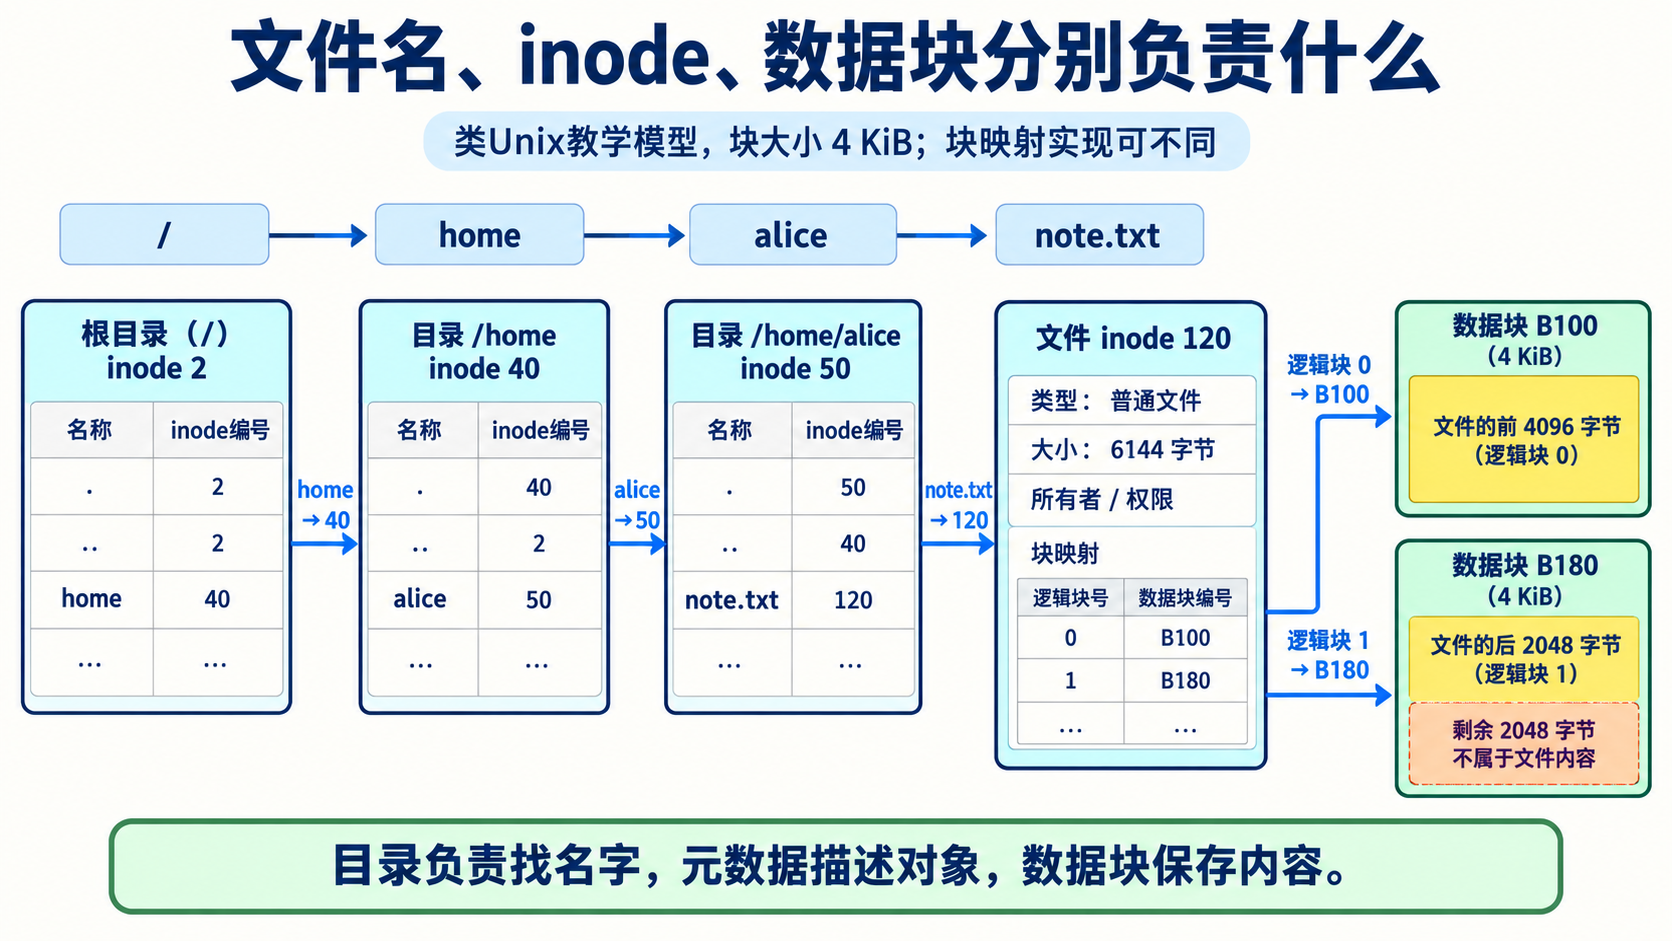
沿目录链找到inode,再按块映射和文件大小找到有效字节。
管理职责还包括可用空间与规则
空闲位图或其他索引记录可分配空间,避免多个文件误占同一块。权限检查限制谁能遍历目录、读写对象;并发协调避免更新相互破坏。某些文件系统通过日志或其他机制维护故障后的元数据一致性,但日志不自动等于所有应用数据都已持久保存,也不能代替备份。实现结构见OSTEP:文件系统实现。
面试回答
文件系统把存储组织成文件和目录,并管理命名、空间、权限与一致性。类Unix模型中,目录项把名称关联到inode,inode描述类型、大小、权限和块映射,数据块保存内容。解析路径逐级查目录,找到对象后再定位字节;文件大小决定有效范围,不能把末块空余当成内容。具体文件系统的组织方式可不同,inode编号也不是全系统永久唯一身份。
2. 读取一个文件通常经历哪些步骤?
读取通常分为打开对象和取得内容两件事:open负责依据路径找到并打开文件,read则依据打开状态、偏移和请求长度取得数据。下面只解释Linux本地普通文件缓冲读,直接I/O、DAX和网络文件系统不能直接照搬。
打开文件并不等于读完文件
应用请求打开/home/alice/note.txt。内核解析路径,检查目录遍历和文件访问权限,取得文件对象,建立这次打开所需的状态,并在进程描述符表里分配一个入口。本例假设返回fd 3,起始偏移为0。
fd 3是进程用于引用打开文件的整数,不是inode编号120。inode描述对象;打开文件状态还记录访问方式、当前偏移等。同一文件可以被分别打开,打开状态不必相同;通过复制描述符共享同一打开对象时,偏移也可能共享。对象关系见Linux VFS文档。
read先看内容是否已经准备好
应用调用read(fd3, buf, 6144),内核通过fd找到打开对象,根据偏移0请求前6144字节。所需内容已经在有效页缓存中时,可直接使用它;没有就绪内容时,通过文件映射找到B100和B180,将所需数据经块I/O、驱动和设备准备到页缓存,再继续读取。
本例常规缓冲读随后把有效数据复制到用户缓冲buf。即便设备通过DMA把数据送到内核RAM,也不意味着这个常规路径自动免去用户缓冲复制。缓存命中支路不必每次都访问存储设备;缓存未命中则可能等待内容就绪。
这里假设没有错误、没有并发截断,并且本次完整返回6144字节。因此用户取得4096+2048字节,打开状态的偏移变成6144。若文件未变化,再从这个位置读取,已到文件末尾,返回0表示EOF。
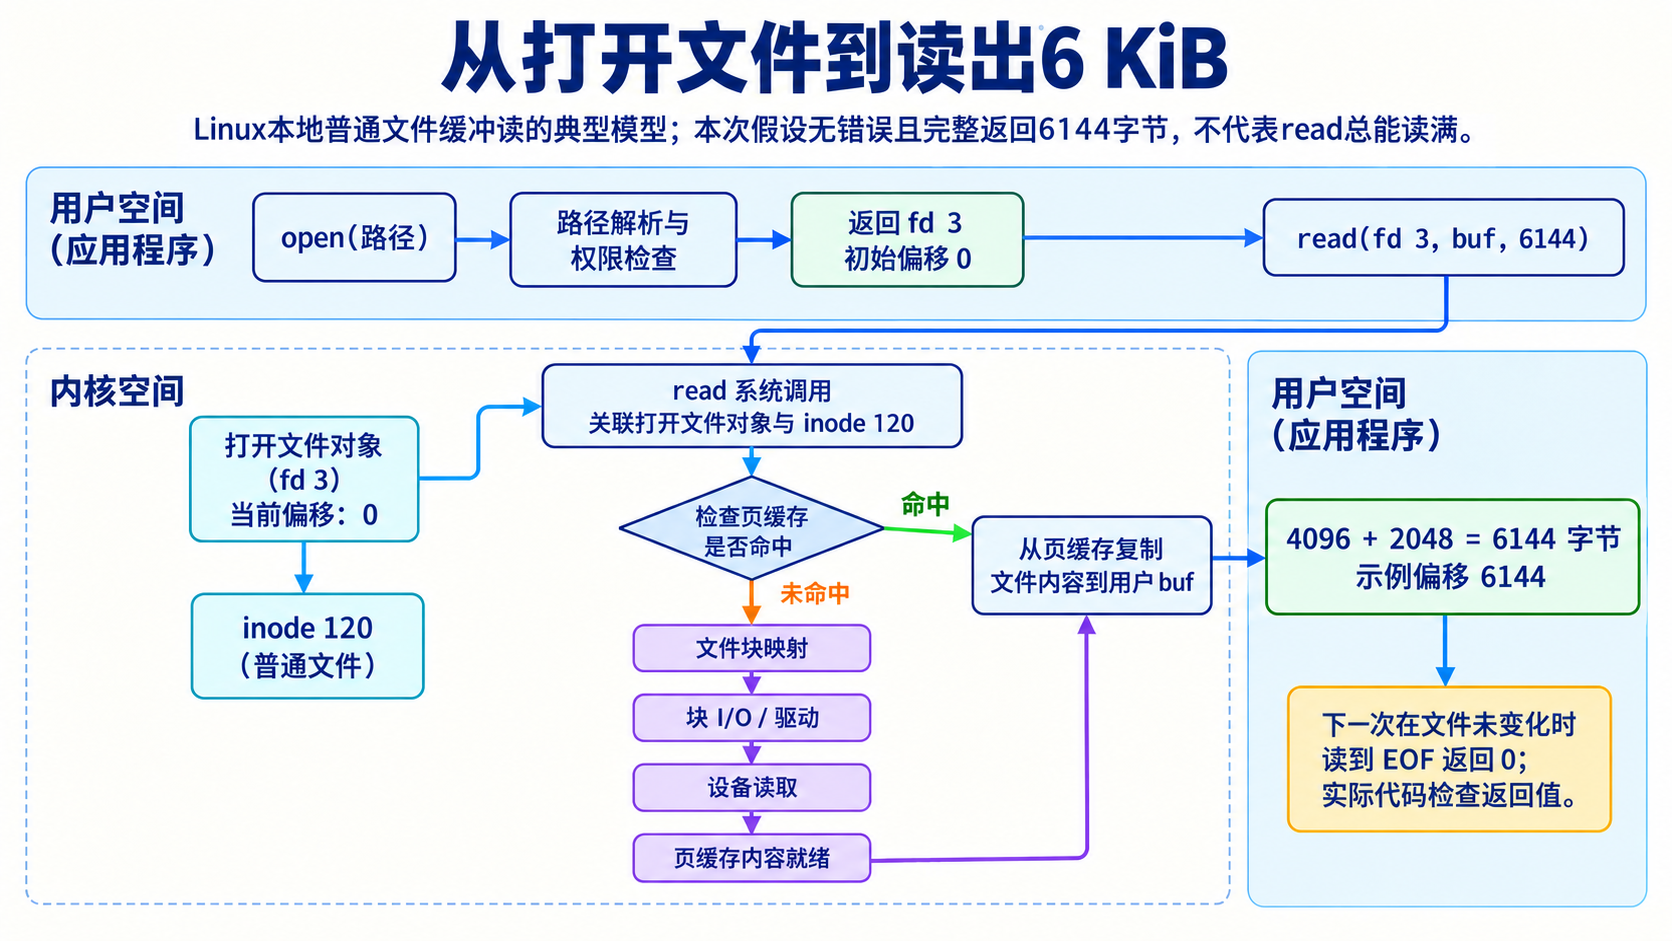
分开open、缓存判断、设备准备与用户缓冲返回。
请求长度不是成功保证
read返回正数表示实际取得的字节数,可能小于请求值;返回0表示本次没有读到更多数据,在本例普通文件末尾表示EOF;错误通常返回-1并说明原因。程序需要检查返回值、按实际字节数推进,必要时继续读取,不能因为请求6144就假设缓冲已全部填满。返回约定见Linux read手册。目录和inode信息也可能被缓存,不能从路径层数推导每次实际磁盘访问次数。
面试回答
通常先open解析路径、检查权限并建立打开文件状态,返回进程内的文件描述符;read再依据该状态的偏移和请求长度取得内容。本地普通文件缓冲读先使用页缓存,缺少内容时经文件块映射和设备I/O准备,再复制到用户缓冲并返回实际字节数。fd不等于inode,open不等于读完;程序必须处理短读、错误和EOF,不能把请求长度当成实际返回长度。
3. 文件系统如何通过页缓存和预读提升性能?
页缓存把已经准备好的文件内容保留在内存,后续可以复用;预读则在预计将要访问某些内容时提前准备它们。前者减少重复读取,后者尝试让未来需求与设备准备重叠,二者都以内容有效、访问模式合适为前提。
相同内容仍在缓存,就不必重复取回
第一次从偏移0读取note.txt,假设它的两个页内容都未缓存,系统需要根据B100、B180准备数据,然后复制6144字节给应用。关闭后再次打开,若内容仍有效且未被回收,新读请求就能直接使用页缓存,不要求再从设备取回相同内容。
“命中”仍有内存访问和本例用户复制,不是耗时为零,也不是CPU数据缓存命中。页缓存由操作系统管理文件内容;CPU数据缓存缓存更底层的数据访问,TLB缓存地址翻译,三种对象和用途不同。修改、失效和回收也会影响能否继续复用。
顺序读取时,把下一段提前准备好
另用64 KiB的large.bin,共16个4 KiB页。为简化说明,假设顺序读取页0时,系统除准备页0,还预先准备页1、2、3;应用处理页0期间,后续页可能已经就绪,再要页1时就减少现场等待。
这里4页只是示意窗口,不是Linux固定预读参数。系统需要根据访问行为等因素决定是否预读、准备多少;提前准备也真实占用I/O和内存,不会凭空生成内容。Linux缓冲文件读取的预读接口和页缓存职责见Linux VFS:地址空间操作。
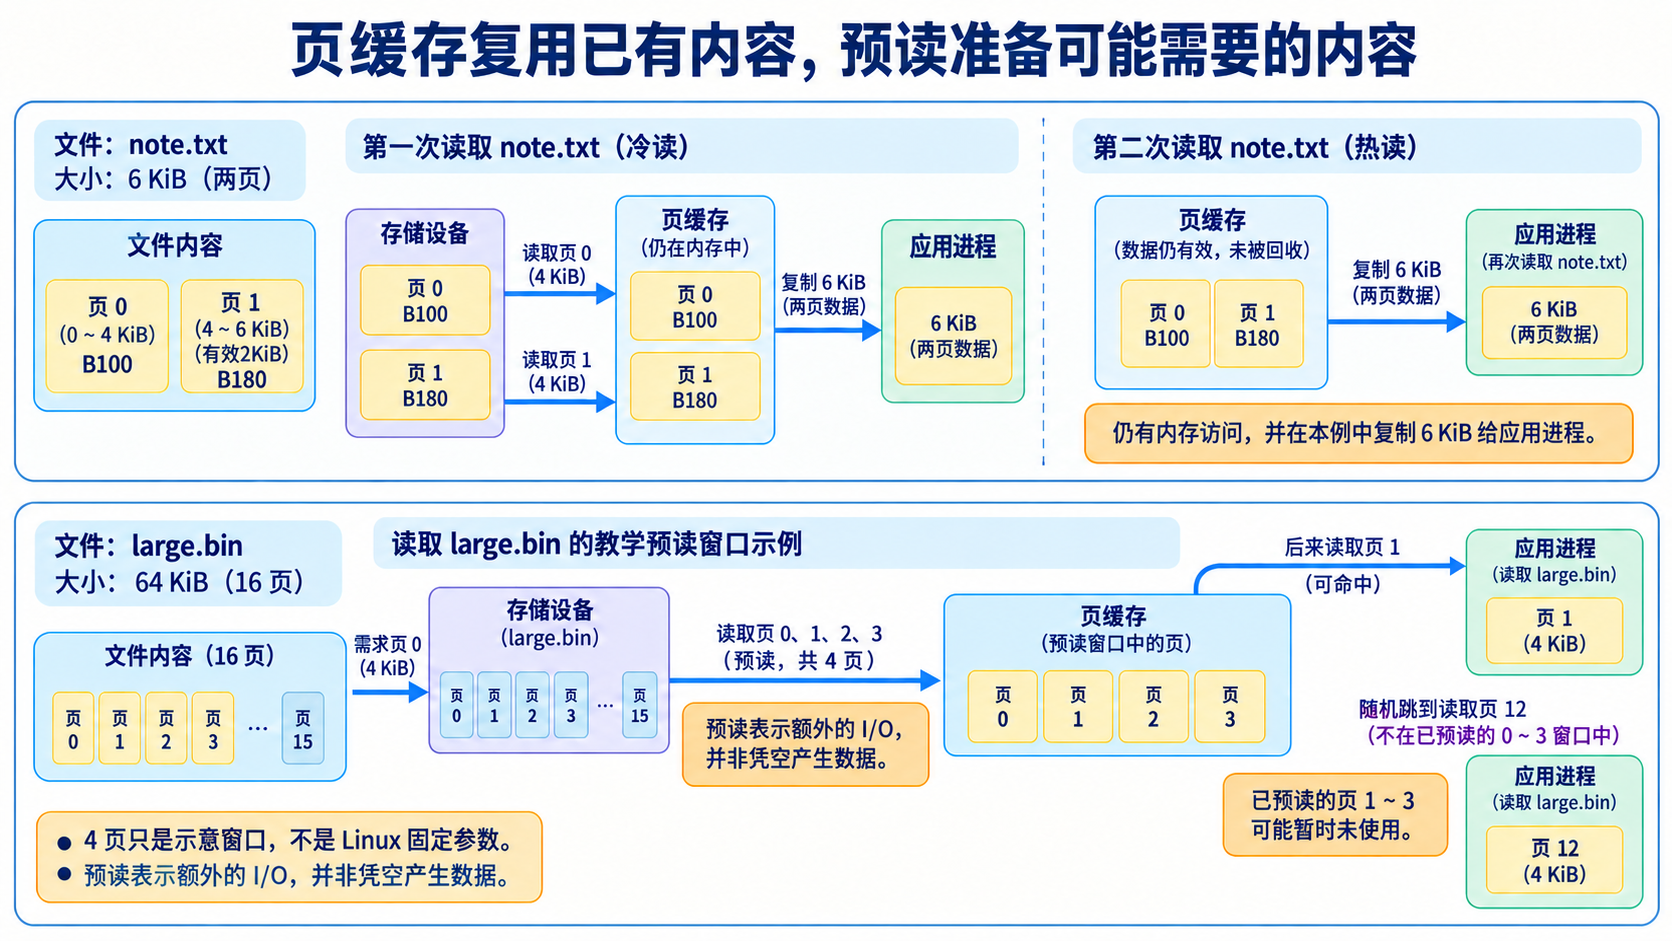
上半比较note.txt冷读与热读,下半用独立大文件解释预读。
预测错了,也会付出成本
如果应用读完页0就随机跳到页12,预读页1~3此时可能没用上,还可能挤占其他有用缓存。因此不能说预读永远更快,适合顺序访问的策略不一定适合随机访问。
缓存性能也受工作集影响:文件需求超过可保留内存,内容可能频繁被回收,重复读取仍会触发I/O。应先判断是重复访问、顺序访问还是随机访问,再分析缓存和预读减少了哪一部分成本。本题不涉及修改系统参数,也没有测量命中率或加速倍数。
面试回答
页缓存保存有效文件内容,后续命中时可减少重复设备读取,但仍有内存访问,常规缓冲read还可能复制到用户缓冲。预读根据访问趋势提前准备后续内容,顺序读时可让I/O与处理重叠,减少将来等待。随机访问可能让预测失效,带来额外I/O和缓存占用。窗口大小并非固定,收益取决于访问模式、内容有效性和可用缓存容量。
4. 文件布局和磁盘碎片为什么会影响性能?
文件布局是文件内容在存储地址中的安排。碎片会使连续的文件字节分散到多个区域,可能增加定位、映射和请求处理成本;影响多大要区分HDD机械访问和SSD等无机械寻道设备。
同样6 KiB内容,可以放在不同位置
对本例文件,连续布局可令逻辑块0→B100、逻辑块1→B101;分散布局则为B100、B180。两者都是按逻辑顺序读取前4096和后2048字节,没有少数据,也没有因为碎片就自动损坏文件。
文件碎片指同一文件的内容分散;空闲空间碎片则指可用空间被切成许多小段,影响后续连续分配。两者相关但不相同:文件目前连续,不代表设备的空闲区域也连续。
HDD多了机械定位,SSD要换一种解释
在HDD教学模型中,磁头需要移动到合适位置,还要等待目标扇区转到可读取的位置。较分散的请求可能增加这些等待,连续访问也更有机会合并处理。不过B100和B180是逻辑存储编号,并不能直接据差值推算真实寻道距离或毫秒数;设备内部可能另有映射和调度。机械访问成本的组成见OSTEP:磁盘。
SSD没有磁头,因此不能说分散布局让SSD“多寻道”。但分散的区间仍可能增加文件映射或请求数量,设备内部映射、并行性和写入管理也会影响表现。具体收益应依据负载和设备,不能反向得出“SSD上的任何碎片完全没有影响”。闪存与映射机制见OSTEP:闪存SSD。
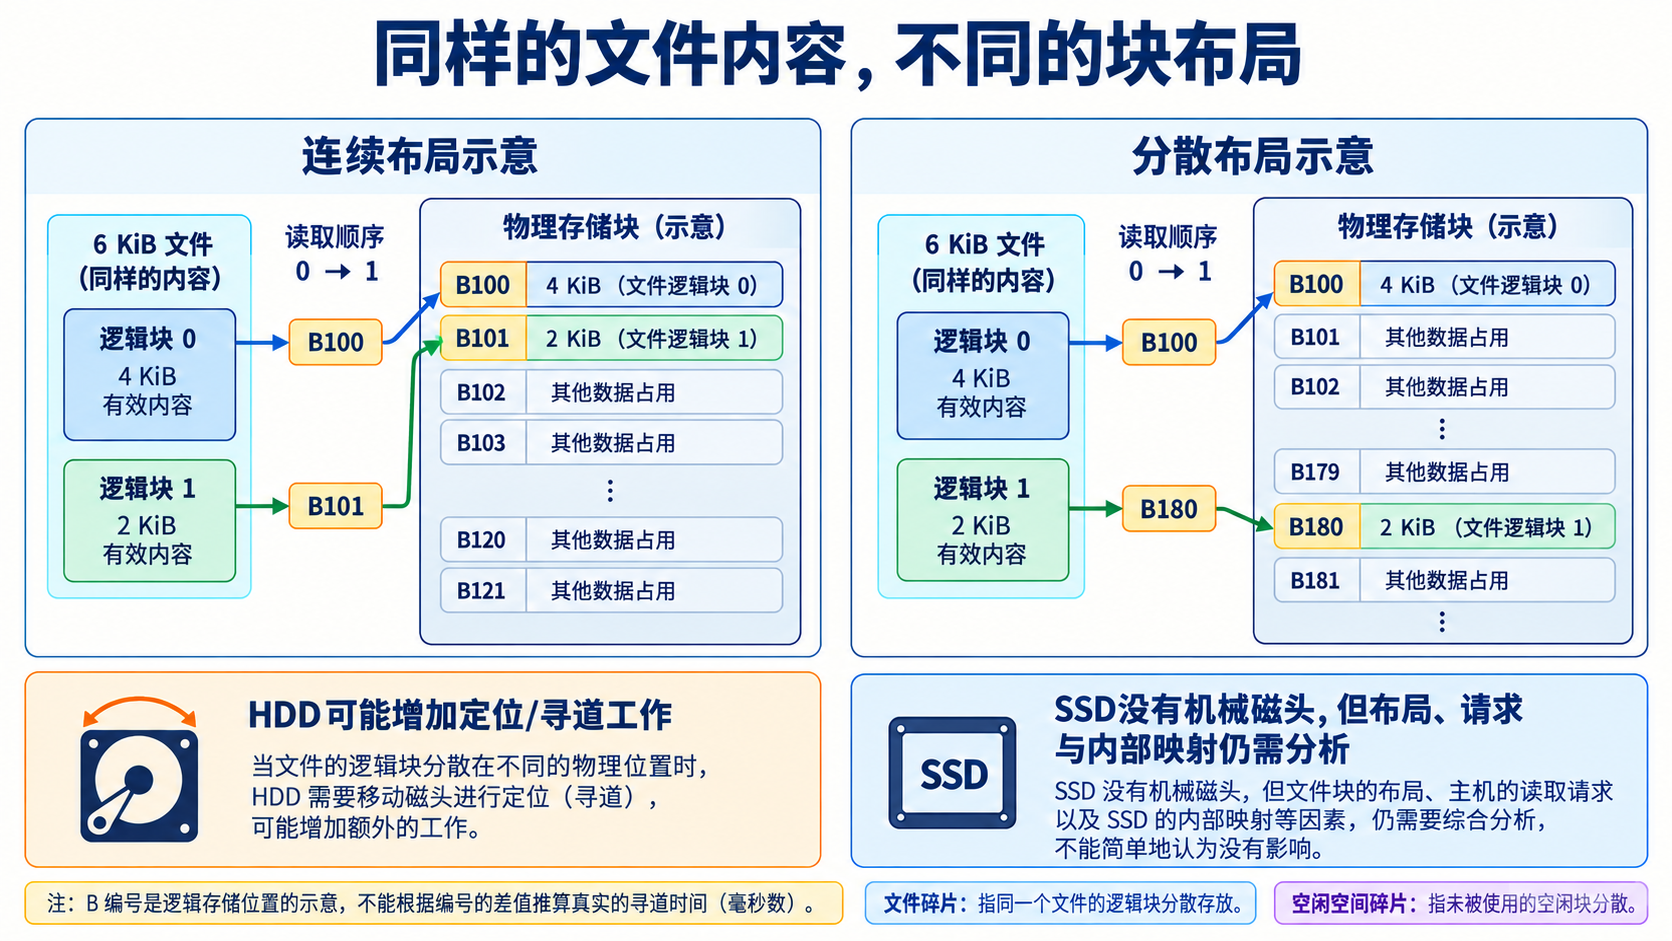
保持文件内容相同,只改变存放位置,并分开HDD与SSD成本。
分散不必然等于应用变慢
若内容已在页缓存,当前读取不需要设备定位,底层布局的影响可能暂时不显现。若文件本来随机访问,“相邻布局”也不一定产生与顺序读取相同的收益。布局优化还可能增加搬运与写入成本,所以不能在不知道设备与访问模式时,把整理碎片当作通用操作建议。
面试回答
布局决定文件逻辑内容对应哪些存储区域,文件碎片会使内容分散,空闲碎片则影响后续连续分配。HDD分散访问可能增加磁头定位与旋转等待,也可能需要更多请求;SSD没有机械寻道,需分析映射、请求及内部管理成本。碎片不等于数据损坏,逻辑编号差不能直接算耗时;页缓存和访问模式也会改变实际影响,不能无条件认为整理就更快。
5. 常见磁盘调度算法有哪些?
磁盘调度决定已排队请求的服务次序,经典HDD算法在移动成本、等待公平性之间取舍。下面用完全相同请求比较;数字只表示轨道移动量,不是实测耗时,也不是现代NVMe内部真实轨迹。
统一前提
轨道0~199,磁头从53开始,初始向较大轨道方向。请求按98、183、37、122、14、124、65、67到达,但开始比较时已全部排队。距离用相邻位置差的绝对值相加,循环返回也计距离,处理完最后一个请求即停止,不补算之后的空转。
到达优先与距离优先
FCFS按到达顺序:53→98→183→37→122→14→124→65→67。移动量为45+85+146+85+108+110+59+2=640。规则简单、请求不会被后来的短距离请求不断插队,但磁头可能反复跨越很大范围。
SSTF每次从尚未处理的请求中选离当前位置最近者:从53先选65,再选67,完整路径为53→65→67→37→14→98→122→124→183。移动量为12+2+30+23+84+24+2+59=236。在这个有限样本中全部能完成;所谓可能饥饿,是指持续有邻近新请求进入时,远处请求可能不断被延后,并非这8个请求会永远完不成。
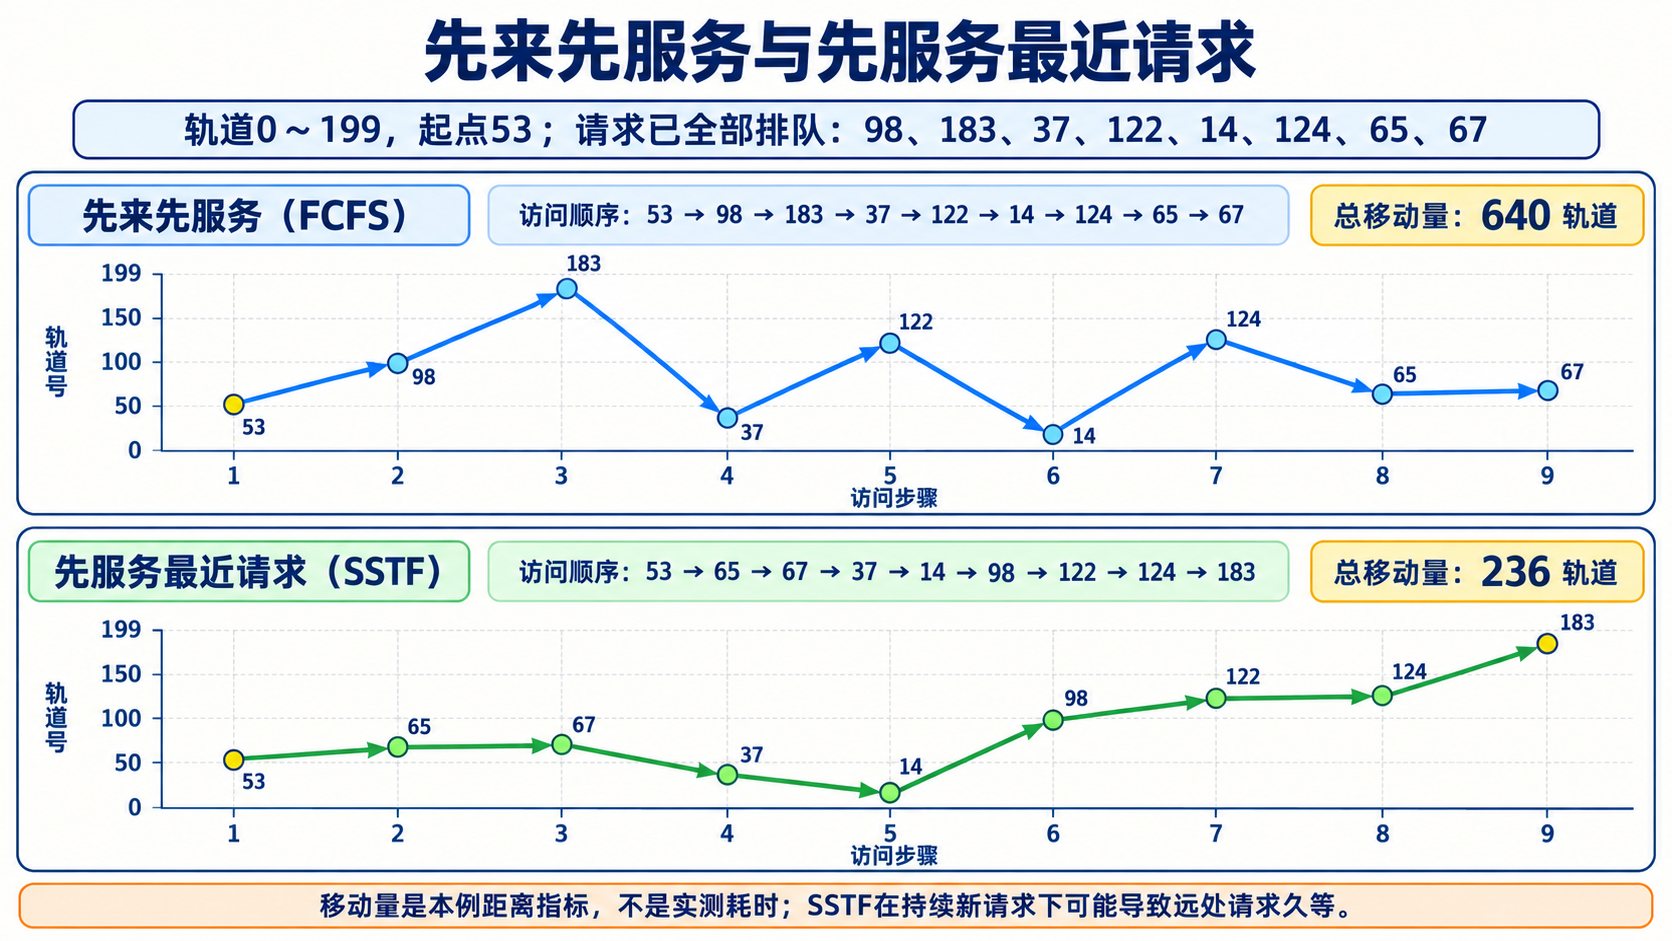
同尺度对照请求服务顺序,而非只比较两个总数。
维持方向,减少来回折返
SCAN像电梯:先沿当前方向服务,到设备边界再反向;LOOK则只走到该方向最后一个等待请求就折返。两者在本例都会先处理65、67、98、122、124、183,差别是SCAN继续走到199,而LOOK在183折返。
C-SCAN只沿一个方向服务,到边界后返回另一边,再继续原方向;C-LOOK将循环返回限制在两端等待请求之间,不必到设备边界。返回过程不服务途中的请求,但物理移动不是免费的瞬移。
| 算法 | 完整路径,起点与边界也列出 | 移动量 |
|---|---|---|
| SCAN | 53→65→67→98→122→124→183→199→37→14 | 331 |
| LOOK | 53→65→67→98→122→124→183→37→14 | 299 |
| C-SCAN | 53→65→67→98→122→124→183→199→0→14→37 | 382 |
| C-LOOK | 53→65→67→98→122→124→183→14→37 | 322 |
例如SCAN向上先移动199−53=146,再向下到14移动185,共331。LOOK为183−53 + 183−14=299。C-SCAN为146+199+37=382;C-LOOK为130+169+23=322。0、199是边界,不是额外请求。
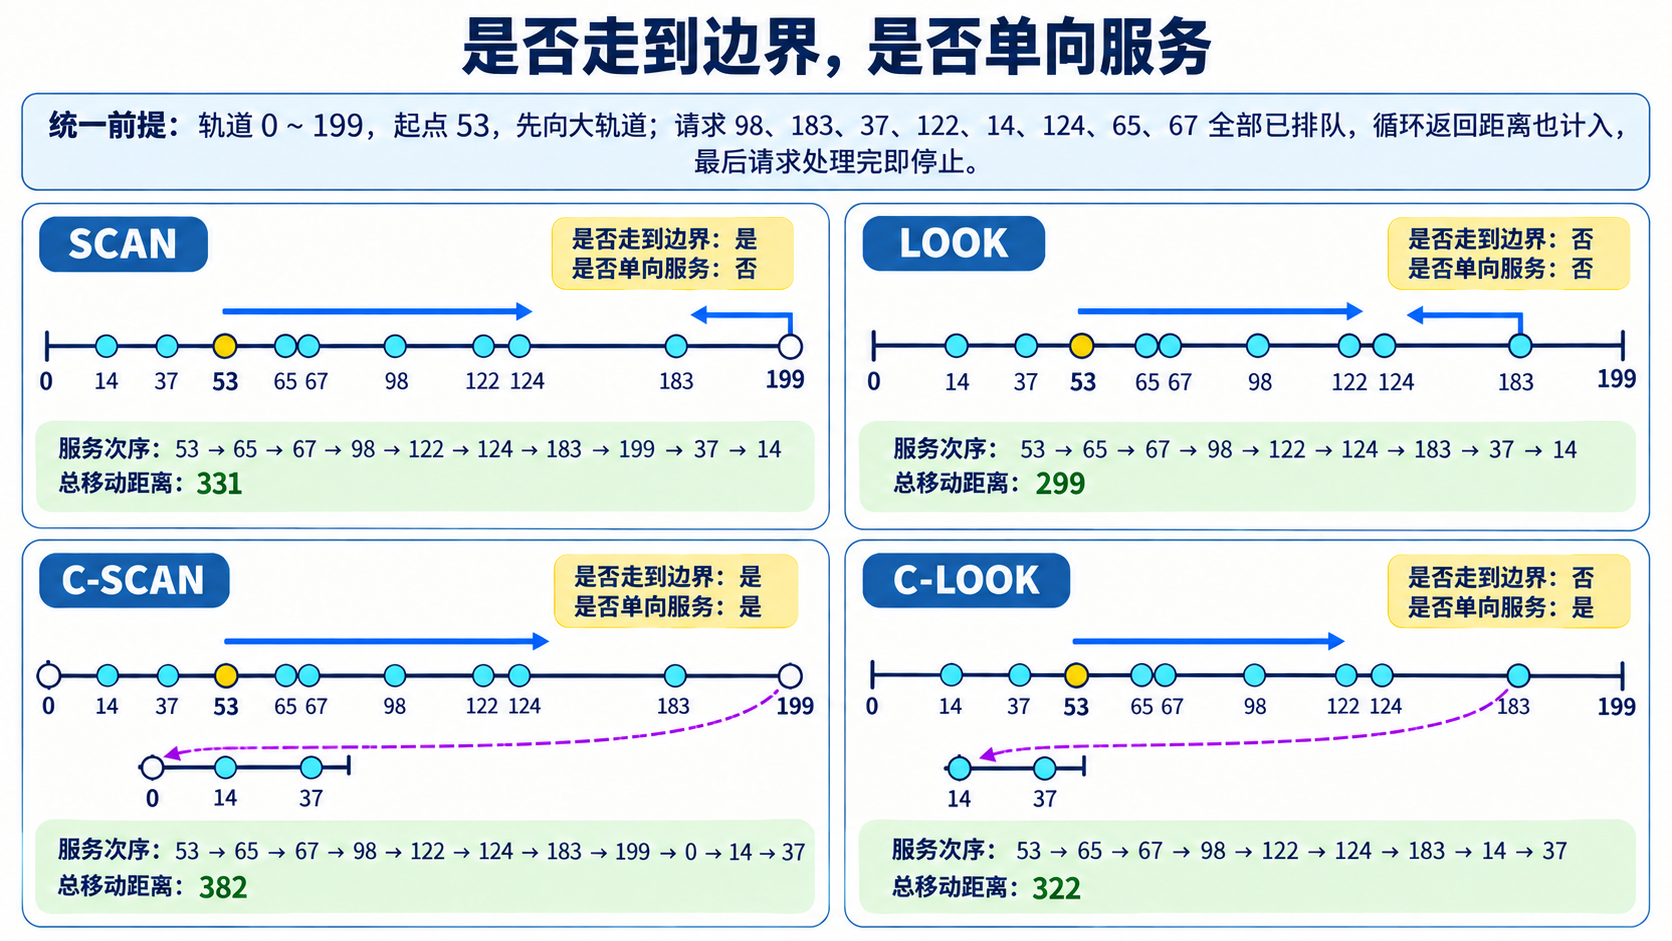
统一比较四种扫描策略,明确边界点与循环返回。
指标更小,不等于所有负载都最好
本例移动量最少的是SSTF,但真实需求还关心最长等待、响应时间、吞吐与服务公平。循环策略的目的也不只是压低一次样本距离,而是使不同区域的服务更均匀。经典磁头模型见OSTEP:磁盘调度;现代Linux块层还有多队列与不同策略,例如BFQ文档讨论公平和延迟,不应简化成“Linux统一采用SSTF”。
面试回答
FCFS按到达顺序,SSTF按当前距离最近,后者可能延后远处请求。SCAN到边界再反向,LOOK到最后等待请求就反向;C-SCAN单向服务并从边界循环返回,C-LOOK只在等待请求两端循环。它们在移动量与公平性间取舍,必须统一方向、边界和返回计费条件。轨道距离不是实际耗时,这些HDD模型不能直接当成SSD或现代Linux的完整调度实现。
6. 常见 RAID 级别有什么区别?
RAID把多块盘组织为一个阵列,主要通过条带、镜像或校验来分配数据和提供冗余。条带把不同块分布到不同盘,镜像保留副本,校验保留可用于恢复的信息;不同级别在可用容量、容错和读写成本之间取舍。
先分清数据、副本与校验
RAID0仅条带化,例如四盘分别放A、B、C、D,利用多盘容量与并行机会,却没有恢复副本,一盘损坏就可能破坏整个条带文件。
两盘RAID1把A、B等相同内容各放一份,总容量相当于一盘;任一盘失败后另一盘仍有副本。RAID5在条带内放数据与一个校验块,并把校验位置轮换到不同成员盘,不是固定一盘永远只放校验。
以4位玩具数据演示异或:A=1010、B=1100、C=0110,P=A xor B xor C=0000。B丢失时,A xor C xor P可恢复1100。这解释单故障恢复的信息来源,不表示校验是某份数据的原样复制。RAID6使用两组独立校验以支持双盘故障,第二组不是简单复制第一组。
在同容量盘条件下比较容量与容错
设阵列共有N块成员盘,每盘容量C,不计元数据与预留空间。下表RAID10限定经典“双盘镜像后跨对条带”,不涵盖所有扩展布局。
| 级别 | 典型最少盘数 | 理想可用容量 | 故障能力与代价 |
|---|---|---|---|
| RAID0 | 2 | N×C | 无盘级冗余;一盘失效可能破坏阵列数据 |
| RAID1 | 2 | 两盘镜像为C | 两盘模型任一1盘失效可继续;写入需维护副本 |
| RAID5 | 3 | (N−1)×C | 任一1盘;小范围写入可能需读改写数据和校验 |
| RAID6 | 4 | (N−2)×C | 任意2盘;维护两组校验,写入工作更复杂 |
| 经典RAID10 | 4,偶数 | (N/2)×C | 任一1盘,多盘取决于镜像配对;维护副本 |
对应图中四盘RAID0容量4C,两盘RAID1容量C,四盘RAID5为3C,四盘RAID6、RAID10均为2C。容量相同不代表行为相同,副本与校验的恢复、写入方式不同。组织原理见OSTEP:RAID。
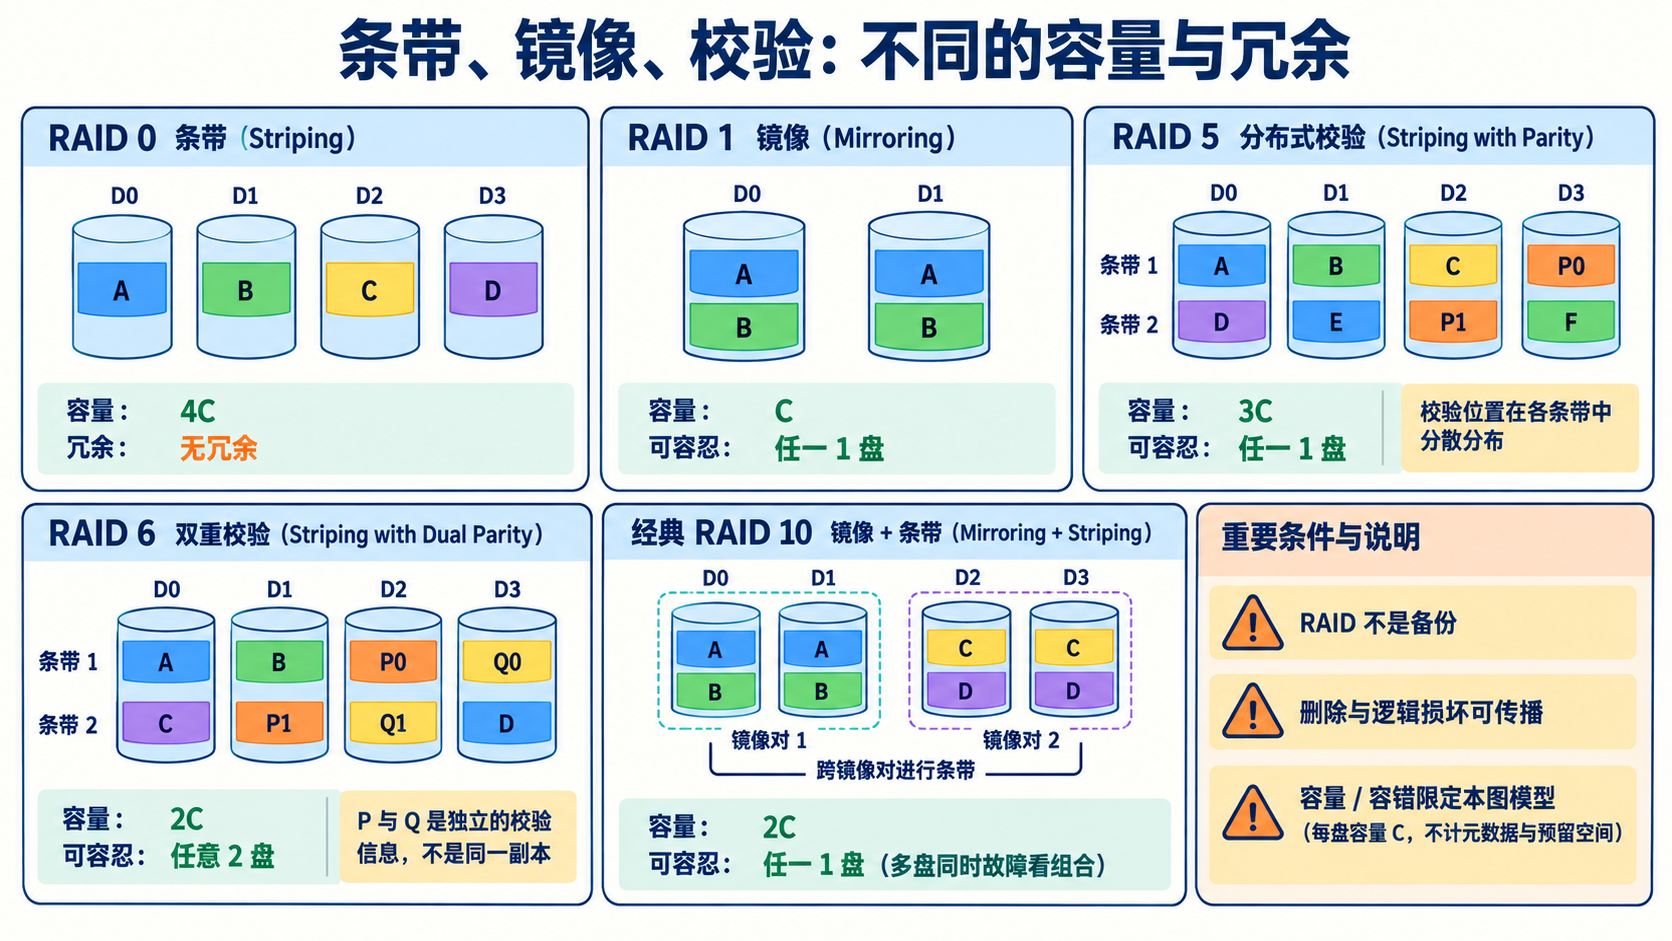
把具体布局与容量对应起来,突出校验分散与独立性。
RAID10坏两盘,为什么答案不固定
四盘镜像对为(D0,D1)、(D2,D3),前一对各有A,后一对各有B。如果D0和D2失效,D1还保存A、D3还保存B,可继续降级访问。如果D0和D1同时失效,A的全部副本丢失,D2、D3只有B,无法保持完整阵列访问。两次都坏两盘,结果取决于配对。
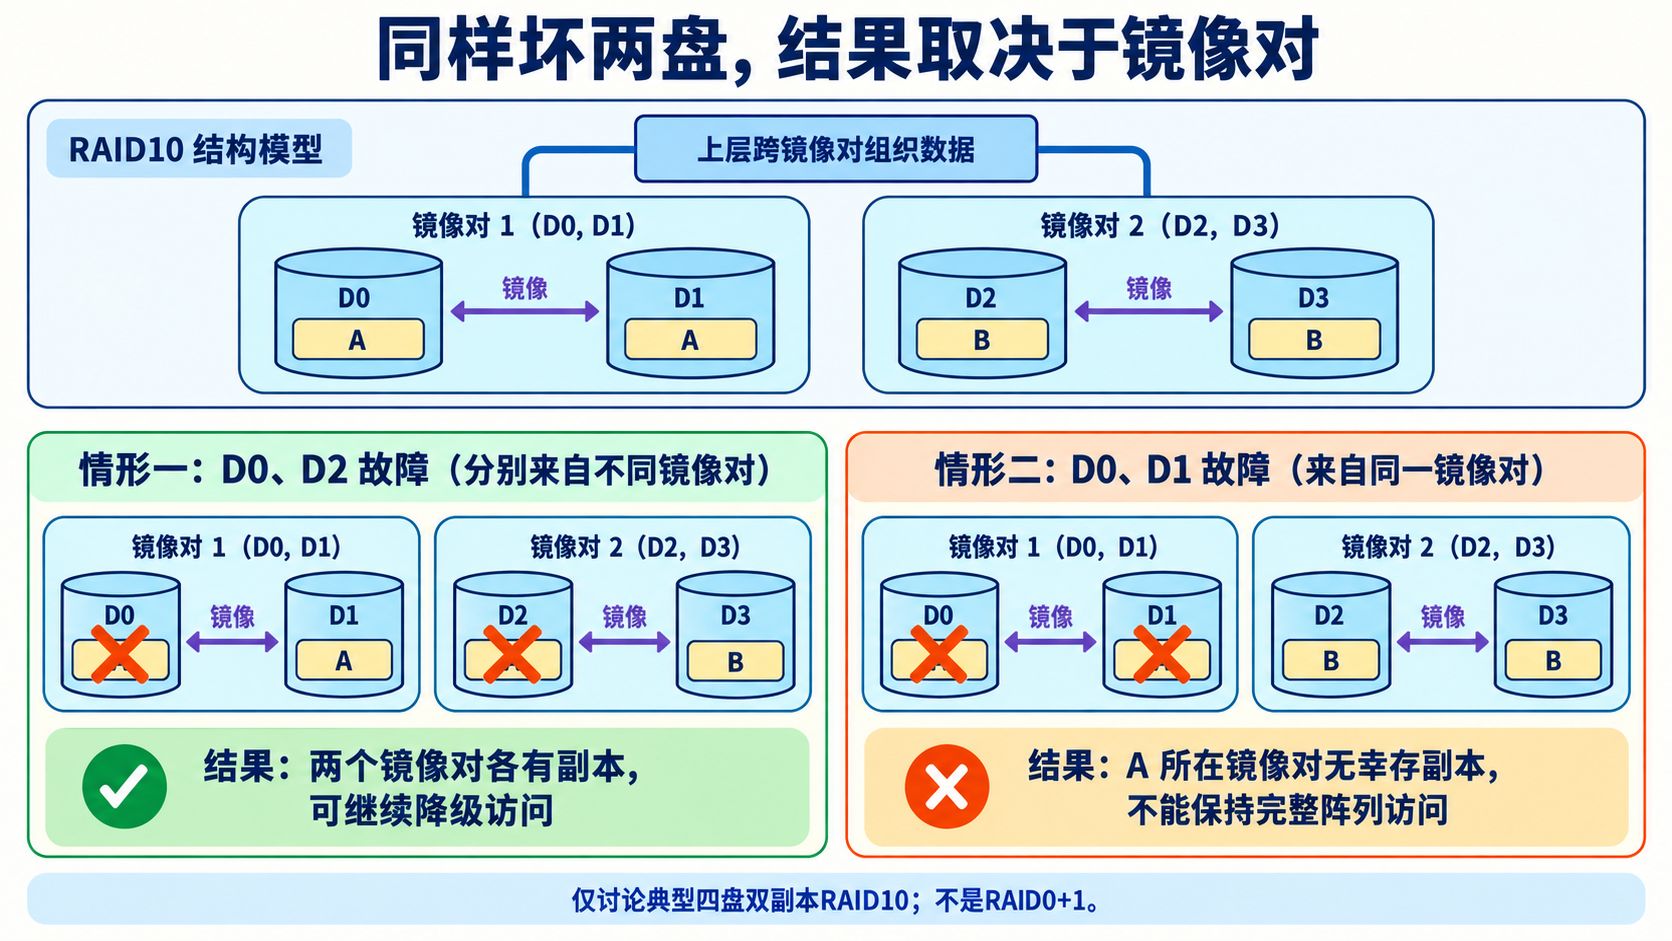
用固定镜像对比较跨对故障与同对故障。
降级运行仍有风险,重建还会占用I/O;冗余级别不保证固定性能倍数,也不保证并发故障、静默损坏或写入故障的全部后果都被消除。Linux md的具体布局与管理条件见Linux RAID文档。RAID不是备份:误删除、逻辑损坏或勒索修改可能同时传播到副本,需要独立备份和恢复验证,而不是只数有几块盘。
面试回答
RAID0做条带但无冗余;RAID1镜像;RAID5用分布校验容忍单盘故障;RAID6用两组独立校验容忍双盘故障;经典RAID10跨镜像对做条带。容量和写入成本因副本、校验方式不同。RAID10多盘故障能否继续取决于镜像对是否仍有副本,并非任意两盘都安全。容量公式需同容量盘等前提,降级与重建仍有风险,RAID也不能替代备份。
阅读导航
上一章:内存管理校招面试题|操作系统



