
C++ RAII 原理:析构、栈展开与资源释放
07 RAII 为什么是 C++ 资源管理的核心
有一种 bug 的排查过程极其消耗意志力:程序在某个完全无法复现的低频条件下偶尔崩溃,回溯栈指向的位置每次都不一样,内存使用曲线在监控面板上缓步爬升但永远找不到对应的泄漏点,测试用例全部通过但生产环境每周总有那么几次不明原因的服务降级。当你花了三天时间排除了并发问题、排除了硬件故障、排除了第三方依赖的降级影响之后,最终回到代码里逐函数审讨资源获取和释放的配对关系时,会发现问题不在某一个被遗忘的 delete 上——而是项目里有一百多处各自手写的获取-释放对,每一对在每一条控制流分支上是否配对正确完全依赖当初写代码的那位同事在那一刻的记忆状态和实践纪律。
手工管理资源的问题从来不是"程序员忘了"——忘了只是最终表现形式。真正的问题是手工管理把两条从根上应该绑定在一起的动作——获取和释放——放在了代码的两个不同位置,然后让程序员的记忆和测试覆盖来担保这两个动作之间的控制和顺序永远一致。当函数只有一个出口、没有异常时,这种担保几乎没有成本。当函数有三个出口、五个出口、十层调用深度、中间夹杂着四个可能抛异常的 C 库调用时,担保的成本从零飙到了不可持续。换个角度看,手工管理其实是在要求程序员在每一次写 new、malloc、open、lock 的时候,都在脑中预演一遍当前函数从这一点往后所有可能执行到的路径——包括那些尚未被写出来的、未来重构者将会插入的新路径——然后在每一条路径的终点上各自安放正确的释放语句。这不是一个人脑在工程规模下能够胜任的任务。RAII 要做的事就是把这两条动作重新绑回一个对象里——获取放进构造函数,释放放进析构函数——然后让 C++ 语言规则层面的作用域退出机制,而不是分散在代码里各处的手工释放语句,来确保每一次获取最终都对应一次释放。
为什么多出口是手工管理的天敌
在一个结构极简单的函数中——从顶到底一条直线,中间没有条件分支,末尾有一个释放——资源管理和执行流控制之间的张力几乎不可见。获取在开头,释放在末尾,中间的使用路径没有分叉,任何一个有基本代码阅读能力的人都能在五秒内确认这条释放语句是否总能被执行。但实际生产代码中很少有这种"单入口单出口干净线"的函数,更常见的形态是从获取点往下有若干条件分支——if (!valid) return;——每一个分支都是一个潜在的新出口,每一个新出口都需要在离开前释放当前已获取的所有资源。出口的数量直接影响着配对的维护成本:三个出口对应着释放逻辑在三个不同位置的各自一份副本,五条出口对应着五份。
void ProcessRequest(const Config& cfg) {
  Connection* conn = OpenConnection(cfg.host);
  if (!conn) return;

  Buffer* buf = AllocateBuffer(conn->max_size());
  if (!buf) {
    ReleaseConnection(conn);
    return;
  }

  if (!Validate(cfg)) {
    ReleaseBuffer(buf);
    ReleaseConnection(conn);
    return;
  }

  Execute(conn, buf);

  ReleaseBuffer(buf);
  ReleaseConnection(conn);
}
ReleaseConnection 在此出现了三次——在 buf 被分配之前的出口、在 buf 被分配之后但在 Validate 之前的出口、在函数末尾。ReleaseBuffer 出现两次——只在 buf 被分配之后的出口。这不是因为释放逻辑本身有多复杂,而是因为手工释放写在了每一个独立的控制流出口上,而一个资源被获取之后、函数结束之前的所有出口都必须各自记得释放这个资源。在这种结构下,如果有人后来在这个函数中间加了一个新的早退条件——比如 if (cfg.timeout_ms == 0) return;——他必须精确地判断出这个新出口处在哪两个资源的获取窗口之间,然后准确地释放当前已获取的全部资源。类型系统既不知道这个函数里有哪些资源正在被手工管理,也不知道释放的顺序是否和获取顺序一致,更不知道新加入的出口有没有漏掉某一条释放语句——所有这些一致性完全建立在程序员的头脑中。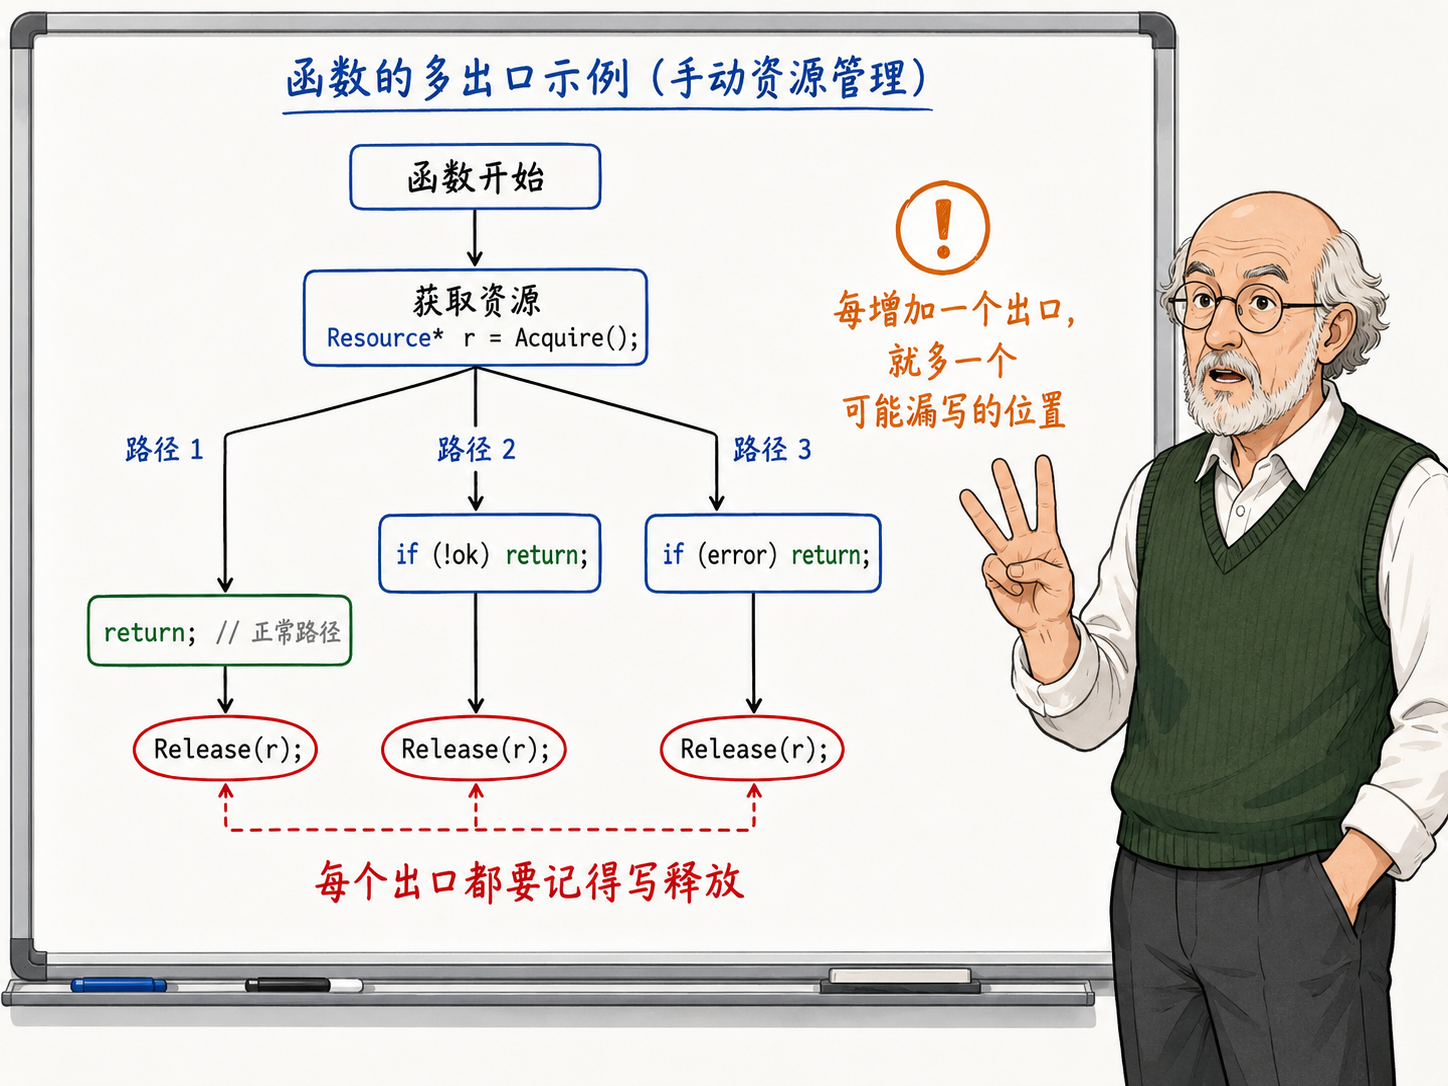
这种情况在同时管理多个资源的函数中会变得更麻烦。资源之间常常存在依赖顺序——buf 的分配需要用到 conn 提供的最大容量——因此释放顺序也不能是任意的:buf 必须先于 conn 被释放。每增加一个资源,出口上的释放组合就从简单的"N 选 1"变成"按顺序释放已获取的 M 个资源中的 N 个",而出错的可能性随着资源数量的增加而组合增长。更关键的是,这个问题在代码审查中几乎是透明的——审查者在看这个函数时,不太可能对每一个出口逐个验证释放组合是否完整,因为出口上的释放逻辑分散在函数的不同位置,没有集中到任何一眼可以覆盖的区域内。手工管理的脆弱性不在写代码的那个时间点上——那时候逻辑还在短期记忆里——而在后来的每一个修改点上,当修改者的注意力聚焦在新功能的行为而不是资源配对的一致性时。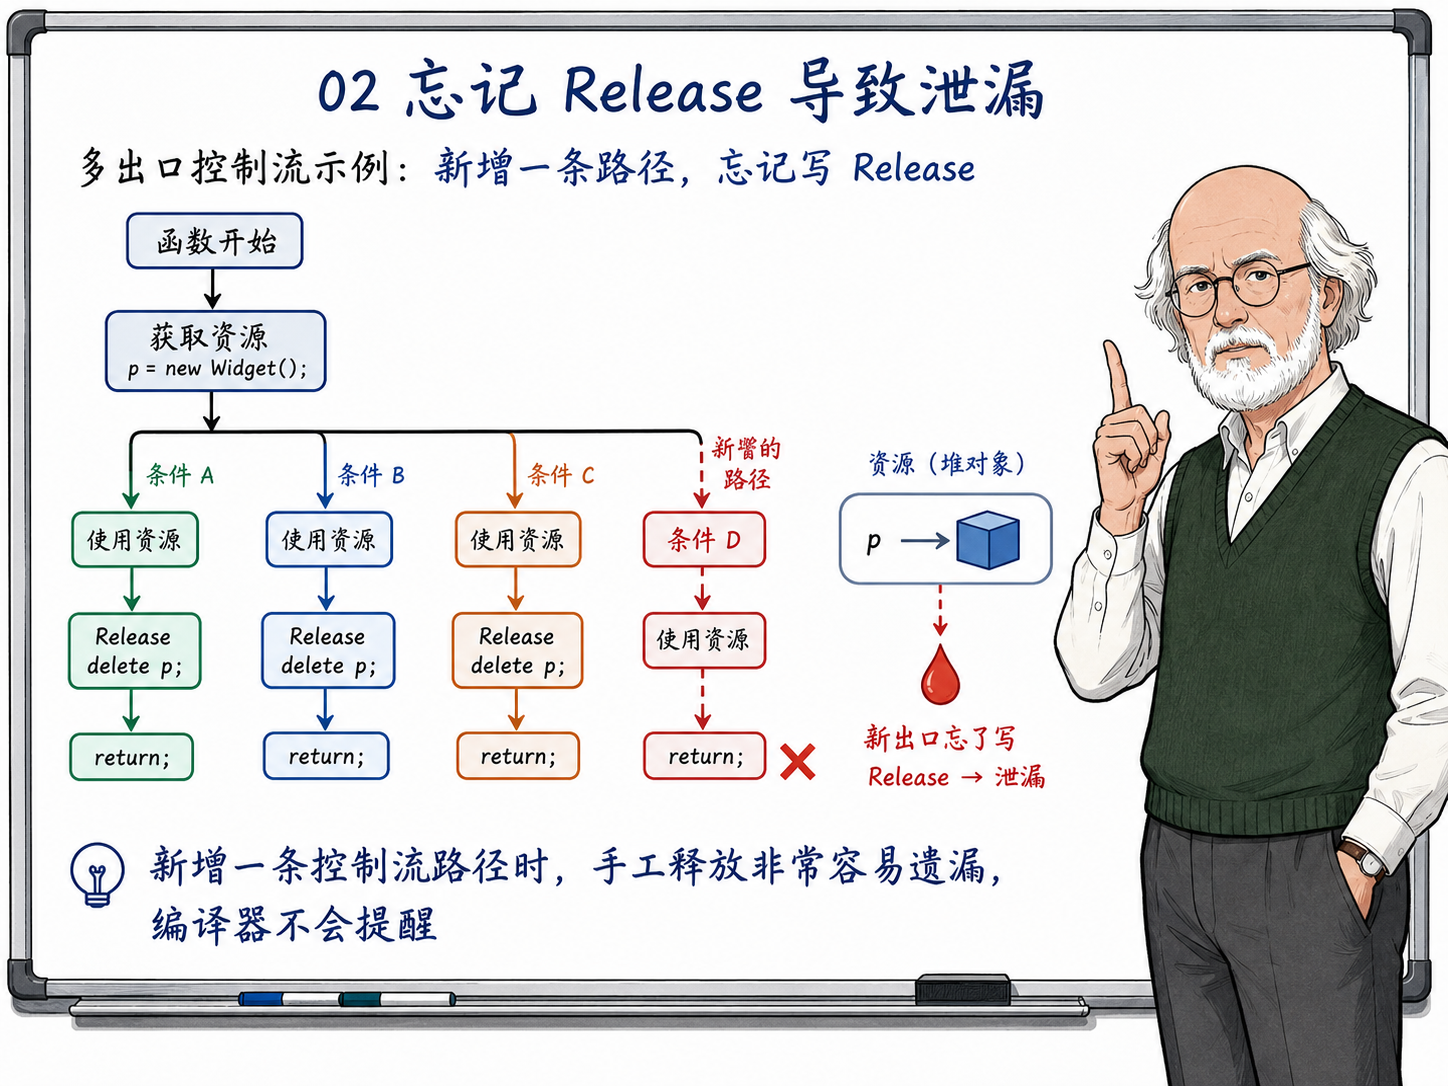
异常出口把这个脆弱性从"容易漏"推到了"写了也执行不到"。如果 Execute(conn, buf) 内部抛出了一个异常,函数末尾的那两行手工释放语句就在被跳过的代码区域内——异常沿调用栈向上传播,跳过当前作用域的所有残留语句。你想不出用纯手工管理来解决这个问题的方法:在每个可能抛出异常的调用后嵌入 try-catch 会把原本线性可读的业务逻辑碾碎成层层嵌套的异常处理块,而放弃处理意味着接受每次异常都是潜在的一次性的资源泄漏。手工管理在多出口上的困境,放到异常路径上就不再是"容易出错"而是"在路径上根本无法执行到释放语句"——这是两个不同级别的问题。
用析构函数把释放从"每个出口"变成"唯一入口"
RAII 处理这个问题的方式不是把释放写得更多或更小心——它把释放语句的位置从"每一个控制流出口的旁边"挪到了"析构函数里面",然后把析构函数的调用时机交给语言的作用域规则。析构函数不关心当前是通过正常 return、提前 return 还是异常传播离开作用域的——这些控制流差异对它来说不可见,它只在作用域退出的那一刻被调用,而那一刻一定会到来。
class ConnectionHandle {
 public:
  explicit ConnectionHandle(const std::string& host)
      : conn_(OpenConnection(host)) {}
  ~ConnectionHandle() { if (conn_) ReleaseConnection(conn_); }
  Connection* get() { return conn_; }
  ConnectionHandle(const ConnectionHandle&) = delete;
  ConnectionHandle& operator=(const ConnectionHandle&) = delete;
 private:
  Connection* conn_;
};

class BufferHandle {
 public:
  explicit BufferHandle(size_t size) : buf_(AllocateBuffer(size)) {}
  ~BufferHandle() { if (buf_) ReleaseBuffer(buf_); }
  Buffer* get() { return buf_; }
  BufferHandle(const BufferHandle&) = delete;
  BufferHandle& operator=(const BufferHandle&) = delete;
 private:
  Buffer* buf_;
};
这两个包装类的骨架是完全相同的:构造调用获取,析构调用释放,拷贝被禁掉(因为裸资源的所有权不应被隐式复制),移动可以按需实现。这个骨架在定义时写一次,之后在该类型的任何使用点上都不需要再写释放代码。当你把这两个类型放进实际函数中时,释放语句从源代码里完全消失了,函数回到了纯粹的业务逻辑形态:
void ProcessRequest(const Config& cfg) {
  ConnectionHandle conn(cfg.host);
  if (!conn.get()) return;

  BufferHandle buf(conn.get()->max_size());
  if (!buf.get()) return;

  if (!Validate(cfg)) return;

  Execute(conn.get(), buf.get());
}
这个版本的 ProcessRequest 有三个出口,但源代码里一个 Release 都没有。不是"不需要释放"——每次 return 触发作用域退出的那一刻,buf 的析构函数被调用然后 conn 的析构函数被调用,释放在这个不可见的瞬间自动完成——而是"释放已经不需要被每个出口各自记住"。你已经把释放的逻辑写在了 BufferHandle 和 ConnectionHandle 的析构函数里各一次,之后所有使用这两个类型的函数——不管是三个出口还是三百个出口——都不需要再为释放这两个资源写任何额外代码。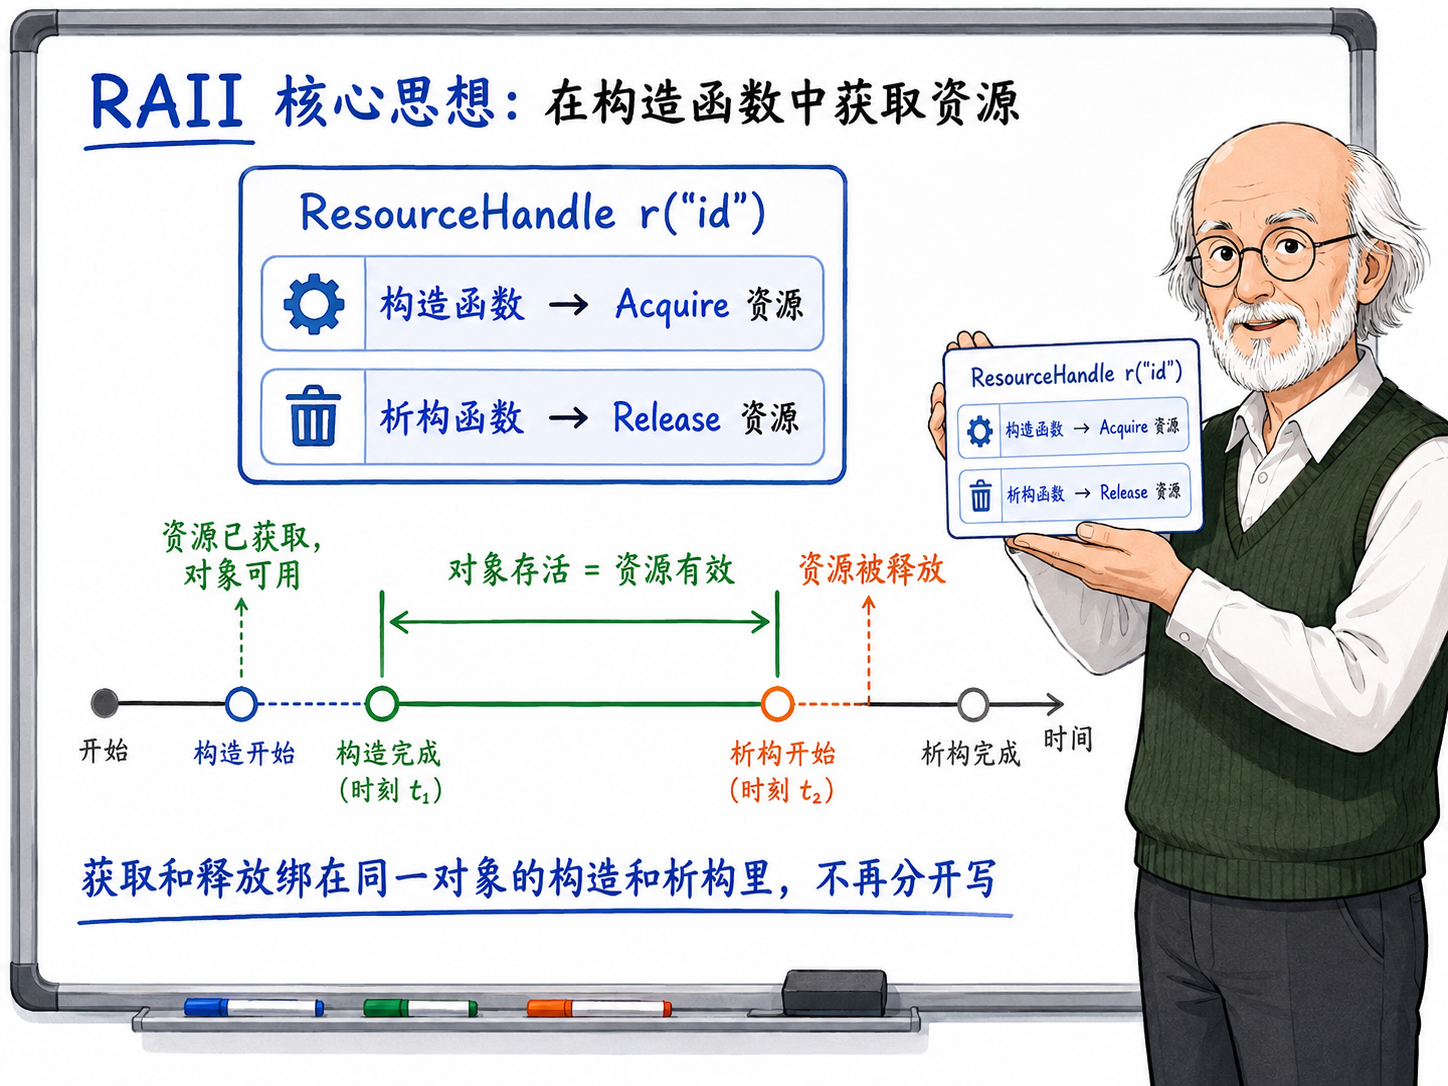
资源之间的依赖关系在 RAII 版本中由声明顺序自动维护。conn 声明在 buf 前面,所以 conn 先于 buf 构造,后于 buf 析构——buf 在整个存活期内都可以安全使用 conn 提供的数据,buf 析构时 conn 还活着。这个依赖顺序不需要在当前函数里做任何手工检查——声明顺序本身就把它编码进了代码结构里,而 C++ 的逆序析构规则保证了这个结构在运行时被严格执行。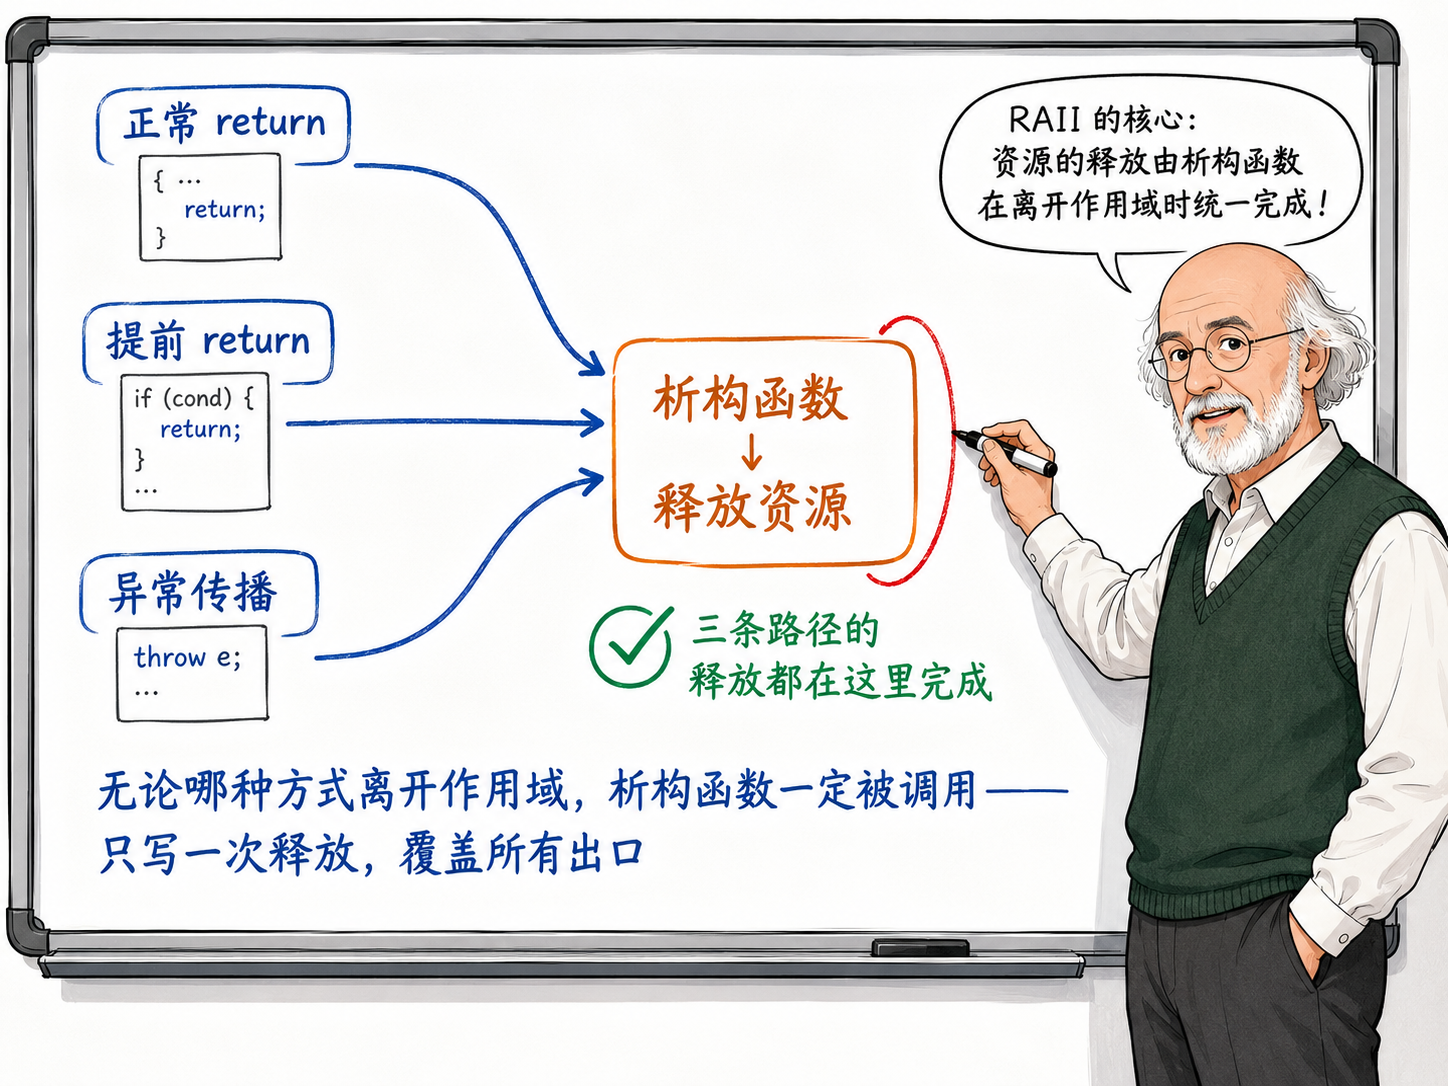
RAII 在一个层次上做到的本质上有三个层次:其一,释放语句不再堆在每个出口旁边——它只存在于析构函数的一个地方,所有出口通过析构函数的统一触发间接抵达。其二,依赖顺序由对象声明顺序表达,不再需要程序员在每一个出口上手工维护释放的组合和次序。其三,析构函数的调用是作用域退出机制的必然副作用,不受任何控制流分支的选择影响,因此不存在"这条路径上没有释放语句"的可能性。
栈展开:RAII 为什么连异常路径都不怕
RAII 在异常路径上的安全性不来自析构函数内部写了什么特殊判断——析构函数不知道自己是被正常的 return、提前的 return、还是异常传播调用的,也不需要知道。安全性来自 C++ 异常处理机制里的一条底层规则——栈展开(stack unwinding)——当异常被抛出后,运行时从 throw 点沿着调用栈逐层向上搜索匹配的 catch 子句,每离开一层作用域,该作用域内所有已完成构造的自动对象都会被逆序析构。
栈展开在每一个栈帧上的行为和前一章描述的"作用域退出时局部对象逆序析构"是完全同构的——唯一的区别在于作用域退出的触发原因,从"执行流自然到达花括号末尾"变成了"异常传播强制离开作用域",但析构函数的调用方式和调用顺序在两种情况下没有任何区别。当 A() 调用 B(),B() 中某处抛出异常且当前作用域和所有中间调用层都没有匹配的 catch 时,栈展开会先离开 B 的最内层作用域——析构 B 中已构造的局部 RAII 对象——然后离开 B 的函数体——析构剩余的局部 RAII 对象——然后退出到 A——析构 A 中已构造的 RAII 对象——以此类推,直到在某一层栈帧上遇到一个匹配的 catch 子句。在整个传播路径上,不需要任何一层作用域内的任何一行代码显式写 try-catch 来清理资源——栈展开机制从语言层面确保了这个清理一定会发生。
这种保证对工程实践最大的冲击是:你可以写一个函数,开头打开三个文件、锁住两个互斥量、分配几个动态缓冲作为局部 RAII 对象,中间调用任意多个可能抛出异常的第三方库函数,末尾一行清理代码都不写——不写 try-catch,不写 release,不做任何手工清理——然后相信当异常在任何嵌套深度被抛出时,所有被 RAII 覆盖的资源都会在栈展开的过程中被自动逐层释放完毕,就像有一条看不见的线程跟着异常的传播路径在收拣沿途的东西。这意味着你在写业务逻辑中的资源获取代码时,不再需要为当前这条执行路径上每一个可能被异常跳过的出口提前在脑子里规划清理顺序——RAII 已经把"异常路径上的资源正确释放"从"需要在每个异常点上游显式编写"的事变成了"在 RAII 类型定义时一次性编写,然后在所有异常路径上自动生效"的事。栈展开本身不关心你的资源是哪种内核对象——它只做一件事:检查当前栈帧上有哪些已完成构造的自动对象,然后逆序调用它们的析构函数。至于析构函数里面是 delete、close、unlock 还是 Destroy,对栈展开来说是完全透明的——它只是一条在离开作用域时必然会路过的门。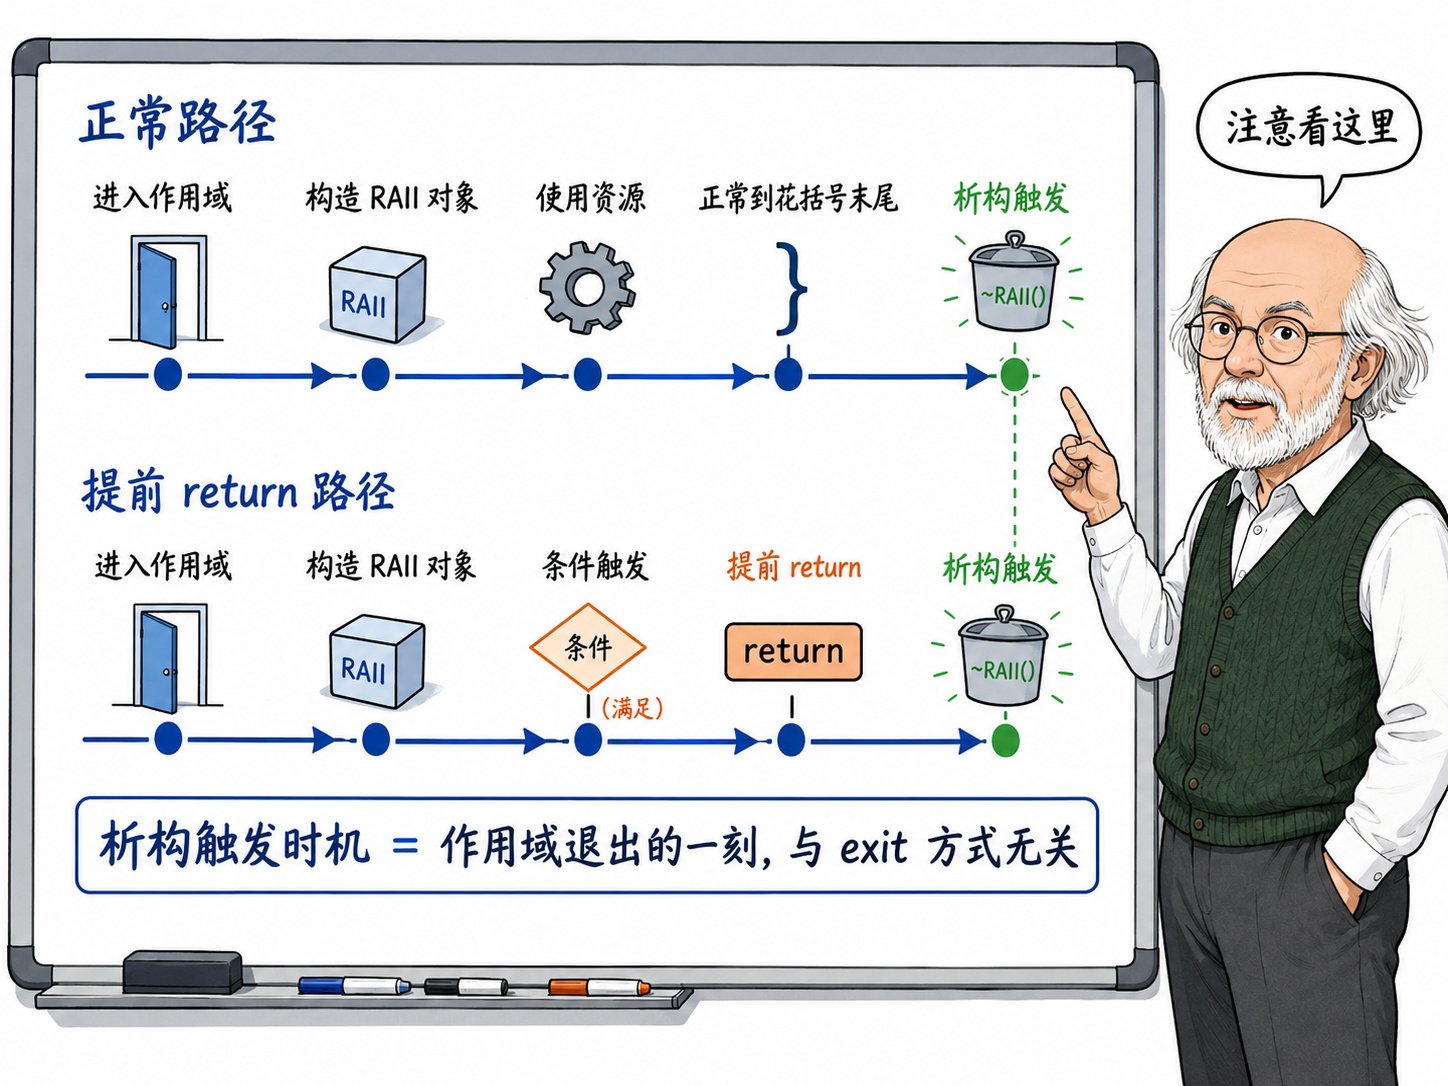
栈展开与 RAII 之间有一条需要精准掌握的边界:只有构造已经完成的 RAII 对象才会在栈展开中被析构。如果异常抛出的位置恰好在某个 RAII 对象的构造函数体内部——资源被部分获取但对象整体还没有完成构造——这个对象的析构函数不会被调用,因为标准规定析构函数的调用对象必须是已构造完成的完整对象,一个被异常中断在构造过程中的半成品不符合析构的前置条件。这就要求 RAII 类型的构造函数在设计上保持"全有或全无"的原子性:成功返回意味着所有内部资源已获取完毕;中途抛出异常意味着在构造函数内部应当确保所有已获取的部分资源已经被妥善清理。好在第 5 章详细论证过的"已完成子对象的自动逆序析构"恰好为此提供了自动化保障——只要每个子对象自身是正确实现的 RAII 类型,构造失败时已完成子对象的清理就是自动的,不需要手工介入。
在 C++ 社区里有一个经常被说反的因果顺序:不是因为 C++ 有异常处理机制,所以需要发明 RAII 来应对异常。事实是反过来的——因为 C++ 有 RAII,异常才能在不要求程序员在每个调用点嵌入层层 try-catch 释放代码的前提下成为一种可用的语言特性。在纯 C 或仅用 malloc/free 手工管理资源的代码中,异常要么意味着接受每次异常都是潜在的资源泄漏,要么意味着在每一个可能抛出异常的调用周围用 try-catch 包裹并手工释放所有已获取资源——两个选项都是工程灾难。正是 RAII 先提供了"析构函数在所有出口上必然执行"的保证,异常才能在不违背资源安全的前提下被广泛使用。异常安全不是 RAII 的附带收益——RAII 是异常安全的前提条件。
资源不只指内存——这句废话在工程中是排第一位的盲区
RAII 的讨论里最容易被一句话带过的部分是"资源不只指内存,还包括文件句柄、锁、socket 等"。这句话在绝大多数教材里就占一行——写完立刻转入用 new/delete 做例子的代码演示。一行的体量远远不足以承载这句话在工程中的实际重量。
堆内存泄漏的症状单调且无处可逃——监控面板上的 RSS 曲线持续爬升,超过阈值后进程被 OOM killer 干掉,排查者拿着 heapprofiler 追到某段代码里一个被遗忘的 delete,定位路径虽然长但方向是单向的。锁泄漏的症状则完全是另一副面孔——一个互斥量被获取后未释放,下一段需要同一把锁的代码会在完全无关的另一条线程上死锁,而死锁的现场在调试器里展现为"某个线程永远停在 pthread_mutex_lock 上",没有任何回溯线索指向那把锁最初是在哪里被获取的。文件描述符泄漏表现为"Too many open files"的系统级错误,但这个错误爆发的位置往往不是文件打开最频繁的那个模块,而是系统里碰巧触发 per-process 硬限制的那条 API 调用——很可能是一个和文件操作毫无关系的 socket 创建。数据库连接泄漏的症状随机性更强——连接池耗尽之后的新请求失败在一个甚至不直接依赖数据库的入口层,而真正的泄漏点埋在某个低频触发的异常分支里的一条数据库查询路径上。
这些不同资源类型的泄漏在各自环境下的表现形式和排查难度差异大得惊人,但它们的共同源头是完全相同的:获取和释放之间的对应关系被某条控制流路径破坏,而破坏者——无论是提前返回、异常传播还是被重构者无意间绕过——和资源的具体类型无关。RAII 对所有这些资源类型提供的是完全同一套保护机制:构造里写获取调用和错误检查,析构里写释放调用,包装完成之后,所有使用这个包装类的代码都自动获得了多出口和异常路径下的安全保障。你用同一个 RAII 骨架包了一个 TCP socket 和一个 CUDA 流句柄,在调用方那边这两者的释放行为是完全统一、完全不需要被区别对待的。
这种统一性有一种容易被低估的间接收益:当你把项目中所有类型的资源都封装进了各自的 RAII 包装类型之后,资源管理正确性的代码审查负担就从"对每个函数的每条控制流分支逐一检查获取-释放配对"降到了"对每种 RAII 包装类型在引入时审查一次其构造和析构的逻辑是否完备"。前者随着函数数量和控制流复杂度的增长而线性发散,后者只在每种新资源类型被引入时产生一次固定的审查成本。项目中引入新资源类型的频率远低于函数中新增控制流出口的频率——在 RAII 体系下,成本曲线从发散变成了收敛。
RAII 包装类在正确实现之后还有一个不易察觉的安全特性:资源获取失败时的自动清理。如果构造函数的初始化列表或函数体中抛出了异常,而该 RAII 对象的某些成员已经在异常点之前成功构造,那些成员的析构函数会被自动调用——这就是第 5 章详述的已完成子对象逆序析构规则在 RAII 场景下的直接作用。你不需要在 RAII 包装类的构造函数里针对"获取到一半失败了怎么办"手工写补偿清理逻辑——只要把每一种子资源各自封装成独立的 RAII 成员(例如把裸指针升级为 unique_ptr,把裸文件描述符升级为 fstream),组合而成的上层 RAII 对象在构造失败时就自动执行了正确的逐层回滚。这也正是为什么第 6 章强调的 Rule of Zero 和 RAII 之间存在共生关系——Rule of Zero 让你不写特殊成员,RAII 让你在构造失败时仍能自动清理——而这两个机制共同依赖的底层基础就是 C++ 的逆序析构和构造失败补偿规则。
标准库只是把同一个骨架套在了不同的资源上
当你同时在代码里写 std::string s("hello")、std::vector<int> v(100)、auto p = std::make_unique<Widget>() 和 std::lock_guard<std::mutex> lock(mtx) 时,你不需要——也确实不应该——去逐一回想每种类型各自的释放机制是什么。std::string 释放字符缓冲区,std::vector 释放元素存储区,std::unique_ptr 对其管理的对象执行 delete,std::lock_guard 解锁它所持有的互斥量。四个释放在底层操作着四种完全不同的系统资源——堆内存、另一块堆内存、一个对象的独占所有权、操作系统的互斥锁——但在你的代码层面它们共用完全同一条接口约定:构造获取,析构释放。这条约定不是这四个类型在各自文档的角落里偶然写出的巧合,而是 RAII 作为设计模式在标准库的多个子系统上被统一部署的结果。
std::fstream 管理文件——构造时打开(可选),析构时关闭——函数从任何一个出口返回时文件被自动关闭,你不需要在 return 之前手工调用 close()。std::jthread(C++20)在构造时创建线程句柄,析构时自动 join 或 detach,让线程生命周期也一并受 RAII 支配。std::shared_ptr 的构造参与了共享所有权的引用计数,析构递减计数并在归零时销毁托管对象——比单纯的"析构时 delete"多了一层引用计数的间接逻辑,但骨架仍然是 RAII:构造获取(一次共享所有权),析构释放(退出共享,最后一个退出者执行销毁)。标准库以同一个骨架覆盖了从堆内存、字符缓冲、动态数组、互斥锁、文件句柄、线程句柄一直到共享生命周期管理的动态对象的全部基础资源类型。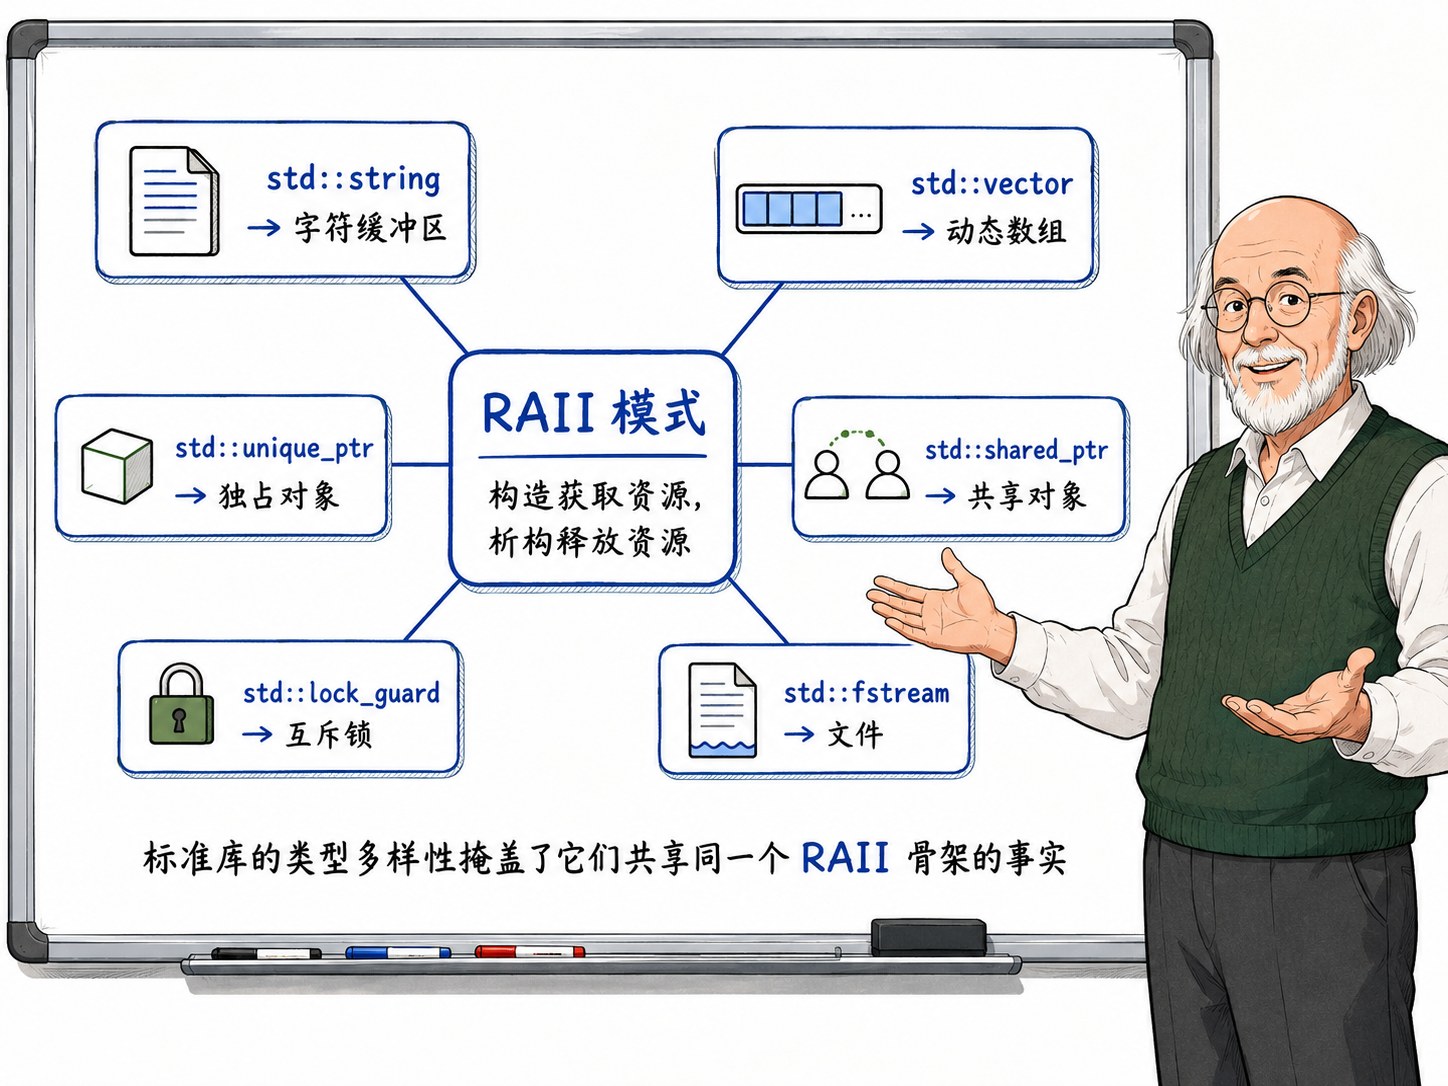
对调用方而言,这种全类型一致的安全意味着你可以在同一段代码里组合多种完全不同的 RAII 类型,而不需要逐件协调各自的释放时机。函数开头锁住互斥锁(std::lock_guard),分配一个临时动态数组(std::vector),从配置文件读入路径(std::string)——当函数从任何一个出口退出时,锁、数组缓冲和路径字符串的堆内存都经由同一套逆序析构被归还,释放的顺序由声明顺序决定,释放的正确性不需要在这段代码的任何一行进行额外的显式检查。程序设计阶段也不再需要为每一种新引入的资源种类单独设计独立的释放策略——只要该资源被正确封装进一个 RAII 包装的类型里,它的释放就自动纳入与所有已有资源完全相同的析构保障体系。
标准库 RAII 类型的覆盖范围在 C++11 之后持续扩大。第 6 章 Rule of Zero 的讨论中已经从"类不需要手写特殊成员函数"的角度提过这一趋势,从 RAII 本位的角度值得再总结一次:C++11 以前,程序员连一个标准的互斥锁 RAII 包装或独占所有权的智能指针都需要自行手写或从第三方库引入,那个时代手工管理资源的比例之所以居高不下,不是因为当时的人喜欢手工控制,而是因为标准库提供的 RAII 类型覆盖面太窄了,窄到连最基础的动态对象所有权和互斥锁保护都需要自己封装。C++11 补上了 unique_ptr、shared_ptr、lock_guard,C++14 补上了 std::make_unique,C++17 补上了 scoped_lock,C++20 补上了 jthread。到了今天,一个新写 C++ 项目中需要用 Rule of Five 亲手管理裸资源的类理应是极少数——它们应该集中在与 C 接口对接的平台特定封装层,标准库已经管好了覆盖绝大多数通用场景的基础资源类型。
需要清醒认识的一点是,标准库的 RAII 覆盖面虽然已经非常广,但不可能覆盖每一种操作系统平台、每一种第三方 C 库、每一种硬件驱动包里独有的资源类型。当你遇到一个标准库没有覆盖的资源类型——比如 GNUTLS 的会话句柄、libcurl 的 easy handle、Windows 的 HANDLE、CUDA 的流对象——你只需要给它写一次 RAII 包装:一个构造函数封装获取逻辑和错误检查,一个析构函数封装释放逻辑,然后按照此资源的所有权语义决定拷贝和移动是被禁止还是需要实现。这个包装类就是你项目中连接这个外部资源类型和 C++ RAII 体系之间的唯一桥梁。写完之后,这个资源在剩下的全部使用场景里就和其他标准库 RAII 类型共用同一条安全保障——析构函数在一切出口上必然执行,逆序析构自动维护资源依赖顺序,栈展开在异常路径上覆盖所有已构造对象。RAII 在这类场景中不是一个理论上的设计模式——它是把外部 C 接口的资源一下子拉进 C++ 安全体系里的实际入口。
RAII 不是技巧之一,而是所有资源管理策略的容器
第 4 章到第 6 章的结论全部摊开之后,RAII 就不再是需要额外记忆的一条独立规则,而是那些分散结论的顺畅汇聚。第 4 章把 new/delete 拆成了分配、构造、析构、释放四个独立动作,证明了手工管理要求程序员在代码的不同位置分别调用这四个动作,而各动作之间的配对正确性只存在于程序员的记忆里。第 5 章证明了析构函数在一切正常的代码退出路径上——正常 return、提前 return、异常传播——都会被无条件触发,且触发顺序在所有对象层级上严格遵循后构造先析构。第 6 章证明了当类开始手工持有资源时,五个特殊成员函数必须在同一张设计图里审视,同时也证明了让标准库 RAII 类型承接资源管理——Rule of Zero——是这五个函数在设计层面最经济的决策。
把这三条结论拼在一起:析构函数覆盖所有出口 → 把释放写在析构里。构造可以完成复杂初始化和资源获取 → 把获取写在构造里。五个特殊成员函数的行为和资源所有权深度耦合 → 不要让类直接裸管资源,把资源所有权集中到标准库已经实现好的 RAII 类型里,自己的类不写特殊成员函数。RAII 在这条推导链里扮演的不是"又多了一个新概念需要背",而是对前述全部分散结论的一次系统性重组——把各自独立被证明正确的规则(析构的确定性、构造和析构的对称性、逆序析构的层级一致性、Rule of Zero 的经济性)装配到了一起,得到了一个可以提炼为"资源跟着对象走,对象析构资源就析构"的完整管理框架。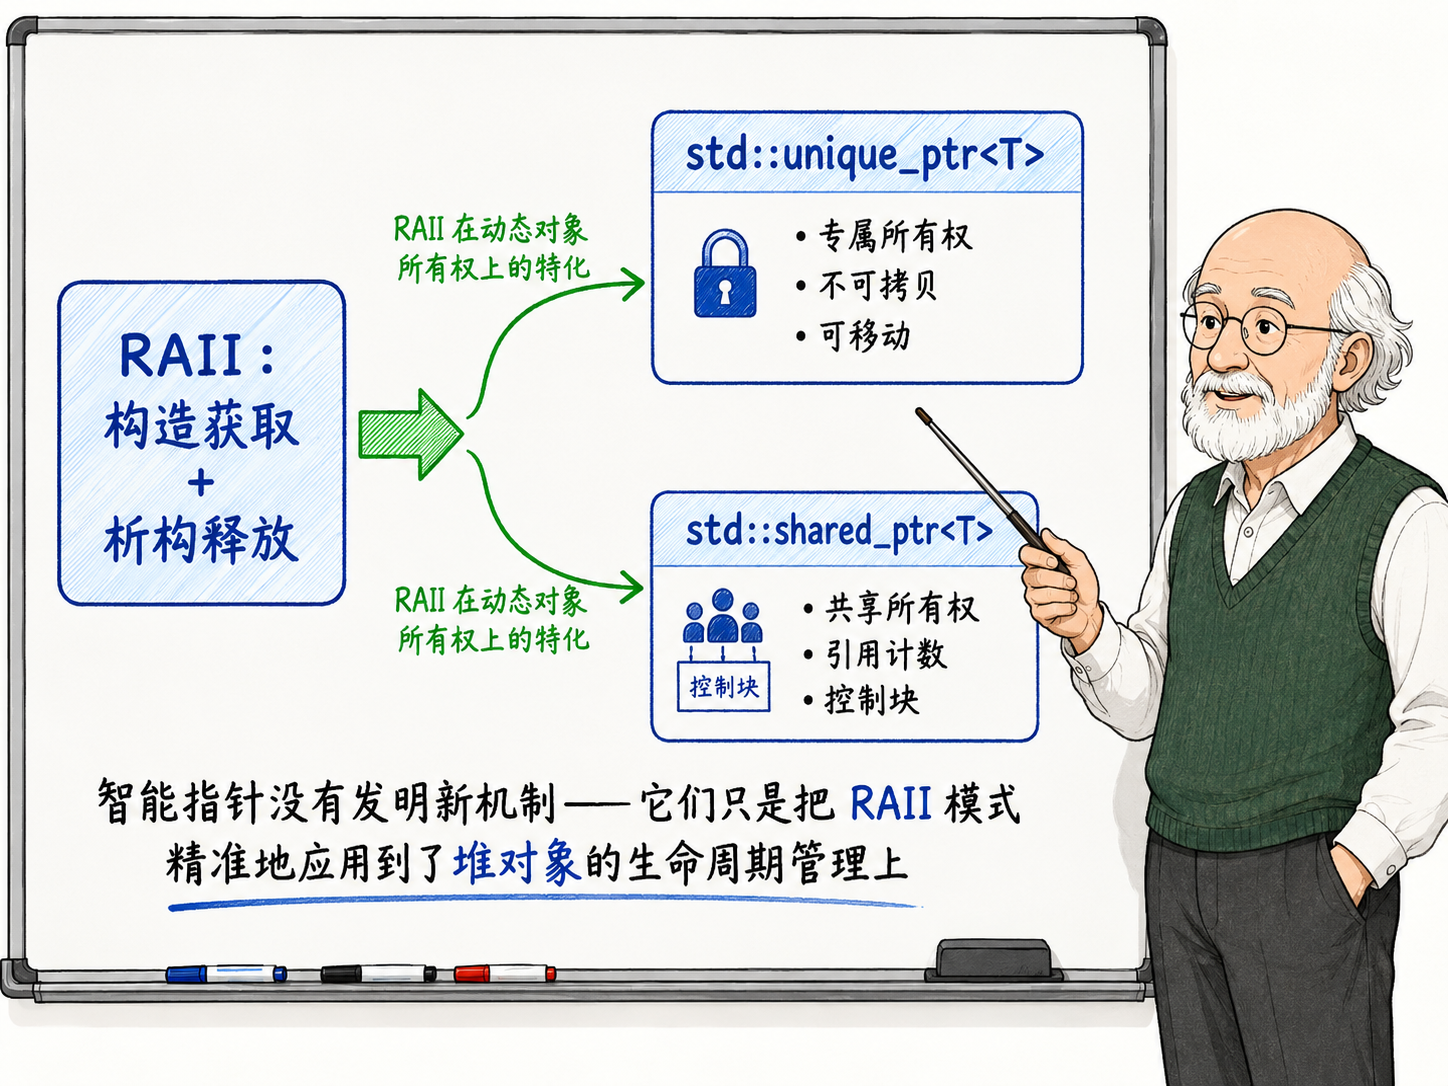
在这个框架下再面对第 8 章和第 9 章的智能指针,它们就不会再让你觉得是"两个需要从零开始学习的新工具"——它们只是 RAII 在动态对象所有权上的两个参数化应用。std::unique_ptr 就是 RAII + 独占所有权 + 禁止拷贝 + 允许移动:构造时接管裸指针的释放责任,析构时销毁所管对象,不允许多个 unique_ptr 共享同一个对象。std::shared_ptr 就是 RAII + 共享所有权 + 引用计数 + 控制块:构造时加入对象的所有权组并增加计数,析构时退出该组并递减计数,在归零的瞬间销毁对象。两者的骨架和 std::string、std::vector、std::lock_guard 的骨架完全同构——构造获取,析构释放——差异只在"获取"和"释放"在两种不同所有权模式下的语义:一个是独占转移,一个是共享计数;一个是禁止拷贝允许移动,一个是拷贝即增加计数、移动即转移计数。本质是同一个 RAII 原语在不同所有权场景下的不同外沿配置。
RAII 被反复讲了这么多年,不是因为它属于 C++ 社群的某种审美偏好。它是 C++ 的语言规则体系——确定性析构、逆序销毁、栈展开——所提供的唯一一种能把资源释放的正确性从"依赖程序员在每一次使用时的正确手工纪律"转化为"依赖编译器在每一次作用域退出时的机械执行"的组织形式。当你把一种资源的获取和释放正确地封装进一个 RAII 类型的构造和析构里之后,这个资源在所有使用场景下的释放就由编译器接手了——不需要单元测试覆盖所有出口,不需要代码审查逐出口确认释放组合,不需要生产监控面板去寻找那条在黑暗中悄悄泄漏的低频路径。责任从人的记忆里移到了语言的机械规则里——这就是 RAII 为 C++ 资源管理体系提供的根本价值。
阅读导航



