
C++ 容器选择:访问模式、地址稳定性与性能验证
09 容器选择看访问模式,不看习惯
很多团队有自己默认的容器选择习惯:"字符串数组用 vector,需要查找就用 map,频繁增删用 list",这些口诀在特定条件下成立,但把它们当成普适规则,你会做出不少让自己事后挠头的决定。比如:一个最多 200 个元素、每秒钟遍历一次的小数组用了 list(遍历时缓存性能极差),一个按键查找极其频繁但输出不需要排序的系统用了 map 而不是 unordered_map(每次查找都多付了对数因子的代价),一个只需要顺序遍历但被习惯性套用了 deque 的队列。
容器选择的核心问题是"我的程序到底在对这些元素做什么"。本章不提供新的容器知识,前八章已经拆解了每种结构的内部机制、复杂度和失效规则。本章的任务是把这些知识拧成一套可操作的判断方法,让你在面对新需求时,从访问模式、修改模式、查找需求和稳定性需求出发,推导出合适的容器。
为什么口诀经常骗人
"频繁插入删除用 list"是流传最广的口诀,也是最有误导性的。它把一个包含前提条件的结论简化成了一条绝对规则,而那个前提条件,你已经拿到了要插入或删除的位置,在实际代码中经常不成立。
如果你每次插入前都要先找到位置,那么在 vector 上就是"查找 O(n) + 搬动 O(n) = O(n)",在 list 上就是"查找 O(n) + 插入 O(1) = O(n)"。两者的渐进复杂度一样,但 vector 的查找是连续内存上的线性扫描(缓存友好),list 的查找是节点间的随机跳转(缓存不友好)。在 N 不大的情况下,vector 的总耗时经常比 list 短。这不是理论推演,是大量实际测量验证的结果。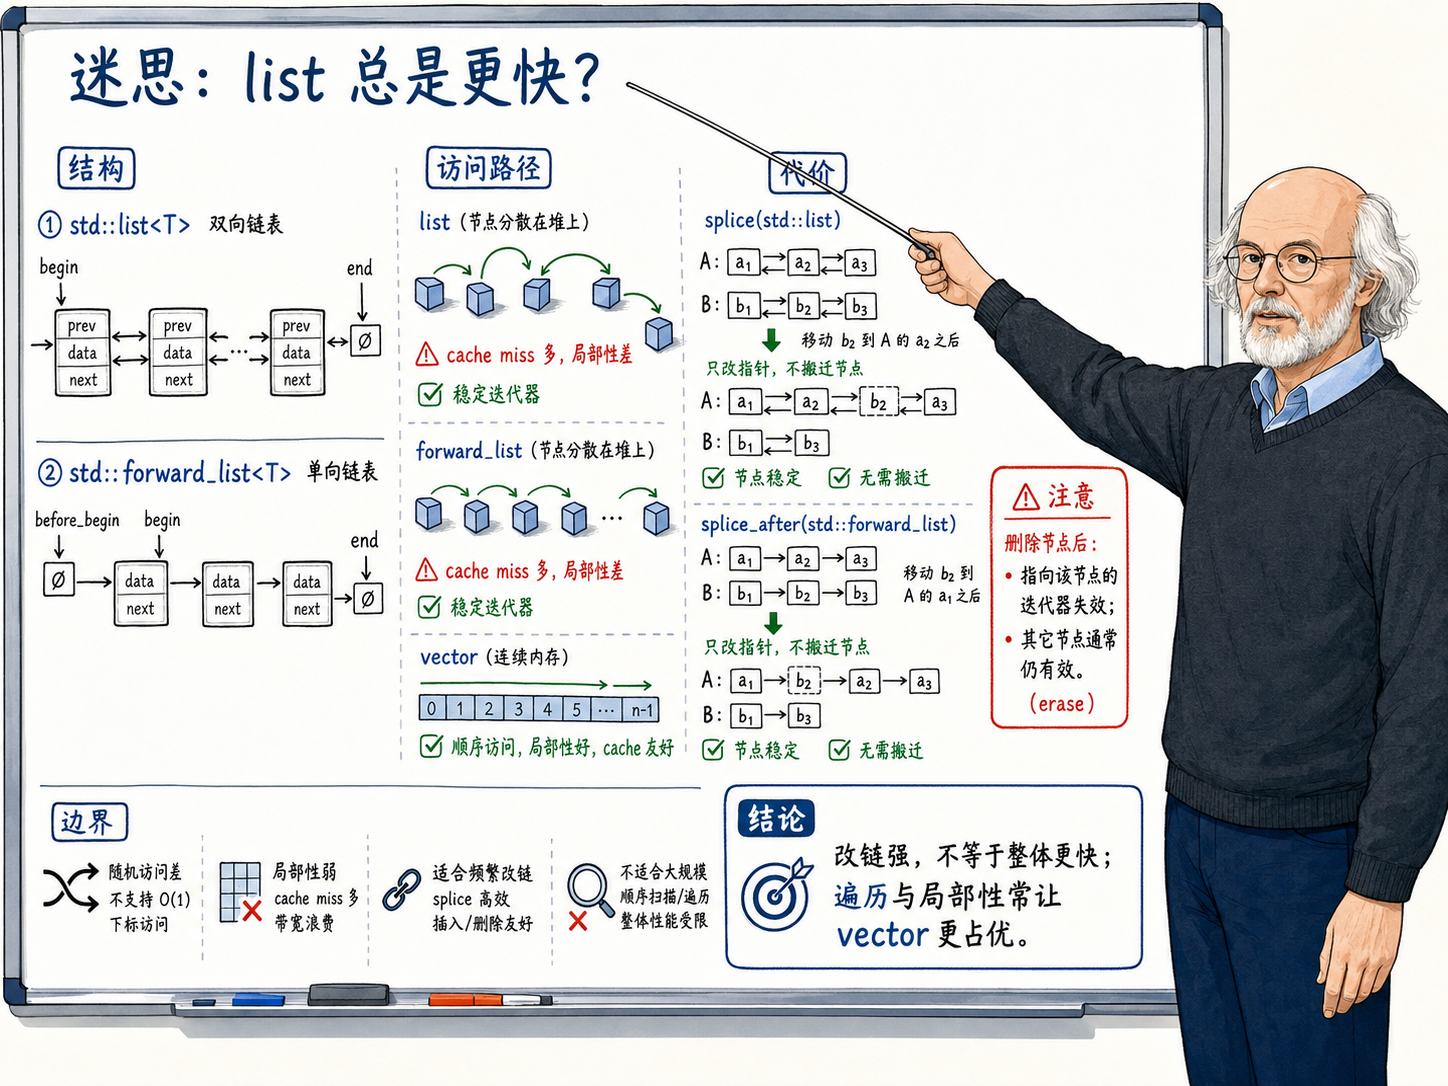
"查找用 unordered_map"同样需要补充前提:键类型有高质量哈希函数,负载因子保持合理水平,不存在攻击性输入。如果键是一个复合类型而你用了一个简单的 XOR 哈希,碰撞率可能极高,O(1) 退化到接近 O(n)。如果你需要按键范围查询,unordered_map 根本做不了,只能遍历全表再逐一过滤。
"有序遍历用 map"是对的,但如果你只需要一次有序输出,把数据放在 vector 里最后 sort 一下,总时间经常比在 map 中逐个按树插入快(同样,缓存在连续内存上的优势)。map 的价值在于需要持续维持有序状态,数据在不断变化,而每次查询都需要按键序结果,这时 vector+ 频繁 sort 的总成本就远远超过 map 了。
这些口诀的共性问题是:它们把"操作类型"当作唯一决策因子,忽略了数据规模、操作频率、是否需要稳定引用、内存布局代价这些同等重要的维度。
五个问题,顺序不对答案会错
每次面对一个新的数据集合,问自己五个问题。顺序很重要,前面的问题会排除大范围的选项,让后面的选择空间变小,判断更精准。
第一问:元素有多少?以后会涨到多少?
这个问题排除了一批容器。如果你知道就是 3 个浮点数,std::array<float, 3>,不需要动态分配。如果你知道不超过几十个,几乎所有容器的性能差异在这个数量级上都测量不出来,选最简单、接口最自然的就行(通常是 vector)。如果你预计可能有百万级别,list 的额外指针内存、map 的树节点开销就开始显著了,需要把空间效率纳入考虑。
规模也影响扩容策略。如果你能预估上线,reserve 能消除 vector 和 unordered_map 的扩容开销。如果你完全无法预估,容器的动态增长行为和内存碎片化就是你不可忽视的成本。
第二问:谁在访问元素?怎么访问?
遍历(for-each)、随机访问(operator[])、按键查找(find)、范围查询(lower_bound/upper_bound)是不同的访问模式,它们对容器结构的要求完全不同。
- 遍历为主:缓存局部性好的连续容器优先,
vector>deque>list。 - 随机访问为主:需要随机访问迭代器,
vector、deque、array、string。 - 按键查找为主:无序查找用
unordered_map/unordered_set,有序查找或范围查询用map/set。 - 范围查询:只有有序关联容器原生支持,
map、set。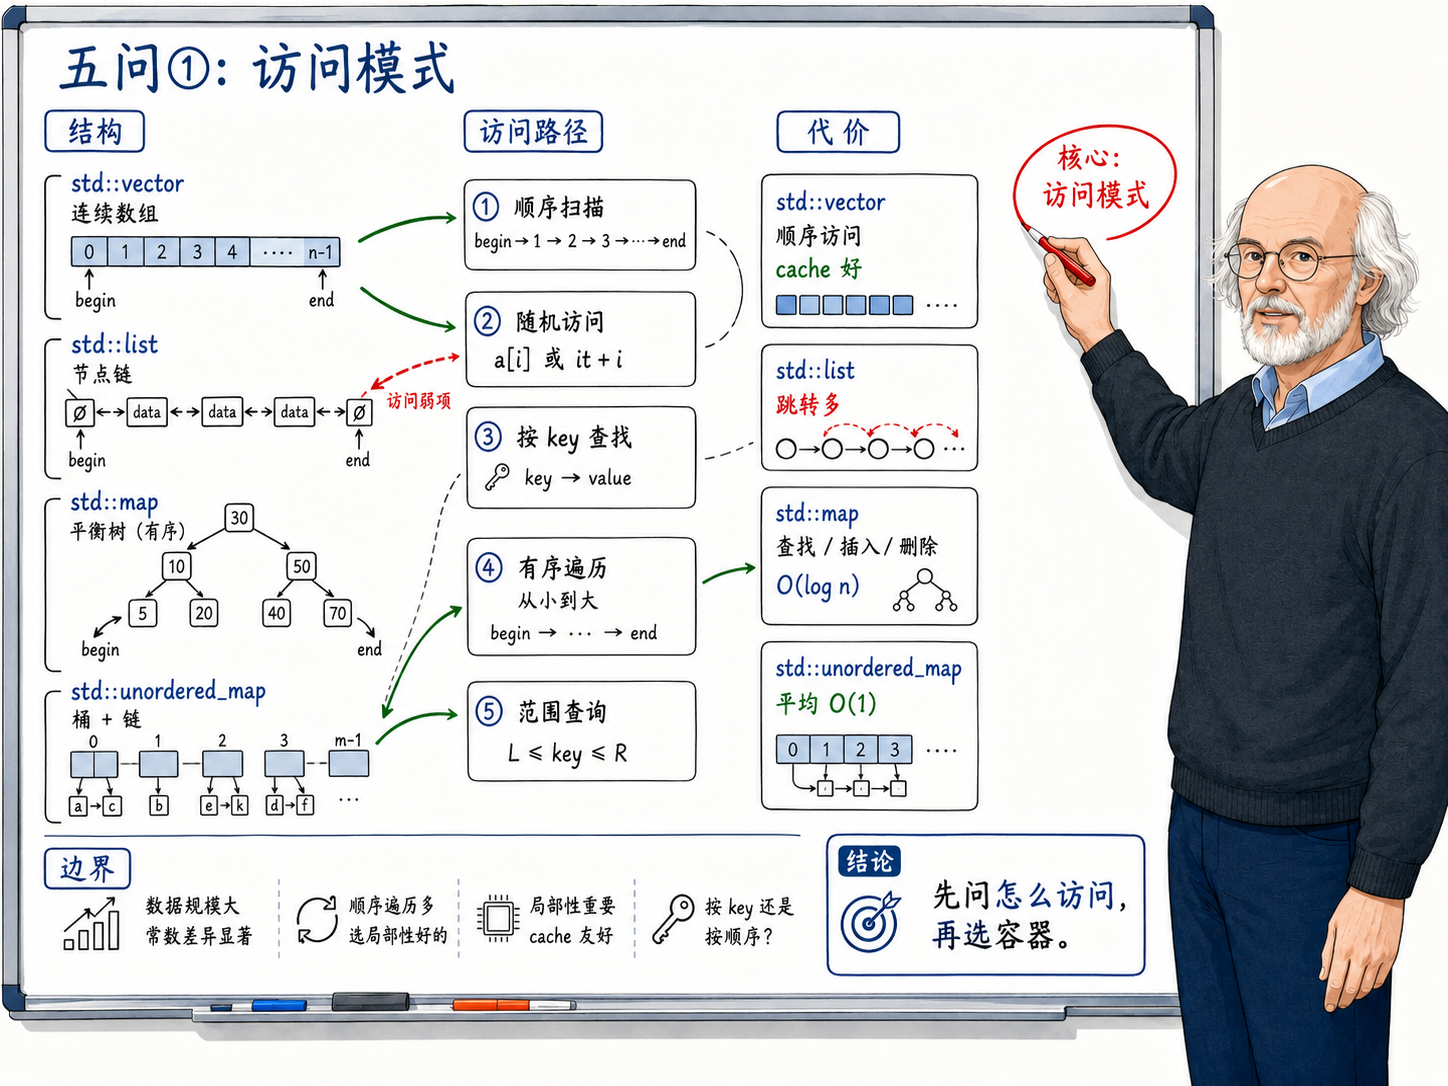
访问模式中一个容易被忽略的变量是读写比例。读多写少的场景可以容忍较贵的插入(偶尔扩容一下无所谓),哈希表或排序后的vector+ 二分查找都合适。写多读少的场景需要关注插入成本,vector的扩容搬动、map的树结构调整、unordered_map的 rehash 各有限制。读写相当则需要折中。
第三问:在哪里修改?
"修改"不只是"改值",更重要的是在哪里插入和删除,这与容器的存储结构直接相关。
- 只在尾部追加:
vector::push_back的分摊常数时间优势明显。如果偶尔需要在头部操作,deque。 - 头部和尾部都频繁操作:
deque的双端常数时间插入删除正好命中。 - 中间频繁插入删除:先确认是否每次插入都需要查找,如果需要,前两问(访问模式)的权重更高。如果位置已经由一个稳定的迭代器给出,
list的节点稳定性有价值。 - 任意位置的批量删除:
vector/deque/string用 remove-erase 惯用法,list用remove_if,map/set/unordered_map/unordered_set用安全的 erase 循环。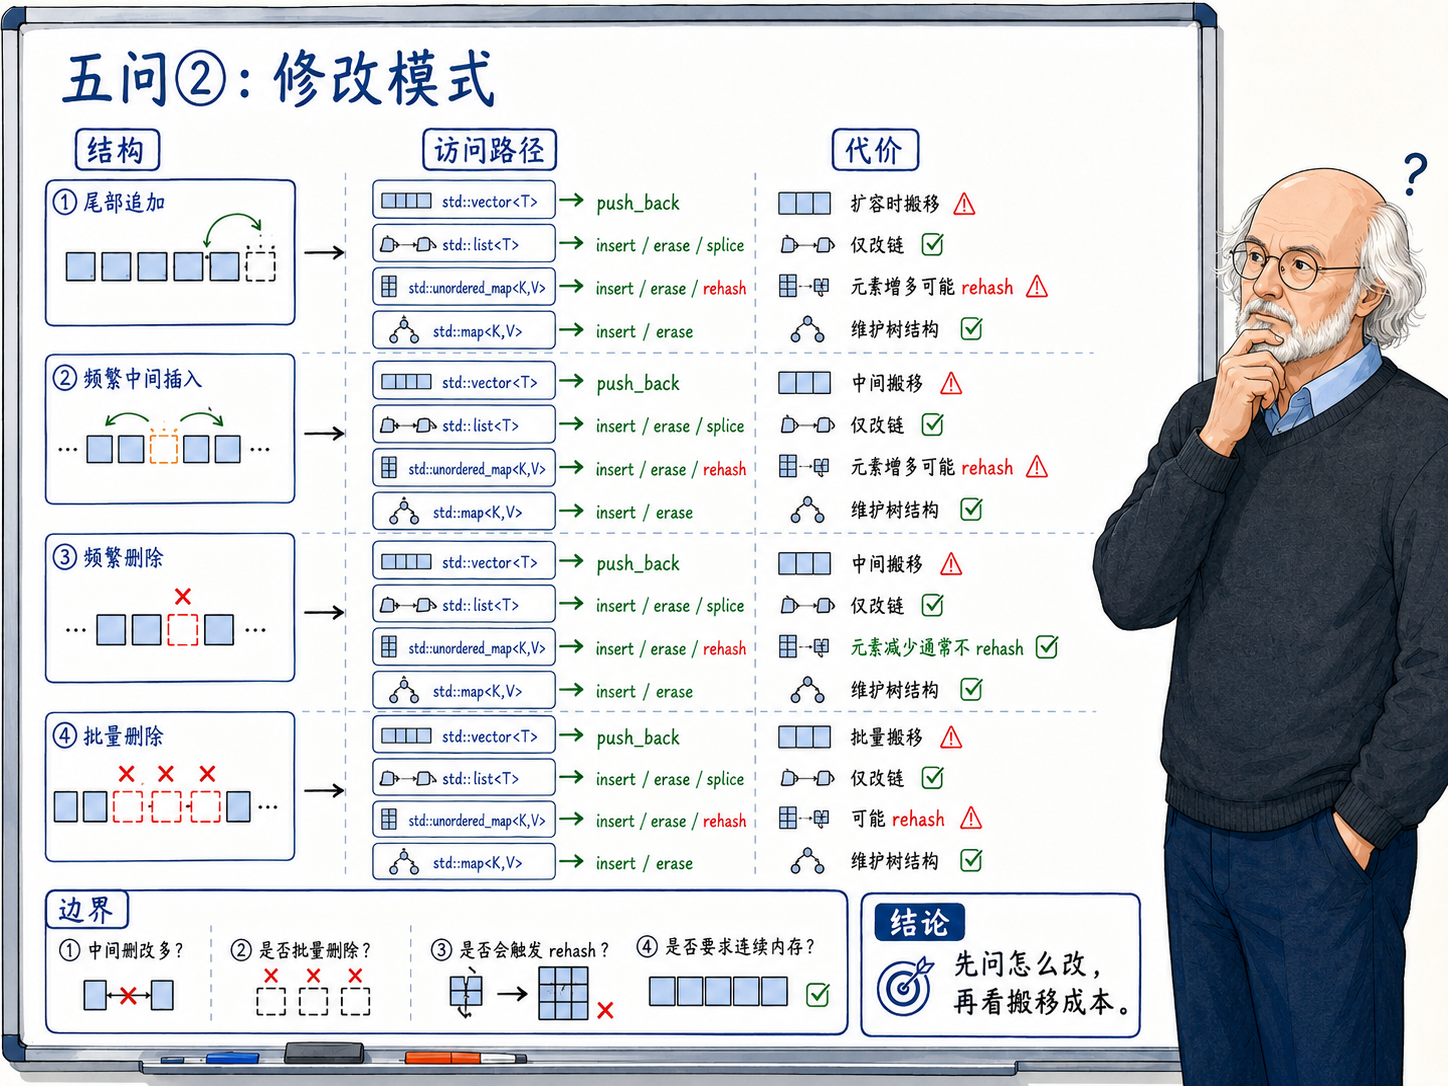
第四问:要不要查?按什么查?
如果从来不需要查找特定元素、只需要遍历所有元素,顺序容器(vector/deque)足够了。如果需要查找:
- 按键查找、不需要顺序:
unordered_map/unordered_set。追求平均 O(1) 的查找速度。接受遍历顺序无保证、rehash 可能导致迭代器失效。 - 按键查找、需要顺序或范围查询:
map/set。接受 O(log n) 的查找代价,获得有序遍历和lower_bound/upper_bound能力。 - 查找就是确认存在性、没有键值之分:
set(或unordered_set)。集合语义比映射更准确地表达意图。 - 同一个键对应多个值:
multimap/unordered_multimap(如果键值对天然就是多对多关系),或者map<K, vector<V>>(如果你需要对某个键对应的值列表做进一步处理)。
第五问:迭代器、引用、指针要不要一直有效?
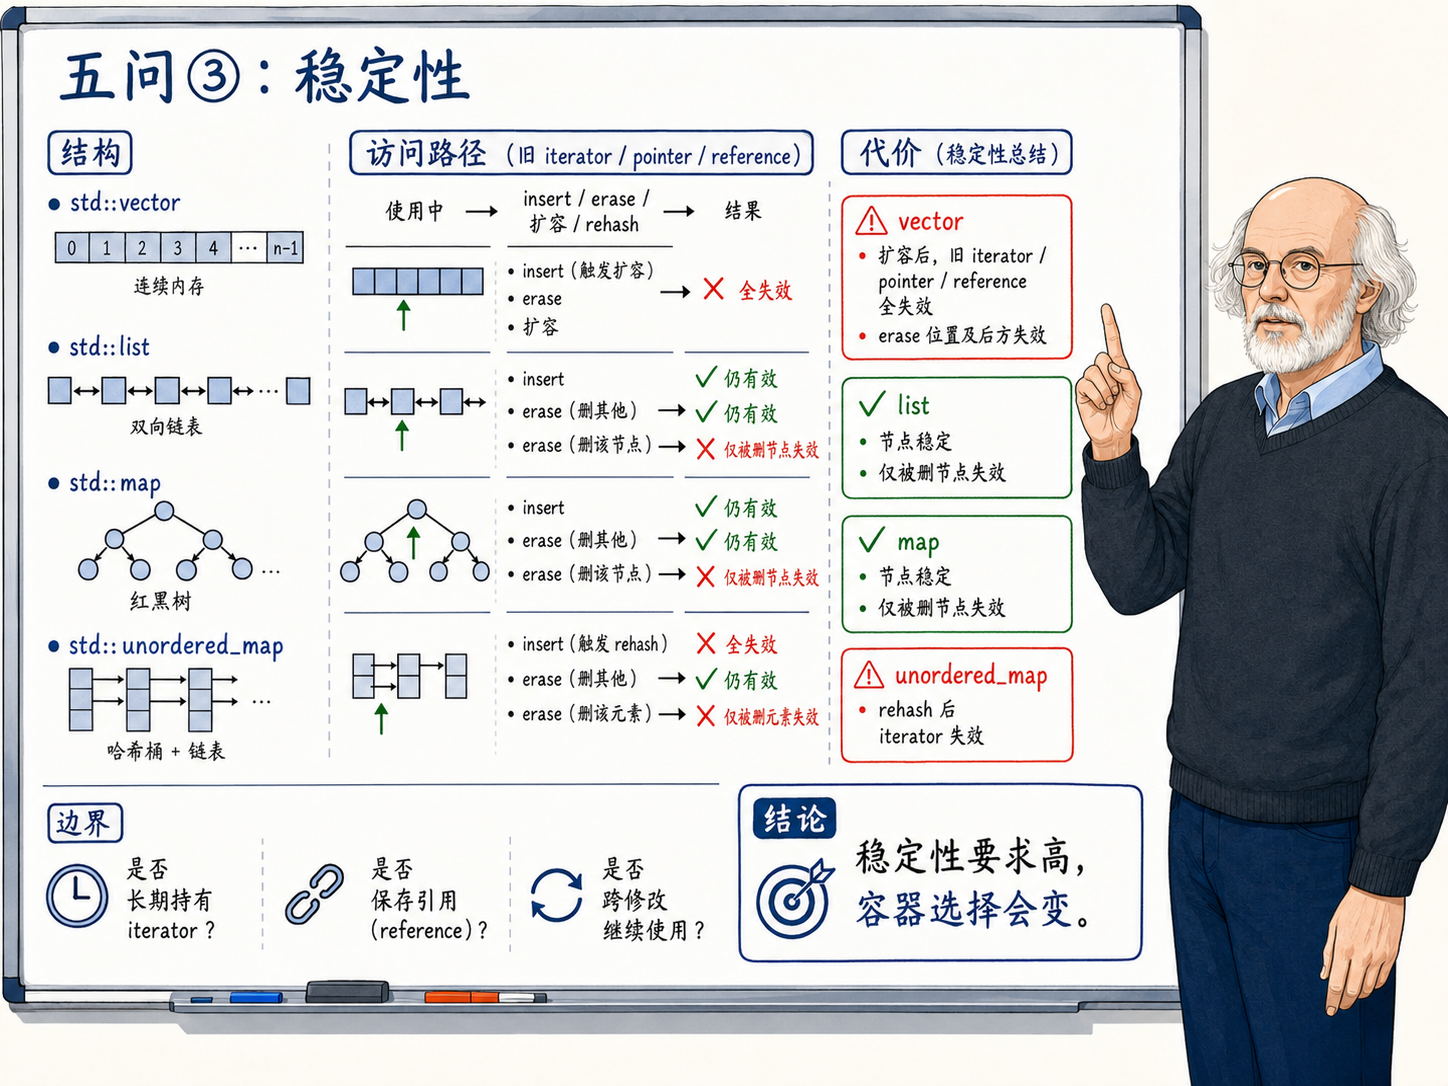
这是最容易被忘记的一问,也是容器选择出错后最难修复的一问,因为引用稳定性是结构层面的保证,无法通过改变用法来绕过。
- 需要长期持有迭代器、容器同时频繁更新:只有节点容器(
list、forward_list、map、set、unordered_map、unordered_set,注意unordered版本排除 rehash 的情况)和deque(仅限头尾插入)。 - 只需要在两次修改之间持有迭代器:任何容器都能胜任,
vector的连续内存还带来最好的缓存局部性。 - 完全不需要长期持有迭代器:这个问题不影响选择,直接跳过。
五个问题之后:从需求推出容器
把五个问题的答案串起来,容器选择就自然浮现。举几个具体任务:
任务 A:排行榜 Top 100。数据量小(100),需要按分数排序输出。访问模式:偶尔更新分数(修改值+调整位置),频繁遍历输出有序列表。不需要按键查找,不需要范围查询,不需要稳定迭代器。最合适的选择:vector 存元素,每次更新后 std::sort(量小无所谓),或手动在有序 vector 中 insert/erase 维护顺序(量小搬动不疼)。如果用 map<int, Player> 按键排序,键是分数,分数相同会打架(map 要求键唯一,除非用 multimap),而且分数变动时需要 erase → 改值 → insert,代码复杂度反而增加。
任务 B:用户 ID → 用户信息的在线索引。数据量:几十万到几百万。访问模式:极高频率按键查找(每次请求按 ID 找用户),不关心输出顺序。偶尔增加新用户,极少批量删除。不需要稳定迭代器。最合适的选择:unordered_map<uint64_t, UserInfo>。uint64_t 的哈希质量很高,负载因子可控。提前 reserve 可以消除 rehash 风险。不需要用 map,有序在这里是纯粹的额外成本。
任务 C:事件日志的最近 1000 条记录。数据量:维持 1000 条,超过则淘汰最旧。访问模式:新记录追加在尾部,旧记录从头部移除,偶尔遍历输出最近 1000 条。不需要按键查找。最合适的选择:deque,push_back 加新,pop_front 去旧,两端都是 O(1)。遍历是分段连续,体量小,缓存效应不太显著。vector 在头部删除需要搬动 999 个元素(每次淘汰),不合适。
任务 D:一组配置键值对,要求按字母序输出配置界面。数据量:几十个键值对。访问模式:按键加/改配置值,遍历输出按字母序。修改频繁度低,输出也不频繁。最合适的选择:map<string, string>。数据量小,对数开销可忽略,原生有序遍历不需额外排序。如果配置项特别多、查找极频繁且不在意有序输出,可以切到 unordered_map,输出前临时 vector 排序。
注意这四个任务没有一个是"频繁插入删除用 list",因为真实需求的组合判断往往导向其他容器。list 真正适合的场景是那些你确实需要节点稳定性或拼接操作的任务,比如实现一个 LRU 缓存(最近使用位移动到头部,splice 零拷贝),或者在 GUI 框架中维护一组可独立增删的选中对象(每个对象的迭代器需要在其他对象被删除时保持有效)。这些场景的特征非常明确:位置稳定性是硬需求。
不确定时,先从 vector 开始
如果你面对一个新需求,五个问题的答案还没有完全明确,一条稳健的基线是:先写 vector,等需求清晰后再换。理由在于:
vector的连续内存对缓存最友好,在大多数常见操作的基准测试中表现最优。vector的接口最简洁,用户迭代器、引用、指针的风险最小(只要你了解扩容规则)。- 从
vector换到其他容器通常比反向换的成本低,因为一开始你用vector的自然方式(下标访问、连续遍历)会暴露你的实际访问模式。如果发现频繁需要find,你会自然地切到map/unordered_map;发现需要稳定迭代器,你会自然地切到list。 - 反之,如果一开始就用了
list,你可能会接受"遍历慢一点"、"多占了内存"、"没有随机访问"这些代价而不自知,因为代码能跑,你不会主动去想"我这 200 个元素的链表换成vector遍历能快 10 倍"。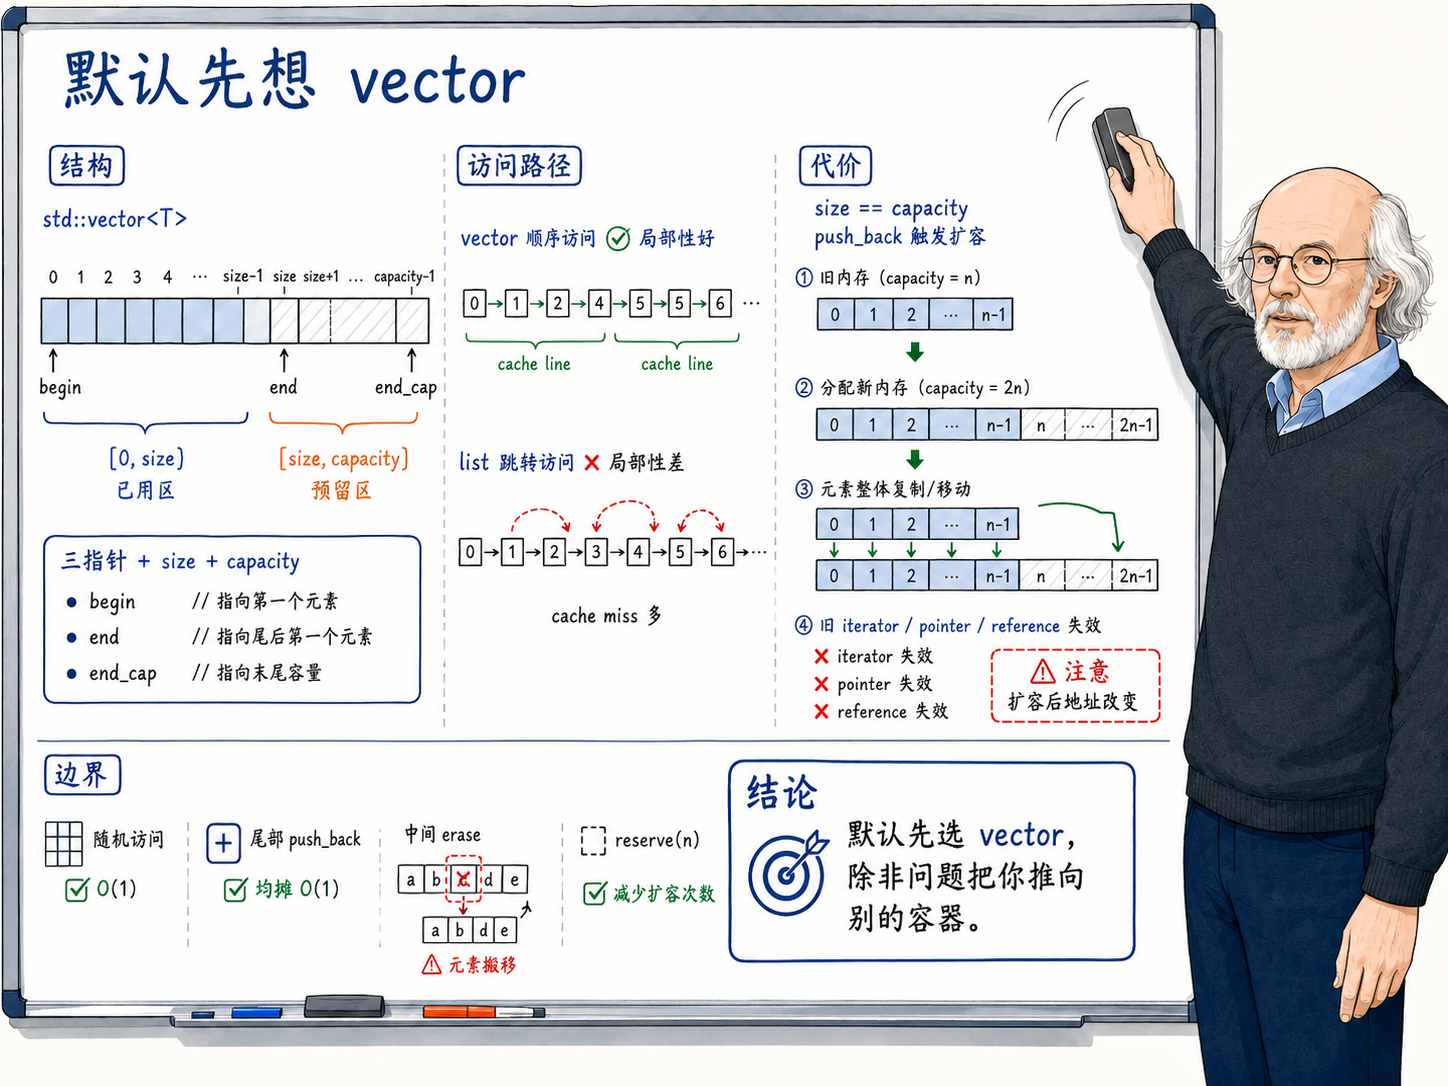
vector不会覆盖所有场景,但它是代价最透明、替换路径最清晰的起点。这个判断背后是对所有容器结构特征的清楚认识,连 Arnold 在 A Tour of C++中都把vector称为"你默认应该使用的容器"("If you don't know which container to use, usevector")。这句建议的有效期在 C++20/23 时代依然成立。
不过,"先从 vector 开始"不能变成新的口号。它适合需求还在探索、数据量可控、访问模式偏遍历或随机访问的阶段。需求一旦出现硬信号,就要及时换容器:头部高频进出指向 deque,长期稳定位置指向节点容器,按键范围查询指向 map 或 set,大规模按键查找且顺序无意义指向 unordered_map。默认选择的意义是降低早期复杂度,不是阻止你在证据出现后调整结构。
一个比较可靠的实践是先把容器藏在小范围内。不要在公共接口上到处暴露 std::vector<Record>&,也不要让调用方拿着内部迭代器长期保存;先写一个 InventoryTable、UserIndex 或 PendingJobs 这样的业务类型,把 add、find、remove_expired、for_each 这些操作作为接口。这样内部从 vector 换成 unordered_map 时,外部只依赖业务操作,不依赖容器形状。容器越早泄露成接口承诺,后续迁移成本越高。
容器选择矩阵
把前面的判断逻辑总结成一张决策矩阵,方便快速定位: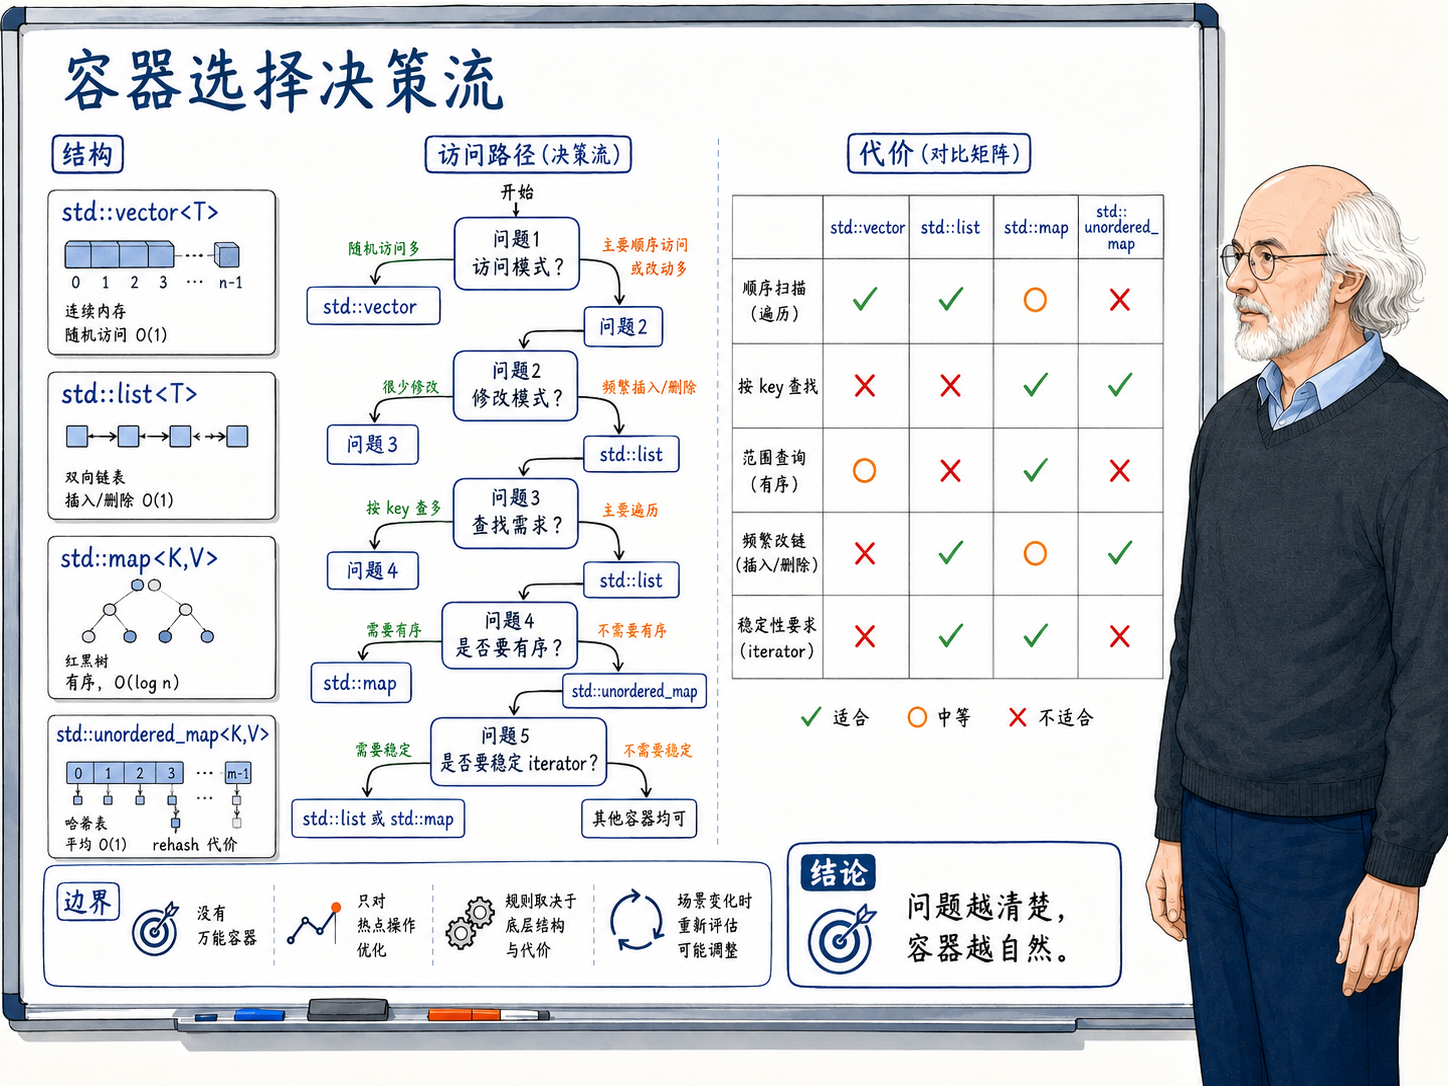
这张矩阵是一张决策入口表,每个"先用这个"后面都挂着"换这个当"的前提条件。真正的容器选择能力不是背下这张表,而是在面对一个具体需求时,能快速跑完五问,发现那个让"先用"变成"该换"的关键条件。
矩阵之外还有一个现实变量:数据分布。哈希表在均匀 key 上表现很好,在碰撞严重或 key 构造昂贵时优势会缩小;排序 vector 在小数据量上经常赢,在频繁插入删除的大数据量上会被搬动成本拖垮;map 在需要范围查询时很稳,在只查单个 key 时可能被哈希表甩开。复杂度表描述的是增长趋势,数据分布决定了常数项和真实路径。容器选择不能只看 Big-O,还要看你的数据长什么样。
因此,进入性能敏感路径后,容器选择必须用测量收尾。先写一个代表真实输入的基准:元素数量、key 长度、插入删除比例、查询比例、输出频率都要接近线上情况;再比较候选容器在同一环境下的耗时、内存占用和尾延迟。不要只测一个理想平均值,也要看最慢 1% 的操作,尤其是 vector 扩容、unordered_map rehash、map 节点分配这种偶发成本。很多容器选择争论,一旦拿真实数据跑完,答案会非常直接。
选择完了还要验证
容器选择不是一次性决策。随着程序演化,数据规模在变、访问模式在变、对顺序和稳定性的要求在变。当初选 vector 是正确的,但半年后数据量从 10 万涨到 1000 万,中间插入变成了主力操作,这个时候 vector 就不再合适了。当初选 map 是正确的,但后来发现查找变成了几乎全部的操作、有序输出需求消失了,unordered_map 可能就是更好的选择。
容器类型在 C++ 里是编译期常量(std::vector<T> 和 std::list<T> 是不同类型),所以切换容器意味着改写类型声明、改接口、改遍历方式,如果耦合严重确实改起来很疼。减轻这种痛苦的方式是把容器选择封装在类型别名或适配层后面,并在接口上尽可能使用迭代器范围而不是要求具体的容器类型,这本就是 STL 迭代器-算法分离设计鼓励的做法。
然而没有哪种设计模式能让容器选择"零成本切换"。vector::operator[] 是 O(1),list 根本没有它,接口差异根植于结构差异,换个名字抹不平结构差异。所以容器选择需要慎重,但也需要在测量中发现错误后愿赌服输,该换的时候果断换,不要因为"当初就是这么选的"而坚持一个已经不再合适的决策。
迁移时也不要只改类型名。vector 迁到 unordered_map,循环顺序会改变,测试里的输出顺序可能随之变化;map 迁到 unordered_map,范围查询能力会消失,原来依赖 lower_bound 的代码需要重新设计;list 迁到 vector,长期保存的迭代器和引用会变得危险。容器迁移本质上是数据结构迁移,要同时检查接口语义、迭代器生命周期、输出顺序、异常路径和性能基准。只要其中一项没过,迁移就不是完成了,只是代码能编译了。
团队协作中,容器选择还应该写进局部设计文档或代码注释。不是每个 vector 都需要解释,但那些"看起来可以换成别的容器"的地方应该说明理由:为什么排行榜用排序 vector,为什么索引用 unordered_map,为什么这里不用 list。注释不需要写成论文,一句话点出访问模式和关键约束就够了。后来的维护者看到数据量变化或访问模式变化时,也能知道该从哪里重新评估。
最终判断容器是否合适,看的是代码是否顺着结构自然展开。选对容器时,常用操作会短、直、少绕路;选错容器时,代码会到处补洞:为了在 vector 里快速查找又维护平行哈希表,为了在 unordered_map 上稳定输出每次都排序,为了在 list 上找元素写一堆线性扫描。补洞不是坏事,真实系统经常需要组合结构,但如果补洞越来越多,就说明原始容器选择已经承担不了需求变化。
可以把容器选择当成一次小型设计评审。先写出数据量级,再写出最高频的三类操作,然后标出是否需要顺序、范围查询、稳定引用和外部接口承诺。这个清单通常不到十行,却能把大部分争论压到事实层面。没有数据量级时,先用简单结构;没有顺序需求时,不为排序付费;没有稳定位置需求时,不为节点付费;没有真实性能压力时,不提前引入复杂组合结构。
这也是本系列前八章的共同目的:让你做选择时能说出结构理由。vector 因为连续内存适合遍历和随机访问,deque 因为分段结构适合两端流动,list 因为节点稳定适合位置共享,map 因为树结构适合有序范围,unordered_map 因为哈希桶适合无序快速查找。容器选择一旦能落到这些结构理由上,就不会被习惯和口诀牵着走。
最后一章会把这些判断放进一个完整数据流里。单个容器的选择只是局部决策,真实程序通常会让多个容器串起来:一个负责输入顺序,一个负责聚合索引,一个负责有序输出。看懂单个容器之后,还要学会让它们各做一件事。
所以本章的落点很务实:别问"哪个容器最好",问数据怎么被访问、怎么被修改、怎么被查找、谁会长期持有位置、结果要不要有序。五个问题跑完,候选容器通常只剩一两个。剩下的差异用真实数据测量,不用口号争。
这种选择方式会让代码更容易解释。你能对同事说清楚为什么这里用 vector,为什么那里用 unordered_map,为什么某个看似慢一点的 map 反而更稳。能解释的选择才容易维护,不能解释的选择最后都会变成团队里的隐性债务。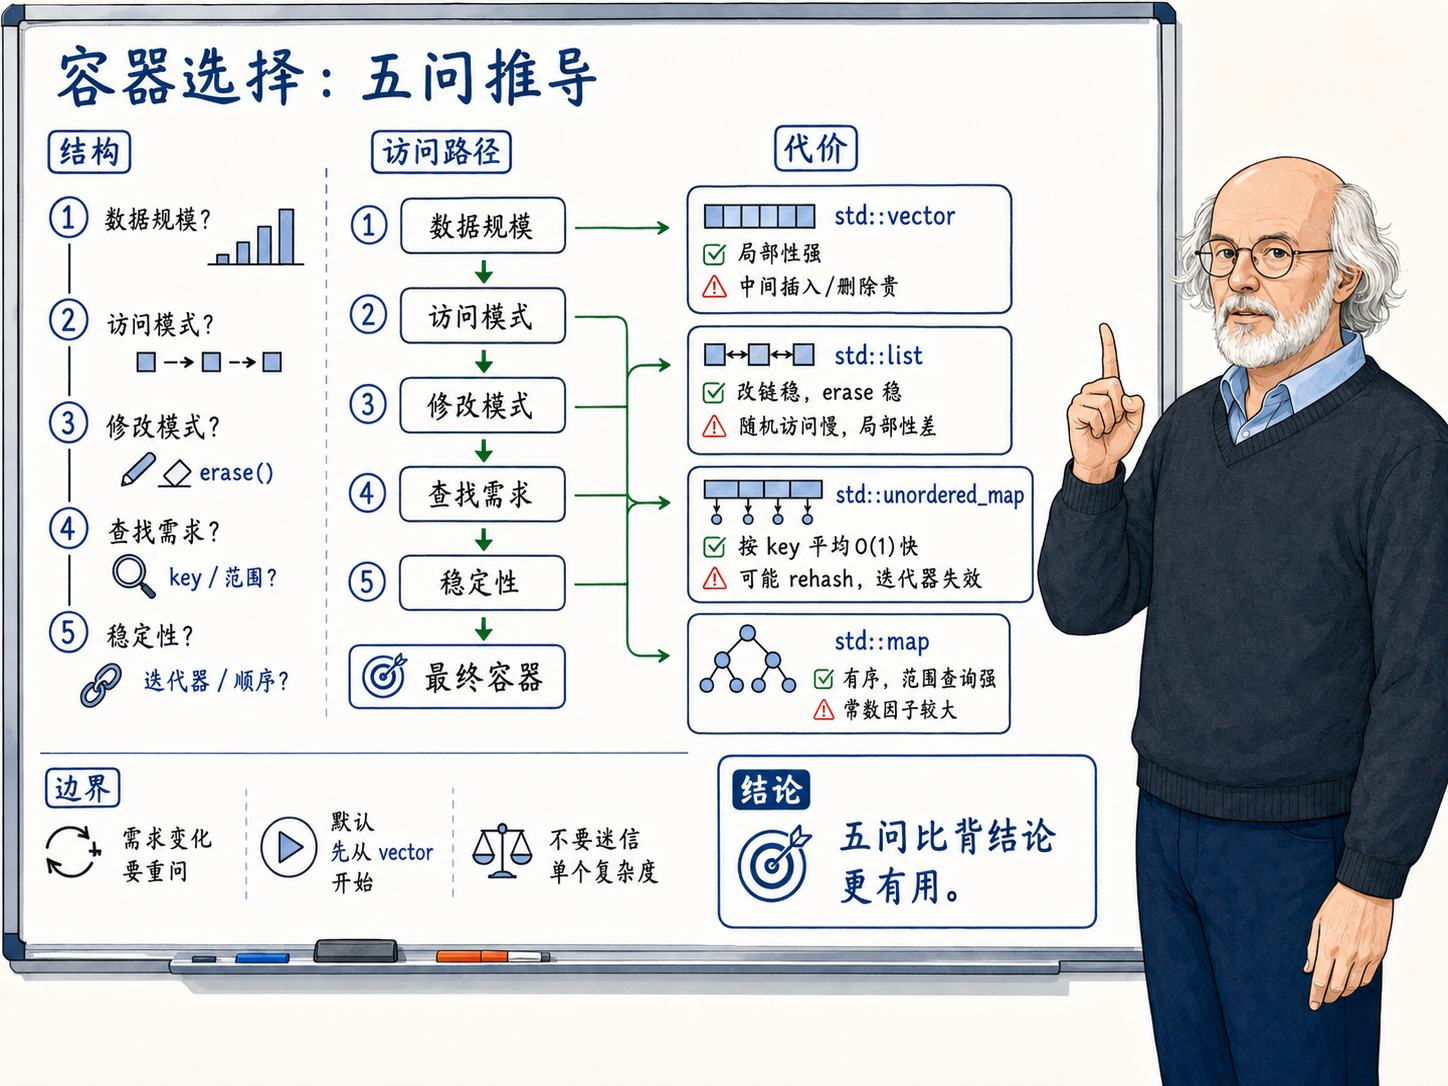
选完容器、用迭代器完成数据操作、处理好失效规则,容器部分的全部知识就齐了。最后一章,我们把所有这些知识压缩成一个小程序,看看这些零件组装起来后怎么配合。
阅读导航



