
AI Infra 高频面试题:推理瓶颈、缓存与并行策略
0. 面试总框架
回答 AI Infra 问题时,先说瓶颈来自哪里:
面试官通常不是只问定义,而是看你能不能根据硬件约束做 trade-off。建议每题都按这三句组织:
- 这个问题的核心瓶颈是什么。
- 常见方案怎么改计算、访存或通信。
- 代价是什么,什么场景适用。
这里其实每一道面试题都可以单独写一篇文章详细介绍相关知识点,后面会开放出来。
1. Roofline:Matmul 最佳输入大小与 MoE TopK token 数
1.1 GEMM 的 Roofline 怎么算
对矩阵乘法 C[M,N] = A[M,K] * B[K,N]:
- FLOPs 约为
2*M*N*K。 - 最小 HBM bytes 近似为
bytes * (M*K + K*N + M*N),其中bytes=2表示 FP16/BF16,bytes=1表示 FP8。 - 算术强度
AI = FLOPs / HBM bytes。 - Roofline 判断:
- 如果
AI < 峰值算力 / HBM带宽,memory-bound。 - 如果
AI >= 峰值算力 / HBM带宽,compute-bound。
- 如果
H100 SXM 的量级:HBM 带宽约 3.35 TB/s;FP16/BF16 Tensor Core 带 sparsity 峰值 datasheet 可到 1979 TFLOPS,不带稀疏常用估算约 989 TFLOPS。所以 P/B 约为:
989e12 / 3.35e12 ~= 295 FLOP/byte1979e12 / 3.35e12 ~= 591 FLOP/byte
对于方阵N*N*N的 BF16 GEMM:
AI ~= 2N^3 / (2 * 3N^2) = N/3
若按 P/B=295,需要 N >= 885 左右才接近 compute-bound。面试中不必死背这个数,要会说:小 batch、小 M 的 GEMM/GEMV 基本 memory-bound;大矩阵、充分 tile 后更可能 compute-bound。
1.2 Decode 为什么常常 memory-bound
Decode 阶段常见形状接近 GEMV:[1,K] * [K,N]。
FLOPs 约 2KN,读权重 KN 个元素,FP16/BF16 下 bytes 约 2KN,所以 AI ~= 1 FLOP/byte,远小于 H100 的 P/B。这就是 decode 小 batch 时很难把 Tensor Core 喂满的根本原因。
1.3 MoE TopK 最佳 token 数怎么估
MoE 每个 expert 的 MLP 通常是多个 GEMM。以 expert 第一个投影为例:
X[T_e, d_model] * W[d_model, d_ff] -> Y[T_e, d_ff]
其中 T_e 是被路由到某个 expert 的 token 数。
算术强度:
AI = 2*T_e*d_model*d_ff / (s*(T_e*d_model + d_model*d_ff + T_e*d_ff))
当 T_e 很小时,读 expert 权重 d_model*d_ff 主导,近似:
AI ~= 2*T_e / s
BF16 下 s=2,所以 AI ~= T_e。若想达到 P/B ~= 295,每个 expert 每次至少要有几百 token 的量级才容易 compute-bound。实际还要满足 Tensor Core tile,比如 M 维至少够多个 warp/block 并行,常见会按 T_e 做 padding、grouped GEMM、expert batching。
面试回答重点:
TopK越大,激活 FLOPs 和 A2A 通信都按K增长。EP越大,每个 expert 分到的 token 越少,expert GEMM 越碎,算子效率下降。- 最佳点不是固定值,要由
tokens_per_step * TopK / num_experts和硬件 roofline 决定。
1.4 用 DeepSeek-V3 估 EP 大小
DeepSeek-V3 公开技术报告给出的推理部署信息中,decode 最小部署单元为 40 个节点、320 张 GPU,attention 使用 TP4 + SP + DP80,MoE 使用 EP320;每个 token 选择 8 个 routed experts,并把 shared expert 当作必选 expert 看待时相当于 9 个 expert。每张 GPU 承载一个 expert,部分 GPU 负责冗余 expert 与 shared expert。
如果面试官给「固定单卡 batch size = 16,以 DeepSeek 为例算 EP」:
- 若每个 DP replica 有
B个 decode token,TopK 为K,专家数为E。 - 平均每个 expert 收到
T_e = B*K/E个 token。 - 如果
T_e太小,expert GEMM 会退化成大量小 M GEMM,吞吐低。 - 因此只靠单卡 batch=16 并不能让 256 expert 都高效,需要跨请求、跨 DP、跨 microbatch 聚合,或采用冗余 expert、动态 batch、prefill/decode 分离。
一句话答案:EP不能只按「专家总数」定,要让tokens_per_expert达到算子有效区间,同时控制 A2A 延迟。DeepSeek-V3 decode 使用 EP320 是系统级折中:每 GPU 一个 expert,结合 DP80、TP4、专家冗余和 IB 点对点通信降低延迟。
2. FlashAttention 与 FlashDecoding
2.1 FlashAttention 是什么
普通 attention 会显式构造 S = QK^T 和 P = softmax(S),大小是 O(L^2)。长上下文时,瓶颈不是算力,而是 HBM 读写巨大中间矩阵。
FlashAttention 的核心:
- 精确 attention,不是近似。
- 按 block/tile 把
Q/K/V搬到 SRAM/shared memory。 - 不把完整
L*Lattention matrix 写回 HBM。 - 用 online softmax 维护每行的最大值
m_i和归一化因子l_i,分块累积输出。
2.2 Online softmax 公式
对于第 i 行,处理新 block 前已有:
m_old = max(scores_seen)l_old = sum(exp(scores_seen - m_old))o_old = sum(exp(scores_seen - m_old) * V)
新 block 得到:m_new = max(m_old, max(scores_block))l_new = exp(m_old-m_new)*l_old + sum(exp(scores_block-m_new))o_new = exp(m_old-m_new)*o_old + sum(exp(scores_block-m_new)*V_block)- 最终
O = o_new / l_new
这解决了「分块 softmax」的数值稳定性问题。
2.3 FlashAttention-2/3 大概优化了什么
- FA-1:核心是 IO-aware tiling。
- FA-2:减少非矩阵乘操作、改进 work partitioning,提高并行度,让 attention 更接近 GEMM 效率。
- FA-3:面向 Hopper,利用异步 TMA、warp specialization、FP8 等机制提升 H100 上的利用率。
2.4 FlashDecoding 是什么
Decode 阶段每次只有一个新 query,但要 attend 到很长 KV cache。单 token query 的并行度不足,FlashDecoding 的思路是把 KV 序列切成多个 split:
- 每个 split 并行计算局部 attention 输出、局部 max、局部 sum。
- 再对多个 split 的局部结果做一次归并 softmax。
适用场景:batch 小、context 很长、单 query attention 并行度不足。代价:多一次 split 归并和更多 kernel/同步开销,短上下文或大 batch 不一定收益。
3. Prefix Cache 与 KV Cache
3.1 KV Cache 是什么
自回归 decode 中,历史 token 的 K/V 不变。KV Cache 把每层历史 K/V 保存下来,新 token 只计算自己的 Q/K/V,再用 Q attend 到历史 KV。
KV Cache 显存估算:
bytes = layers * tokens * kv_heads * head_dim * 2(K,V) * dtype_bytes
MHA 下 kv_heads = num_heads;GQA/MQA/MLA 会减少 KV cache。
3.2 Prefix Cache 是什么
Prefix Cache 是跨请求复用相同 prompt prefix 的 KV Cache。比如系统 prompt、工具描述、few-shot examples 在很多请求中相同,可以不重复 prefill。
区别:
| 项目 | KV Cache | Prefix Cache |
|---|---|---|
| 粒度 | 单个 request 的历史 KV | 多个 request 共享的公共前缀 KV |
| 生命周期 | 请求 decode 完释放 | 可跨请求保留,按 LRU/引用计数淘汰 |
| 目的 | 避免重复算历史 token | 避免重复 prefill 公共 prefix |
| 难点 | 动态增长、碎片、显存占用 | hash 匹配、块共享、权限隔离、淘汰策略 |
3.3 怎么实现 Prefix Cache
常见实现:
- token block 化:比如每 16/32/64 token 一个 block。
- 对 block token ids、model id、LoRA id、sampling 不相关参数、cache salt 做 hash。
- block table 指向物理 KV page。
- 引用计数管理共享 block。
- eviction 用 LRU/LFU/priority,保留命中率高的系统 prompt 和工具 schema。
- 注意权限隔离:不同租户、不同安全上下文不能错误共享。
vLLM 的 PagedAttention 用类似虚拟内存分页的方法管理 KV block,降低碎片并支持 cache sharing。
4. Chunked Prefill、MLA 与激活值过大
4.1 Chunked Prefill 是什么
Prefill 长 prompt 会产生大 GEMM,吞吐高但会阻塞 decode,导致其他请求 TPOT 抖动。Chunked Prefill 把长 prefill 切成多个 chunk,和 decode 交错调度。
4.2 在 MLA 中 KV load 后做 projection,KV 很大导致激活值大怎么办
MLA 把 KV cache 存成 latent/compressed 表示,decode 时再投影恢复部分 K/V 表示。问题中「KV load 后做 proj,KV 很大导致激活值很大」可以从数值稳定性和系统实现两层回答:
数值层面:
- RMSNorm/LayerNorm 放在 projection 前或后,约束输入尺度。
- 对 projection 输出做 scaling,例如按
1/sqrt(d)或模型定义的 attention scale。 - 使用 FP32 accumulation,特别是 reduction、softmax max/sum。
- 对 FP8/INT8 KV 使用 per-channel 或 per-block scale,避免单个异常值污染整块量化。
- 必要时做 activation clipping,但要说明会影响精度,通常作为工程兜底。
系统层面: - fused kernel:load compressed KV -> dequant/scale -> projection -> attention,减少 HBM 往返。
- 分块归一化,避免一次性 materialize 巨大 K/V。
- 对长上下文使用 split-KV/FlashDecoding,保持局部 max/sum 再归并。
- profiling 看是 bandwidth、tensor core、还是 softmax/reduction 瓶颈。
5. Agent 场景 KV Cache 不够怎么办
Agent 场景的特点:system prompt 长、tools schema 长、多轮对话长、分支/回溯多、很多请求共享前缀。
可选优化:
- Prefix Cache:缓存系统 prompt、工具定义、few-shot。
- Paged KV:按 block 分配,降低碎片,支持共享和 copy-on-write。
- KV quantization:KV cache 用 INT8/FP8/低比特,配合 per-head/per-channel scale。
- Sliding window 或 sink token:保留开头重要 token + 最近窗口。
- Context compaction:把旧工具调用和中间推理摘要化。
- 分层 cache:HBM 热 KV、CPU DRAM 冷 KV、NVMe 极冷 KV,但要评估 PCIe/网络延迟。
- Prefix-aware scheduling:相同 prefix 的请求合批,提高 prefix cache 命中。
- Speculative decoding:减少 decode 步数,但会增加 draft model 和验证逻辑。
面试回答要强调:KV cache 空间优化不能只看省显存,还要看额外带宽、反量化开销、质量损失和尾延迟。
6. PD 分离一定好吗?Agent prefix 很长怎么办
PD 分离是把 prefill 和 decode 放到不同 worker/GPU 池:
- Prefill:大矩阵、compute-heavy、吞吐优先。
- Decode:小步迭代、memory/latency-heavy、延迟优先。
不一定好,原因:
- Prefill 完要把 KV 交给 decode,KV 很大时跨 GPU/跨节点传输代价高。
- Agent 场景 prefix 很长,如果 prefix cache 命中在 decode 池而不是 prefill 池,反而搬 KV 很贵。
- 请求短、上下文短、并发低时,PD 分离增加调度复杂度和排队。
- 如果网络弱,KV handoff 会吞掉收益。
Agent prefix 很长时的策略: - 把稳定 prefix cache 放在离 decode 更近的位置。
- 按 prefix affinity 调度到已有 cache 的 worker。
- 对超长 prefix 采用 prefill chunk + early handoff。
- 热 prefix 预热到多张 GPU,减少单点热点。
- 判断公式:如果
节省的 prefill compute 时间 > KV 传输时间 + 调度排队时间,PD 分离才值得。
7. CP 中 AG KV 和 AG Q 怎么选择?Agent 还能 AG KV 吗?
CP 是 context parallelism,把长序列按 context 维切到多张 GPU。Attention 要让每个 Q 看到所需 K/V,因此需要通信。
两类思路:
- AG KV:all-gather K/V,每张卡保留本地 Q,拿到全局 KV 算 attention。
- AG Q:all-gather Q,每张卡保留本地 KV,计算局部 attention,再做归并/规约。
| 方案 | 通信对象 | 适合场景 | 问题 |
|-|-|-|-|
| AG KV | K/V | Q 较小、KV cache 可承受、实现简单 | 长上下文 KV 巨大,Agent 场景更明显 |
| AG Q | Q | decode 单 token 或 Q 小,避免复制大 KV | 需要跨卡 softmax 归并,逻辑复杂 |
| Ring Attention | Q/K/V block 环形流动 | 超长上下文训练/推理 | 多步通信,调度复杂 |
Agent 场景还能不能 AG KV? - 如果 prefix cache 很长,AG KV 会重复搬运大量共享 KV,通常不优。
- 如果 KV 已在多卡分片,优先让计算靠近 KV,做 AG Q 或 ring/split attention。
- 如果上下文不太长、NVLink 内通信、batch 较大,AG KV 仍可能简单有效。
面试话术:选择不是绝对的,看bytes(Q)、bytes(KV)、softmax 归并成本、网络拓扑和 cache locality。Agent 长 prefix 通常更偏向减少 KV 搬运。
8. Decode 输出长,怎么负载均衡和优化
长输出会导致 continuous batching 中有请求长期占位,短请求排队,GPU batch 形状不断变化。
优化:
- Token-level continuous batching:每步重新组 batch。
- Fair scheduling:限制单请求连续占用步数,兼顾 TPOT 和整体吞吐。
- Prefix/cache affinity:把相同 prefix 或已有 KV 的请求放同 worker。
- 预测输出长度:按 prompt、任务类型、历史统计做 admission control。
- Speculative decoding:draft model 一次提议多个 token,target model 验证。
- 并行采样合并:多候选时共享 prefix KV。
- 对超长生成做迁移或分层服务:长任务进入后台低优先级队列。
- KV 预留与抢占:Paged KV 支持 preempt/swap/recompute。
指标上要同时看: - TTFT:首 token 延迟。
- TPOT:每 token 延迟。
- ITL:inter-token latency。
- Throughput:tokens/s。
- Goodput:满足 SLO 的 tokens/s。
9. 为什么要 EP 和大 DP?大 EP 开多大合适?
9.1 EP 的目的
Expert Parallelism 把不同 expert 放到不同 GPU,避免每张卡存所有专家。MoE 的参数量巨大,但每个 token 只激活 TopK expert,所以 EP 是让稀疏模型可部署的关键。
代价:
- token dispatch 和 combine 需要 all-to-all。
- expert 负载不均会导致 straggler。
- 每个 expert token 数太少会导致 grouped GEMM 效率差。
9.2 大 DP 的目的
DP 复制模型或部分模型,处理更多独立请求:
- 提高吞吐。
- 增加每步 token 数,使 MoE 每个 expert 收到更多 token。
- Serving 中 DP 也能隔离不同请求,减少队列干扰。
9.3 EP 开多大
经验判断:
- 如果模型所有 expert 单卡放不下,EP 至少要让参数放下。
- 如果
tokens_per_expert = batch_tokens * topK / num_experts太小,EP 太大或 batch 太小。 - 优先让 A2A 在高速域内完成,比如 NVLink/NVSwitch 内;跨节点 EP 要非常小心。
- 热 expert 可冗余复制,缓解负载不均。
一句话:EP 由显存下限、网络上限和 expert GEMM 效率共同决定。
10. PD 分离配比怎么定?Decode batch 多大合适?怎么反推 Prefill 数量?
定义:
lambda:请求到达率 req/s。L_in:平均输入 token。L_out:平均输出 token。R_p:prefill pool 处理速度 input tokens/s。R_d:decode pool 处理速度 output tokens/s。
稳定条件:lambda * L_in < R_plambda * L_out < R_d
需要的 GPU 数:G_p >= lambda * L_in / r_p_per_gpuG_d >= lambda * L_out / r_d_per_gpu
Decode batch 多大合适:- 太小:GEMV/GQA/attention 并行度不足,吞吐低。
- 太大:排队增加,TPOT/ITL 变差,KV 显存爆。
- 用 SLO 反推:选择满足 p95 TPOT 的最大 batch,而不是追求峰值吞吐。
由 decode 反推 prefill 数量:
如果 decode 是瓶颈,prefill 多了只会堆 KV 和增加 TTFT;如果 prefill 是瓶颈,decode GPU 空转。实际用压测曲线找 prefill utilization 和 decode utilization 都在健康区间的配比。
11. MoE 并行 overhead 与 A2A 通信量
MoE 一层典型流程:
主要 overhead:
- Router 计算和 TopK。
- token permutation/unpermutation。
- dispatch A2A。
- combine A2A。
- padding/capacity factor 导致无效 token。
- expert 负载不均。
- 小 batch grouped GEMM 效率低。
A2A 通信量估算:
每层 dispatch 发送 activation:
bytes_dispatch ~= tokens * topK * hidden_size * dtype_bytes
combine 返回同量级:
bytes_total ~= 2 * tokens * topK * hidden_size * dtype_bytes
如果还发送 routing weight、indices,相比 hidden activation 通常较小。若 EP 跨节点,网络开销会非常显著。
12. 4 台服务器矩阵乘并行:C=A*B,A/B 都是 [N,N]
题目:4 台服务器,每台 memory 是 N*N,服务器全连接,计算 C=A*B,A/B 都是 [N,N],怎么并行?如果缓存只有 N*N/8,怎么做?
12.1 每台能放 N*N:2D SUMMA
把 GPU/服务器看成 2x2 网格,A/B/C 都按块切成 2x2:
每个进程 Pij 负责 Cij。按 k 维分 2 次:
- 第 k 轮,行内广播
A[i,k],列内广播B[k,j]。 - 本地累加
Cij += Aik * Bkj。
每台存储约: - 一个
C块:N^2/4 - 一个 A panel:
N^2/4 - 一个 B panel:
N^2/4 - buffer/临时空间
总量小于N^2,可行。
12.2 缓存只有 N*N/8:进一步分块流水
N^2/8 放不下 Cij + Aik + Bkj 三个 N^2/4 块,需要更细粒度 tiling:
- 仍用 2D decomposition,但每个
Cij再切成小 tile。 - 每次只加载
A的一条 tile panel 和B的一条 tile panel。 Ctile 局部累加,累加完写回外部存储或分批 reduce。- 使用 double buffering 隐藏通信。
这就是 out-of-core / blocked SUMMA。面试要说清楚代价:通信轮数增加、需要多次读写 C tile,但满足内存上限。
13. Attention 变体:MHA、MQA、GQA、MLA 对算子的影响
| 结构 | Q heads | KV heads | KV cache | 计算/访存影响 |
|---|---|---|---|---|
| MHA | H | H | 最大 | 表达力强,decode KV 读最重 |
| MQA | H | 1 | 最小 | 大幅降 KV cache 和带宽,可能损失质量 |
| GQA | H | G,1<G<H | 中等 | 质量/效率折中,很多 LLM 采用 |
| MLA | H 或 latent Q | latent compressed KV | 更小 | 存 latent KV,decode 时投影,节省 cache 但增加 projection 计算 |
| KV cache 比例: |
- MHA:
H * head_dim - GQA:
G * head_dim - MQA:
1 * head_dim - MLA:
kv_lora_rank或 compressed dim
Decode 阶段常被 KV cache bandwidth 限制,因此 MQA/GQA/MLA 的意义非常大。
14. 算子有哪些优化方法
通用 checklist:
- Tiling:把数据搬到 shared memory/register,多次复用。
- Coalesced memory access:让 warp 连续访问,减少 memory transaction。
- Vectorized load/store:用
float4、half2等。 - Tensor Core:使用 MMA/WGMMA,保证 shape、layout、对齐满足要求。
- Fusion:把 bias、activation、residual、norm 融合,减少 HBM round-trip。
- Double buffering:计算当前 tile 时预取下一 tile。
- Warp specialization:不同 warp 分工 load/compute/store。
- Reduce 优化:warp-level primitives、shared memory tree reduction。
- 避免 bank conflict:shared memory layout padding/swizzle。
- Occupancy 不是越高越好:寄存器、shared memory、ILP、Tensor Core pipeline 要综合看。
面试中可以用 LayerNorm 举例:读 x、算 mean/var、归一化、写 y。优化点包括向量化读、warp/block reduction、融合 residual/dropout、FP32 accumulation。
15. 如何根据硬件特性优化 Infra
按层次回答:
- HBM:减少读写,fusion、cache、量化、Paged KV。
- SRAM/shared memory:tiling、FlashAttention、GEMM blocking。
- Register:减少 spill,合理 unroll,控制每线程寄存器。
- Tensor Core:选择 BF16/FP16/FP8,使用对齐 shape。
- NVLink/NVSwitch:优先把 TP/EP 放在高速域内。
- IB/RDMA:跨节点通信做 overlap、hierarchical collective。
- PCIe:避免频繁 CPU-GPU 往返,pin memory、异步拷贝。
- L2 cache:权重复用、持久化 cache、合理访问模式。
一句话:先用 profiler 判断瓶颈,再选择优化。Nsight Compute 看 SM/Tensor/HBM 利用率,Nsight Systems 看 kernel gap、通信重叠和调度等待。
16. 同样输入,算子会随机输出吗?AtomicAdd 有什么问题?
同样输入不一定 bitwise 相同,原因:
- 浮点加法不满足结合律:
(a+b)+c不一定等于a+(b+c)。 - 并行 reduction 顺序可能不同。
atomicAdd保证单次读改写原子性,不保证多个线程的全局执行顺序固定。- FP32/FP16 的舍入误差会随累加顺序变化。
- 某些库为了性能选择 nondeterministic algorithm。
AtomicAdd 问题: - 竞争严重时性能差,serialization。
- 浮点结果非确定。
- 热点地址会导致吞吐下降。
解决: - 分层 reduction:warp -> block -> global,减少 atomic。
- 固定 reduction tree,开启 deterministic mode。
- 用更高精度 accumulation。
- 允许误差时用 tolerance 验证,而非 bitwise 比较。
17. FP32 下 9.9*10^9 - 1.0*10^-9 等于多少?会溢出吗?
不会溢出。FP32 最大约 3.4e38,9.9e9 远小于最大值。
但 1e-9 相对 9.9e9 太小,远低于该数量级的 FP32 ULP。FP32 有约 24 bit 有效精度,约 7 位十进制有效数字。在 1e10 附近,相邻可表示数间隔大约是几百到一千。因此:
float32(9.9e9) - float32(1e-9) == float32(9.9e9)
面试要点:不是溢出,而是小数被舍入吞掉,属于精度/吸收问题。
18. GPU 有哪些 memory
CUDA 编程视角:
| Memory | 位置/范围 | 特点 | 常见用途 |
|---|---|---|---|
| Register | SM 内,线程私有 | 最快,数量有限 | 临时变量、fragment |
| Local memory | 逻辑线程私有,物理常在 HBM | register spill 或大数组 | 避免使用过多 |
| Shared memory | SM 内,block 共享 | 快,程序员管理 | tiling、block reduction |
| Global memory | HBM,grid 可访问 | 大但慢 | tensor、KV cache、weights |
| Constant memory | 只读,cache | 广播友好 | 小常量 |
| Texture/readonly cache | 只读路径 | 空间局部性 | 特定访问模式 |
| L2 cache | 芯片共享 | 自动缓存 | 跨 SM 复用 |
| 注意:Global memory 地址是虚拟地址,会映射到设备内存、peer memory 或 pinned host memory 等。 |
19. 两个进程能同时操作同一个 GM 地址吗?GM 有虚拟地址吗?
可以,但分情况:
- 同一进程内多个 kernel/stream 操作同一 global memory 地址,需要同步保证顺序。
- 多进程访问同一 GPU memory 需要 CUDA IPC、MPS、统一虚拟地址等机制。
- 如果同时写同一地址且无原子/锁,结果是 data race。
- 原子操作只能保证单个操作原子,不保证业务级顺序。
GM 是否有虚拟地址:有。现代 CUDA 使用 Unified Virtual Addressing,同一进程中 host 和 device 地址空间可统一管理;global memory 是虚拟地址,底层映射到设备物理内存、peer memory 或 pinned host memory。
20. 算子中的常量参数放在哪个 memory
取决于大小和访问模式:
- 编译期常量:可能内联到指令 immediate。
- kernel 参数:通过 constant memory 参数区传入。
- 小型只读表:
__constant__memory,适合 warp 内所有线程读同一地址。 - 大型只读权重:global memory + L2/readonly cache。
- 每线程临时常量:register。
面试重点:constant memory 对广播访问很高效,但如果同一 warp 访问很多不同地址,会串行化。
21. 单核什么时候两个线程比一个线程更快
在 CPU/GPU 都可以从「隐藏等待」解释。
两个线程更快的场景:
- 单线程经常等待内存、IO、cache miss、同步。
- 硬件支持 SMT/Hyper-Threading,另一个线程可利用空闲执行单元。
- GPU 上更多 warp 可以隐藏 memory latency。
不会更快甚至更慢的场景: - 单线程已把执行单元、带宽或 cache 用满。
- 两线程争用 cache、寄存器、内存带宽。
- 线程切换和同步开销大于收益。
一句话:多线程提升来自隐藏 latency 和提高资源利用率,不是让一个核心的峰值算力翻倍。
22. 如何估算 LLM 推理显存
显存主要由四部分组成:
- 权重:
params * dtype_bytes / tensor_parallel_size - KV cache:
layers * tokens * kv_heads * head_dim * 2 * dtype_bytes - activation/workspace:prefill 更大,decode 较小。
- runtime overhead:CUDA graph、allocator、fragmentation、NCCL buffer。
面试建议:先粗算权重和 KV cache,再留 10%-30% runtime buffer。
23. Prefill 和 Decode 的瓶颈差异
| 阶段 | 计算形态 | 瓶颈 | 优化 |
|---|---|---|---|
| Prefill | 大 batch/长序列 GEMM + attention | compute 或 attention IO | FlashAttention、chunked prefill、batching |
| Decode | 每步一个 token,GEMV/小 GEMM + KV scan | HBM/KV bandwidth、调度 | GQA/MQA/MLA、KV quant、continuous batching、FlashDecoding |
24. PagedAttention 为什么有效
PagedAttention 借鉴 OS paging,把 KV cache 切成固定大小 block/page:
- 减少连续大块分配造成的碎片。
- 支持请求动态增长。
- 支持 prefix/block sharing。
- block table 类似页表,逻辑 token 序列映射到物理 KV block。
代价:attention kernel 要处理非连续 block table,地址计算和访存模式更复杂。
25. Continuous batching 怎么工作
每个 decode step 后,完成的请求退出,新请求加入,形成动态 batch。它提高 GPU 利用率,但会带来:
- 不同请求长度导致 batch shape 变化。
- KV cache 动态分配。
- 公平性和 SLO 调度问题。
- CUDA graph 复用变难,需要 bucket shape。
26. Speculative Decoding 的收益和限制
流程:
- 小 draft model 生成多个候选 token。
- 大 target model 并行验证。
- 接受连续匹配 token,不匹配处回退。
收益取决于:
- draft 速度足够快。
- acceptance rate 足够高。
- target model 验证多个 token 的并行效率高。
限制: - 增加系统复杂度和显存。
- 对高温采样、多样性生成、工具调用场景收益可能下降。
27. Tensor Parallelism 的通信量
常见 Megatron 风格:
- Column parallel linear:按输出维切权重,前向不需要 all-reduce,后续可能 gather。
- Row parallel linear:按输入维切权重,前向需要 all-reduce partial sums。
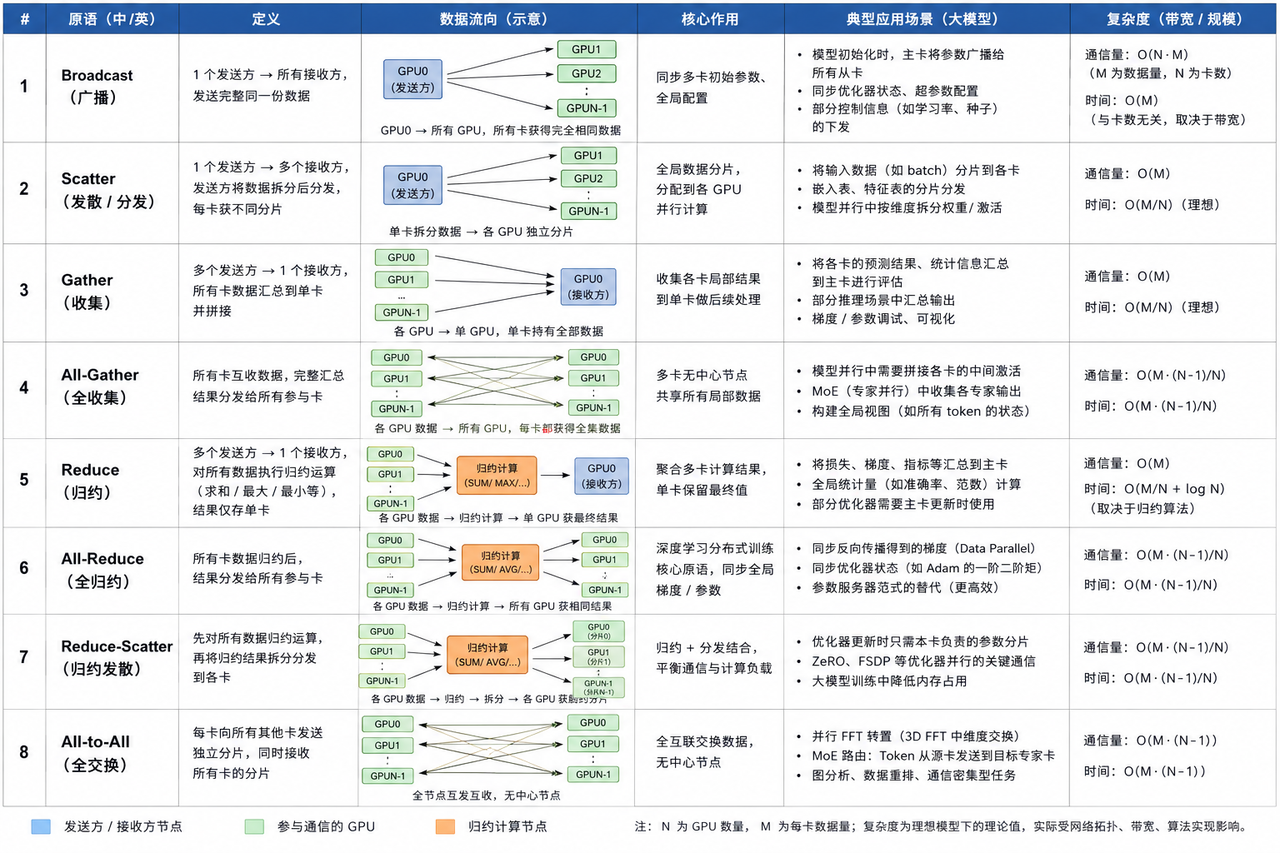
Transformer 一层中 TP 通常会引入多次 all-reduce/reduce-scatter/all-gather。TP 放在 NVLink/NVSwitch 域内更合适,跨节点 TP 延迟会很痛。
28. Pipeline Parallelism 的 bubble 怎么算
若 pipeline stages 为 p,microbatches 为 m,朴素 GPipe 的 bubble 占比约:
bubble ~= (p-1)/(m+p-1)
降低 bubble:
- 增加 microbatch 数。
- 使用 1F1B 调度。
- 平衡每 stage 计算量。
- interleaved pipeline。
29. ZeRO/FSDP 分别省什么
- ZeRO-1:切 optimizer states。
- ZeRO-2:再切 gradients。
- ZeRO-3:再切 parameters。
- FSDP 类似 ZeRO-3 思路,按模块 all-gather 参数,算完释放。
训练面试要会估算 Adam 显存:参数、梯度、m、v,混合精度下还有 master weights。
30. FP8 训练/推理要注意什么
FP8 优点:带宽减半,Tensor Core 吞吐高。
难点:
- 动态范围有限,需要 scaling。
- E4M3 精度高但范围小,常用于 forward activation/weight。
- E5M2 范围大但精度低,常用于 gradient。
- scale 粒度:per-tensor、per-channel、per-block。
- 需要 amax history、延迟 scale 更新、溢出监控。
31. INT8/INT4 量化会影响哪些算子
- Weight-only quant:主要省权重带宽,decode 受益大;activation 仍 BF16/FP16。
- W8A8:权重和激活都量化,GEMM 更快但校准难。
- KV cache quant:省显存和带宽,但 attention 质量可能受影响。
- SmoothQuant/AWQ/GPTQ:分别从 activation smoothing、权重重要性、二阶近似角度降低量化误差。
32. NCCL 常见 collective 怎么选
| Collective | 用途 |
|---|---|
| AllReduce | TP partial sum、梯度同步 |
| ReduceScatter | ZeRO/FSDP 梯度切分、sequence parallel |
| AllGather | FSDP 参数 gather、CP gather |
| AllToAll | MoE token dispatch/combine、sequence exchange |
| Broadcast | PP 参数/控制信息 |
| 通信优化: |
- overlap compute/communication。
- hierarchical collectives:节点内 NVLink,节点间 IB。
- bucket 化,避免太多小包。
- topology-aware rank placement。
33. 如何定位一次 LLM serving 延迟抖动
排查顺序:
- 请求层:输入/输出长度分布是否变了。
- 调度层:queue time、batch size、preemption、prefix hit rate。
- KV 层:显存碎片、eviction、swap、recompute。
- GPU 层:SM/HBM 利用率、kernel gap、CUDA graph miss。
- 通信层:NCCL/A2A/all-reduce latency、跨节点热点。
- 模型层:某些 expert 过热、routing imbalance。
关键指标:
- p50/p95/p99 TTFT/TPOT。
- tokens/s 和 goodput。
- KV cache usage、block fragmentation、prefix hit rate。
- per-expert token histogram。
- NCCL time 占比。
34. MoE expert 负载不均怎么处理
- 训练时:load balancing loss、aux-loss-free bias 更新、capacity factor。
- 推理时:expert replication,热 expert 多副本。
- token dropping/padding:吞吐和质量折中。
- routing aware batching:让不同请求混合后更均匀。
- 分层路由:限制每 token 跨节点 expert 数。
- 监控 per-expert tokens、A2A bytes、expert GEMM time。
35. 为什么小 batch 下 GPU 利用率低
- GEMM M 维太小,Tensor Core tile 不满。
- kernel launch 和调度开销占比变大。
- HBM 读权重/KV 无法被足够计算摊薄。
- warp occupancy 可能不足以隐藏延迟。
优化:continuous batching、request 合并、CUDA graph、persistent kernel、weight/KV quant、speculative decoding。
36. CUDA Graph 在推理中有什么用
作用:
- 减少 CPU launch overhead。
- 固定执行图,提高 decode step 稳定性。
限制: - shape 变化难处理。
- 动态 batch、动态 KV block、不同采样参数会降低复用。
- 常用 bucket 化:为常见 batch/seq shape 捕获多个 graph。
37. 为什么 attention softmax 要减 max
直接 exp(score) 容易 overflow。稳定 softmax:
softmax(x_i) = exp(x_i - max(x)) / sum_j exp(x_j - max(x))
FlashAttention 的 online softmax 本质上是在分块条件下维护这个 max 和 sum。
38. RoPE 对 KV Cache 有什么影响
RoPE 把位置信息旋转到 Q/K。KV cache 中通常保存已经应用 RoPE 的 K,decode 新 token 的 Q/K 按当前位置旋转。长上下文扩展时要处理 RoPE scaling、position interpolation、YaRN 等,否则高位置外推质量下降。
39. 为什么 Prefix Cache 不能简单按字符串匹配
因为模型看到的是 token ids,不是原始字符串。还要考虑:
- tokenizer 版本。
- system prompt 模板。
- special tokens。
- LoRA/adapters。
- model weights 版本。
- 安全租户隔离。
- cache salt。
正确做法是按 token block 和上下文元数据 hash。
40. 多租户 serving 怎么隔离
- admission control,按租户限流。
- KV cache quota。
- prefix cache 加租户/权限 salt。
- 防止长请求拖垮短请求:队列分级。
- 观测 per-tenant SLO。
- 对工具调用和隐私数据禁用跨租户 prefix sharing。
41. 训练和推理 Infra 最大区别
| 维度 | 训练 | 推理 |
|---|---|---|
| 目标 | tokens/s、稳定收敛、checkpoint | SLO、成本、吞吐、尾延迟 |
| 状态 | 参数/梯度/优化器/激活 | 权重/KV cache/request state |
| 并行 | DP/TP/PP/CP/ZeRO | TP/PP/EP/DP/PD split/continuous batching |
| 容错 | checkpoint restart | 请求级重试、worker 热迁移 |
| 动态性 | batch 较规则 | 输入输出长度高度动态 |
42. 设计一个 LLM serving 系统怎么答
建议架构:
回答要覆盖:
- 请求路由:模型版本、租户、prefix affinity。
- 调度:continuous batching、chunked prefill、PD split。
- KV 管理:PagedAttention、prefix cache、eviction。
- 并行:TP/EP/DP,拓扑感知。
- 量化:weights/KV/FP8。
- 指标:TTFT、TPOT、goodput、成本。
- 容错:worker crash、KV 丢失、重试、降级。
43. 如果吞吐低,你会怎么优化
先判断瓶颈:
- GPU SM/Tensor 低、HBM 高:memory-bound,做 KV/weight quant、fusion、GQA/MLA。
- SM 低、kernel gap 高:launch/scheduler 问题,CUDA graph、persistent kernel。
- NCCL 高:并行切分或拓扑问题,rank placement、减少跨节点 TP/EP。
- batch 小:continuous batching、提高并发、合并请求。
- expert 不均:expert replication、routing balancing。
44. 如果显存 OOM,你会怎么优化
按收益优先级:
- 减 batch 或 max context。
- KV cache paging/eviction。
- Prefix cache 去重。
- KV quant。
- Weight quant。
- TP/PP/EP 切分。
- CPU offload,但注意 PCIe 延迟。
- Sliding window/context compression。
45. AI Infra 面试最后反问什么
可以反问:
- 当前服务更关注 TTFT、TPOT、throughput 还是 cost/token?
- 模型主要是 dense、MoE,还是多模型混部?
- 最大瓶颈在 HBM、网络、调度还是显存容量?
- 是否有长上下文/Agent/tool calling 场景?
- 团队的 profiling 和压测基础设施如何?
一页速记
| 主题 | 一句话 |
|---|---|
| Roofline | AI=FLOPs/bytes,小 batch decode 多数 memory-bound |
| FA | 不 materialize L^2,用 tiling + online softmax 降 HBM IO |
| FlashDecoding | 把长 KV 拆 split 并行算,再归并 softmax |
| KV Cache | 省历史 token 重算,显存按 layers*tokens*kv_heads*head_dim*2 增长 |
| Prefix Cache | 跨请求复用公共 prefix KV,按 token block hash |
| MQA/GQA/MLA | 核心是减少 KV heads 或压缩 KV,降低 decode bandwidth |
| Chunked Prefill | 长 prefill 切块,避免 decode 被饿死 |
| PD Split | prefill/decode 资源解耦,但 KV handoff 可能很贵 |
| EP | 省 MoE expert 参数显存,代价是 A2A |
| A2A | MoE 每层约 2*tokens*topK*hidden*dtype_bytes |
| CUDA nondeterminism | 浮点非结合律 + atomic/reduction 顺序变化 |
| GPU memory | register/shared/global/constant/local/L2,各自优化不同 |
46. vLLM、TensorRT-LLM、SGLang 的定位有什么不同
| 系统 | 主要定位 | 典型强项 | 面试表达 |
|---|---|---|---|
| vLLM | 通用高吞吐 LLM serving engine | PagedAttention、continuous batching、OpenAI API 兼容生态 | 适合多模型服务、研究到生产的通用场景 |
| TensorRT-LLM | NVIDIA GPU 上的高性能推理库/引擎 | kernel 优化、FP8、inflight batching、TensorRT 集成 | 适合 NVIDIA 生产部署和极致性能优化 |
| SGLang | 面向结构化生成和 agent/workflow 的 serving/runtime | Radix cache、structured output、并行函数调用 | 适合复杂 prompt 复用、agent、程序化生成场景 |
| 面试时不要说谁绝对更好,而要按 workload 选:如果 prefix 复用极强,Radix/prefix cache 很关键;如果是 NVIDIA-only 且追求极致吞吐,TensorRT-LLM 值得考虑;如果要快速上线多模型 OpenAI-compatible 服务,vLLM 常见。 |
47. Radix Cache 和普通 Prefix Cache 有什么区别
普通 Prefix Cache 常按固定 token block hash 命中。Radix Cache 用前缀树保存 prompt token 序列的共享前缀,能复用不同请求之间的最长公共前缀。
适用场景:Agent 请求共享 system prompt、工具 schema;多轮对话存在公共历史;结构化生成中 prompt 模板相似。注意树节点要关联 KV block、引用计数、权限上下文和 eviction priority,不能只按字符串前缀复用。
48. 什么是 Inflight Batching
Inflight batching 指推理过程中动态把不同阶段的请求合到同一个 batch 中处理,而不是等一个 batch 全部完成才处理下一个。
优势是长短请求混合时 GPU 利用率更高,新请求可在已有请求 decode 过程中加入,配合 paged KV 后动态 batch 的内存管理更可控。风险是 batch shape 动态变化,CUDA Graph 复用困难;调度器要同时考虑公平性和吞吐;不同 sampling 参数可能影响 kernel fusion 和 graph bucket。
49. OpenAI-compatible API 服务内部通常怎么分层
API 层负责协议、鉴权、限流;Router 负责模型版本、租户、地域、prefix affinity;Scheduler 负责 batching、SLO、抢占;Engine 负责 GPU kernel 和 KV 管理;Streamer 要处理取消、超时、断连和 backpressure。
50. 怎么设计多模型混部
问题本质是显存、请求分布和 SLO 的资源隔离。常见方案包括静态分片、动态加载、权重量化、MIG/MPS、admission control。线上通常会把热模型常驻,长尾模型走动态池;高 SLO 租户独立资源,低 SLO 租户共享资源。面试要强调冷启动、cache 污染、显存碎片和流量突刺。
51. LoRA/Adapter Serving 怎么做高效
LoRA 增量可写成 Y = XW + alpha/r * XAB。挑战是不同请求使用不同 LoRA,如果每个 LoRA 单独 batch 吞吐低,LoRA 权重频繁换入换出会造成 HBM/CPU 传输。
优化:Base model 常驻 GPU;LoRA adapter 做缓存,热 adapter 常驻;Multi-LoRA batching 在同一 batch 内按 adapter 分组计算增量;小 rank LoRA 可把 XA 和 B 融合到 linear kernel;长尾 adapter 放 CPU/NVMe cache,但要控制冷启动。
52. Structured Output / JSON 约束解码如何实现
常见方式有 logits processor、Grammar/Regex/FSM、Trie、speculative + constrained verification。代价是每步 logits mask 增加 CPU/GPU 开销,复杂 schema 会导致状态机大,tokenizer 子词会让字符串约束更复杂。系统优化是把 FSM 状态放到批处理结构中,避免每个请求 Python 回调;对常见 schema 做编译缓存。
53. 多模态 LLM Serving 和纯文本有什么不同
多模态通常多了 vision/audio encoder 和跨模态 projector。差异是输入预处理更重,prefill token 数可能由图片 patch 数决定,batching 更难,GPU/CPU pipeline 都可能成为瓶颈。
优化:预处理异步化;图片 encoder 结果缓存;按 image token 数 bucket;限制最大图片/视频帧数;多模态 encoder 和 LLM 分池部署。
54. Embedding/Rerank 服务和生成服务的 Infra 区别
Embedding/Rerank 通常是 encoder-only 或 cross-encoder,请求没有长 decode 循环,主要是 batch GEMM,KV cache 不重要,latency 受 batch 等待和 tokenizer 影响较大。生成服务是自回归 decode,状态长期驻留,KV cache 是核心资源,需要 streaming,尾延迟和调度更复杂。
55. RAG 系统中 AI Infra 负责哪些性能瓶颈
瓶颈可能在 embedding batch、vector search latency、reranker cross-encoder、prompt 拼接导致 prefill 过长、引用内容重复导致 prefix cache 命中低。优化包括 query/result cache、rerank 截断、context compression、document chunk 去重、prompt 模板固定化。
56. LLM Benchmark 应该怎么设计
不要只测 tokens/s。应同时报告输入长度分布、输出长度分布、并发数和到达过程、TTFT p50/p95/p99、TPOT/ITL p50/p95/p99、request success rate、goodput、GPU 利用率、HBM 利用率、KV cache 使用率。Benchmark 要接近线上 workload,固定 1k in/1k out 的平均值容易误导。
57. Throughput、Latency、Goodput 的区别
Throughput 是系统总产出,比如 tokens/s;latency 是单请求耗时,比如 TTFT、E2E latency;goodput 是满足 SLO 的有效吞吐。一个系统 tokens/s 很高,但 p99 TPOT 超 SLO,那么高吞吐对业务无意义。面试中建议强调用 goodput 做容量规划。
58. TTFT 为什么会高
TTFT = 排队 + tokenization + prefill + 调度/通信 + 首 token decode。
常见原因是输入 prompt 长、prefill batch 太大、prefix cache miss、tokenizer 成为 CPU 瓶颈、PD split 中 KV handoff 慢、冷模型加载或 CUDA graph warmup。
优化包括 prefix cache、chunked prefill、prefill pool 扩容、tokenizer 并行、warmup、admission control。
59. TPOT 为什么会高
TPOT 主要由每个 decode step 的计算、KV scan、通信和调度决定。
原因可能是 decode batch 太大或太小、KV cache 过长、GQA/MQA/MLA 未使用或 KV 未量化、TP/EP 跨节点通信、sampling/logits processor 在 CPU 侧阻塞、输出长请求长期占用 slot。
60. 如何做容量规划
给定 QPS=lambda、平均输入 L_in、平均输出 L_out、单 GPU prefill 能力 r_prefill、单 GPU decode 能力 r_decode:
- Prefill GPU:
ceil(lambda * L_in / r_prefill / target_util) - Decode GPU:
ceil(lambda * L_out / r_decode / target_util) - KV 显存:按并发请求和最大上下文估算。
要留余量:线上 p95/p99 输入输出长度、流量突增、故障降级都会吃掉 capacity。
61. 什么是 Admission Control
Admission control 是在请求进入 GPU 调度前判断系统是否能承接。依据包括当前队列长度、KV cache 可用 block、租户 quota、请求最大 token 数、预计 TTFT/TPOT 是否超过 SLO。策略包括拒绝或降级超长请求、低优先级请求排队、对长输出设置最大预算、高价值租户预留容量。
62. 请求取消后系统要清理什么
streaming 请求断开或用户取消后,要清理 scheduler request state、KV cache block 引用计数、prefix cache 引用、sampling state、网络连接和 backpressure buffer。如果正在 GPU kernel 中,通常只能在 step 边界取消,不能任意中断 kernel。
63. KV Cache Eviction 怎么设计
目标是释放显存同时尽量保留高价值 cache。常见策略包括 LRU、LFU、TTL、Priority、Size-aware。Eviction 不能破坏 active request;共享 block 要看引用计数。超大 prefix 即使命中率高也可能不划算,因为它会挤掉更多小 prefix。
64. KV Cache Offload 到 CPU 是否值得
判断公式:offload收益 = 省下的HBM容量价值 - PCIe/网络传输延迟 - 反复换入换出开销。
适合长上下文但访问不频繁、请求可容忍高延迟、热 KV 留 HBM 冷 KV 放 CPU 的场景。
不适合低延迟在线场景,因为 decode 每步都需要访问 KV,PCIe 带宽远低于 HBM。
65. Sliding Window Attention 解决什么问题
Sliding window 让每个 token 只 attend 最近窗口,KV cache 和 attention 成本从全历史变成窗口大小。优点是显存和带宽稳定;缺点是模型无法直接看到窗口外信息,需配合 sink token、summary token、retrieval 或特殊训练。
66. Sink Token 是什么
一些长上下文模型保留最前面的少量 token 作为 attention sink,同时滑动保留最近窗口。这样既保留全局锚点,又控制 KV cache。它不是免费扩展上下文,而是让有限窗口更稳定;真正的远距离信息仍可能丢失。
67. YaRN、RoPE Scaling 解决什么
RoPE 在训练长度外直接外推会质量下降。RoPE scaling/YaRN 等方法通过调整位置编码频率或插值方式,让模型支持更长上下文。Infra 关注点是 tokenizer/model config 必须匹配,KV cache 位置索引要正确,prefix cache 不同 RoPE 配置不能混用,长上下文会显著增加 prefill 和 KV 成本。
68. 为什么 tokenizer 也可能是瓶颈
高 QPS、短输出场景下,GPU 很快,CPU tokenizer 可能成为瓶颈。优化包括 Rust/C++ tokenizer、tokenizer worker pool、批量 tokenization、prompt 模板缓存、常见 system prompt 预 tokenized、避免 streaming 每步做重型 detokenization。
69. Sampling 有哪些性能坑
Sampling 可能包括 temperature、top-k、top-p、min-p、repetition penalty、bad words、grammar mask。坑点是 logits 从 GPU 拷到 CPU 再处理开销大,每请求 sampling 参数不同导致 batch 内分支复杂,top-p 需要排序或近似排序,grammar mask 可能很大。优化包括 GPU sampling kernel、参数 bucket、常见 mask 编译缓存、减少 CPU-GPU 同步。
70. Beam Search 为什么比普通采样更难 serving
Beam search 每个请求会扩展多个 beam:KV cache 需要复制或共享历史,每步要选择 top beams,batch size 等效放大,beam 之间长度不同,调度更复杂。优化包括 KV block copy-on-write、beam 内共享 prefix、限制 beam width、用 GPU top-k。
71. Prefix Cache 和安全隔离有什么关系
如果不同租户共享 prefix cache,可能出现侧信道或数据污染。cache key 至少要包含 tenant/user 权限域、model id、weight version、tokenizer version、adapter/LoRA id、system prompt 模板版本和 security salt。敏感场景可以禁用跨租户 cache,只允许同租户或公共系统 prompt 复用。
72. Prompt Injection 对 Infra 有什么影响
Prompt injection 本身是安全问题,但 Infra 要配合:请求日志脱敏,避免泄露 system prompt;工具调用权限在服务端校验,不能只信模型输出;prefix cache 不能把敏感 tool schema 错共享给其他租户;trace/debug 页面要做权限控制;对异常长 prompt、递归工具调用限流。
73. 如何做模型版本灰度
步骤:按 tenant、百分比、region 或 request tag 路由;保留旧模型快速回滚;灰度期间对比 TTFT/TPOT、错误率、质量指标;prefix cache key 包含 model version,不能跨版本复用 KV;量化版本也要独立,因为数值输出和 cache 表示可能不同。
74. 模型热更新为什么难
难点是权重加载慢、占 HBM 大;旧请求还在 decode,不能中途换权重;CUDA graph 和 kernel workspace 可能与 shape/config 绑定;Prefix/KV cache 不能跨权重版本复用。策略是新 worker 预热 -> 流量切换 -> 旧 worker drain -> 释放资源。
75. CUDA Graph 和动态 shape 怎么结合
做法:为常见 batch size、seq length bucket 捕获 graph;请求调度时尽量填充到已有 bucket;对罕见 shape 走 eager path;graph replay 前保证内存地址稳定,Paged KV 要有稳定的 block table buffer。取舍是 bucket 越多命中高但内存和管理复杂,bucket 越少 padding 浪费多。
76. Persistent Kernel 在 LLM Decode 中有什么用
Persistent kernel 让 kernel 常驻 GPU,减少 launch overhead,并在 GPU 侧循环取任务。优点是降低每 token step 的 CPU launch 开销,适合小 batch 高频 decode;缺点是调度器复杂,资源常驻可能影响其他 kernel,debug 和 profiling 更难。
77. 如何理解 Kernel Fusion 的收益
Fusion 本质是减少 HBM round-trip 和 launch overhead。例如 linear -> bias -> activation -> residual -> norm,未融合时每步都读写 HBM;融合后中间结果留在 register/shared memory。限制是融合后寄存器压力增大可能降低 occupancy,大 GEMM 本身已高度优化,不应盲目把所有东西塞进去。
78. LayerNorm/RMSNorm 算子怎么优化
RMSNorm 公式:y = x / sqrt(mean(x^2)+eps) * weight。优化点包括每行一个或多个 block、向量化 load、FP32 accumulation、warp/block reduction 求 sum of squares、weight 和 x 合并读取、与 residual/add 融合。RMSNorm 比 LayerNorm 少 mean subtraction,通常更简单更快。
79. Softmax 算子怎么优化
步骤是每行求 max、计算 exp(x-max)、求 sum、除以 sum。优化包括 warp/block reduction、短行用 warp-level softmax、长行分 block online softmax、避免中间结果多次写 HBM、评估近似 exp 精度。FlashAttention 的 online softmax 就是 softmax 优化在 attention 中的系统化应用。
80. TopK 算子为什么难
TopK 需要在大量 logits 或 expert scores 中找最大 K 个。难点是排序代价高,batch 内 mask 不同,MoE router TopK 在每层都调用且延迟敏感。优化包括 K 小时用 selection 而不是 full sort,warp/block 局部 topK + 全局归并,对 vocabulary sampling 使用 fused sampling。
81. Grouped GEMM 是什么
Grouped GEMM 把多个不同 M/N/K 的小 GEMM 合并调度。MoE expert 中每个 expert token 数不同,直接逐 expert 调用 GEMM 开销高,Grouped GEMM 可以提高 GPU 利用率。风险是 shape 差异太大时效率仍低,padding 会浪费计算,需要把 token 按 expert permutation 后连续存储。
82. FP8 GEMM 为什么要 scale
FP8 表示范围和精度有限,直接把 FP16/BF16 数值 cast 到 FP8 会 overflow/underflow。通常记录 tensor/block 的 amax,计算 scale,把数值映射到 FP8 可表达范围;GEMM 用 FP8 输入、FP16/BF16/FP32 accumulate;输出再用 scale 还原。Scale 粒度越细,精度越好,但 metadata 和实现复杂度越高。
83. Blackwell/Hopper 对 AI Infra 有哪些影响
Hopper 带来 FP8 Tensor Core、TMA、Transformer Engine、NVLink/NVSwitch 增强。Blackwell 继续增强低精度 Tensor Core、HBM 和 NVLink 生态。Infra 影响是量化格式更激进、scale 管理更重要、attention/GEMM kernel 要利用新硬件指令、多 GPU 通信拓扑对部署更关键,老 kernel 在新硬件上需要重新 profiling。
84. NVLink、NVSwitch、InfiniBand 的区别
| 网络 | 范围 | 特点 | 常见用途 |
|---|---|---|---|
| NVLink | GPU-GPU | 高带宽低延迟 | 节点内 TP/EP/CP |
| NVSwitch | 多 GPU 交换 | 节点内全互联 | 8/16 GPU 服务器 |
| InfiniBand/RoCE | 跨节点 | RDMA,延迟高于 NVLink | 多节点 DP/PP/EP |
| 经验:TP 尽量在 NVLink 域内;跨节点更适合 DP、PP 或精心设计的 EP。 |
85. Rank Placement 为什么重要
同样的 TP/EP/DP 配置,不同 rank 放置会导致通信跨越不同链路。原则是 TP rank 放同一 NVSwitch island,MoE A2A 尽量限制在高速域,PP 相邻 stage 尽量网络近,DP 跨节点更容易扩展。并行策略和物理拓扑必须一起设计,否则理论通信量相同,实际延迟差很多。
86. AllReduce 的 Ring 和 Tree 有什么区别
Ring 带宽利用高,适合大消息,但延迟随节点数增长;Tree 延迟更低,适合小消息,但带宽利用可能不如 ring;分层算法会先节点内 reduce,再节点间 reduce,再节点内 broadcast。大模型训练中梯度桶大,ring/hierarchical 常见;推理中小消息多,延迟更敏感。
87. AllToAll 为什么比 AllReduce 更难
AllReduce 每个 rank 最终拿到相同结果;AllToAll 是每个 rank 给每个 rank 发送不同数据。难点是消息大小不均,尤其 MoE routing;网络热点和 straggler;buffer packing/unpacking 开销;和 expert GEMM overlap 更复杂。优化包括 token 重排、expert load balance、分层 A2A、限制跨节点 expert、expert replication。
88. Sequence Parallelism 解决什么
Sequence Parallelism 把 sequence 维切分,降低 activation memory,并和 Tensor Parallel 的 reduce-scatter/all-gather 配合。训练中常用于降低 LayerNorm、Dropout 等非 TP-friendly 部分的 activation 显存。推理中更常讨论 Context Parallelism,目标是长上下文 KV/attention 分片。
89. Context Parallelism 与 Tensor Parallelism 区别
TP 切 hidden/head/MLP 维,主要解决参数和 GEMM;CP 切 sequence/context 维,主要解决长上下文 attention 和 KV cache。CP 的难点在 attention 需要跨分片看到 K/V,需要 AG KV、AG Q、ring attention 或分块归并。
90. Ring Attention 的核心思想
把 context 分片放在不同 GPU 上,K/V block 沿 ring 传递,每张 GPU 用本地 Q 对经过的 K/V block 计算局部 attention,并维护 online softmax 状态。优点是不用一次 all-gather 全量 KV;缺点是通信轮次多,latency 随 GPU 数增加,调度复杂。
91. Expert Parallel 和 Tensor Parallel 怎么组合
常见组合是 attention 用 TP,dense MLP 或 shared expert 用 TP,routed experts 用 EP,外层用 DP 扩吞吐。设计原则是 TP 通信放高速域,EP 尽量避免跨慢网络 A2A,DP 用来扩大 batch 和隔离请求。
92. MoE 中 capacity factor 是什么
训练时每个 expert 通常限制最多接收多少 token:capacity = ceil(capacity_factor * tokens * topK / num_experts)。capacity factor 大,少丢 token,但 padding 和计算浪费大;capacity factor 小,效率高,但可能丢 token 或质量下降。推理时通常不希望 drop token,会用 expert replication 或动态调度处理热点。
93. Aux-loss-free load balancing 是什么思路
传统 MoE 用辅助 loss 鼓励 expert 负载均衡,但可能影响主任务。Aux-loss-free 思路用路由 bias 等机制动态调整 expert 被选概率,在不显式加入较大辅助损失的情况下降低不均衡。面试重点是说明目标:让 expert 使用更均衡,同时尽量不损伤模型质量。
94. 高性能 MoE 通信库解决什么
高性能 MoE 通信库通常优化 token dispatch/combine、变长 A2A、packing/unpacking、通信与 expert GEMM overlap、节点内/节点间分层通信。MoE 性能不只取决于 expert GEMM,dispatch/combine 和负载均衡同样决定尾延迟。
95. 为什么 MoE 推理可能比 Dense 更难稳定
MoE routing 动态,每层每请求 expert 分布不同;A2A 消息大小不均;热 expert 造成 straggler;小 token 数导致 expert GEMM 不饱和;负载均衡策略影响质量和吞吐。Dense 模型计算更规则,MoE 模型系统复杂度更高。
96. 训练中 Activation Checkpointing 的 trade-off
Activation checkpointing 不保存全部中间激活,反向时重算。收益是显著省显存;代价是增加计算量,训练 step time 变长。适合显存是瓶颈且算力相对充足的大模型训练。面试中要补一句:checkpoint 粒度太细会增加调度开销,粒度太粗又省不了足够显存。
97. Optimizer State Offload 是什么
把 optimizer state 或参数分片放 CPU/NVMe,GPU 只在需要时取回。收益是训练更大模型;代价是 PCIe/NVMe 带宽和延迟可能拖慢训练,需要 overlap 和 prefetch。典型场景是 ZeRO-Offload、ZeRO-Infinity 类方案。回答时要区分参数 offload、梯度 offload、optimizer state offload。
98. Checkpoint 保存什么
训练 checkpoint 通常包括 model parameters、optimizer states、lr scheduler、random states、dataloader progress、parallel rank/shard metadata。推理模型发布还要包括 tokenizer、config、generation config、quantization scales、adapter 信息。分布式 checkpoint 要能从不同并行切分恢复,否则换 GPU 数或并行策略会很痛。
99. 分布式训练故障恢复怎么设计
大规模训练 MTBF 很低,需要周期性 checkpoint、异步 checkpoint、rank failure 后重新拉起全局 job、必要时支持 elastic training。checkpoint 频率按故障概率和保存成本折中:太频繁影响吞吐,太稀疏则故障后损失大量计算。
100. DataLoader 为什么可能拖慢训练
原因包括数据读取慢、解压/解码 CPU 瓶颈、tokenizer 或 augmentation 太慢、小文件太多、网络存储抖动。优化包括数据预打包、顺序读、mmap、prefetch、worker pool、缓存、把 tokenizer 前置离线化。面试中可以说:GPU 空转不一定是 GPU 问题,先看 data wait time。
101. 如何避免训练中 GPU 空转
检查 DataLoader wait time、CPU-GPU copy 是否异步、NCCL 是否等待慢 rank、pipeline bubble、kernel launch gap。优化包括 prefetch、pin memory、overlap communication、增大 microbatch、均衡 pipeline stage、使用 profiler 定位。
102. 混合精度训练中 Loss Scaling 解决什么
FP16 梯度可能 underflow。Loss scaling 把 loss 放大,反向得到放大的梯度,再除回 scale。Dynamic loss scaling 会在 overflow 时降低 scale,在稳定时提高 scale。BF16 动态范围更大,通常不太需要 loss scaling。
103. 梯度累积和增大 batch 的区别
梯度累积用多个 microbatch 累加梯度,再做一次 optimizer step。它在梯度上接近更大 global batch,但 BatchNorm、dropout/randomness、optimizer step 频率和 LR schedule 可能不同。系统收益是降低单步显存,但一次参数更新耗时更长。
104. Pipeline stage 怎么切
目标是每个 stage 耗时接近,通信小。要考虑每层 FLOPs 和参数、embedding/lm head 是否特殊、MoE 层可能更慢且波动、跨节点 stage 边界通信、activation size。实际要 profiling 后调整,不能只按层数平均切。
105. 为什么大模型训练常用 3D 并行
3D 并行通常指 DP + TP + PP,也可加 CP/EP。DP 扩数据吞吐,TP 切单层大矩阵,PP 切层降低单卡参数/激活压力,EP 切 MoE expert,CP 切长序列。大模型单一并行维度通常无法同时解决显存、算力和通信。
106. ZeRO-3 和 TP 有什么区别
ZeRO-3 是数据并行下的参数/梯度/优化器状态分片,计算某层前 all-gather 参数,算完释放。TP 是单层矩阵计算切分,每层前向/反向都需要通信。简单说:ZeRO-3 主要省训练状态显存;TP 主要让单层计算和参数放得下并并行加速。
107. FSDP auto-wrap 策略怎么选
按模块粒度 wrap。粒度太大时 all-gather 内存峰值高;粒度太小时通信调用太多,开销大。常按 transformer block wrap。还要考虑 activation checkpoint、mixed precision、CPU offload 和 prefetch。面试可以补充:wrap 策略不是只看参数量,还要看计算边界和通信重叠。
108. 训练中为什么会出现 NaN
原因包括学习率过大、FP16 overflow、softmax/log/除法数值不稳定、数据异常、梯度爆炸、通信后某个 rank 的 NaN 扩散。排查要记录 loss scale、grad norm、激活统计、首个 NaN 层;开启 anomaly detection 或插入 check kernel,但注意开销。
109. 推理中为什么也会 NaN
原因包括量化 scale 错误、attention mask 错、softmax 输入全 -inf、RoPE position 越界或配置错、kernel 对特殊 shape bug、FP8/FP16 overflow。线上处理是检测 NaN logits,失败请求重试到 fallback worker,同时记录 model/version/shape/kernel。
110. 如何做 AI Infra Observability
必须监控 API 成功率和错误码、TTFT/TPOT p95/p99、queue time、GPU SM/HBM 利用率、KV cache block 使用率和 eviction、prefix cache hit rate、NCCL/communication latency、per-expert token histogram。没有分阶段指标时,延迟抖动很难定位。
111. GPU 利用率高但业务慢,可能是什么原因
GPU 忙不等于请求快。可能是 batch 太大,吞吐高但 latency 差;低优先级长请求占满资源;decode TPOT 超 SLO;GPU 在做无效 padding;MoE 热 expert 导致尾部慢;prefill 把 decode 饿死。要看 goodput 和分阶段 latency,而不是只看 GPU utilization。
112. GPU 利用率低但业务也慢,可能是什么原因
可能瓶颈不在 GPU:tokenizer/CPU sampling 慢、调度器锁竞争、网络 streaming backpressure、NCCL 等待慢 rank、KV allocator 锁或碎片、kernel launch gap 大、数据预处理慢。Nsight Systems 可以看 GPU timeline 是否有空洞,服务 trace 可以看 CPU 阶段耗时。
113. 如何做压测流量模型
压测应模拟 Poisson 或真实 trace 到达、输入长度分布、输出长度分布、streaming client 行为、取消/超时、多租户权重、cache 命中率。只用固定并发和固定长度,会高估系统稳定性。压测报告必须给 SLO 条件下的 goodput。
114. Online/Offline Batch Inference 有什么区别
Online 需要严格 SLO、streaming、动态请求、隔离和抢占。Offline 吞吐优先,可以大 batch、排序/分桶、失败重试。同一个模型,online 和 offline 的最优引擎配置可能完全不同;offline 可牺牲 TTFT 换吞吐,online 不行。
115. 怎么降低 Cost per Token
路径包括提高 GPU 利用率但不牺牲 SLO、量化权重/KV、prefix cache 提高命中、更好的 batching、MoE/Dense 模型按任务路由、speculative decoding 降低 target model 步数、混部提高资源利用、优化输出长度避免无用生成。成本指标要按满足质量和 SLO 的 token 计算。
116. 如何做模型路由
模型路由可以按任务复杂度、延迟 SLO、租户等级、上下文长度、工具调用需求、质量置信度。典型策略是小模型先处理简单请求,大模型处理复杂或 fallback;长上下文请求路由到 KV 容量更大的池;高价值租户路由到低拥塞池。
117. Speculative Decoding 和 Model Routing 怎么结合
小模型可以既是独立服务,也可作为 draft model。组合方式:简单请求直接小模型输出;中等请求小模型 draft,大模型 verify;难请求直接大模型,避免 draft 低接受率浪费。关键指标是 acceptance rate、draft/target 速度比、质量差异和额外显存。
118. Disaggregated Serving 除了 PD 分离还有什么
更广义的 disaggregation 可以包括 tokenizer/preprocess 与 GPU engine 分离、prefill/decode 分离、KV cache pool 独立管理、encoder/decoder 分离、multimodal encoder 与 LLM 分离、CPU sampling 或 grammar engine 分离。目标是让不同资源池按各自瓶颈扩缩容,但代价是跨组件传输和调度复杂度上升。
119. 如何回答「设计一个 Agent 推理平台」
重点是工具 schema 很长,prefix/radix cache 是核心;session state 要可恢复;tool execution 要权限隔离;长链路要 trace 每一步;对递归调用、长输出、并发工具调用限流;KV cache 不够时做摘要、滑窗、检索式记忆。
120. 给一台 8xH100 机器,怎么部署 70B 模型
回答示例:先估权重,70B BF16 约 140GB,单卡 80GB 放不下,8 卡可 TP8 或 TP4+PP2;再估 KV,按层数、kv heads、head dim、max tokens、batch 算,决定最大并发;如果用 GQA,KV cache 比 MHA 小很多;吞吐优先时用 continuous batching、Paged KV、CUDA graph bucket;latency 敏感时控制 decode batch;长上下文场景考虑 chunked prefill、prefix cache、KV quant;跨机器扩展时优先 DP 扩副本,避免 TP 跨节点。面试官想听的是估算过程,而不是固定配置。
参考链接
- FlashAttention: https://arxiv.org/abs/2205.14135
- FlashAttention-2: https://arxiv.org/abs/2307.08691
- FlashAttention-3: https://arxiv.org/abs/2407.08608
- vLLM / PagedAttention: https://arxiv.org/abs/2309.06180
- DeepSeek-V3 Technical Report: https://arxiv.org/abs/2412.19437
- DeepSeekMoE: https://arxiv.org/abs/2401.06066
- NVIDIA H100: https://www.nvidia.com/en-us/data-center/h100/
- NVIDIA Hopper Architecture: https://developer.nvidia.com/blog/nvidia-hopper-architecture-in-depth/
- CUDA Programming Guide: https://docs.nvidia.com/cuda/cuda-programming-guide/
- DistServe: https://arxiv.org/abs/2401.09670
- Sarathi-Serve: https://arxiv.org/abs/2403.02310
- Splitwise: https://arxiv.org/abs/2311.18677
- vLLM docs: https://docs.vllm.ai/
- TensorRT-LLM docs: https://nvidia.github.io/TensorRT-LLM/
- SGLang docs: https://docs.sglang.ai/
- NVIDIA Triton Inference Server: https://docs.nvidia.com/deeplearning/triton-inference-server/user-guide/docs/
- MLPerf Inference: https://mlcommons.org/benchmarks/inference-datacenter/
- NVIDIA Blackwell Architecture: https://www.nvidia.com/en-us/data-center/technologies/blackwell-architecture/
阅读导航



